
深入解析JavaScript中Array.prototype.concat与ES6扩展运算符在合并数组与添加元素时的核心差异,涵盖语法灵活性、迭代器协议、扁平化机制、浅拷贝内存模型与性能考量。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS数组合并与添加:concat与扩展运算符的区别
作者:函数茶馆
时间:2026-11-21
浏览:668
文章目录
JavaScript 核心机制
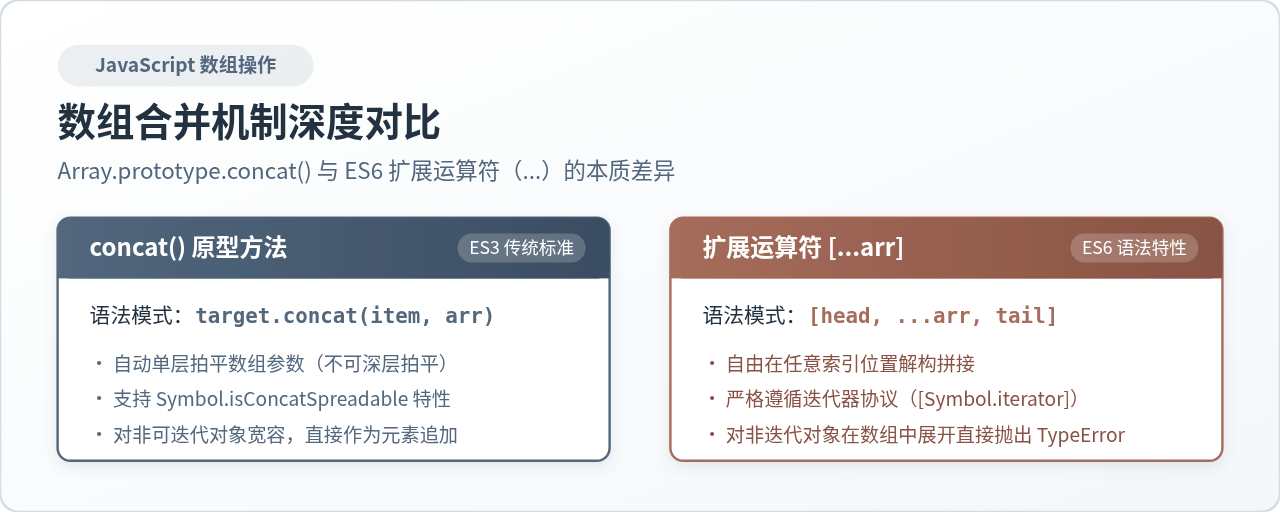
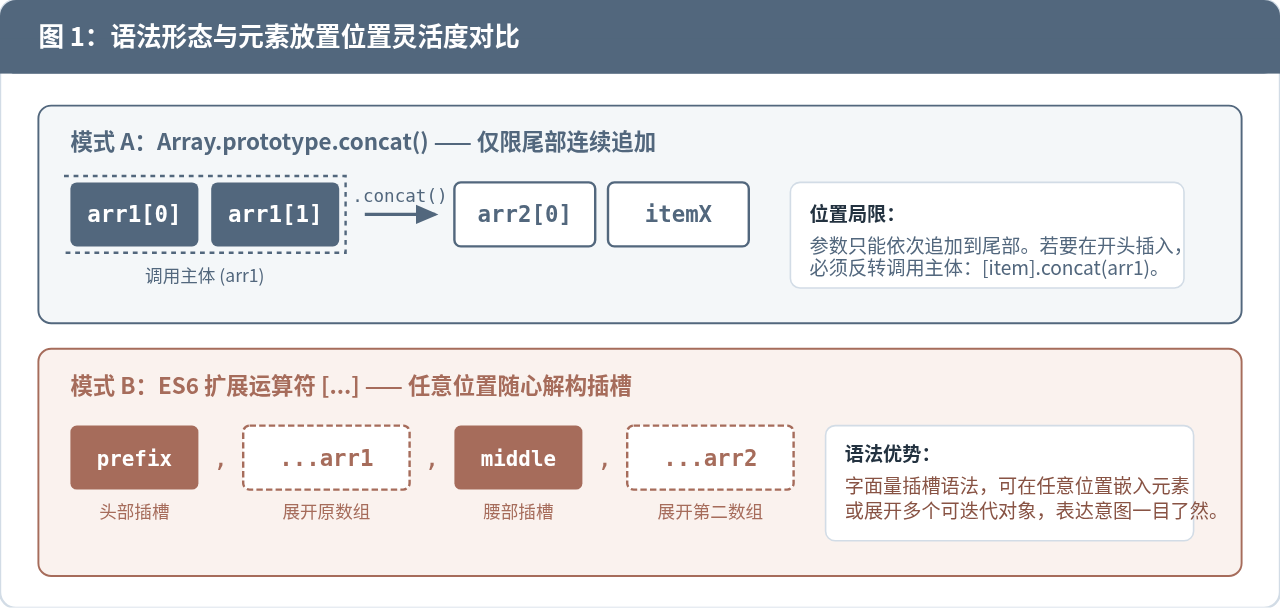
图 1:concat 的固定尾部追加模式与扩展运算符任意位置插槽对比
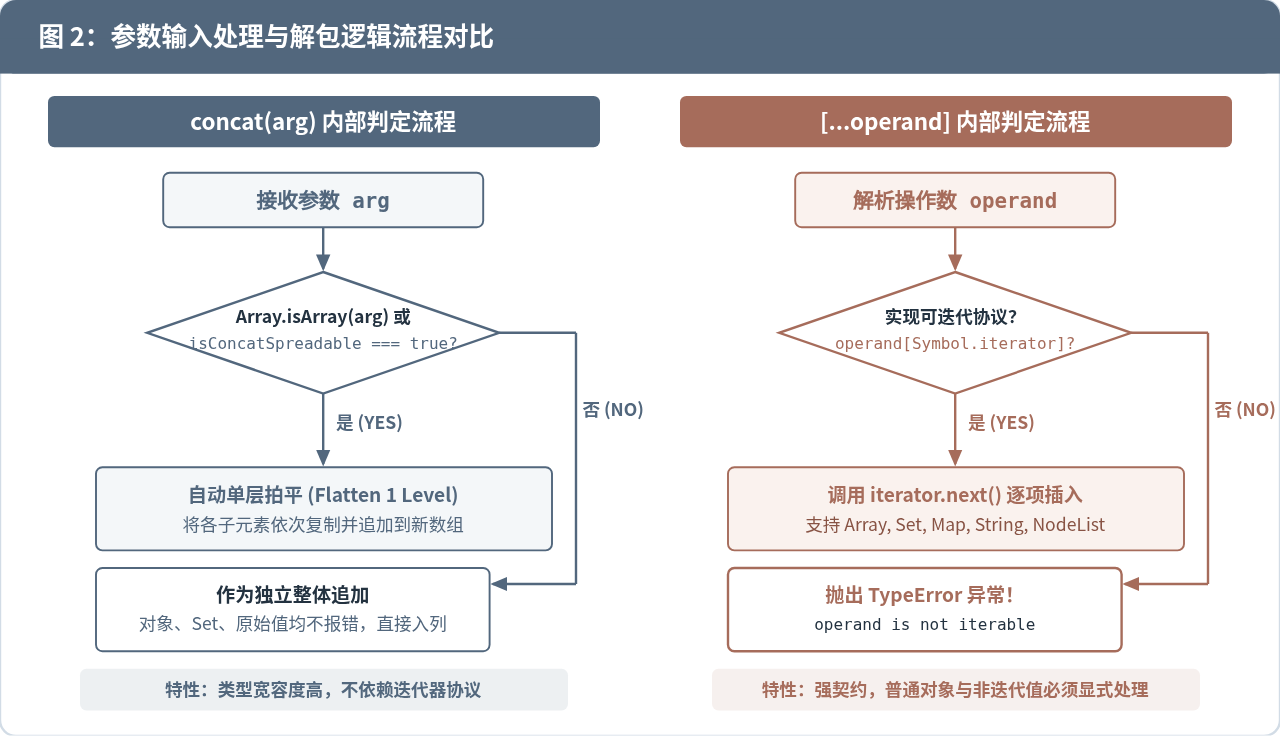
图 2:concat 与扩展运算符对不同类型参数的处理流程对比
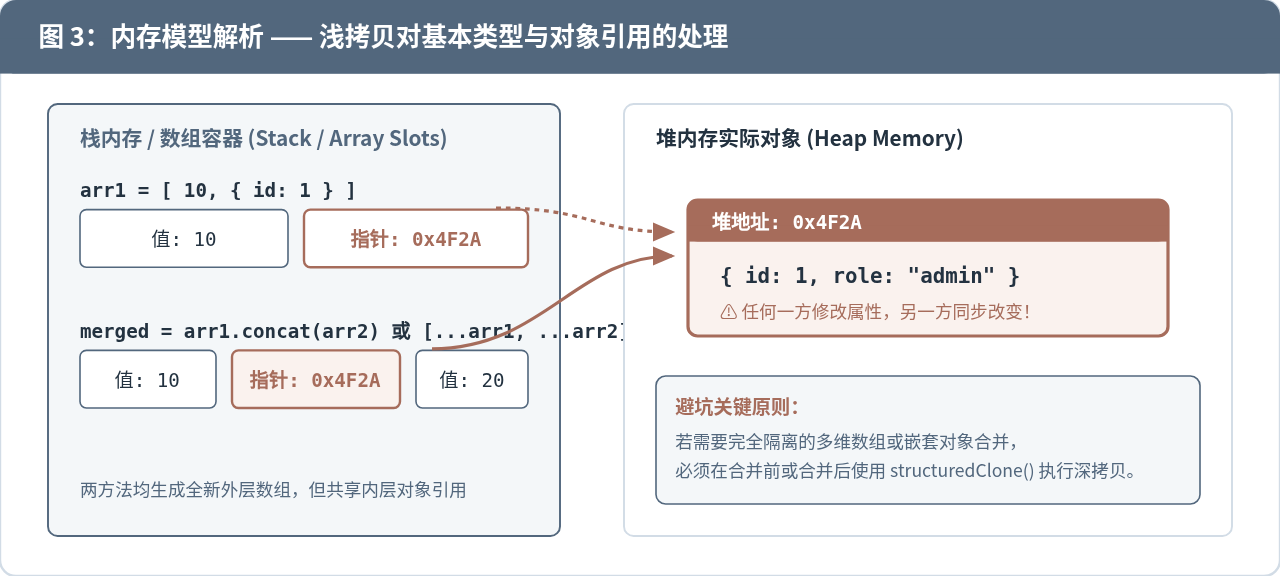
图 3:数组浅拷贝合并时的堆栈内存结构与对象引用共享
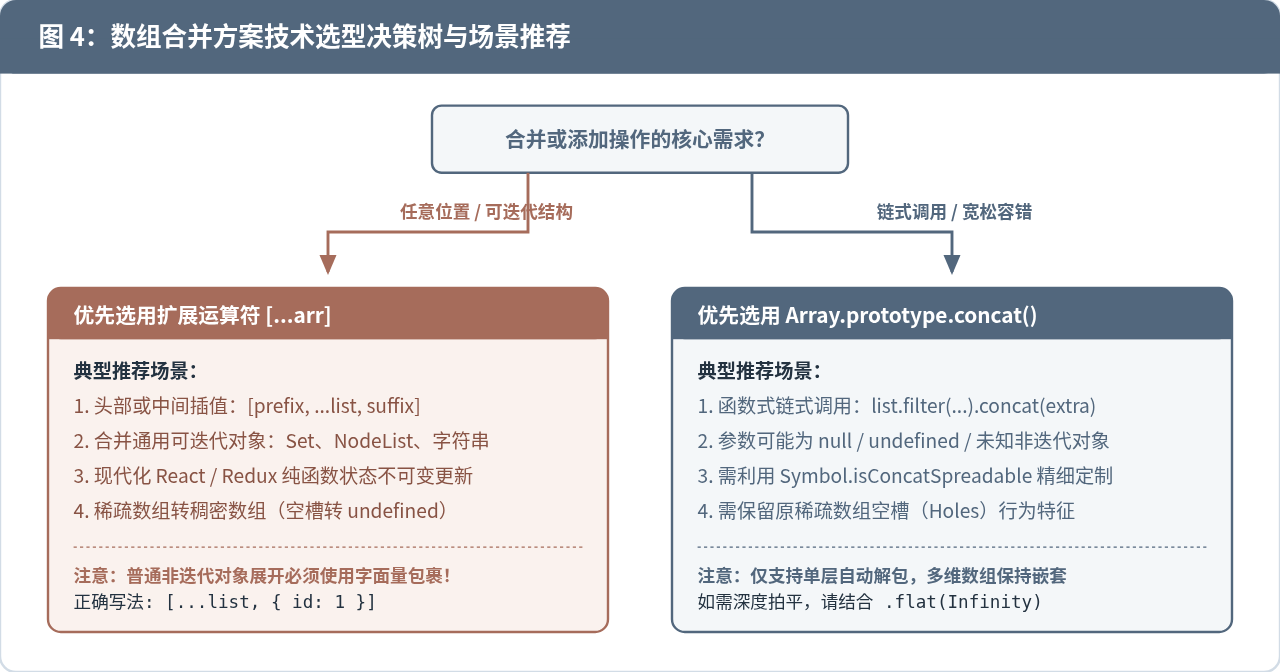
图 4:数组合并与元素添加方案决策路径全景图
分类:ECMAScript 规范与进阶实践
阅读时长:约 8 分钟
在 JavaScript 开发中,向数组追加元素或将多个数组合并为一个新数组主要有两种原生途径:老牌的
Array.prototype.concat() 原型方法与 ES6 引入的扩展运算符(Spread Operator,...)。虽然两者的共同点是均不修改原数组(返回全新数组)且对内层嵌套引用仅做浅拷贝,但在语法灵活性、展开解包机制、可迭代契约、错误边界以及特殊数组形态的处理上,两者有着截然不同的运行逻辑。
一、语法形态与元素放置位置的灵活性
从书写形式上看,concat() 是定义在 Array.prototype 上的常规实例方法,而扩展运算符属于 ES6 语法级别的操作符,必须配合数组字面量 [...] 一起使用。
1. 尾部追加与语法直观度
当仅仅需要将一个或多个数组拼接到目标数组的尾部时,两者都能直接胜任:
// 基础数组声明
const listA = ['apple', 'banana'];
const listB = ['cherry', 'date'];

// 方式 1:concat() 原型方法
const resultConcat = listA.concat(listB, 'elderberry');

// 方式 2:ES6 扩展运算符
const resultSpread = [...listA, ...listB, 'elderberry'];
示例输出结果:
resultConcat -> ['apple', 'banana', 'cherry', 'date', 'elderberry']
resultSpread -> ['apple', 'banana', 'cherry', 'date', 'elderberry']
resultConcat -> ['apple', 'banana', 'cherry', 'date', 'elderberry']
resultSpread -> ['apple', 'banana', 'cherry', 'date', 'elderberry']
2. 任意位置的插槽自由度
两者的第一个明显分水岭在于插入位置的自由度。
concat() 的语义是“以调用者为基础,向后追加参数”。如果需要在一个数组的开头(头部)或两个数组之间的中间位置插入独立元素,使用 concat() 就会显得比较别扭。开发者必须新建一个仅包含头部元素的临时数组作为调用主体:
// 使用 concat 在开头插入元素:必须构造临时前置数组
const withHeadConcat = ['first'].concat(listA, ['mid'], listB);

// 使用扩展运算符:任意位置直接插入字面量插槽
const withHeadSpread = ['first', ...listA, 'mid', ...listB, 'last'];
扩展运算符可以直接嵌入数组字面量中,无论位于开头、中间还是末尾,写法完全统一,且省去了构造多余过渡数组实例的开销。
二、核心机制差异:扁平化规则与迭代器协议
如果仅看上面的代码,很多人会以为扩展运算符只是 concat() 的语法糖。然而在底层规范中,两者的求值引擎依赖着完全不同的规则体系。
1. concat 的单层数组拍平与 isConcatSpreadable
当给 concat() 传入一个数组参数时,JavaScript 规范规定:concat() 会自动将该数组参数拍平一层(Flatten 1 Level),将其内部的项展开后放入新数组中。但如果传入多维数组,深层嵌套不会被展开:
const base = [1, 2];
const nested = [3, [4, 5]];

const res = base.concat(nested);
// res: [1, 2, 3, [4, 5]] —— 仅拍平外层 nested 数组
更关键的是,concat() 是否展开某个参数,并不依赖该对象是否具备迭代器,而是依赖内部的 Symbol.isConcatSpreadable 属性。普通对象只要显式设置了该属性为 true,且具备数字 length 和数字索引,就能被 concat() 当作数组解包;反之,若将数组的该符号设为 false,数组也会被当成不可展开的单体整体:
// 自定义类数组对象,默认会被 concat 视为普通对象不展开
const arrayLike = {{ 0: 'customA', 1: 'customB', length: 2, [Symbol.isConcatSpreadable]: true }};
const mergedLike = [10].concat(arrayLike);
// mergedLike 结果: [10, 'customA', 'customB']

// 将正常数组的展开特性关闭
const lockedArr = [99, 100];
lockedArr[Symbol.isConcatSpreadable] = false;
const mergedLocked = [10].concat(lockedArr);
// mergedLocked 结果: [10, [99, 100]] —— 数组整体作为单项加入
2. 扩展运算符与严格的迭代器协议(Symbol.iterator)
与 concat() 完全不同,数组字面量中的扩展运算符 [...target] 必须遵守 JavaScript 的可迭代协议(Iterable Protocol)。
运行时在遇到 ...target 时,会首先检查 target[Symbol.iterator] 是否为可用函数。只要实现了该协议(如 Array、Set、Map、String、DOM 的 NodeList 以及函数的 arguments),扩展运算符就能直接展开它;但如果传入未实现迭代器协议的普通对象,就会立即抛出运行时异常:
// 1. 展开 Set 或 Map 等可迭代结构(扩展运算符天然支持)
const uniqueSet = new Set(['x', 'y']);
const fromSet = [0, ...uniqueSet];
// fromSet: [0, 'x', 'y']

// 2. 对比:concat 不会自动展开 Set(因为 Set 的 isConcatSpreadable 默认为 undefined)
const fromSetConcat = [0].concat(uniqueSet);
// fromSetConcat: [0, Set(2) {{ 'x', 'y' }}] —— Set 对象直接作为一个元素推入

// 3. 对普通非可迭代对象展开
const plainObj = {{ name: 'Tom', age: 18 }};
// 尝试在数组字面量中解构普通对象:
// const err = [...plainObj];
// ❌ 报错:Uncaught TypeError: plainObj is not iterable

// 但作为单个元素添加则是合法的:
const validSpread = [plainObj]; // [{ name: 'Tom', age: 18 }]
const validConcat = [].concat(plainObj); // [{ name: 'Tom', age: 18 }]
注意容错边界:如果一个函数接收到的参数可能是
null 或 undefined,[...val] 会抛出 TypeError: val is not iterable;而 [].concat(val) 则会安全地将 null 或 undefined 作为数组项存入([null]),不会中断程序执行。
三、内存机制:浅拷贝与引用传递陷阱
无论是 concat() 还是扩展运算符,它们产生的都是原数组的浅拷贝(Shallow Copy)。这常是实际项目中引发深层状态被意外污染的根源。
1. 基本类型与引用类型的拷贝表现
- 基本数据类型(数字、字符串、布尔值、Symbol、BigInt):在新数组中直接分配新值存储,后续互不干扰。
- 引用数据类型(对象、数组、函数):新数组中仅复制了该对象在内存中的堆指针(Reference Pointer),并未克隆对象实体。
// 构造包含对象的数组
const user1 = {{ id: 101, status: 'active' }};
const originalList = [user1];

// 分别通过两种方式合并生成新数组
const copyByConcat = originalList.concat();
const copyBySpread = [...originalList];

// 外层数组实例确实是独立的全新对象
console.log(copyByConcat !== originalList); // true
console.log(copyBySpread !== originalList); // true

// 陷阱:内层对象指向同一块内存
copyBySpread[0].status = 'banned';

// 观察原数组和 concat 数组:
console.log(originalList[0].status);  // 'banned'(原数组被意外污染!)
console.log(copyByConcat[0].status);  // 'banned'(同步改变!)
解决方案:如果数组中含有嵌套对象且需要真正的数据隔离,应在合并前使用现代标准的
structuredClone() 进行结构化深拷贝,或者在现代状态管理(如 Redux、Zustand)中采用不可变更新模式。
四、特殊边界:稀疏数组与大数据量场景
1. 对稀疏数组(Sparse Array / Holes)的处理
所谓稀疏数组,即带有未定义“空槽”(hole)的数组(例如 new Array(3) 或 [1, , 3])。这两种方式对待空槽的态度完全相反:
concat()尊重 ECMAScript 历史遗留特性,会完整保留空槽,生成的新数组依然是稀疏数组。- 扩展运算符
[...]依赖迭代器遍历,在迭代过程中空槽会被转换为具体的undefined值,生成的新数组是稠密数组(Dense Array)。
const sparse = [1, , 3]; // 索引 1 位置是空洞 hole

const fromConcat = [].concat(sparse);
console.log(1 in fromConcat); // false (索引 1 处不存在属性,保持空洞)

const fromSpread = [...sparse];
console.log(1 in fromSpread); // true (索引 1 处值为 undefined,转为稠密数组)
2. 超大数组性能与堆栈限制
在处理包含数万甚至数十万级别元素的大数组时,很多开发者容易把数组字面量中的扩展运算符与函数入参中的扩展运算符混为一谈:
- 在函数参数中展开(例如
listA.push(...listB)):受到 JavaScript 执行引擎调用栈(Call Stack)大小的严格限制。如果listB的长度超过数万,会直接触发RangeError: Maximum call stack size exceeded。 - 在数组字面量中展开(即
[...listA, ...listB]):由于是在堆内存中连续分配新数组,不受调用栈限制。它只受当前 V8 堆内存的最大限制。 - 在大数据量的基准测试中,现代 JavaScript 引擎(如 V8)对
[...a, ...b]和a.concat(b)均进行了深度优化,二者的耗时差异通常在毫秒级微距内。但在原地追加超大数组时,使用分块(Chunking)或传统的for循环手动推入反而是内存占用最稳妥的做法。
五、全景对照与技术选型建议
为了在实际工程中迅速决策,我们将两种方案的核心特性归纳如下:
| 对比维度 | Array.prototype.concat() | 扩展运算符 [...arr] |
|---|---|---|
| 语法类别 | 实例方法调用(Method Call) | ES6 语法级解构操作符(Spread Syntax) |
| 插入位置 | 仅限追加至尾部(需链式或反向构造) | 任意位置(首部、腰部、尾部随心混合) |
| 可迭代对象支持 | 默认不解构 Set/Map/String(需定制属性) | 天然支持所有实现 [Symbol.iterator] 的对象 |
| 普通非迭代对象 | 宽容,直接作为单个元素追加,不报错 | 直接展开会抛出 TypeError 异常 |
| 空槽(Holes)保留 | 保留空槽(保持稀疏状态) | 填充为 undefined(转为稠密数组) |
| 拷贝深度 | 浅拷贝(共享对象堆引用) | 浅拷贝(共享对象堆引用) |
| 链式调用体验 | 优良(适合 arr.filter().concat()) |
需打断链式,或在外部用数组字面量包裹 |
实践决策准则:
- 日常绝大多数业务场景:首选扩展运算符
[...]。它的语法声明式特征更强,在 React、Vue、Redux 等强调不可变状态(Immutable Update)的前端框架中,[newItem, ...prevList]或[...prevList, newItem]的语义比concat更加直观清晰。 - 需要直接解构非数组可迭代结构时:必须使用扩展运算符。例如将
document.querySelectorAll()得到的NodeList或Set快速合并为数组。 - 输入源类型不确定且追求绝对防御性时:选用
concat()。如果上游传入的参数可能混杂有undefined、null或未实现迭代协议的配置对象,concat()能保证不抛出异常并平稳追加。 - 函数式数据流处理时:选用
concat()。在链式处理管道中,list.map(...).filter(...).concat(extraList)能够保持流畅的方法链,无需频繁通过中括号打断逻辑。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章