
详细讲解在JavaScript中将超长字符串按指定固定长度自动换行的多种实现方式,涵盖循环切片法、正则表达式匹配法、Unicode表情字符安全处理及实战避坑指南。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS怎么实现长字符串按固定长度自动换行
作者:函数茶馆
时间:2026-11-21
浏览:160
文章目录
前端工程 / JavaScript 数据处理
核心解答:在 JavaScript 中实现长字符串按固定长度折行换行,最直接可靠的方式有两种:针对纯文本和一般字符,采用 for 循环配合 str.slice(i, i + n) 线性切片并以
连接,性能高且逻辑可控;若追求极简单行代码,可使用正则匹配 str.match(new RegExp(`[\s\S]{1,${n}}`, 'g')).join('
')。若字符串包含复合 Emoji 表情等特殊字符,则需引入 Intl.Segmenter 或字符集分词以规避乱码。
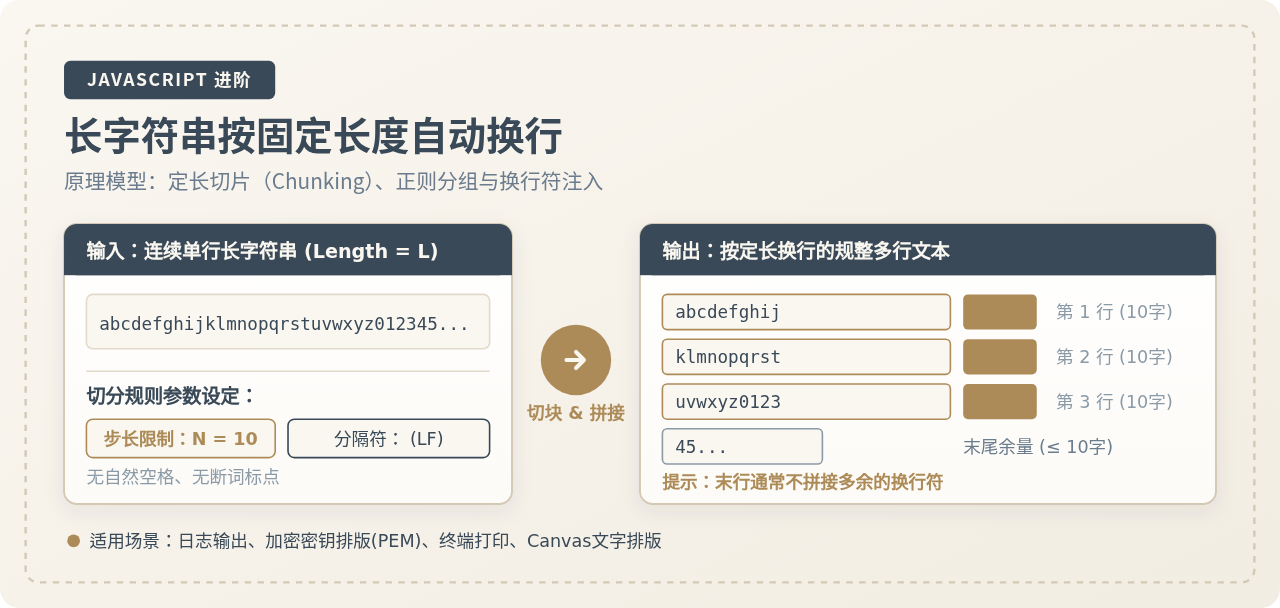
图 0:长字符串定长折行与切块注入机制概览(缩略图)
一、为什么需要手动进行长字符串定长换行?
在日常 Web 开发中,处理长字符串折行通常有两种截然不同的场景:
- 视觉视图层折行:仅为了在浏览器网页或移动端容器内防止长英文字符串撑破布局,通常直接使用 CSS 样式属性
word-break: break-all;或overflow-wrap: anywhere;即可由浏览器渲染引擎自动排版,无需破坏原始数据。 - 数据与协议层折行:生成特定标准格式的数据源。例如:遵循 RFC 7468 标准的 PEM 格式证书(Base64 密文每 64 字符换行)、终端命令行 ASCII 字符画输出、日志文件规整分块持久化、HTML Canvas 文本绘制引擎等。此类场景必须在字符串实体中真正插入
本文聚焦于第二种场景,即通过 JavaScript 算法在纯数据层面将连续字符串按固定步长精准拆分并注入换行符。
二、核心原理:定长切片(Chunking)与重组模型
从底层算法来看,长字符串定长换行本质上是一个固定窗口滑动切片(Fixed-size Chunking)过程:
假设原始字符串长度为 L,指定每行固定长度为 N。那么总共可切分出 Math.ceil(L / N) 个子片段。每个分段的起始索引为 i * N,截止索引为 Math.min((i + 1) * N, L)。在取得全部子串数组后,调用数组的 join('
') 方法,即可在子项之间安全拼接换行符,且末尾不会产生冗余的空换行。
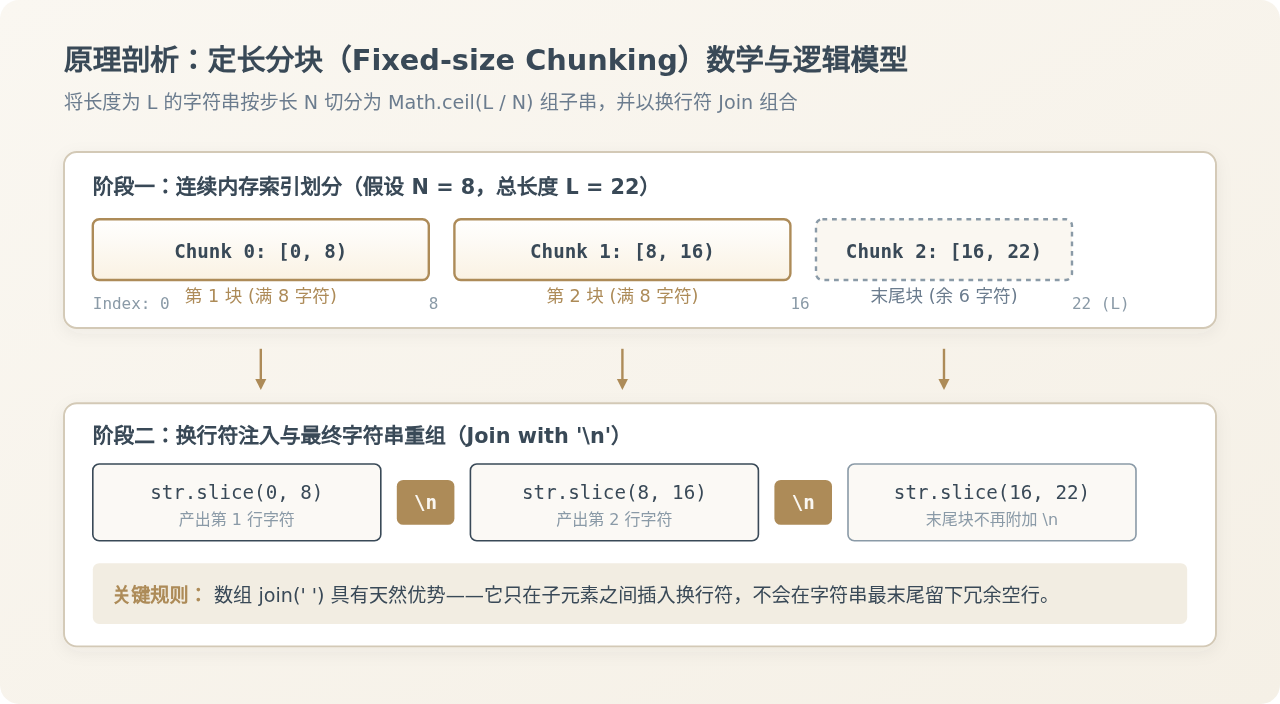
图 1:字符串固定步长切片与换行符编排原理
三、实现方法详解与完整示例
1. 方法一:循环截取法(推荐:性能稳定、无依赖)
循环截取法直接使用 String.prototype.slice()。slice 接受起始与结束索引,无论末尾剩余字符是否满足固定长度,slice 都能自适应截取至末尾,绝不越界报错。
/**
 * 将长字符串按固定长度插入换行符(循环 slice 法)
 * @param {string} str - 原始字符串
 * @param {number} size - 每行固定字符长度
 * @param {string} [sep='
'] - 换行分隔符,默认为换行符 '
'
 * @returns {string} 格式化后的换行文本
 */
function wrapStringBySlice(str, size, sep = '
') {
  // 1. 边界检查
  if (!str || typeof str !== 'string' || size <= 0) {
    return str || '';
  }
  if (str.length <= size) {
    return str;
  }

  // 2. 定长滑动截取
  const chunks = [];
  for (let i = 0; i < str.length; i += size) {
    chunks.push(str.slice(i, i + size));
  }

  // 3. 连接输出
  return chunks.join(sep);
}

// 示例验证
const rawText = 'ABCDEFGHIJKLMNOPQRSTUVWXYZ0123456789';
const formatted = wrapStringBySlice(rawText, 10);
console.log(formatted);
/* 输出示例:
ABCDEFGHIJ
KLMNOPQRST
UVWXYZ0123
456789
*/
为什么使用 slice 而不是 substr 或 substring?
String.prototype.substr 已被 ECMAScript 规范废弃(Deprecated);而 substring 会在参数传递负数或反序时进行内部数值调换,行为不如语义清晰的 slice 直观。
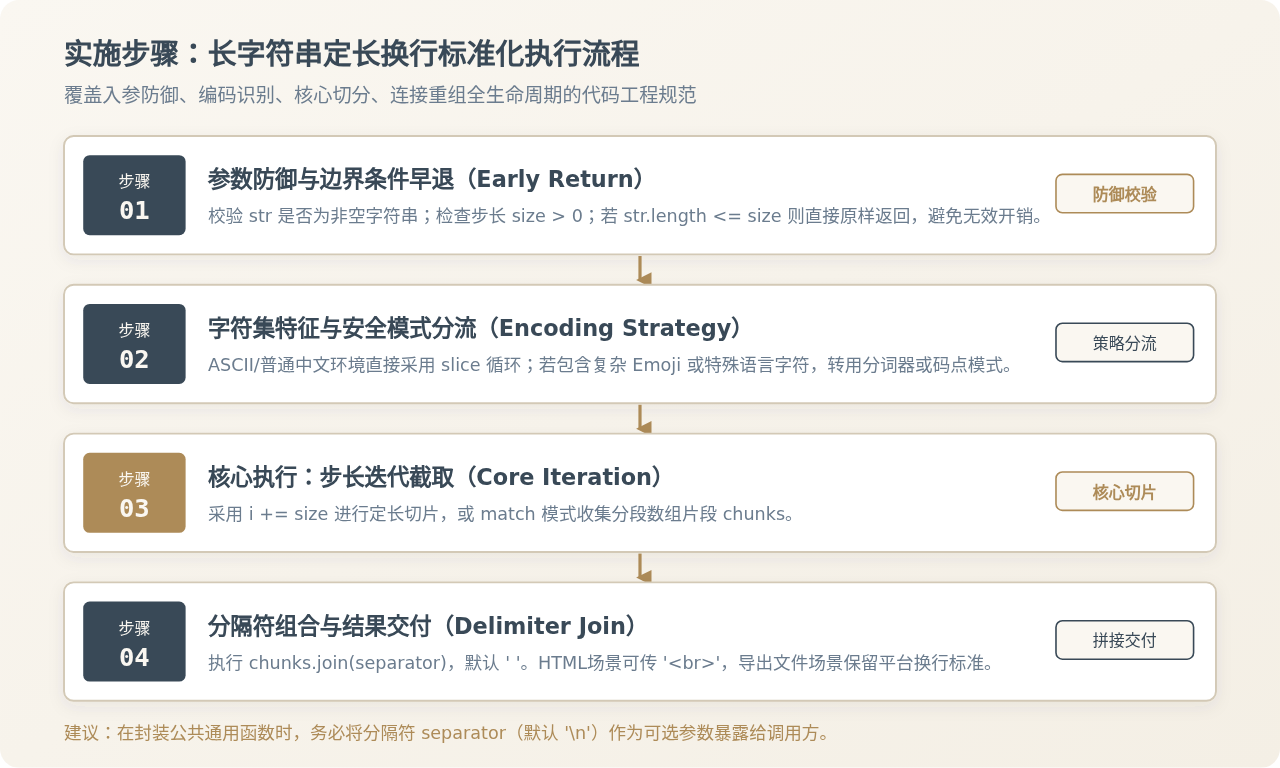
图 2:长字符串定长换行标准化执行流程与四步生命周期
2. 方法二:正则表达式法(极简单行实现)
如果代码追求简洁或在一次性轻量级脚本中,正则表达式是最优雅的选择。利用正则模式 [\s\S]{1,N} 全局匹配即可直接捕获所有分块。
/**
 * 正则单行匹配换行
 * 注意:使用 [\s\S] 匹配包括换行符在内的任意字符
 */
function wrapStringByRegex(str, size, sep = '
') {
  if (!str || size <= 0) return str || '';

  // 使用动态正则匹配 1 到 size 长度的任意字符
  const regex = new RegExp(`[\s\S]{1,${size}}`, 'g');
  const matches = str.match(regex);
  return matches ? matches.join(sep) : str;
}

// 示例验证
console.log(wrapStringByRegex('1234567890abcdefghij', 6));
/* 输出示例:
123456
7890ab
cdefgh
ij
*/
正则要点解析:[\s\S] 与 s 标志位
如果输入的原始字符串中本身已混入偶发的换行符或不可见控制符,常规的点号 . 可能会将其跳过导致行数计算失常。因此采用 [\s\S] 或配置 new RegExp(`.{1,${size}}`, 'gs'),确保任何字符都能被纳入计数窗口。
3. 方法三:Unicode/Emoji 安全截取(防止特殊字符断裂)
JavaScript 的普通字符串索引基于 UTF-16 代码单元(Code Unit)。常见的高位 Emoji(如 👨👩👧👦、🥑、🎉)或冷僻汉字在内存中由两个代码单元(代理对 Surrogate Pair)乃至多个代码点组成。
若恰巧在代理对中间(例如第 10 个 code unit)切断,该 Emoji 将瞬间损毁,变成无意义的乱码方块(如 �)。为了解决这个问题,需要按照字素簇(Grapheme Cluster)进行计量与切分。现代浏览器和 Node.js(v16+)提供了原生的 Intl.Segmenter API。
/**
 * 字符素感知换行(完美支持复杂 Emoji、复合符号)
 */
function wrapUnicodeString(str, size, sep = '
') {
  if (!str || size <= 0) return str || '';

  // 优先使用现代标准的 Intl.Segmenter 按人类直觉感知的字符切分
  if (typeof Intl !== 'undefined' && Intl.Segmenter) {
    const segmenter = new Intl.Segmenter('und', { granularity: 'grapheme' });
    const graphemes = Array.from(segmenter.segment(str), s => s.segment);

    const chunks = [];
    for (let i = 0; i < graphemes.length; i += size) {
      chunks.push(graphemes.slice(i, i + size).join(''));
    }
    return chunks.join(sep);
  }

  // 降级方案:使用 Array.from() 按 Unicode 码点解构(支持双字节 Emoji)
  const codePoints = Array.from(str);
  const chunks = [];
  for (let i = 0; i < codePoints.length; i += size) {
    chunks.push(codePoints.slice(i, i + size).join(''));
  }
  return chunks.join(sep);
}

// 示例验证:包含复合表情的字符串
const emojiString = '🍎🍌🍇🍉🍓🍒🍍🥑🥝🌽';
console.log(wrapUnicodeString(emojiString, 3));
/* 输出示例:
🍎🍌🍇
🍉🍓🍒
🍍🥑🥝
🌽
*/
四、各实现方案综合对比与技术选型
为了帮助开发者在实际项目中权衡利弊,下表与图示直观呈现了上述各方案在性能、字符安全与使用场景上的差异:
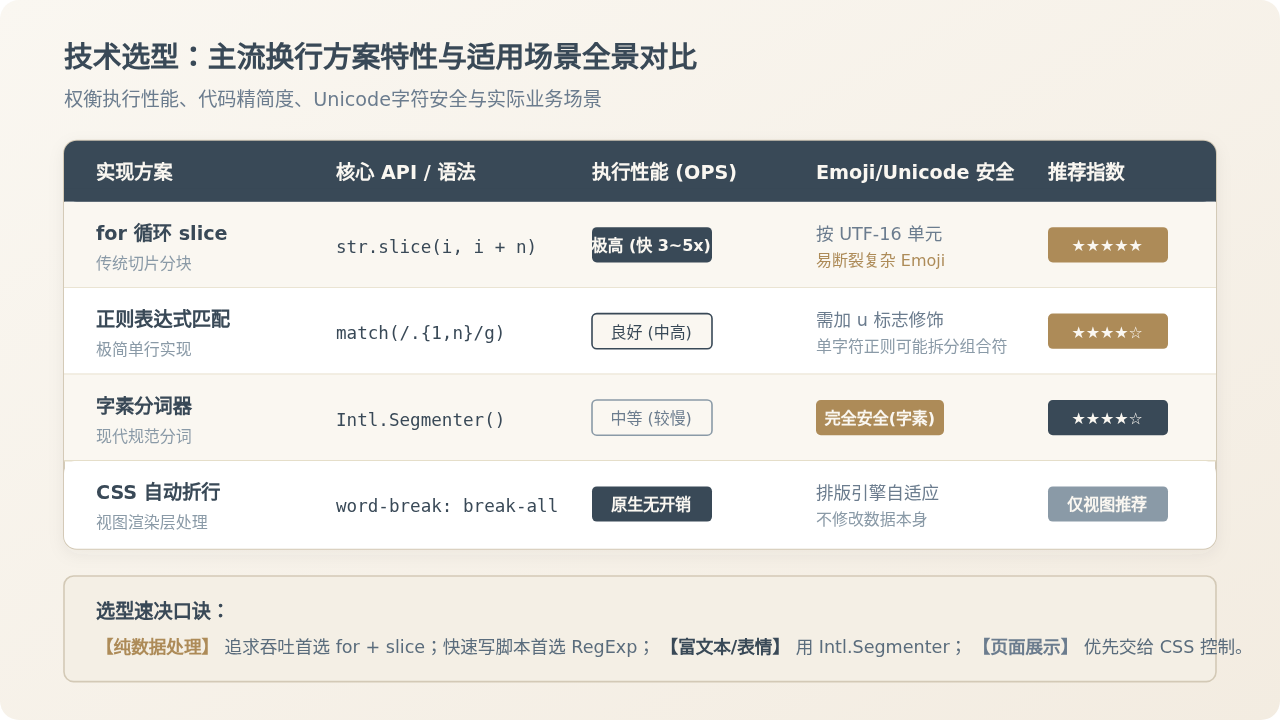
图 3:各换行实现方案特性与技术选型决策矩阵
| 实现方案 | 底层核心 API | 性能表现 | 字符安全度 | 最佳适用场景 |
|---|---|---|---|---|
| 循环 slice 法 | String.prototype.slice |
最优(数百万字符耗时毫秒级) | 基础(针对 UTF-16) | 通用数据格式化、PEM证书、大文件处理 |
| 正则表达式法 | String.prototype.match |
良好(内部正则引擎开销) | 中等(加 u 修饰符支持码点) | 中小型字符串、快速脚本、单行函数 |
| 字素分词器法 | Intl.Segmenter |
中等(分词逻辑较重) | 最高(彻底规避乱码) | 用户聊天输入、富表情文本、特定多语言排版 |
| CSS 样式断行 | word-break: break-all |
原生极快(渲染树折行) | 完全自适应(不改动数据) | 纯前端 DOM 视觉防溢出、表格单元格排版 |
五、实际场景关键注意事项与排坑指南
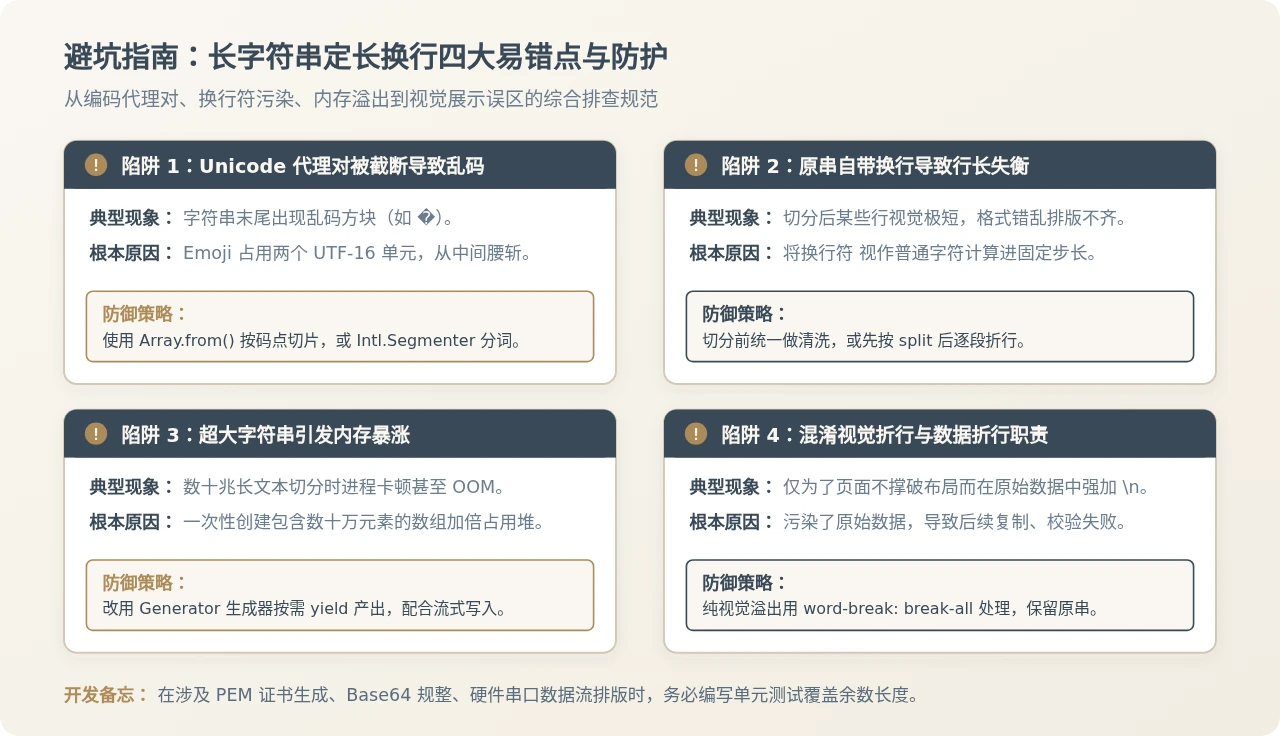
图 4:长字符串定长换行常见陷阱与防御规约
1. 换行符的跨平台与环境适配
在纯 Linux/macOS 环境或现代网络传输协议中,标准换行符为
(Line Feed, LF)。但在 Windows 传统文本文件或特定邮件协议(如 MIME)中,通常要求以
(CRLF)作为换行结束。
如果在网页 HTML 容器(非 <pre> 标签且未配置 white-space: pre-wrap;)中直接输出带
的文本,浏览器会将其合并为普通空格。此时需将分隔符参数替换为 <br> 或 <br />。
2. 超大字符串(数十兆字节)的内存保护
当长字符串规模达到数兆或数十兆字节(例如长 Base64 编码的附件或音视频文件)时,如果直接使用 str.match() 或在 for 循环中构建一个拥有数十万项的字符串数组,堆内存占用将瞬间飙升,容易触发 V8 引擎的垃圾回收卡顿甚至内存溢出(OOM)。
针对超大长文本,推荐采用 ES6 生成器(Generator)进行按需流式产出:
/**
 * 生成器迭代法:零临时大数组开销
 */
function* generateWrappedChunks(str, size) {
  if (!str || size <= 0) {
    if (str) yield str;
    return;
  }
  for (let i = 0; i < str.length; i += size) {
    yield str.slice(i, i + size);
  }
}

// 在 Node.js 可写流中逐行消费写入文件,避免内存占用过大
for (const line of generateWrappedChunks(hugeData, 64)) {
  // writableStream.write(line + '
');
}
六、总结
实现 JavaScript 长字符串按固定长度自动换行,核心在于厘清业务所处的层次与数据特征:
- 若属于页面视觉排版,优先交由 CSS
word-break: break-all;处理,绝不随意篡改底层业务数据。 - 若属于数据格式化或导出,首选
for循环配合str.slice()与join(' '),其具备最佳的运行性能与确定性,能够稳定应对各类常规字符。 - 如果涉及现代交互界面中频繁出现的 Emoji 表情或特殊符号,升级采用
Intl.Segmenter字素分词方案,以确保多字节字符的视觉完整性。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章