

针对旧版浏览器(如IE 8-11及早期WebView)不支持URLSearchParams的情况,提供纯原生、零外部依赖的URL参数截取方案,涵盖单参数正则匹配、全量对象解析及边界异常防范。
兼容旧浏览器的JS URL参数截取方案
作者:页面旅途
时间:2026-11-19
浏览:549
文章目录
在不支持现代
URLSearchParams 接口的旧版浏览器(如 IE 8~11、早期 Android WebView 或封闭式工控客户端)中,截取 URL 参数的最稳妥手段是利用原生字符串拆分或正则表达式,配合安全的 URI 解码与异常兜底,提取查询字符串。本文提供两种纯原生且零外部依赖的截取方案,并逐一剖析 SPA Hash 路由、多值同名参数及畸形字符编码等关键边界处理。
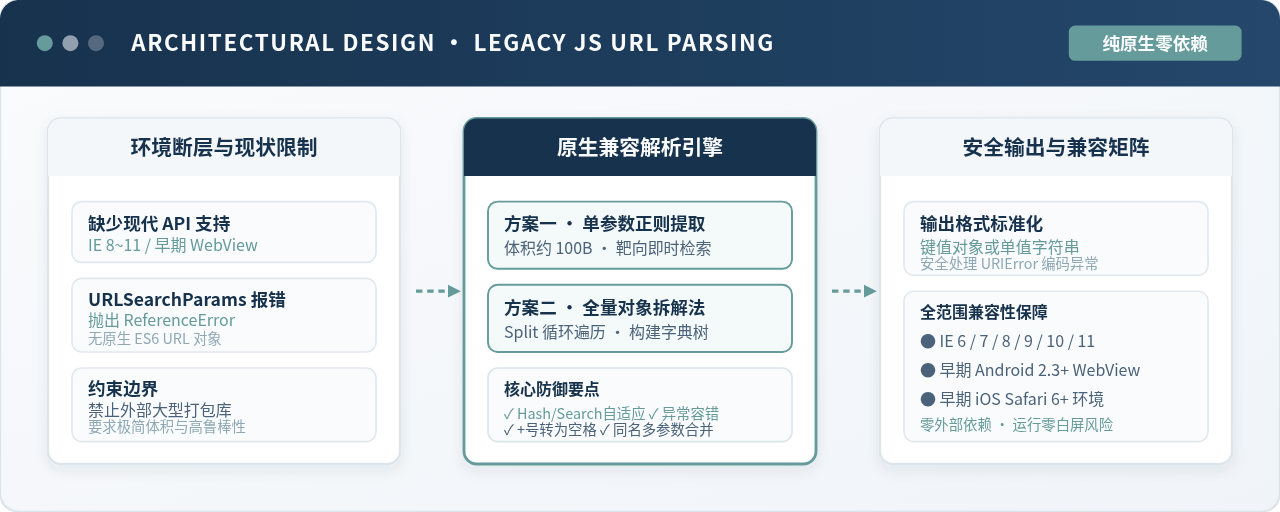
一、旧浏览器面临的环境断层与兼容痛点
现代前端开发中,获取地址栏参数通常只需一行代码:new URLSearchParams(window.location.search).get('id')。然而在旧版宿主环境中,这一 API 并不存在:
- IE 全系列完全不支持:从 IE 6 到最终版本的 IE 11,均未实现
URLSearchParams与现代URL构造函数。直接调用将立即引发ReferenceError: 'URLSearchParams' is not defined,导致整个脚本执行中断,页面呈现白屏。 - 早期嵌入式 WebView 缺失:在老旧的 Android 4.x/5.x 系统 WebView,或部分封闭式金融外设、车载终端内嵌的旧版 WebKit 中,现代 URL 处理对象均未内置。
- 轻量化场景无构建流水线支持:许多遗留系统维护、老活动页面嵌入或纯静态外链跳转脚本中,并没有引入 Webpack/Babel 的 Polyfill 打包工具,引入体积庞大的第三方库(如 polyfill.io 或数十 KB 的庞大库)极不现实,必须依赖纯原生、无依赖、轻量且稳健的代码段。
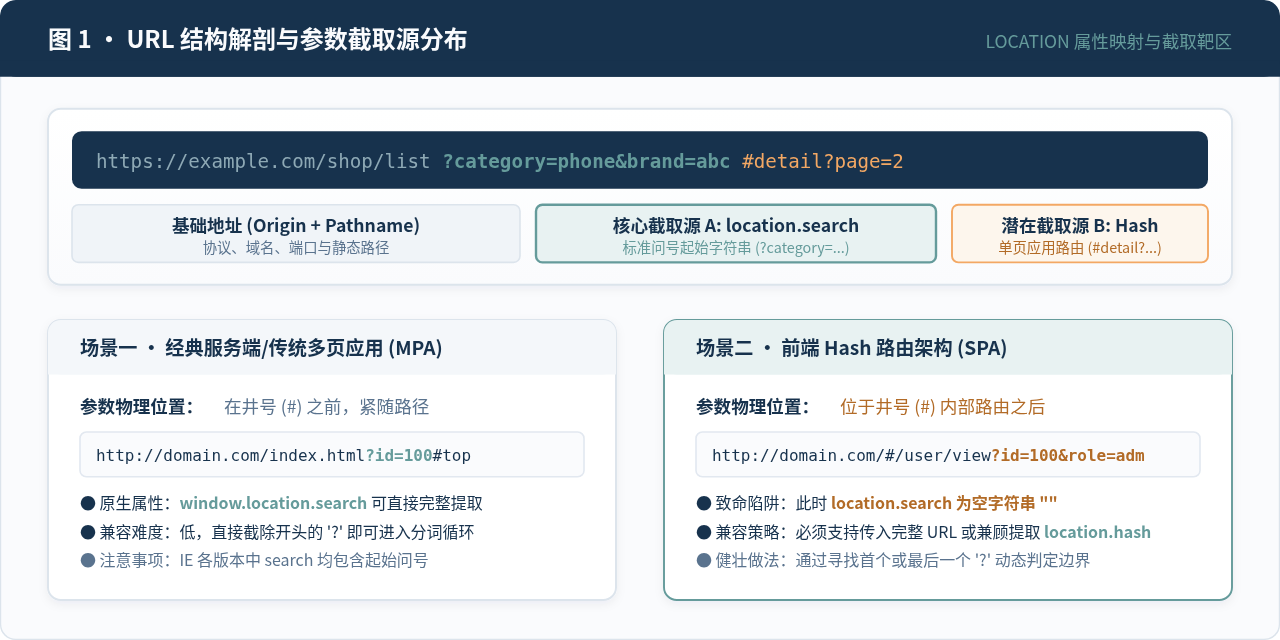
二、方案一:极致轻量的单参数正则截取函数
如果业务场景仅需读取某一个特定的 URL 参数(例如仅提取 token、userId 或 channel),编写一个轻量的正则匹配函数是最简洁且开销最低的做法。这种方案不需要在内存中构建任何字典结构,代码体积通常只有百余字节。
1. 完整实现代码
/**
 * 兼容旧浏览器的单参数提取函数(正则匹配法)
 * @param {string} name 需要截取的参数名
 * @param {string} [url] 可选的完整 URL,默认取当前页面 window.location.href
 * @return {string|null} 返回匹配并解码后的参数值,不存在时返回 null
 */
function getUrlParam(name, url) {
    if (!name) {
        return null;
    }
    // 兼容没有传入 url 的情况,优先取当前环境完整 href(覆盖 search 与 hash)
    var targetUrl = url || (window.location ? window.location.href : '');
    if (!targetUrl) {
        return null;
    }

    // 对参数名进行特殊正则字符转义,防止参数名本身含正则元字符导致崩溃
    var escapedName = name.replace(/[\[\]]/g, '\\$&');

    // 匹配规则:以 ? 或 & 或 # 开头,紧跟参数名,后接 =,捕获直到遇到 &、# 或结尾的所有字符
    var regex = new RegExp('(\?|&|#)' + escapedName + '=([^&#]*)', 'i');
    var matches = regex.exec(targetUrl);

    if (!matches || matches.length < 3) {
        return null;
    }

    // 提取未解码参数值
    var rawVal = matches[2];

    // 将 URL 查询参数中合法的 '+' 号还原为标准的空格字符
    var formattedVal = rawVal.replace(/\+/g, ' ');

    // 使用 try...catch 兜底 decodeURIComponent,防止遇到畸形 % 序列抛出 URIError 异常
    try {
        return decodeURIComponent(formattedVal);
    } catch (err) {
        // 遇到非法编码时平稳降级返回原字符串
        return formattedVal;
    }
}
2. 代码要点与适用边界
该正则方案通过 (\?|&|#) 作为前置边界,巧妙化解了传统只依赖 (\?|&) 时无法捕获 SPA Hash 路由后置参数的问题。同时,利用 [^&#]* 限制截断区间,避免将井号后面的锚点字符误读为参数值。
适用建议
单参数正则法非常适合营销落地页、短链接统计跳转或简单认证拦截等场景。但如果一个页面需要频繁截取 5 个以上的参数,正则法会重复遍历字符串数次,此时应采用下文的方案二。
三、方案二:工业级全参数解析对象法(推荐方案)
在绝大多数中后台系统与老业务维护中,最常见的要求是将 URL 中所有的查询参数一次性解析为一个原生的纯 JavaScript 键值对象(Object)。这既方便后续批量取用,也能优雅地处理同名多参数(转为数组)与无值参数。
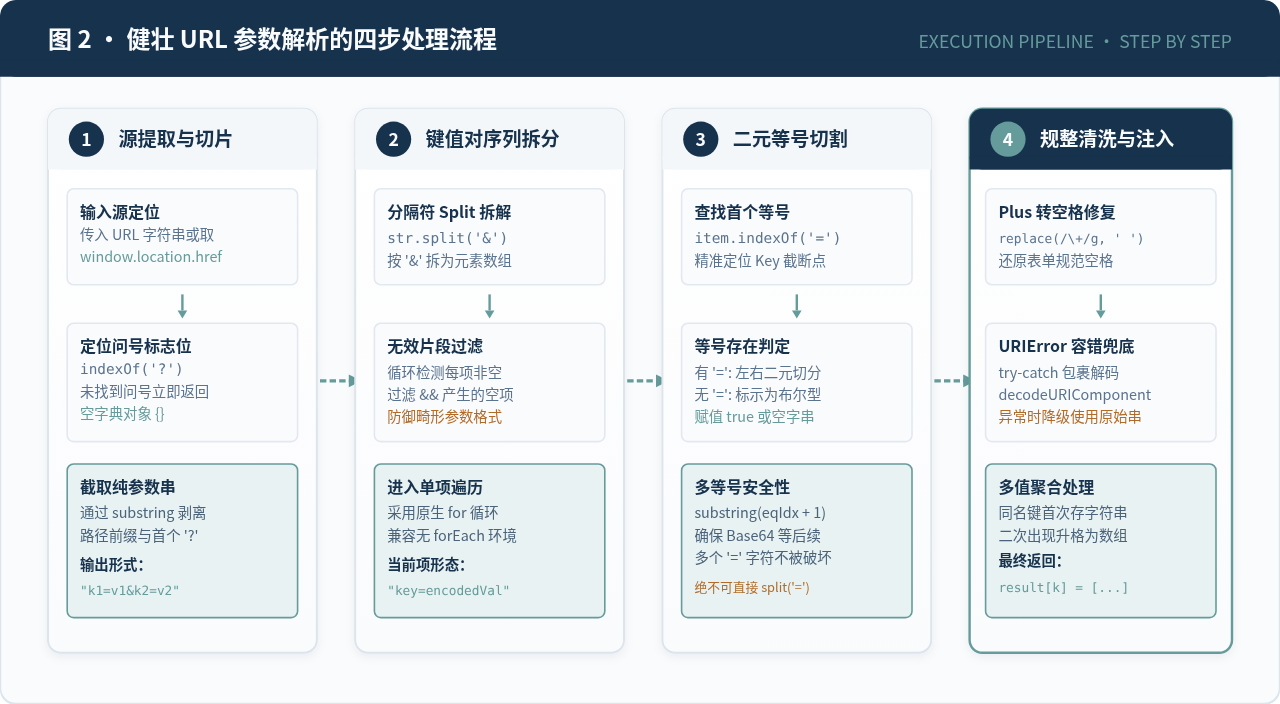
1. 完整实现代码
/**
 * 兼容旧浏览器的全参数解析函数(全量对象解析法)
 * @param {string} [url] 需要解析的 URL,默认读取当前页面完整 href
 * @return {Object} 返回解析后的参数字典
 */
function parseUrlParams(url) {
    var result = {};
    var targetUrl = url || (window.location ? window.location.href : '');
    if (!targetUrl || typeof targetUrl !== 'string') {
        return result;
    }

    // 步骤 1:定位参数起始问号。兼顾传统地址与 SPA Hash 路由
    var queryStart = targetUrl.indexOf('?');
    if (queryStart === -1) {
        return result;
    }

    // 截取第一个问号后面的所有内容
    var queryString = targetUrl.substring(queryStart + 1);

    // 步骤 2:按照 '&' 拆分各个键值对片段
    var pairs = queryString.split('&');

    for (var i = 0; i < pairs.length; i++) {
        var pair = pairs[i];
        if (!pair) {
            continue; // 过滤空段,如连续出现的 &&
        }

        // 如果参数串之后包含 Hash 片段(如 ?a=1#section),需要在此截除
        var hashIdx = pair.indexOf('#');
        if (hashIdx !== -1) {
            pair = pair.substring(0, hashIdx);
            if (!pair) {
                break; // 井号之后如果是锚点纯文本则不再继续
            }
        }

        // 步骤 3:严格使用首个 '=' 截断,保留后续值中可能存在的 '='
        var equalIdx = pair.indexOf('=');
        var rawKey = '';
        var rawVal = '';

        if (equalIdx === -1) {
            // 无等号参数(例如 ?debug&preview),将其赋为 true
            rawKey = pair;
            rawVal = 'true';
        } else {
            rawKey = pair.substring(0, equalIdx);
            rawVal = pair.substring(equalIdx + 1);
        }

        // 步骤 4:参数名与值的规范化清洗与安全解码
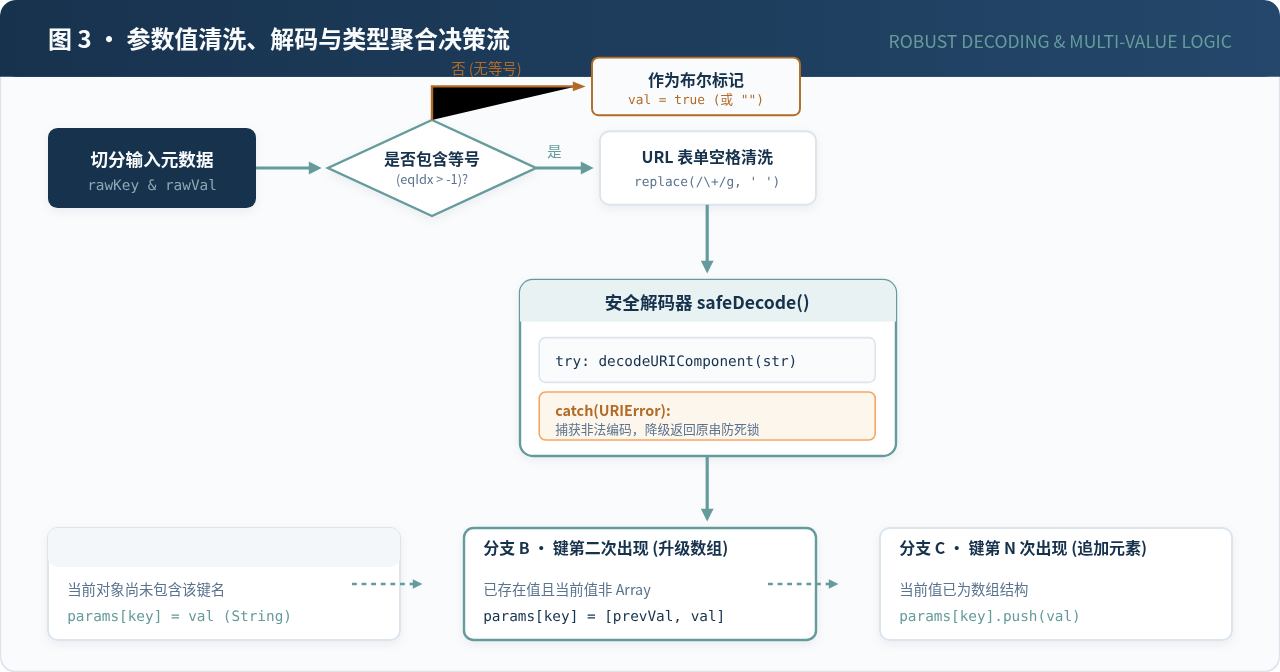
        var cleanKey = safeDecodeUriComponent(rawKey.replace(/\+/g, ' '));
        var cleanVal = safeDecodeUriComponent(rawVal.replace(/\+/g, ' '));

        if (!cleanKey) {
            continue;
        }

        // 处理同名多参数(例如 tags=js&tags=css)
        if (Object.prototype.hasOwnProperty.call(result, cleanKey)) {
            if (result[cleanKey] instanceof Array) {
                result[cleanKey].push(cleanVal);
            } else {
                result[cleanKey] = [result[cleanKey], cleanVal];
            }
        } else {
            result[cleanKey] = cleanVal;
        }
    }

    return result;
}

/**
 * 健壮的 URI 解码包装函数,兼容旧环境并杜绝 URIError
 */
function safeDecodeUriComponent(str) {
    if (!str) {
        return '';
    }
    try {
        return decodeURIComponent(str);
    } catch (e) {
        // 当遇到未转义的 '%' 等畸形字符时,降级原样返回
        return str;
    }
}
四、老旧浏览器下的四个致命细节陷阱
在编写兼容 IE 或老旧嵌入式容器的代码时,如果只简单执行 split('&') 和 decodeURIComponent,往往在特殊字符或生产边缘场景下触发难以排查的隐蔽 Bug。以下是必须落实的防御细节:
1. 空格编码的“加号”未还原问题
根据 W3C application/x-www-form-urlencoded 规范,URL 查询串中的空格通常会被编码为加号 +。然而,原生 JavaScript 的 decodeURIComponent() 仅会将 %20 解码为空格,对于 + 号则会原样保留。如果在解码前没有执行 replace(/\+/g, ' '),用户输入的 hello+world 就会被错误地读取为加号而非原本的空格。
2. 畸形百分号编码引发的 URIError 崩溃
老旧业务系统中经常会遇到未完全编码的特殊字符,例如截断的 Base64 编码、包含裸露的 % 字符(如折扣参数 discount=20%&flag=1)。原生 decodeURIComponent("20%") 会直接抛出未捕获的 URIError: URI malformed,导致后续逻辑完全停止。必须通过 try...catch 将解码逻辑包裹隔离,发生异常时降级返回原始串。
3. 参数值中自带等号(Base64 或嵌套 URL)
切忌使用 pair.split('=') 将参数项简单拆为两半。当参数值自身包含 Base64 补齐符(如 token=abc==&uid=1)或者内部嵌套了回调地址(如 redirect=https://site.com/auth?id=2)时,split('=') 会将第三个及之后的等号全部丢弃或截断。正确做法是利用 indexOf('=') 寻找第一个等号,并使用 substring() 分离左右部分。
4. SPA Hash 路由下参数错位
在基于前端 Hash 路由的 Vue / React 老旧兼容项目中,URL 往往呈现为 https://host.com/#/dashboard?orderId=1001。此时访问 window.location.search 得到的是完全为空的字符串 "",因为参数位于 # 之后,被挂载在 window.location.hash 上。如果解析函数只读 search,将无法读取到任何参数。因此,通用实现应优先读取 window.location.href,从全文动态定位 ? 所在位置。
五、方案三:轻量级 URLSearchParams Polyfill 实现
如果在既有的大型老旧项目中,已经存在大量使用现代 API(例如 params.get()、params.has())的业务代码,直接修改所有调用点工作量极大。此时可以引入一个轻量级的微型 Polyfill,仅向不支持的浏览器挂载标准的 URLSearchParams 构造器:
(function() {
    // 环境嗅探:如果已原生支持,则不重复挂载
    if (typeof window !== 'undefined' && window.URLSearchParams) {
        return;
    }

    function CompactURLSearchParams(search) {
        this.dict = {};
        if (!search) {
            return;
        }
        var query = search.charAt(0) === '?' ? search.substring(1) : search;
        var pairs = query.split('&');
        for (var i = 0; i < pairs.length; i++) {
            var pair = pairs[i];
            if (!pair) continue;
            var eq = pair.indexOf('=');
            var key = eq > -1 ? pair.substring(0, eq) : pair;
            var val = eq > -1 ? pair.substring(eq + 1) : '';
            key = decode(key);
            val = decode(val);
            if (!this.dict[key]) {
                this.dict[key] = [];
            }
            this.dict[key].push(val);
        }
    }

    function decode(s) {
        try {
            return decodeURIComponent(s.replace(/\+/g, ' '));
        } catch (e) {
            return s;
        }
    }

    CompactURLSearchParams.prototype.get = function(name) {
        return this.dict[name] ? this.dict[name][0] : null;
    };

    CompactURLSearchParams.prototype.getAll = function(name) {
        return this.dict[name] ? this.dict[name].slice(0) : [];
    };

    CompactURLSearchParams.prototype.has = function(name) {
        return Object.prototype.hasOwnProperty.call(this.dict, name);
    };

    // 挂载至全局宿主
    if (typeof window !== 'undefined') {
        window.URLSearchParams = CompactURLSearchParams;
    }
})();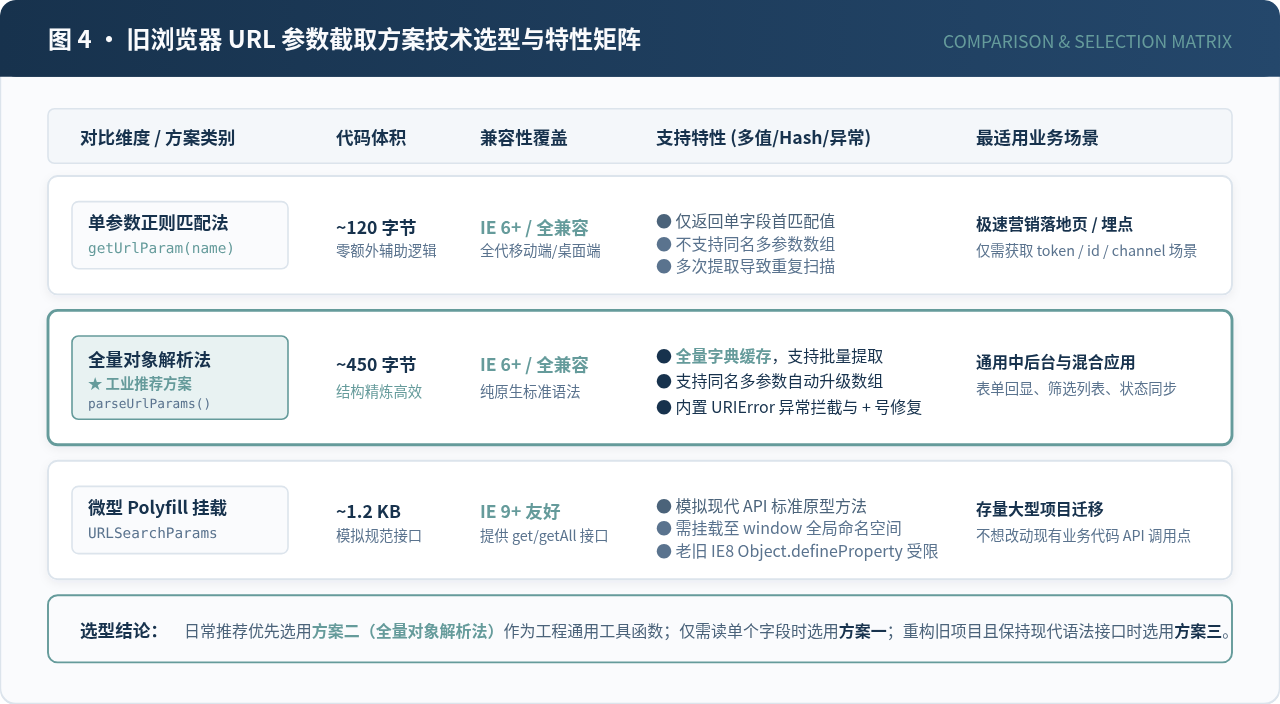
六、不同方案的选型对比与测试验证
| 方案名称 | 实现核心 | 体积开销 | IE 兼容度 | 同名数组支持 | 典型适用场景 |
|---|---|---|---|---|---|
| 单参数正则匹配法 | RegExp 捕获组 | ~120 字节 | IE 6+ 全版本 | 不支持 (仅取首值) | 活动埋点、简单 ID/Token 即时截取 |
| 全量对象解析法 | Split + 首等号截断 | ~450 字节 | IE 6+ 全版本 | 完全支持 (自动升格) | 中后台表单、参数联动、标准工程工具库 |
| 轻量 Polyfill 法 | 原型链挂载模拟 | ~1.2 KB | IE 9+ 最佳 | 支持 (通过 getAll) | 存量现代代码重构、维持 API 接口一致 |
生产测试用例验证
在旧版 IE(如通过 IE11 仿真模式切至 IE8/9)控制台中,可运行以下测试用例验证解析函数的鲁棒性:
// 测试测试用例:涵盖 +号空格、Base64等号、同名多值及无值标记
var testUrl = "http://legacy.test.com/index.html?keyword=hello+world&token=abc==&tag=js&tag=css&debug#hash?extra=1";

var params = parseUrlParams(testUrl);

console.log(params.keyword); // 输出: "hello world" (+号成功还原为空格)
console.log(params.token);   // 输出: "abc==" (尾部等号完整保留未截断)
console.log(params.tag);     // 输出: ["js", "css"] (同名多参数转换为数组)
console.log(params.debug);   // 输出: "true" (无值标记安全赋为 "true")
通过遵循上述规整步骤与容错规范,即可在不引入庞大外部依赖的前提下,确保 URL 参数提取代码在所有老旧浏览器及封闭内嵌终端中平稳、安全运行。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章