

深入解析如何在 JavaScript 中使用原生 DOMParser API 将 HTML 字符串转换为独立内存 DOM 树,并使用标准 DOM 方法安全、精准地提取目标文本与属性。
JS使用DOMParser解析HTML字符串并提取内容
作者:像素漫游
时间:2026-11-19
浏览:194
文章目录
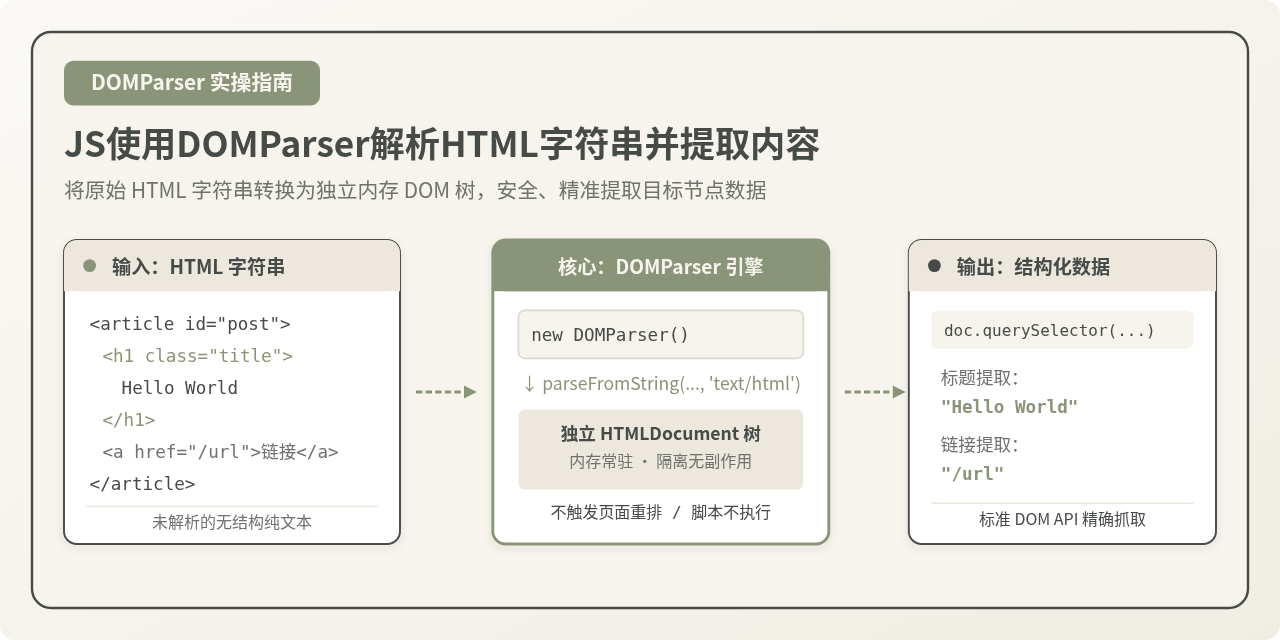
在 JavaScript 开发中,从服务端 API、富文本输入框或剪贴板接收到的数据往往是一串未渲染的 HTML 字符串。直接使用正则表达式截取这些内容极易因标签嵌套、属性顺序或换行格式变化而失效;而借助浏览器原生提供的
DOMParser API,可以在内存中将 HTML 字符串构造成一个标准且独立的 DOM 树,进而使用诸如 querySelector、textContent 等原生方法稳健、高效地提取所需内容。
一、DOMParser 的核心工作机制与基础语法
DOMParser 是浏览器自带的原生构造函数,它的核心职责是将包含 XML 或 HTML 语法的纯文本字符串,解析并转换成标准的 Document 对象。与直接将字符串写入页面不同,DOMParser 在执行解析时是在完全与当前页面视图解耦的内部环境中构建 DOM 节点。
使用 DOMParser 的基本语法十分精简,仅需完成实例化与方法调用两步:
// 1. 创建 DOMParser 解析器实例
const parser = new DOMParser();

// 2. 将 HTML 字符串解析为 Document 树
const htmlString = `
  <div class="card">
    <h2 class="title">前端开发实践</h2>
    <a href="https://example.com/item" class="link">详情链接</a>
  </div>
`;
const doc = parser.parseFromString(htmlString, 'text/html');

// 3. 从解析出的文档中提取所需内容
const title = doc.querySelector('.title').textContent;
const linkUrl = doc.querySelector('.link').getAttribute('href');

console.log(title);   // 输出: "前端开发实践"
console.log(linkUrl); // 输出: "https://example.com/item"
在调用 parseFromString 方法时,传入了两个参数:第一个是待解析的字符串,第二个是 MIME 类型。对于 HTML 字符串,第二个参数必须精确传递 'text/html'。调用返回的 doc 是一个标准的 HTMLDocument 对象,拥有与全局 document 相同的查询与遍历能力。
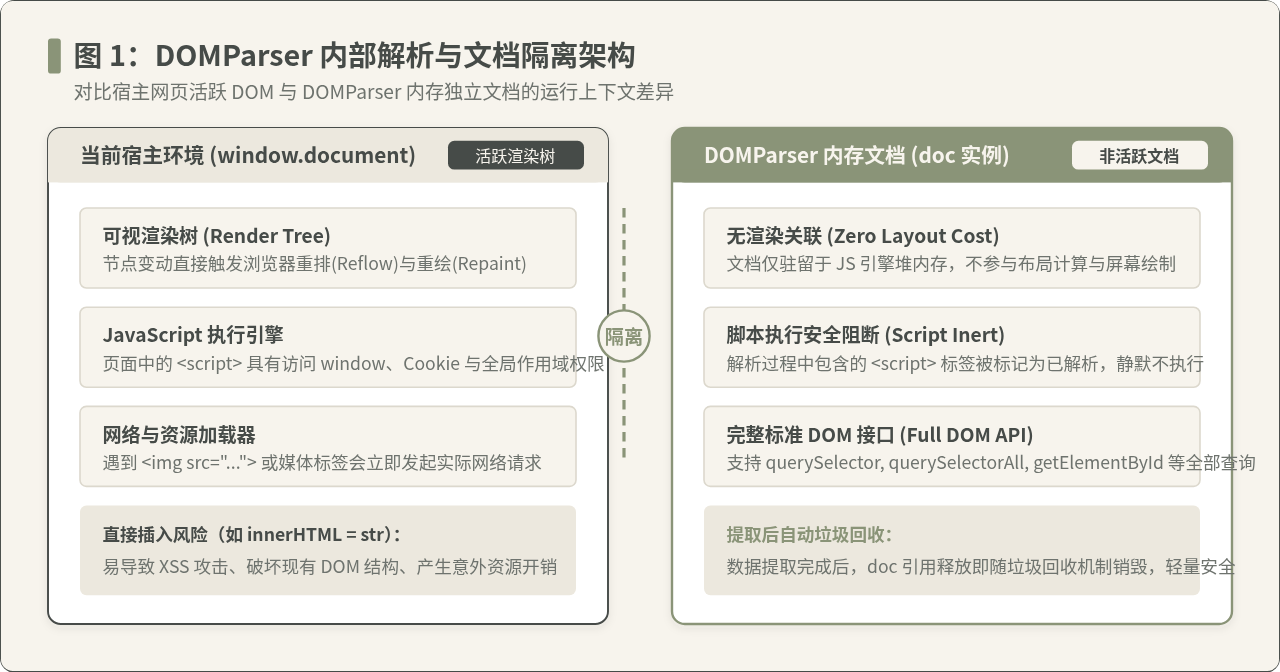
图 1:DOMParser 内部解析与文档隔离架构(对比宿主页面活跃树与内存隔离文档)
二、四步实操:使用 DOMParser 提取目标内容
无论待处理的 HTML 字符串是简单的段落还是复杂的多层列表,使用 DOMParser 提取内容的流程都可以清晰归纳为以下四个固定步骤。
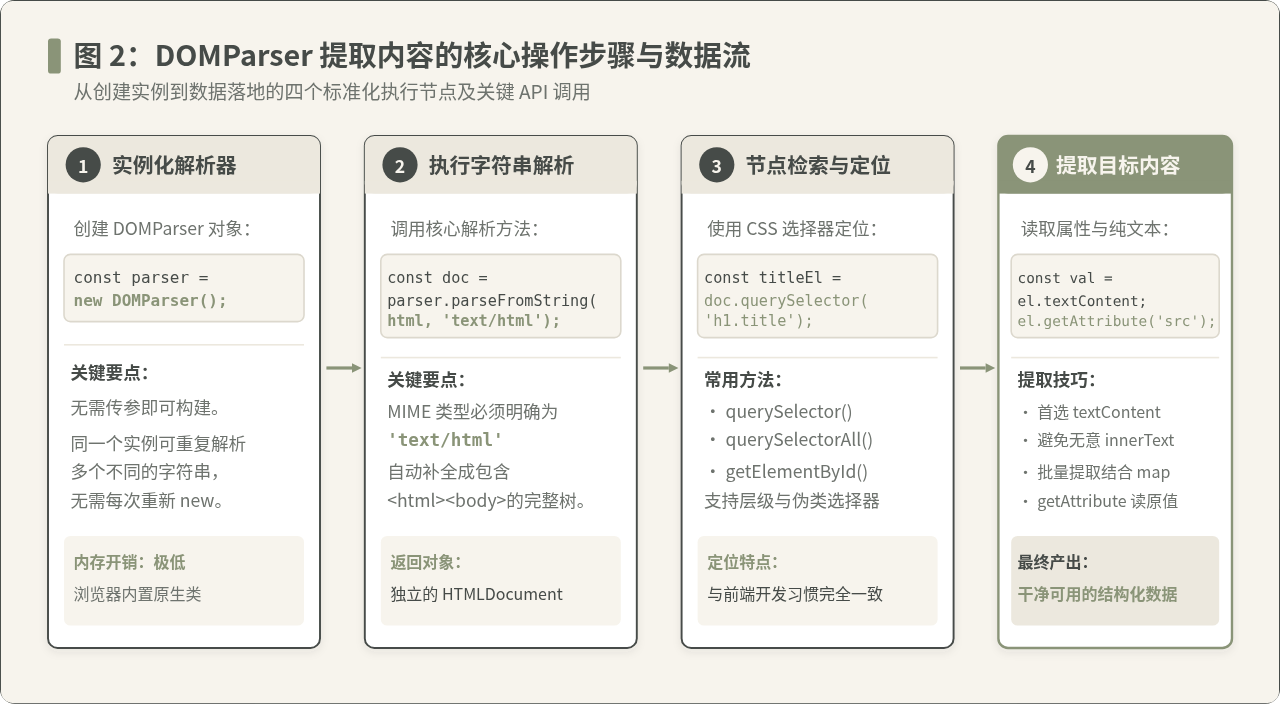
图 2:DOMParser 提取内容的核心操作步骤与数据流
第 1 步:创建解析器实例
调用 new DOMParser() 创建解析器。DOMParser 实例本身非常轻量,且具有无状态复用的特性。在同一个模块中需要循环解析多个 HTML 字符串时,只需保留一个单例对象即可,无需在循环内部频繁重复创建。
第 2 步:解析并生成文档对象
执行 parser.parseFromString(str, 'text/html')。值得注意的是,浏览器依据 HTML5 规范解析时,即使传入的字符串只是一个微小的局部片段(例如 <span>测试</span>),返回的 Document 依然会被规范自动补全为包含 <html>、<head> 与 <body> 的完整文档树结构。局部节点默认均挂载于 doc.body 之下。
第 3 步:定位与筛选目标节点
在得到的 doc 对象上,可以无缝使用前端开发者最熟悉的标准选择器方法:
doc.querySelector(selector):获取匹配 CSS 选择器的首个节点,未找到时返回null;doc.querySelectorAll(selector):获取所有匹配节点的静态NodeList集合;doc.getElementById(id):根据元素 ID 快速定位节点。
第 4 步:获取数据与清理格式
找到对应节点后,根据提取需求读取具体属性值或文本内容:
- 纯文本提取:推荐使用
node.textContent.trim()。textContent会忠实返回节点及其全部子孙节点的文本内容,并且不会触发视图排版计算。 - 属性值提取:使用
node.getAttribute('attrName')获取原始属性值,例如读取链接的href或图片的src;如需读取自定义数据属性,可访问node.dataset.name。 - 批量列表提取:结合
Array.from(doc.querySelectorAll(...))搭配map()方法将多节点批量映射为结构化的 JavaScript 数组或对象。
多节点与复杂列表解析完整示例
// 模拟从接口返回的 HTML 列表片段
const rawHtml = `
  <div class="catalog">
    <ul class="book-list">
      <li class="book-item" data-id="101">
        <span class="book-title">JavaScript 权威指南</span>
        <span class="price">¥ 119.00</span>
        <a href="/books/101" class="buy-btn">购买</a>
      </li>
      <li class="book-item" data-id="102">
        <span class="book-title">深入浅出 Node.js</span>
        <span class="price">¥ 79.00</span>
        <a href="/books/102" class="buy-btn">购买</a>
      </li>
    </ul>
  </div>
`;

// 实例化并解析
const parser = new DOMParser();
const doc = parser.parseFromString(rawHtml, 'text/html');

// 批量提取为对象数组
const items = Array.from(doc.querySelectorAll('.book-item')).map(item => {
  const titleEl = item.querySelector('.book-title');
  const priceEl = item.querySelector('.price');
  const linkEl = item.querySelector('.buy-btn');

  return {
    id: item.dataset.id,
    title: titleEl ? titleEl.textContent.trim() : '',
    price: priceEl ? priceEl.textContent.trim() : '',
    url: linkEl ? linkEl.getAttribute('href') : ''
  };
});

console.log(items);
// 示例输出:
// [
//   { id: "101", title: "JavaScript 权威指南", price: "¥ 119.00", url: "/books/101" },
//   { id: "102", title: "深入浅出 Node.js", price: "¥ 79.00", url: "/books/102" }
// ]
三、方案辨析:为什么选择 DOMParser 而非替代手段?
在很多开发讨论中,常能见到另外两种提取 HTML 内容的方式:一种是通过创建临时 div 并设置 innerHTML;另一种是编写正则表达式直接匹配标签文本。这两种做法虽然也能在某些简单用例下拿到结果,但在面对真实场景时存在明显缺陷。
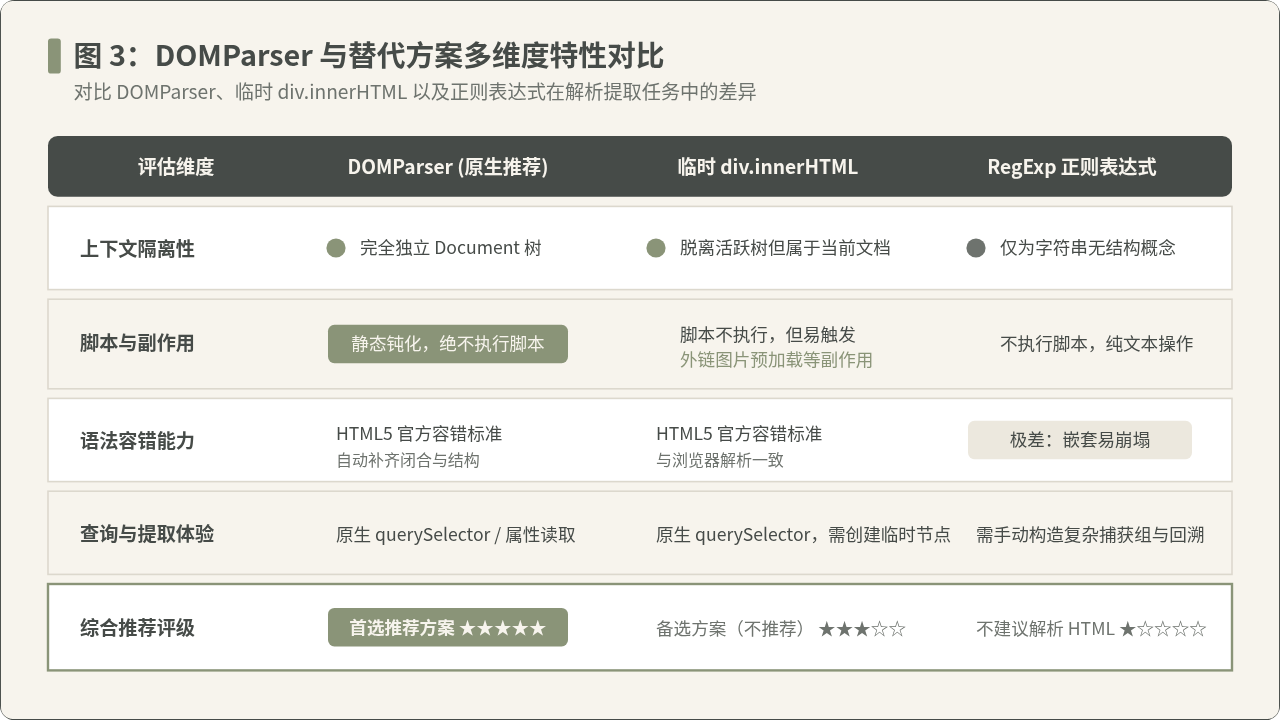
图 3:DOMParser 与替代方案多维度特性对比
1. 辨析:临时容器 div.innerHTML 的隐患
许多开发者习惯写 const div = document.createElement('div'); div.innerHTML = html;。这种做法看似直观,但有两点容易被忽视的副作用:
- 资源预加载副作用:当把包含
<img src="https://example.com/banner.png">的字符串赋值给活跃文档中创建的临时div.innerHTML时,浏览器可能立即触发对该图片资源的静默网络请求,即便这个临时div最终根本没有插入到页面中,从而造成不必要的网络带宽浪费。 - 上下文未完全隔离:临时创建的
div依然归属于当前主窗口的document,其原型链与当前页面紧密耦合。而DOMParser产生的Document是完全独立的堆内存对象,对当前运行环境的影响降到了最低。
2. 辨析:正则表达式匹配 HTML 的脆弱性
试图用类似 /<h1 class="title">(.*?)<\/h1>/i 的正则表达式去提取内容,在理论上貌似成立,但真实世界中的 HTML 具有极高的语法弹性:属性顺序可能颠倒(如 <h1 id="top" class="title">)、标签可能包含任意换行和空格、属性值可能采用单引号或双引号、标签内部可能嵌套同名子标签。这些极其常见的情况会让正则表达式迅速变得冗长晦涩且易于崩溃。HTML 是上下文无关语法层级的语言,解析它应当始终交给经过专门设计的状态机解析器。
四、进阶细节与避坑指南
在深入使用 DOMParser 的过程中,有以下几个关键细节需要掌握:
重要注意点:HTML 模式下的容错机制与错误检测
当 MIME 类型设为 'text/html' 时,DOMParser 遵循浏览器的宽松解析规则。哪怕传入的 HTML 存在标签未闭合或结构混乱,解析器也不会抛出 JavaScript 运行时异常,而是会自动纠正闭合位置并构建 DOM。如果需要严格验证 XML/SVG 的语法合法性,则必须使用 'application/xml',并在解析结果中检索 <parsererror> 标签以判断是否存在语法错误。
1. 为什么读取纯文本应优先选 textContent 而非 innerText?
在已渲染的页面中,innerText 会感知 CSS 样式(例如 display: none 的元素其 innerText 为空),并且在读取时可能触发页面的重排计算。然而,由 DOMParser 生成的文档并未与任何可视窗口关联,缺乏计算好的样式上下文,因此各浏览器内核对非活跃文档中 innerText 的处理细节可能存在细微差异。相比之下,textContent 严格按照 DOM 节点树的文本流返回内容,执行效率更高,行为表现也完全一致。
2. 安全边界:解析安全不等于插入安全
这是一个非常容易混淆的认知点:使用 DOMParser 解析包含恶意 <script> 的字符串是安全的,因为解析过程中脚本不会执行;但如果你随后把解析出来的 DOM 节点又通过 appendChild 或 innerHTML 插入到了当前真实渲染的网页中,恶意代码依然会立刻被触发执行。
因此,安全边界非常明确:如果只是单纯从 HTML 中“提取”文本、数字或链接,DOMParser 是安全可靠的;但如果业务目的是清洗并“展示”不受信任的富文本内容,必须配合专门的 XSS 防御库(如 DOMPurify)进行白名单过滤。
五、全景决策与选型总结
在实际项目架构中,对于 HTML 字符串内容的解析与提取,可以参考下方的决策路径选择最佳技术落地方案。
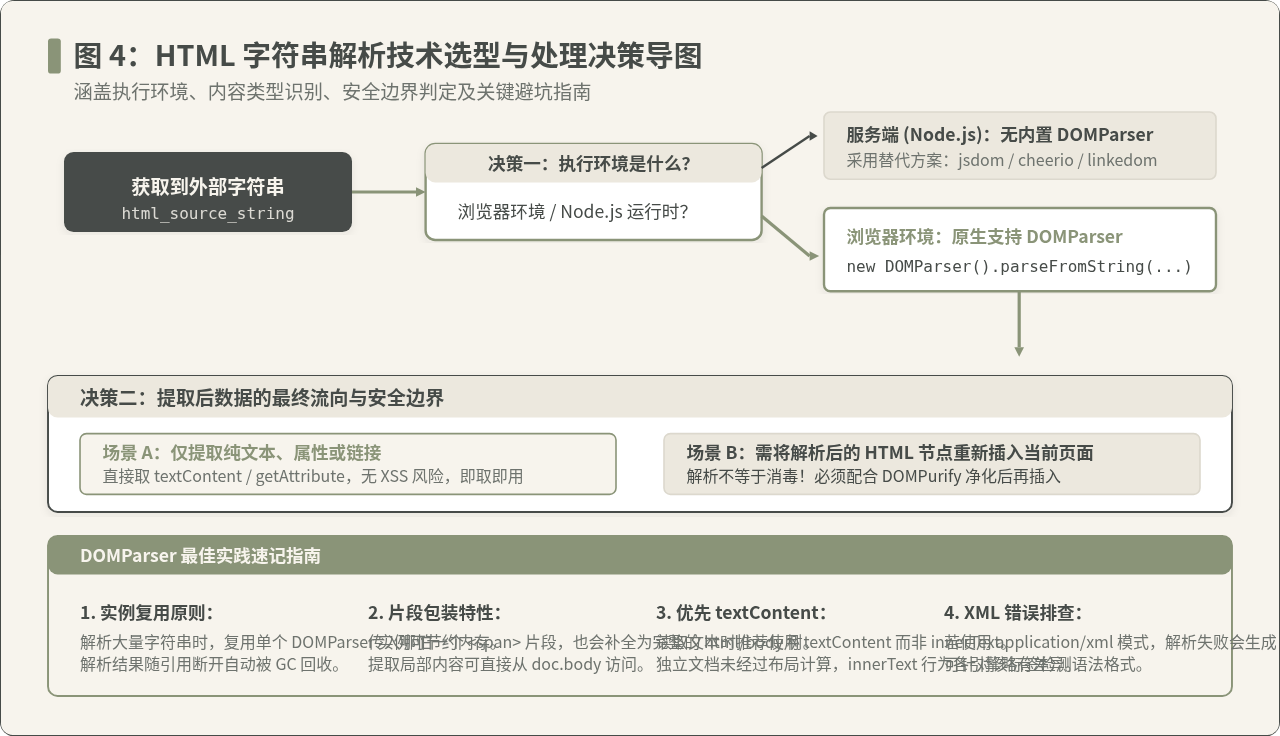
图 4:HTML 字符串解析技术选型与处理决策导图
综上所述,浏览器原生提供的 DOMParser 是前端解析 HTML 字符串的首选方案。它免除了额外加载外部解析库的包体积负担,利用底层 C++ 编写的浏览器解析引擎提供极致的解析性能与工业级容错性,同时配合语义清晰的 CSS 选择器体系,能够让开发者以极低的心智负担完成复杂结构化数据的安全提取。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章