
详细讲解如何使用JavaScript遍历HTML表格获取所有行数据的实用教程。涵盖table.rows/row.cells原生属性与querySelectorAll/Array.from现代方法,提供完整代码示例、单元格文本清洗、输入框取值及合并单元格处理技巧。

当前位置:首页 > JavaScript DOM 与事件 > 正文
JS怎么遍历HTML表格获取所有行数据
作者:像素漫游
时间:2026-11-19
浏览:262
文章目录
JavaScript DOM
前端数据抽取
阅读时间:约 8 分钟
适用环境:现代浏览器 & 原生 JS (ES6+)
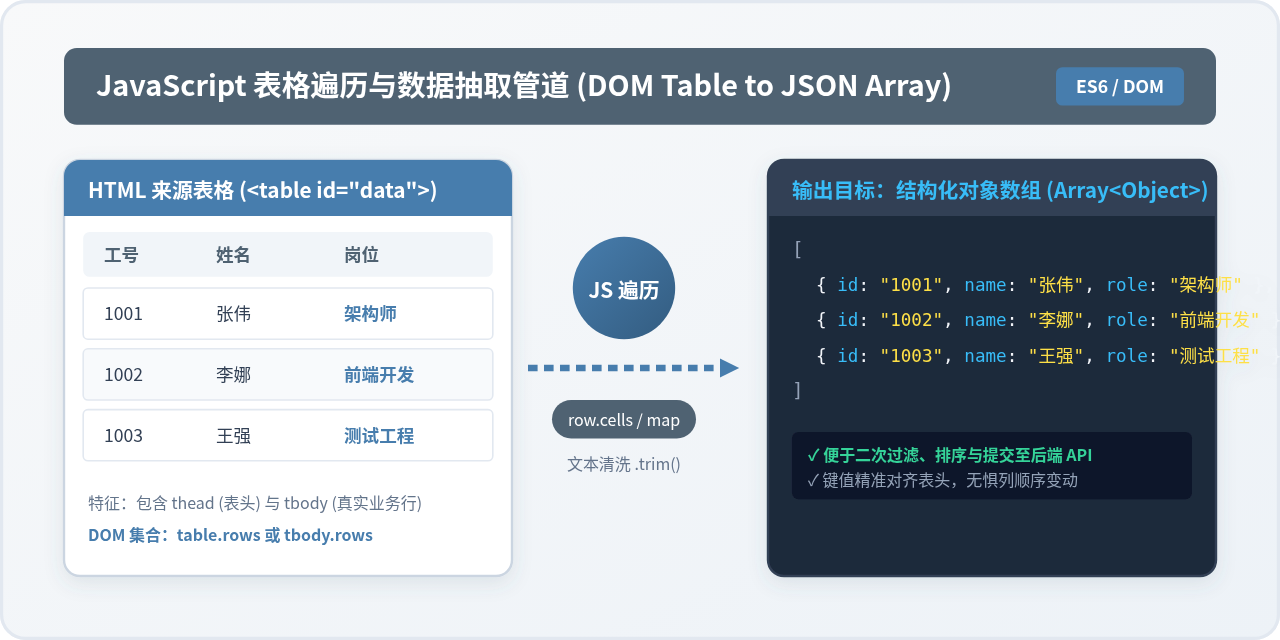
在 JavaScript 中遍历 HTML 表格获取所有行数据,核心在于获取表格行元素集合(
HTMLCollection 或 NodeList),再通过循环迭代提取每个单元格的内容。常用且可靠的实现方案主要有两种:一种是利用 W3C HTMLTable 规范提供的原生属性 table.rows(或 tbody.rows)和 row.cells,执行性能最高;另一种是利用现代 DOM 选择器 querySelectorAll('tbody tr') 配合 Array.from() 与 map(),代码更为紧凑且便于接入现代函数式数据流。本文将系统拆解这两种实现方式,深入讲解从表头过滤、单元格文本清洗到处理输入框等表单控件的具体操作与避坑要点。
示例表格与 DOM 树层级分析
为了让代码示例具有明确的参照物,我们先设定一个标准的员工数据表格。该表格包含常规的表头 <thead>、主体数据容器 <tbody>,并在单元格中包含工号、姓名、部门及薪资信息:
| 工号 | 姓名 | 所属部门 | 基础薪资 |
|---|---|---|---|
| 1001 | 张伟 | 技术架构部 | 28000 |
| 1002 | 李娜 | 产品运营部 | 18500 |
| 1003 | 王强 | 质量保障部 | 16000 |
许多初学者在提取表格数据时最容易犯的错误是直接对 table.rows 发起遍历,却忘记了该属性返回的是整个表格包含 <thead> 在内的所有行。这意味着索引 0 对应的并非数据,而是列名表头,极易导致后续的数据类型转换或字段映射抛出异常。
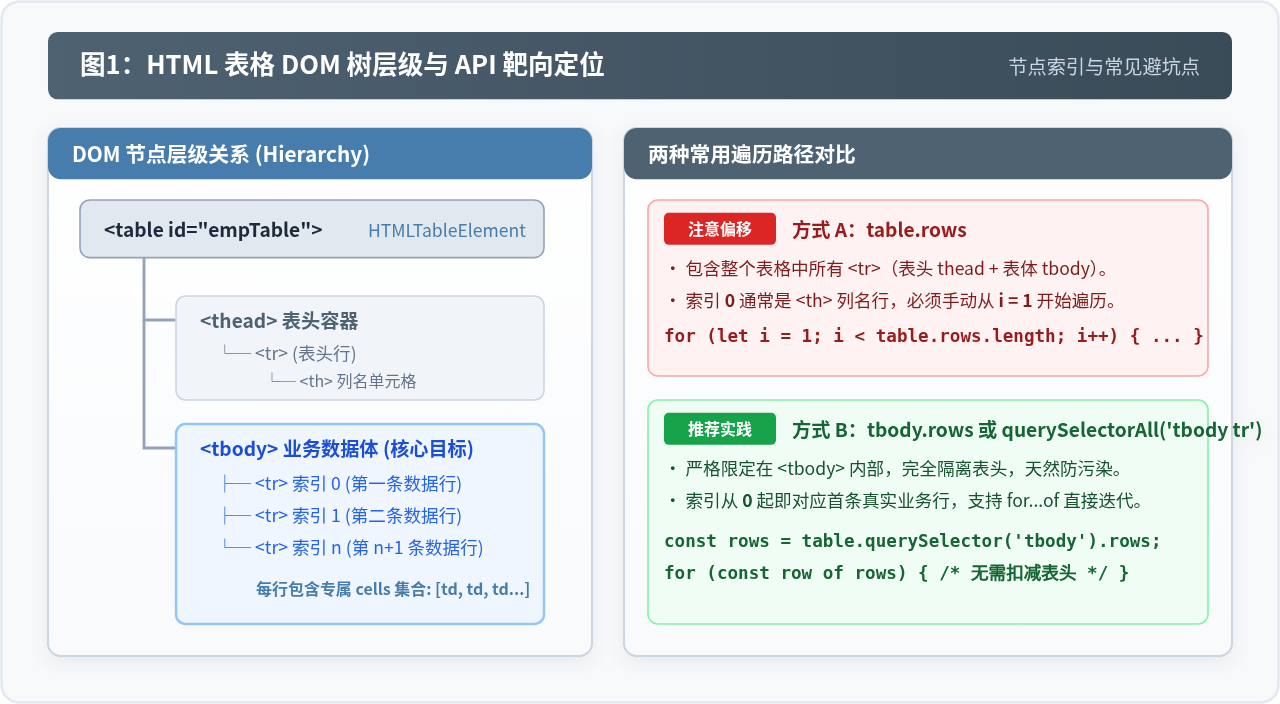
从 DOM 层级看,明确区分 table.rows 与 tbody.rows 是编写稳健代码的第一步:
- table.rows:属于
HTMLTableElement接口,按文档顺序返回表格内所有的行,包含<thead>、<tbody>和<tfoot>。如果使用此属性,循环必须显式从索引 1 开始以剔除表头。 - tbody.rows:属于
HTMLTableSectionElement接口,严格仅返回该<tbody>下的子数据行。从该集合的第一项开始即为真正的业务记录,不会与表头发生混淆。 - row.cells:属于
HTMLTableRowElement接口,返回当前行内包含的所有单元格(无论其标签为<td>还是<th>)。
方案一:使用原生 DOM 属性 (table.rows / row.cells) 遍历
原生 DOM API 具有执行速度极快、内存开销极小的特点,因为它直接访问浏览器已经构建好的底层节点映射,不需要经过 CSS 选择器引擎的词法解析。该方案的执行流程分为四个规范步骤:
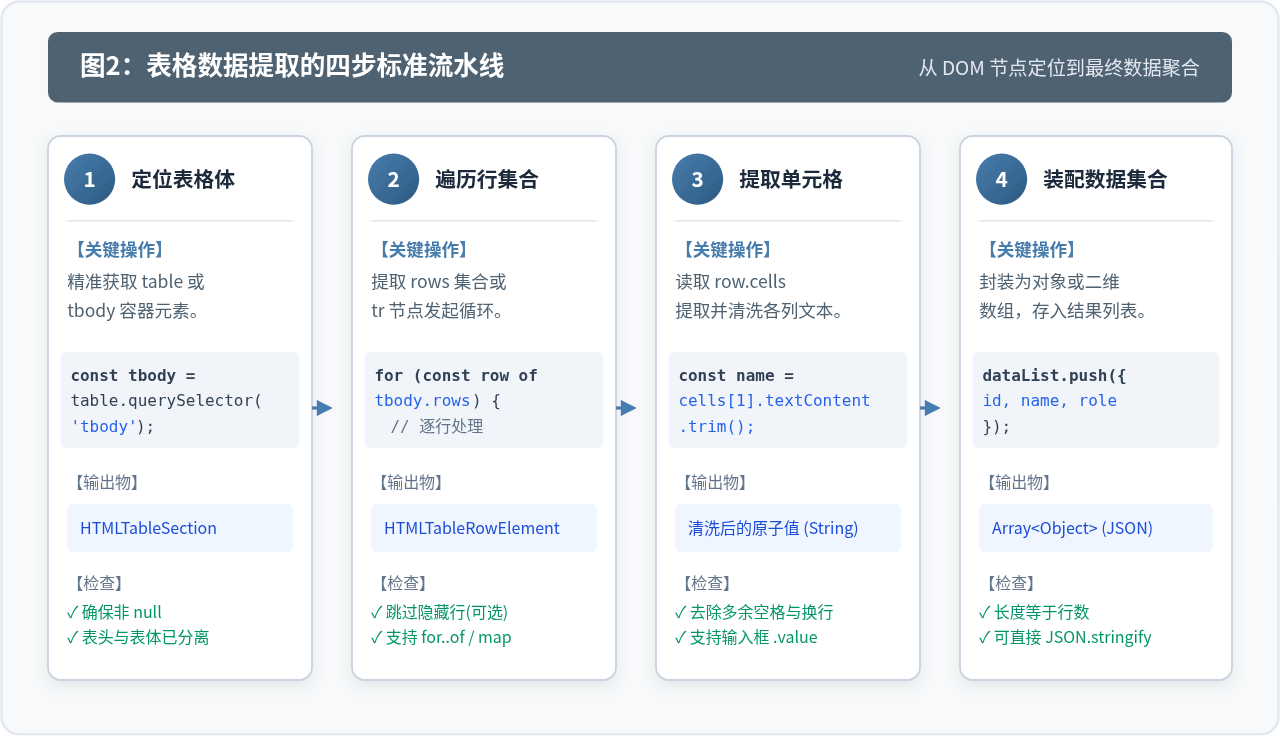
1. 完整实现代码
以下代码演示了如何定位表格主体、遍历每一行并按列索引将单元格文本转换为结构化的 JavaScript 对象数组:
// 步骤 1:定位表格主体容器元素
const table = document.getElementById('employeeTable');
if (!table) {
  console.error('未找到指定的表格元素');
}

// 优先锁定 tbody,隔离表头 <thead> 带来的索引干扰
const tbody = table.querySelector('tbody') || table;
const resultList = [];

// 步骤 2:遍历每一行
for (let i = 0; i < tbody.rows.length; i++) {
  const row = tbody.rows[i];

  // 步骤 3:获取当前行的单元格集合
  const cells = row.cells;
  if (cells.length < 4) continue; // 跳过可能存在的空行或异常合并行

  // 步骤 4:提取列文本并执行清洗操作
  const rowData = {
    id: cells[0].textContent.trim(),
    name: cells[1].textContent.trim(),
    department: cells[2].textContent.trim(),
    salary: Number(cells[3].textContent.trim()) || 0
  };

  resultList.push(rowData);
}

console.log('提取结果:', resultList);
控制台示例输出 (示例结果)
[
  { "id": "1001", "name": "张伟", "department": "技术架构部", "salary": 28000 },
  { "id": "1002", "name": "李娜", "department": "产品运营部", "salary": 18500 },
  { "id": "1003", "name": "王强", "department": "质量保障部", "salary": 16000 }
]
为什么用 textContent 而非 innerText?
在遍历单元格时,推荐优先使用
在遍历单元格时,推荐优先使用
textContent。原因是 innerText 会感知 CSS 样式并触发浏览器的重排(reflow),如果表格行数成百上千,频繁访问 innerText 会导致页面出现明显卡顿;而 textContent 只读取纯文本节点内容,性能损耗极低。
方案二:使用 querySelectorAll 与现代 ES6+ 语法
在现代前端工程开发中,开发者往往更倾向于函数式编程风格。通过 querySelectorAll 结合 Array.from() 或展开运算符,能够以非常简练的代码完成数据提取、筛选与格式转换。
1. 动态对齐表头的高级映射实现
硬编码列索引(例如 cells[0]、cells[1])在实际开发中存在风险——如果后端调整了列顺序或者用户自定义了表格列展示,硬编码的索引就会取错字段。更优雅的做法是先提取 <th> 中的表头名,再动态生成键值对:
function getTableDataDynamically(tableSelector) {
  const table = document.querySelector(tableSelector);
  if (!table) return [];

  // 1. 动态抓取表头标题,作为结果对象的 Key 列表
  const headers = Array.from(table.querySelectorAll('thead th')).map(
    th => th.textContent.trim()
  );

  // 2. 选择 tbody 内的所有数据行并链式转化
  const rows = Array.from(table.querySelectorAll('tbody tr'));

  return rows.map(row => {
    const cellElements = Array.from(row.querySelectorAll('td'));

    // 利用 reduce 根据表头数组组装成键值对象
    return headers.reduce((record, headerName, idx) => {
      const td = cellElements[idx];
      record[headerName] = td ? td.textContent.trim() : '';
      return record;
    }, {});
  });
}

// 调用示例
const tableData = getTableDataDynamically('#employeeTable');
console.log(tableData);
控制台示例输出 (示例结果)
[
  { "工号": "1001", "姓名": "张伟", "所属部门": "技术架构部", "基础薪资": "28000" },
  { "工号": "1002", "姓名": "李娜", "所属部门": "产品运营部", "基础薪资": "18500" },
  { "工号": "1003", "姓名": "王强", "所属部门": "质量保障部", "基础薪资": "16000" }
]这种写法的核心优势在于解耦:无论将来列顺序如何调整或新增列,代码均无需手动改写硬编码索引,结果对象将严格根据当前的 HTML 表头自适应映射。
复杂场景:表单控件与特殊单元格的提取细节
在实际生产环境中,表格通常不仅仅展示静态文本,往往内嵌了输入框(<input>)、复选框(<input type="checkbox">)、下拉框(<select>)或者状态徽标(Badge)。如果仍然直接调用 td.textContent,将无法拿到输入框中用户实时键入的内容。
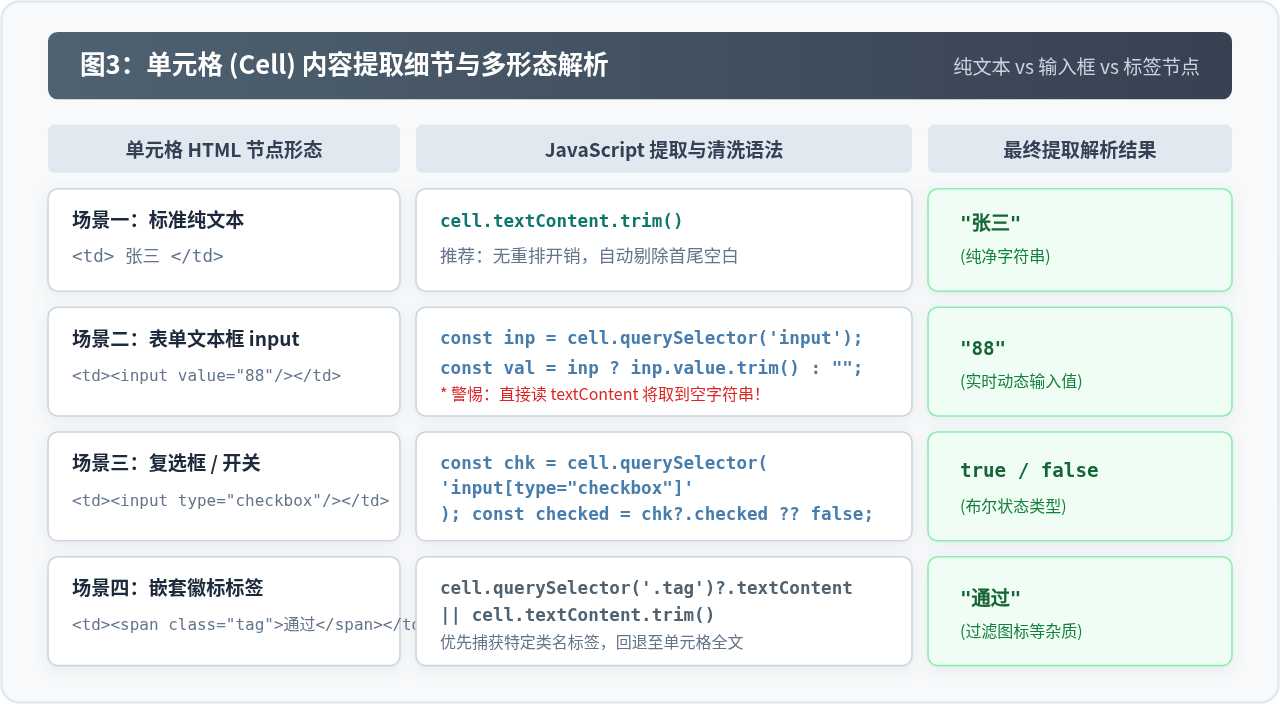
1. 针对各种控件的通用提取函数
为了兼容单元格内存在表单输入的情况,可以封装一个通用的单元格值提取辅助函数:
/**
 * 智能提取单个单元格的值,兼容输入控件与纯文本
 * @param {HTMLTableCellElement} cell 单元格 DOM 节点
 * @returns {string|boolean} 提取后的数值
 */
function extractCellValue(cell) {
  if (!cell) return '';

  // 1. 判断是否包含复选框或单选框
  const checkbox = cell.querySelector('input[type="checkbox"], input[type="radio"]');
  if (checkbox) {
    return checkbox.checked;
  }

  // 2. 判断是否包含通用输入框 (文本/数字) 或 下拉菜单
  const inputControl = cell.querySelector('input:not([type="checkbox"]):not([type="radio"]), select, textarea');
  if (inputControl) {
    return inputControl.value.trim();
  }

  // 3. 常规纯文本单元格,直接读取并清洗空白
  return cell.textContent.trim();
}
注意避免取到换行与制表符:
HTML 代码在格式化排版时,
HTML 代码在格式化排版时,
<td> 标签内部通常包含回车和缩进空格。如果不调用 .trim(),提取出的字符串两侧可能会残留诸如 "
张伟
" 的隐形空白字符,这在后续与数据库校验或发起 HTTP 请求时会导致匹配失败。
2. 过滤隐藏行 (Hidden Rows)
当表格带有客户端搜索过滤功能时,被筛选掉的行通常会被添加 display: none 样式或带上 .is-hidden 类名。如果不希望将隐藏的脏数据提交到后端,可以在迭代时加入条件判断:
// 方式 A:在 querySelectorAll 中直接使用 CSS 伪类过滤
const visibleRows = Array.from(
  table.querySelectorAll('tbody tr:not([style*="display: none"]):not(.hidden)')
);

// 方式 B:在循环中通过 offsetParent 属性判断可见性
for (const row of tbody.rows) {
  // 元素 display:none 时其 offsetParent 为 null
  if (row.offsetParent === null) {
    continue; // 跳过不可见的隐藏行
  }
  // ... 执行后续提取
}
方案选型对比与工程实践总结
在实际工程架构中,应该根据表格的数据量级、动态更新频率以及代码规范来决定采用哪种遍历方案。下表梳理了两种主流方案在核心维度上的具体表现:
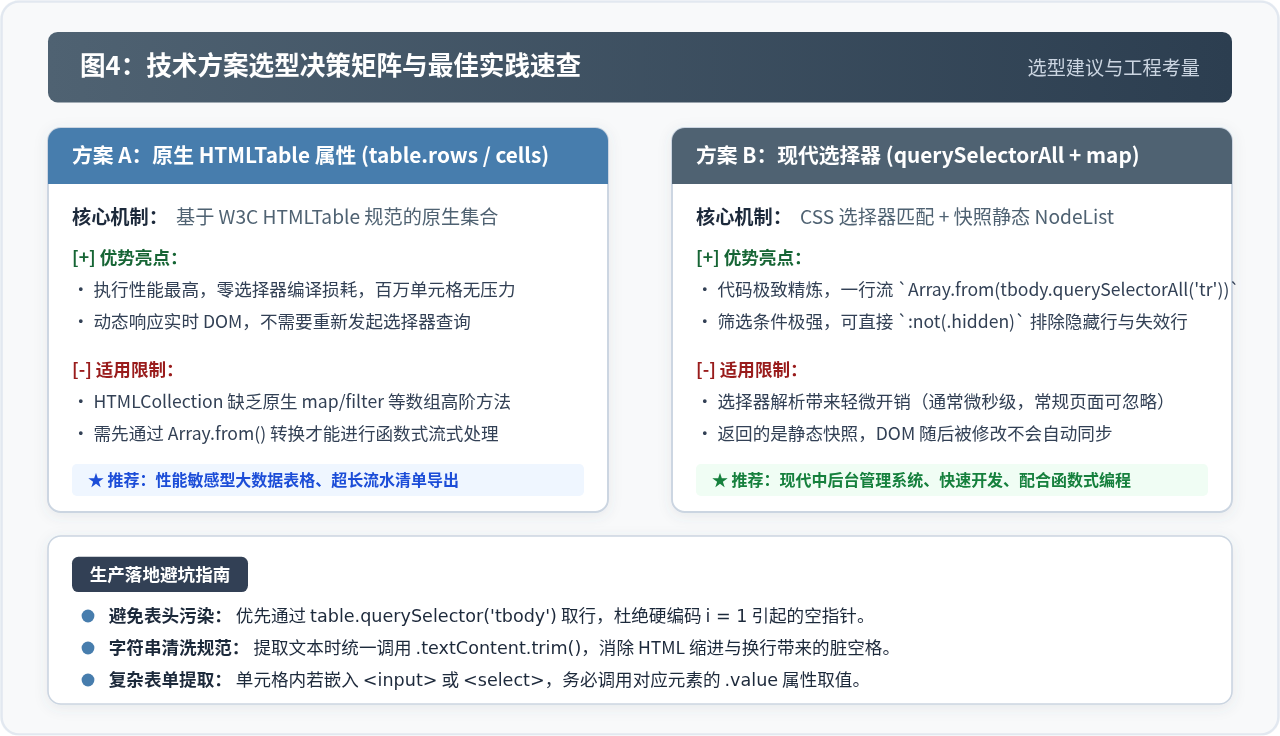
核心实践原则
- 必须明确容器范围:永远优先通过
table.querySelector('tbody')锁定数据体,不要为了图省事直接对table.rows做无差别迭代,这能彻底避免因表头占用索引而导致的边界 Bug。 - 文本必须经过清洗:统一对提取出的字段使用
.trim()处理,必要时做正则剔除不可见控制字符。 - 大数据量优先用原生属性:当表格行数达到上千行时,
for循环配合tbody.rows与row.cells能带来更显著的性能优势,避免多次选择器解析造成的开销。 - 表单表格需区分属性:对于带有编辑功能的交互式表格,严禁单纯依赖
textContent,必须通过querySelector('input')获取.value或.checked。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章