
深入剖析大数据量下JavaScript数组去重的性能瓶颈,从算法复杂度、V8内存开销到主线程响应机制,系统讲解Set、Map、原地双指针排序以及Web Worker分片等高性能去重方案与技术选型。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
大数据量下JS数组去重的性能优化方案
作者:巡夜人
时间:2026-11-18
浏览:181
文章目录
JavaScript进阶
算法与数据结构
内存与性能调优
大数据量处理
当 JavaScript 处理几十或数百个元素的小型数组时,任意一种去重写法在现代浏览器与 Node.js 运行环境中都能在不到 1 毫秒内完成。然而,当数据量跃升至 10 万、50 万乃至 100 万级规模时,许多在常规开发中习以为常的去重写法(例如 filter 结合 indexOf 或双重循环)会迅速遭遇性能悬崖,耗时暴增至数十秒甚至导致主线程锁死崩溃。本文将针对大数据量这一特定场景,系统拆解去重计算的核心瓶颈,并提供兼顾执行耗时、内存占用与 UI 响应能力的优化方案。
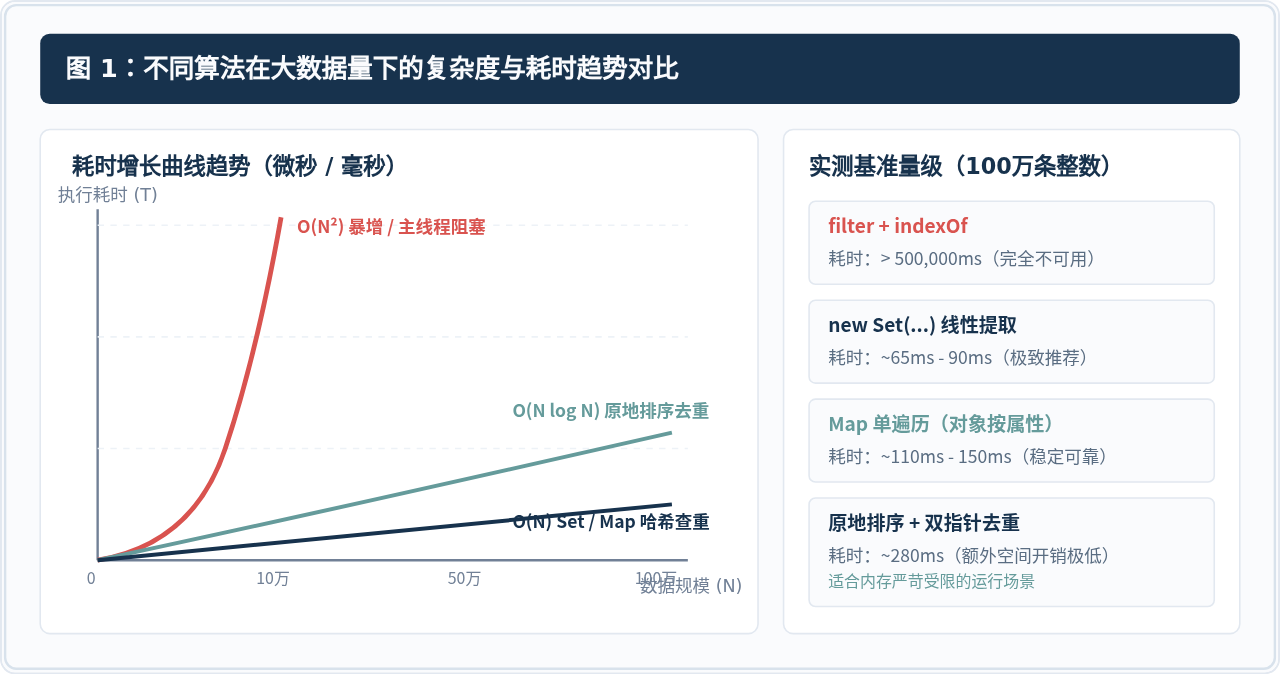
一、大数据量下的性能瓶颈与复杂度差距
去重算法在数据膨胀时的表现差异,本质上是由时间复杂度与底层内存分配机制决定的。常规写法往往隐藏着高密度的二次遍历:
- 嵌套扫描型(O(N²)):以
arr.filter((item, idx) => arr.indexOf(item) === idx)为典型代表。对包含 10 万个元素的数组,最差情况下需要执行近 50 亿次内部比对,CPU 算力被全量消耗在无意义的顺序扫描上。 - 排序双指针型(O(N log N)):先对数组进行原地快速排序,随后通过一次线性遍历消除相邻重复元素。时间复杂度为 O(N log N),且无需维护巨大的额外散列表,非常适合内存极度受限的环境。
- 散列索引型(O(N)):利用
Set或Map的哈希表特性,单次键值查询的均摊时间复杂度为 O(1),总体耗时随数据规模呈线性增长。
二、基础类型数组的高性能方案:基于 Set 的线性去重
对于数值、字符串、布尔值等基本类型构成的超大数组,首选且最优的解法是利用 ES6 的 Set。在 V8 引擎内部,Set 采用类似 OrderedHashTable 的存储结构,能够以平均 O(1) 的时间完成插入与重复键检测。
1. 标准实现与展开陷阱
// 方案 A:扩展运算符(适合绝大多数场景,代码最为简洁)
function deduplicateWithSetSpread(arr) {
  return [...new Set(arr)];
}

// 方案 B:Array.from(语义明确,在大数据量下内存开销更稳定)
function deduplicateWithSetFrom(arr) {
  return Array.from(new Set(arr));
}
注意避免函数参数栈溢出:早期的扩展写法
[].concat.apply([], arr) 在数万级数组中会直接触发 RangeError: Maximum call stack size exceeded。即使是 [...new Set(arr)],在部分引擎构建超百万级连续迭代时,也会瞬间产生多倍于原始数据的临时内存对象。如果内存较为紧张,优先使用 Array.from(new Set(arr))。
三、业务对象数组去重:基于 Map 的单次线性映射
在实际生产中,数据往往不是单纯的标量,而是带有业务 ID 的对象列表(如订单详情、用户列表)。直接使用 Set 会因为对象引用地址不同而导致去重失效。若通过 JSON.stringify 进行序列化比对,字符串转换与键排序开销将使吞吐量下降两个数量级。
1. 单字段属性去重的高性能写法
使用 Map 以业务唯一标识(如 id 或 uid)作为 Key 进行单次遍历,既能确保 O(N) 的高效执行,又能精确保留首个出现的记录或覆盖更新:
/**
 * 依据指定属性去重对象数组
 * @param {Array<Object>} list 原始数组
 * @param {string} key 作为唯一标识的键名
 * @returns {Array<Object>}
 */
function deduplicateObjectsByKey(list, key) {
  const map = new Map();
  const len = list.length;

  for (let i = 0; i < len; i++) {
    const item = list[i];
    if (item && !map.has(item[key])) {
      map.set(item[key], item);
    }
  }

  return Array.from(map.values());
}
2. 为什么避免使用 filter + Map.has
社区常见的简洁写法为 list.filter(item => !map.has(item[key]) && map.set(item[key], 1))。在小数组下这种写法优雅,但在 50 万级数据下,filter 回调函数会产生 50 万次函数帧创建与上下文切换,其耗时通常是传统 for 循环的 2 到 3 倍。在百万级体量下,朴素的 for 循环依然是保证极端吞吐的最优选择。
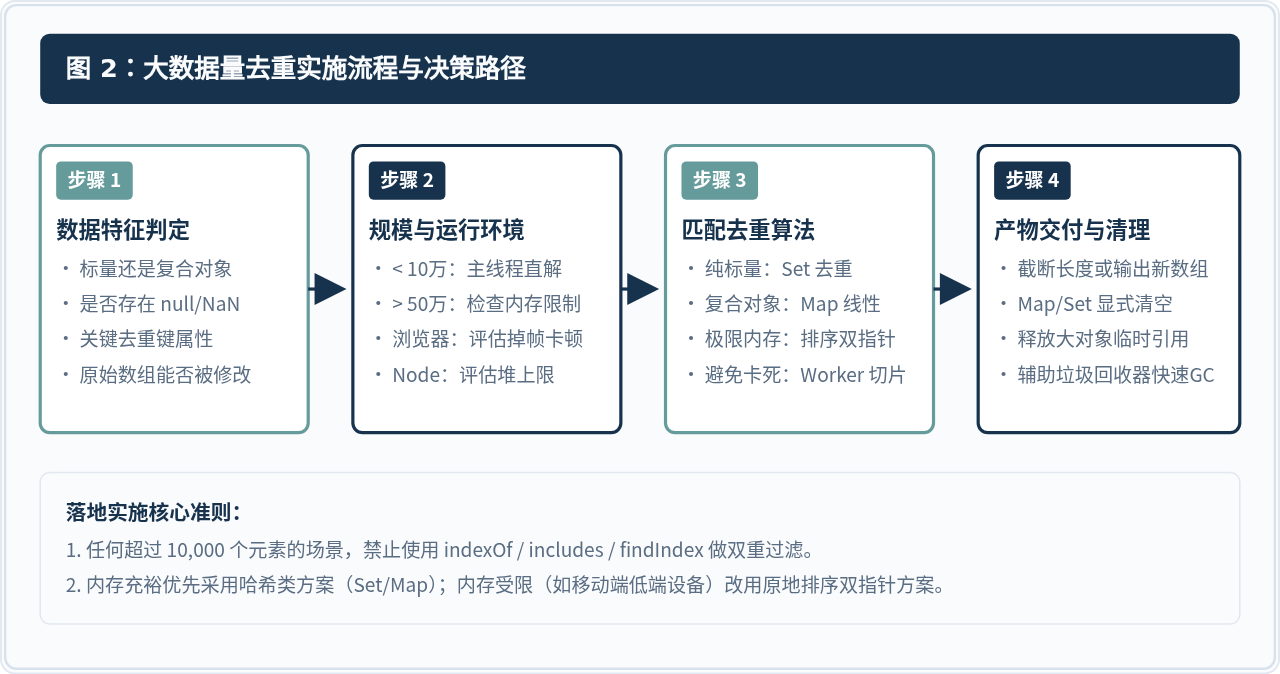
四、大数据量去重全流程与决策步骤
在工程落地时,不应盲目套用某一种特定写法,而应依照数据类型、数据规模和运行载体建立清晰的决策路径:
五、内存受限场景:原地排序与双指针优化
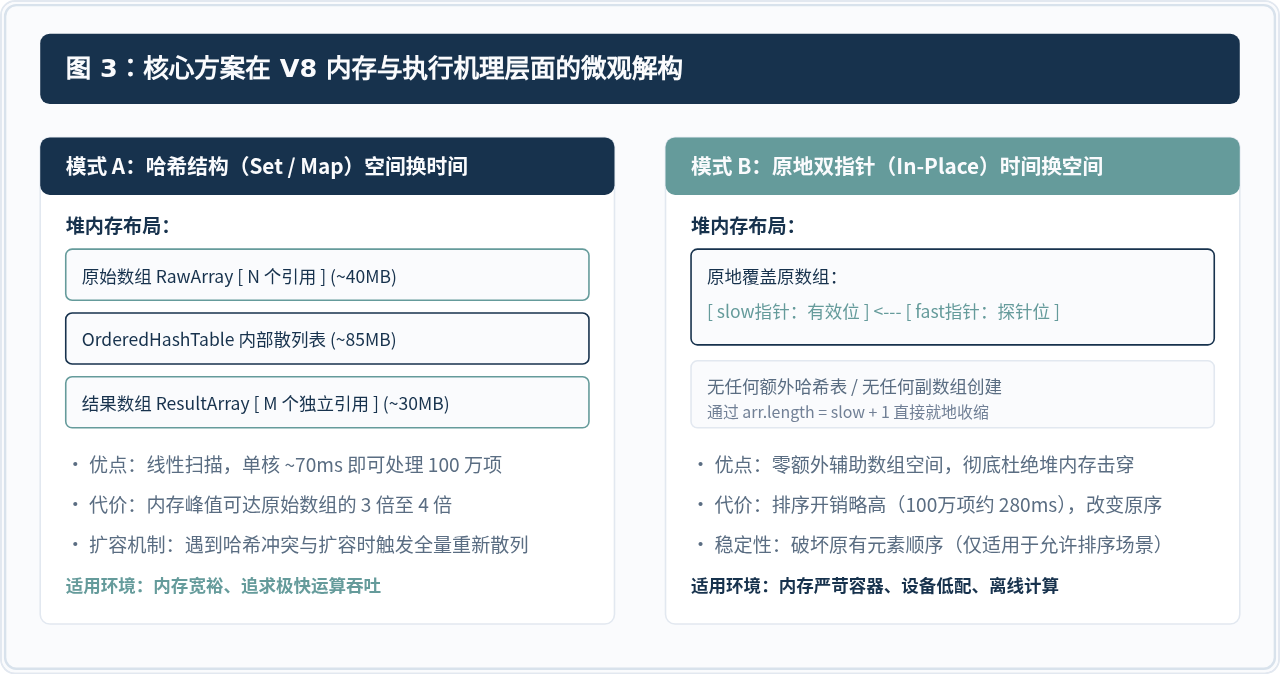
Set 和 Map 方案虽然速度极快,但在处理 100 万级规模的数据时,不仅需要保留原始数组,还需要开辟一个容纳 100 万键值的内部哈希表,以及最终存放去重结果的新数组。在 Node.js 内存上限严格受控(如 Docker 容器分配 512MB 限制)或低端移动设备浏览器上,这种双倍乃至三倍的瞬时内存峰值可能直接触发 OOM(Out of Memory)进程崩溃。
如果业务允许改变原数组中元素的排序顺序,且更看重内存使用的平稳性,可以采用“原地数值排序 + 双指针原地覆盖”策略。该策略仅需常数级别的额外空间(O(1) 空间复杂度):
/**
 * 针对数值型超大数组的原地排序双指针去重
 * 空间复杂度 O(1),无额外哈希表开销
 * @param {number[]} arr
 * @returns {number[]} 原数组被原地修改并截断
 */
function deduplicateInPlace(arr) {
  const len = arr.length;
  if (len <= 1) return arr;

  // 1. 原地数值快速排序(利用底层类型化/V8快排优化)
  arr.sort((a, b) => a - b);

  // 2. 双指针扫描去重
  let slow = 0;
  for (let fast = 1; fast < len; fast++) {
    if (arr[fast] !== arr[slow]) {
      slow++;
      arr[slow] = arr[fast];
    }
  }

  // 3. 截断无效尾部数据,归还多余内存
  arr.length = slow + 1;
  return arr;
}
六、浏览器防卡死优化:Web Worker 与异步分片
在浏览器环境中,即便是耗时仅需 150 毫秒的去重操作,也足以跨越 9 个以上的帧周期(以 60Hz 刷新率计算,每帧预算仅 16.6 毫秒),直接导致页面动画卡顿、输入框无响应乃至弹出“页面无响应”警报。在大数据量场景下,将繁重的去重工作与主线程解耦是提升用户体验的核心环节。
1. 使用 Web Worker 彻底卸载计算负荷
通过独立工作线程进行数据去重,主线程只负责提交任务与接收结果:
// worker.js (工作线程代码)
self.onmessage = function (e) {
  const { data } = e;
  const uniqueSet = new Set(data);
  const result = Array.from(uniqueSet);
  self.postMessage(result);
};

// main.js (主线程代码)
function runDeduplicateInWorker(hugeArray) {
  return new Promise((resolve, reject) => {
    const worker = new Worker('worker.js');
    worker.postMessage(hugeArray);

    worker.onmessage = function (e) {
      resolve(e.data);
      worker.terminate(); // 及时注销线程,防资源泄漏
    };

    worker.onerror = function (err) {
      reject(err);
      worker.terminate();
    };
  });
}
Transferable Objects 性能增益:如果处理的是数值型的
Int32Array 或 Float64Array 等类型化数组,在向 Worker 传递数据时应使用可转移对象(Transferable Objects):worker.postMessage(buffer, [buffer])。这将直接移交内存底层的 ArrayBuffer 控制权,免除数十兆数据的序列化与深拷贝开销,耗时从数十毫秒骤降至 0 毫秒。
2. 时间切片(Time Slicing)方案
若受限于项目架构无法方便地部署 Worker 脚本,可使用基于 requestIdleCallback 的时间切片方案,在浏览器每帧的空闲时段分块去重:
/**
 * 时间切片分块去重
 * 避免阻塞主线程交互
 */
function deduplicateAsyncTimeSlice(arr, chunkSize = 20000) {
  return new Promise((resolve) => {
    const set = new Set();
    let index = 0;
    const len = arr.length;

    function processSlice(deadline) {
      // 只要本帧仍有空闲时间且数据未处理完
      while ((deadline.timeRemaining() > 0 || deadline.didTimeout) && index < len) {
        const limit = Math.min(index + chunkSize, len);
        for (; index < limit; index++) {
          set.add(arr[index]);
        }
      }

      if (index < len) {
        requestIdleCallback(processSlice);
      } else {
        resolve(Array.from(set));
      }
    }

    requestIdleCallback(processSlice);
  });
}
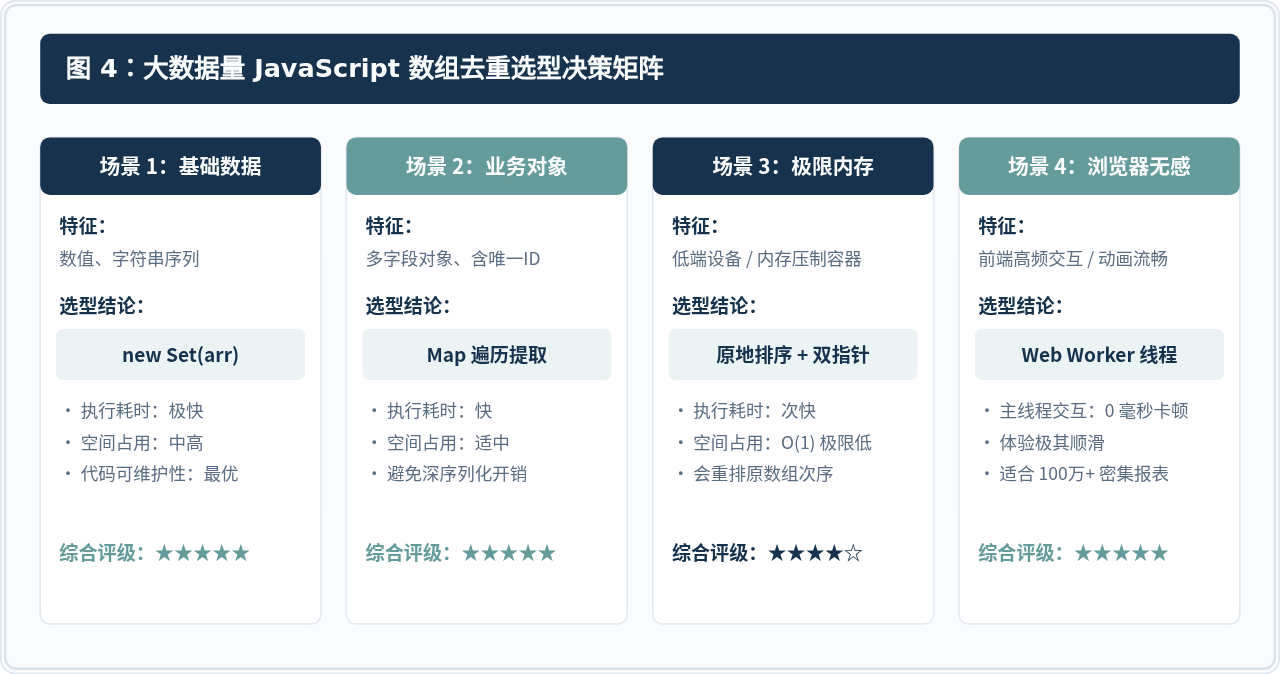
七、大数据量去重综合选型决策矩阵
为了在实际工程中迅速确立方案,下表及决策图汇总了不同约束条件下的技术选择与权重考量:
| 业务数据场景 | 推荐算法方案 | 时间复杂度 | 额外空间开销 | 核心优势与适用范围 |
|---|---|---|---|---|
| 纯基础类型(数值 / 文本) | Array.from(new Set(arr)) |
O(N) | 较高(约 2-3 倍) | 代码极其精简,吞吐最强,通用性首选 |
| 对象数组(按单一 ID 属性) | Map + 单重 for 循环 |
O(N) | 中等 | 按属性索引稳定去重,避免重复对象序列化 |
| 内存受限 / 容器内存严格压制 | 原地 sort + 双指针原地覆盖 |
O(N log N) | 极低(O(1) 原地) | 绝不触发 OOM 溢出,适合极端严苛内存 |
| 浏览器主线程强交互场景 | Web Worker (可转移对象) |
O(N) | 隔离于子线程 | 完全杜绝主线程卡顿掉帧,UI 交互流畅 |
| 历史老旧浏览器兼容需求 | 普通 Object 作为哈希字典 |
O(N) | 较高 | 支持无 ES6 运行环境,需注意 Key 字符串化陷阱 |
八、总结与避坑清单
面对大规模数据的去重需求,开发者应当建立以下工程防御准则:
- 彻底弃用 O(N²) 写法:无论是
filter + indexOf、includes还是嵌套for循环,只要数据规模越过万级,就绝不能出现在生产代码中。 - 防范隐式垃圾回收(GC)风暴:在单次循环内部尽量避免频繁使用
JSON.stringify、创建临时闭包或构造微型短命对象。这些短命对象会迅速填满 V8 的新生代(Young Generation)内存区,引发高频 Minor GC,大幅拖慢执行速度。 - 对象去重统一标准化 Key:对象数组去重时,如果存在联合键(如
`${category}_${id}`),尽量通过模板字符串生成紧凑标量作为 Map 的 Key,确保映射的一致性与高命中率。 - 善用线程隔离:在前端密集计算场景中,将数据移入 Web Worker 并辅以
ArrayBuffer零拷贝转移,是保证用户界面帧率稳定的终极方案。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章