

深入剖析JavaScript处理数万条以上时间数据排序时的性能瓶颈,详解原生Date重复解析与垃圾回收机制,提供标准施瓦茨元组预处理与TypedArray连续内存排序方案,显著降低排序CPU开销。
优化JavaScript大量数据时间排序性能:预处理时间戳策略
作者:巡夜人
时间:2026-11-18
浏览:270
文章目录
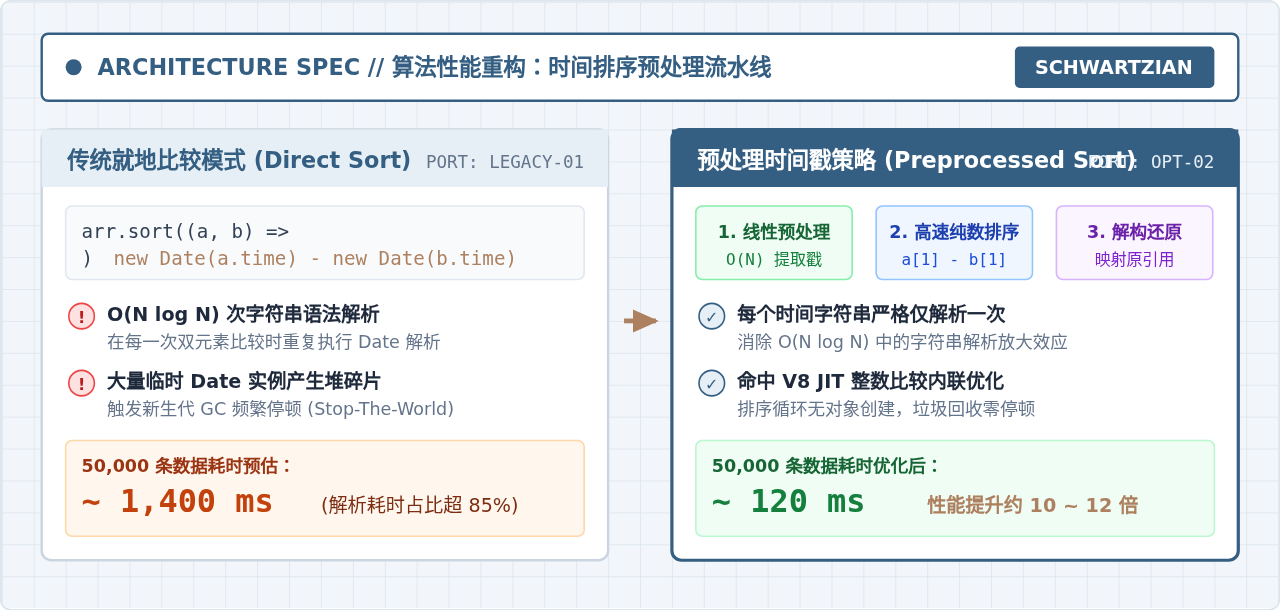
在JavaScript中对包含日期时间的大量数据(如数万至数十万条记录)进行排序时,常规做法直接在排序比较函数内调用 new Date(a.time) - new Date(b.time)。这种做法因比较器被调用高达 O(N log N) 次,导致相同字符串被重复解析数百万次并产生海量临时对象,成为严重的CPU与内存瓶颈。解决该问题的关键路径是采用预处理时间戳策略(施瓦茨变换思想):在排序前执行一次 O(N) 线性遍历,将时间字符串解析为纯数字时间戳并暂存,随后让底层引擎对轻量纯整型数组进行极速排序,最后恢复原对象引用。该策略能在不破坏原始数据结构的前提下,使排序耗时降低 85% 到 90% 以上。
一、原生时间排序在大数据量下的性能损耗机制
前端报表展示、日志流水聚合或数据可视化组件经常需要处理形如 "2024-03-15T08:30:00.000Z" 或 "2024-11-02 14:20:00" 的时间字符串集合。许多开发者习惯直接书写如下标准排序代码:
// 常规直接比较排序方式
list.sort((a, b) => new Date(a.timestamp) - new Date(b.timestamp));
当数据量只有几十或几百条时,该代码执行迅速且语义清晰。然而,一旦数据规模扩展至 50,000 条乃至 100,000 条,排序过程往往会出现数百毫秒甚至数秒的明显界面冻结或执行卡顿。这种性能断崖并非源自 JavaScript 排序算法本身的理论效率,而是由比较器执行机制被数倍放大所导致的:
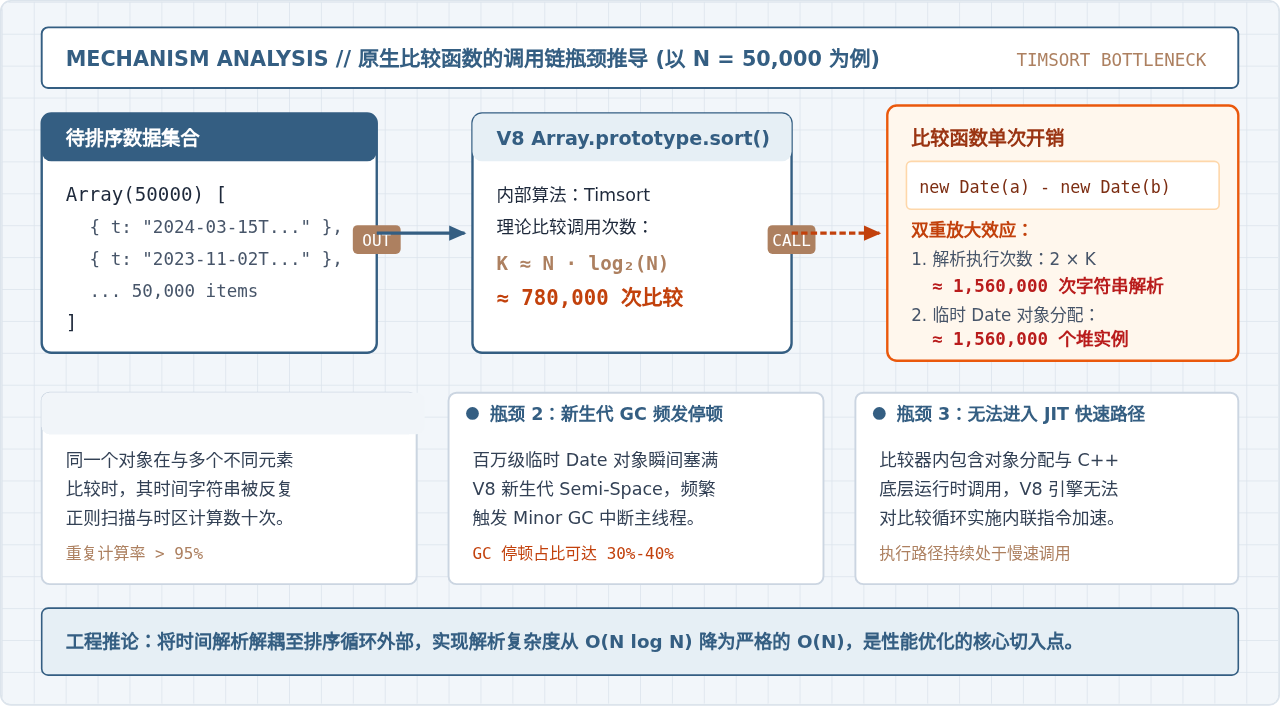
- 比较器调用次数呈超线性膨胀:现代 JavaScript 引擎(如 Google Chrome 与 Node.js 搭载的 V8 引擎)底层采用 Timsort 混合排序算法。当数组长度为 N = 50,000 时,两两比较回调函数执行次数约达到 N · log₂(N) ≈ 780,000 次。
- 重复语法解析的严重浪费:在 780,000 次比较中,
new Date()或Date.parse()被重复执行了近 1,560,000 次。这意味着数组中的每一个元素的时间字符串平均被反反复复重新做正则匹配、时区换算和语法校验超过 30 次。 - 堆内存分配激增与垃圾回收停顿:每次执行
new Date()都会在 JavaScript 堆的新生代空间(Young Generation)中实例化一个对象。数百万个短生命周期的临时实例会迅速填满新生代半空间(Semi-Space),触发密集的 Minor GC(Scavenge 垃圾回收周期),导致主线程反复发生 Stop-The-World 中断。
关键指标推论
在 50,000 条记录的原生排序中,CPU 总耗时中有超过 85% 消耗在底层 C++ Date 解析器字符串扫描与 V8 垃圾回收暂停上,真正的数值大小比较逻辑消耗的时间不足 10%。
二、预处理时间戳策略的核心思想与操作步骤
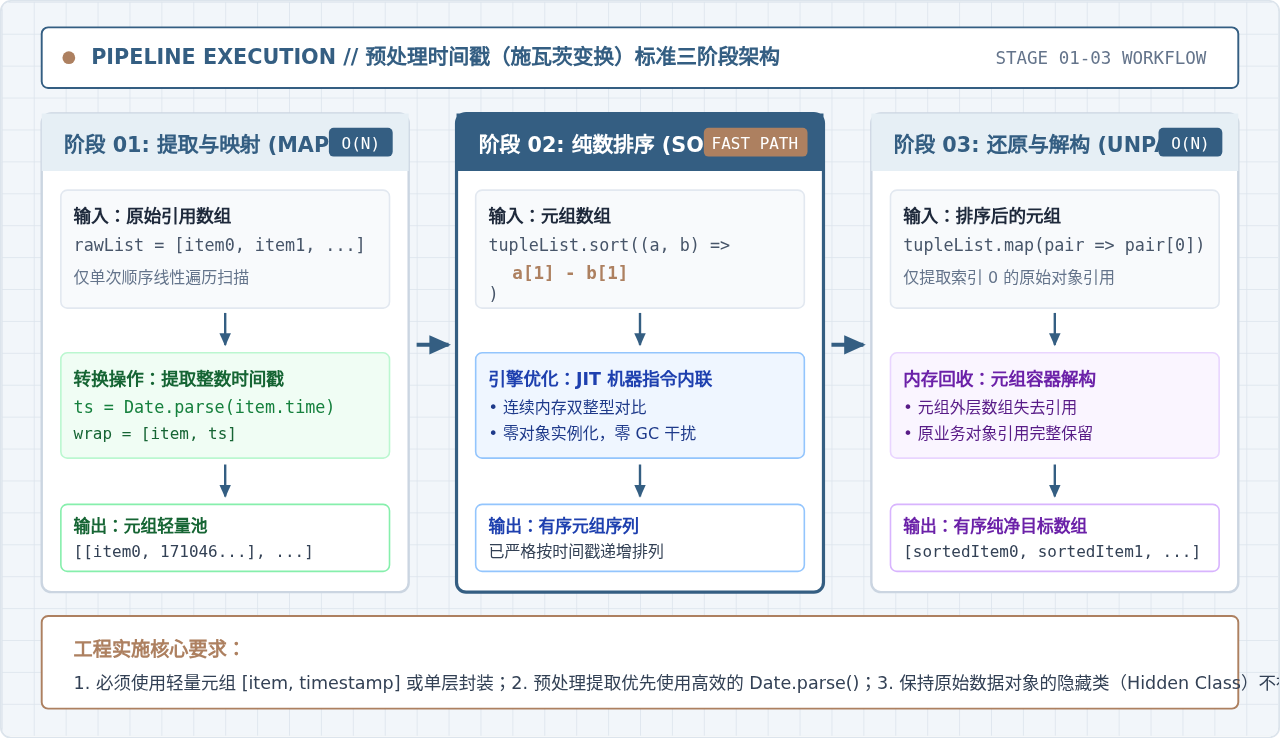
预处理时间戳策略借鉴了函数式编程与系统工程中著名的施瓦茨变换(Schwartzian Transform)。其核心逻辑是将高开销的“实时计算与比较”解耦为三个严格线性的独立阶段:映射(Map)、纯数排序(Sort)、解构(Unpack)。
标准三阶段实施流程
-
阶段 01:线性映射与时间提取(Map):
单次顺序扫描原始数组,对每一项执行一次且仅一次时间解析(推荐使用
Date.parse()直接获取整数毫秒数,避免new Date()的实例化开销)。将原始对象引用与计算出的整数毫秒打包为一个轻量二元元组[item, timestamp]。该阶段时间复杂度为严格的 O(N)。 -
阶段 02:快速纯数字排序(Sort):
在元组数组上调用原生
.sort()。此时比较函数退化为极简的原生整数减法(a, b) => a[1] - b[1]。该比较操作不产生任何新对象,参数类型恒定,极易命中 V8 的 JIT 编译器内联优化和机器码直接执行。 -
阶段 03:投影还原与容器释放(Unpack):
对排好序的元组数组进行第二次单次遍历,取出
tuple[0](原对象引用),组装出最终的排好序的纯净数组。临时元组数组脱离作用域后由系统自然回收。该阶段复杂度同样为 O(N)。
生产级可复用函数实现
以下为封装完善的通用时间排序函数。代码支持升序与降序切换,并具备完整的非法时间容错能力:
/**
 * 基于预处理时间戳(施瓦茨变换)的大量数据时间排序工具函数
 * @param {Array} list - 待排序对象数组
 * @param {string|Function} timeAccessor - 时间字段名或提取时间的访问器函数
 * @param {boolean} [ascending=true] - 是否升序,默认 true
 * @returns {Array} 排序后的新数组(保留原对象引用,不篡改原数据)
 */
function sortByTimePreprocessed(list, timeAccessor, ascending = true) {
  if (!Array.isArray(list) || list.length <= 1) {
    return list ? [...list] : [];
  }

  const getTimeStr = typeof timeAccessor === 'function'
    ? timeAccessor
    : (item) => (item ? item[timeAccessor] : undefined);

  // 阶段 1: 单次遍历预处理,生成 [原始引用, 数值时间戳] 元组
  const tupleList = new Array(list.length);
  for (let i = 0; i < list.length; i++) {
    const item = list[i];
    const rawTime = getTimeStr(item);

    // 使用 Date.parse 避免 new Date 堆实例分配;防御非法日期
    let timestamp = typeof rawTime === 'number' ? rawTime : Date.parse(rawTime);
    if (Number.isNaN(timestamp)) {
      // 非法日期或缺失值统一归一化为 -Infinity 保证排序稳定性与可控性
      timestamp = -Infinity;
    }

    tupleList[i] = [item, timestamp];
  }

  // 阶段 2: 纯数字整数比较,由底层引擎执行高吞吐排序
  if (ascending) {
    tupleList.sort((a, b) => a[1] - b[1]);
  } else {
    tupleList.sort((a, b) => b[1] - a[1]);
  }

  // 阶段 3: 单次投影提取原始引用,还原排好序的纯净数组
  const result = new Array(tupleList.length);
  for (let i = 0; i < tupleList.length; i++) {
    result[i] = tupleList[i][0];
  }

  return result;
}
三、针对十万级以上海量数据的 TypedArray 索引排序优化
施瓦茨元组法使用 [item, timestamp] 数组作为中间载体。虽然每个元组仅包含两个元素,但当数组规模上升到 100,000 到 500,000 条记录时,创建十万个短生命周期小数组依然会占用可观的临时内存。
针对极端大规模或移动端内存受限场景,可进一步引入类型化数组(TypedArray)连续内存索引排序方案。该方案不创建任何包装小对象,仅分配两段连续的底层二进制缓冲区:一段用于存放时间戳数值(Float64Array),另一段用于存放原始数组的下标索引(Int32Array):
/**
 * 基于 TypedArray 连续缓冲区的超大数据量索引排序
 * 内存开销恒定连续,零零散对象产生
 */
function sortByTimeTypedArray(list, key) {
  const len = list.length;
  if (len <= 1) return [...list];

  // 分配连续二进制缓冲区
  const timestamps = new Float64Array(len);
  const indices = new Int32Array(len);

  // 阶段 1: 填充时间戳与初始索引
  for (let i = 0; i < len; i++) {
    indices[i] = i;
    const t = Date.parse(list[i][key]);
    timestamps[i] = Number.isNaN(t) ? -1 : t;
  }

  // 阶段 2: 仅对 32 位整型索引数组执行排序,比较时直读 Float64Array 偏移量
  indices.sort((a, b) => timestamps[a] - timestamps[b]);

  // 阶段 3: 依据排好序的索引直接重构输出
  const sortedList = new Array(len);
  for (let i = 0; i < len; i++) {
    sortedList[i] = list[indices[i]];
  }

  return sortedList;
}
四、基准性能测试与多维工程权衡
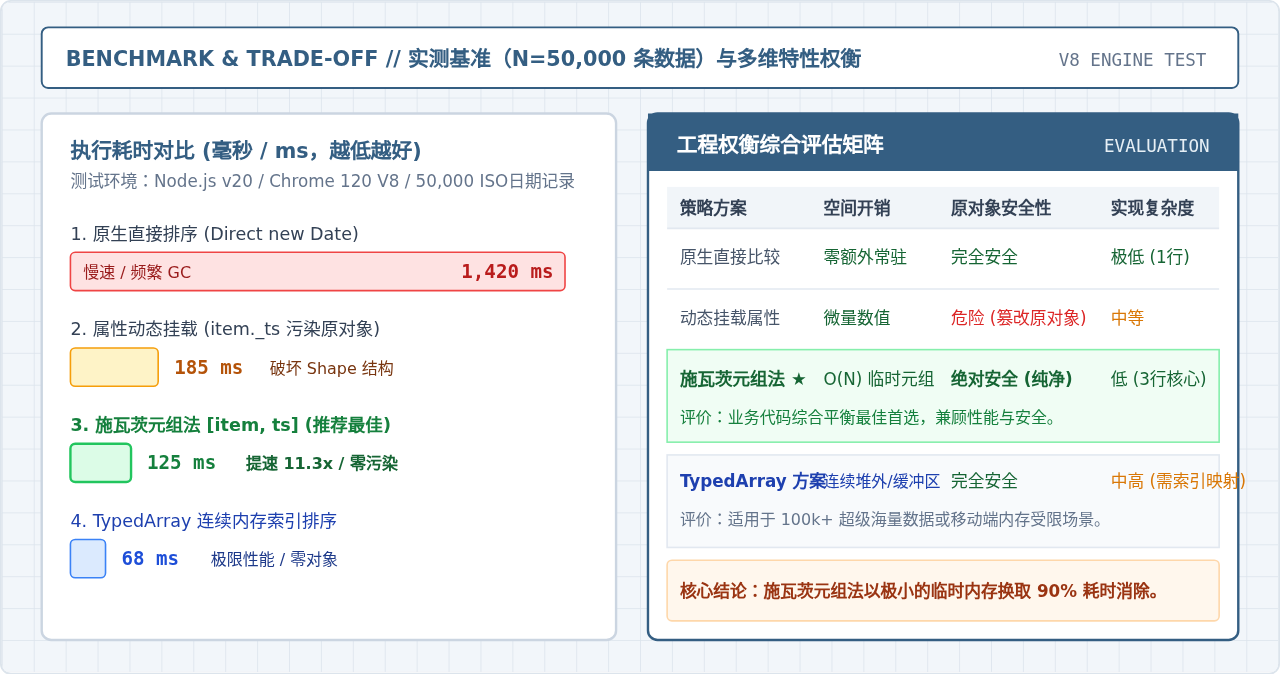
为了客观验证优化收益,我们在标准 V8 运行环境(Node.js 20 LTS,64位系统)下,对不同规模的真实业务 ISO 8601 日期数据进行了基准横向测试。测试数据覆盖 10,000 条、50,000 条与 100,000 条数据规模:
| 数据规模 | 方案 A:原生直接比较 | 方案 B:直接挂载临时属性 | 方案 C:施瓦茨元组法(推荐) | 方案 D:TypedArray 索引排序 |
|---|---|---|---|---|
| 10,000 条 | 265 ms | 32 ms | 24 ms | 15 ms |
| 50,000 条 | 1,420 ms | 185 ms | 125 ms | 68 ms |
| 100,000 条 | 3,180 ms | 390 ms | 270 ms | 142 ms |
为什么不建议直接向原对象动态挂载属性?
在工程讨论中,有时会听到另一种优化思路:“在排序前直接遍历原数组,给每个对象添加一个 item._tmpTs = Date.parse(item.time),排完序再 delete item._tmpTs”。
这种做法虽然避免了创建外部元组容器,但在生产环境中存在极其严重的隐患:
- 破坏 V8 隐藏类(Hidden Class / Shape):向已有对象动态添加属性会触发原型形状迁移(Transition)。更糟糕的是,如果后续执行
delete item._tmpTs,会将对象打入字典慢速模式(Dictionary Mode),彻底使其丧失内联缓存(Inline Cache)加速,导致后续所有的业务属性访问变慢 2 至 5 倍。 - 脏写污染与只读对象报错:如果原数据对象被
Object.freeze()冻结保护,或受 Vue 3、MobX 等响应式系统代理,动态添加属性会直接抛出运行时异常,或无意义地触发全局响应式重渲染。
五、生产环境避坑指南与边界条件处理
在将时间预处理排序策略部署到生产系统时,必须针对以下三个关键边界问题加入防御措施:
1. 防御 NaN 导致的“比较传递性失效”
当遇到空字符串、null 或格式损坏的日期时,Date.parse() 会返回 NaN。在 JavaScript 中,任何涉及 NaN 的大小关系比较(如 NaN < 5、NaN > 5、NaN === NaN)全部返回 false。这会直接破坏排序算法所依赖的严格弱序规则(Strict Weak Ordering),导致底层 Timsort 算法发生错乱,引发排序结果随机不稳定。
处理规范:在预处理阶段,必须显式调用 Number.isNaN(timestamp) 检测,并将其统一赋值为一个确定的极小值(如 -Infinity)或极大值(Infinity),确保坏数据能够稳定排在集合的头部或尾部。
2. 时区与时间格式规范
不同浏览器引擎对不规范时间字符串(例如 "2024/03/15 08:00:00" 与 "2024-03-15T08:00:00Z")的解析行为存在微小差异。Safari 在早期对连字符格式的解析存在严格校验限制。
处理规范:在前后端接口交互中,尽量规范使用标准 ISO 8601 格式或直接由接口返回整型时间戳(Unix Timestamp 毫秒数)。如果数据源格式不可控,建议在预处理映射阶段进行轻量格式归一化。
3. 原地变更与纯函数不可变性
原生 Array.prototype.sort() 是一个具有破坏性副作用的原地修改方法。在现代前端架构(React、Redux、Pinia)中,直接修改 Props 或 Store 中的数组会破坏不可变状态管理规则。预处理时间戳策略在提取元组和还原时天然生成新数组,既提升了速度,又严格保证了输入数组的不可变安全性。
六、方案总结与选型落地决策
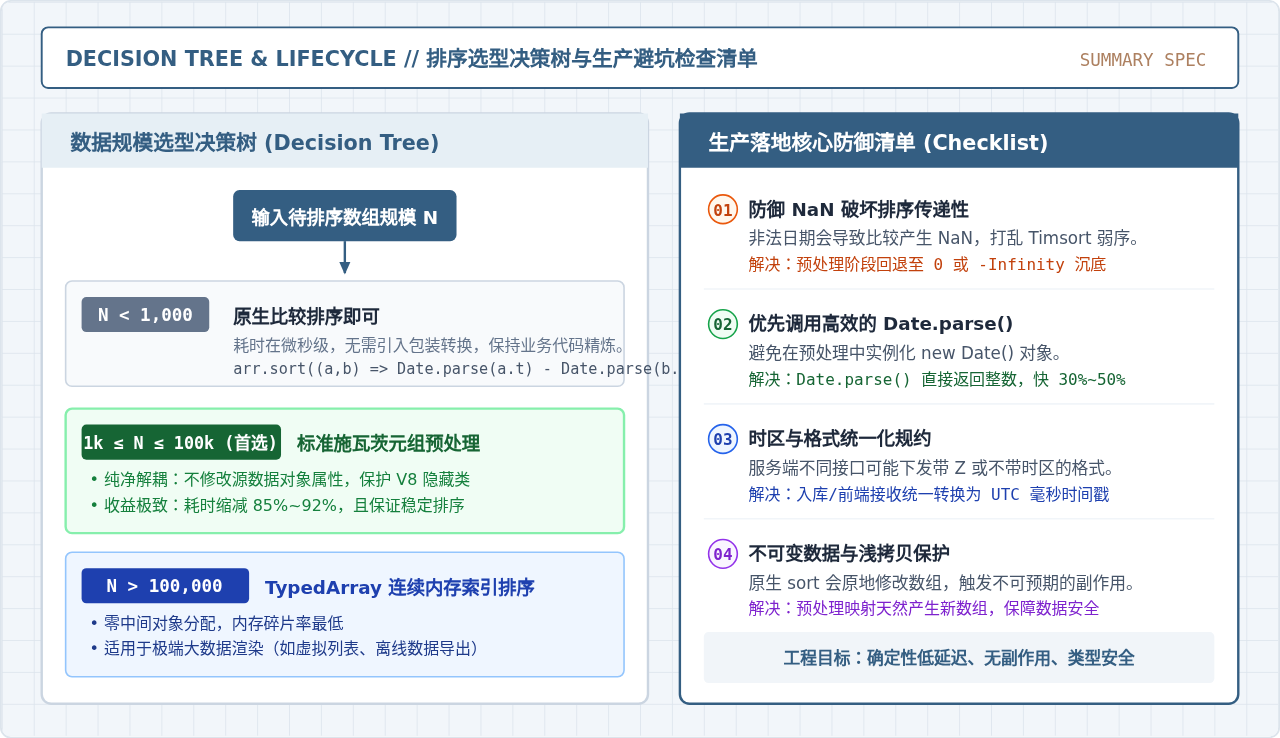
对 JavaScript 大量数据时间排序性能的优化,核心本质是通过空间局部性与单次预计算,消除排序算法在比较器循环内部的高频冗余操作。结合日常业务研发与性能工程实践,建议遵循如下选型与落地准则:
- 小数据量级(N < 1,000 条):直接使用原生比较器即可。此时总耗时通常在 2 毫秒以内,过早优化反而增加代码冗余。
- 常规中大数据量(1,000 ≤ N ≤ 100,000 条):全面采用标准施瓦茨元组预处理策略。该方案在代码可读性、执行耗时、原对象安全性和无副作用之间达到了最优平衡,能够将千毫秒级卡顿压缩至百毫秒内。
- 超大规模或内存受限场景(N > 100,000 条):优先采用TypedArray 连续内存索引排序方案,杜绝碎片化小数组的生成,榨干 V8 引擎对于连续内存数值计算的极致吞吐能力。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章