

深入讲解JavaScript获取URL参数时中文乱码的产生原因与排查步骤,提供URLSearchParams、decodeURIComponent以及处理GBK编码的多场景完整解决方案。
JS获取URL参数时中文乱码怎么解决
作者:像素漫游
时间:2026-11-18
浏览:187
文章目录
解决 JavaScript 获取 URL 参数中文乱码的核心做法分两步:首先判断乱码类型(是未解码的十六进制百分比串、双重编码还是非 UTF-8 编码),然后选用匹配的解码方式。在现代浏览器中,获取参数首选原生
URLSearchParams(内部已自动完成 UTF-8 百分号解码);在传统解析脚本或老旧项目中,针对提取后的值显式执行 decodeURIComponent() 并处理加号空格;若遭遇旧系统以 GBK 编码传输的参数,则需借助 TextDecoder('gbk') 按字节流进行降级解析。
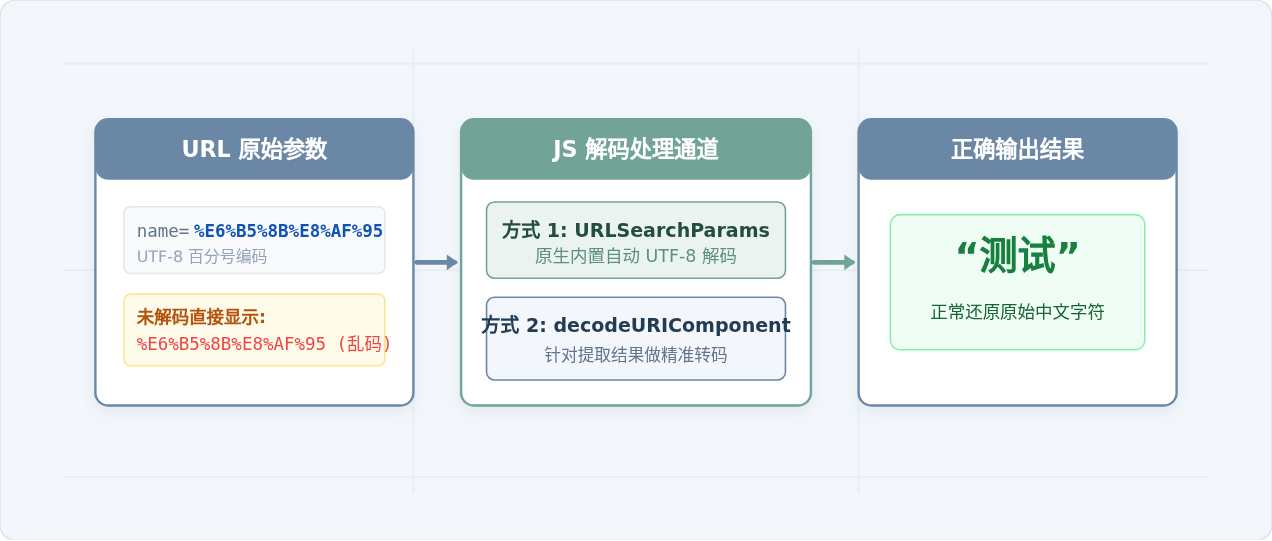
一、为什么获取 URL 参数会出现中文乱码?
在标准的 URI(统一资源标识符)规范中,URL 仅允许包含英文字母、数字和少量特定标点符号(如 -、_、.、!、~、*、'、(、))。包括中文字符在内的所有非 ASCII 字符,在放入 URL Query 时都必须按照某种字符编码转换为字节,再转义为形如 %E4%BD%A0%E5%A5%BD 的百分号编码(Percent-Encoding)。
当 JavaScript 在前端页面中获取这些参数时,出现乱码通常不是因为浏览器“无法显示中文”,而是解码环节与编码环境发生了不匹配。具体表现为以下三种常见根源:
- 截取后未进行 URI 解码:许多开发者使用自定义字符串切割(如
split('?')、split('&'))或正则表达式提取参数值,直接将%E6%B5%8B%E8%AF%95作为字符串赋值给变量,导致页面直接将百分号编码显示出来。 - 双重编码(Double Encoding):发送页面时为了防止网络中间件拦截,代码调用了两次
encodeURIComponent,或者框架路由本身做了一次自动转义而业务代码又编码了一次。前端代码只调用一次解码,取出来的结果依旧是一串百分比字符。 - 字符集编码不一致(UTF-8 与 GBK 冲突):现代浏览器和 JavaScript 默认所有 URL 编解码均为 UTF-8 标准(一个汉字占 3 字节,对应 3 组百分号)。如果跳转来源是老旧政企系统、ASP 站点或特定搜索服务,其 URL 采用 GB2312/GBK 编码(一个汉字占 2 字节),调用 JS 原生
decodeURIComponent时会因找不到合法的 UTF-8 引导序列而直接抛出URIError: URI malformed。
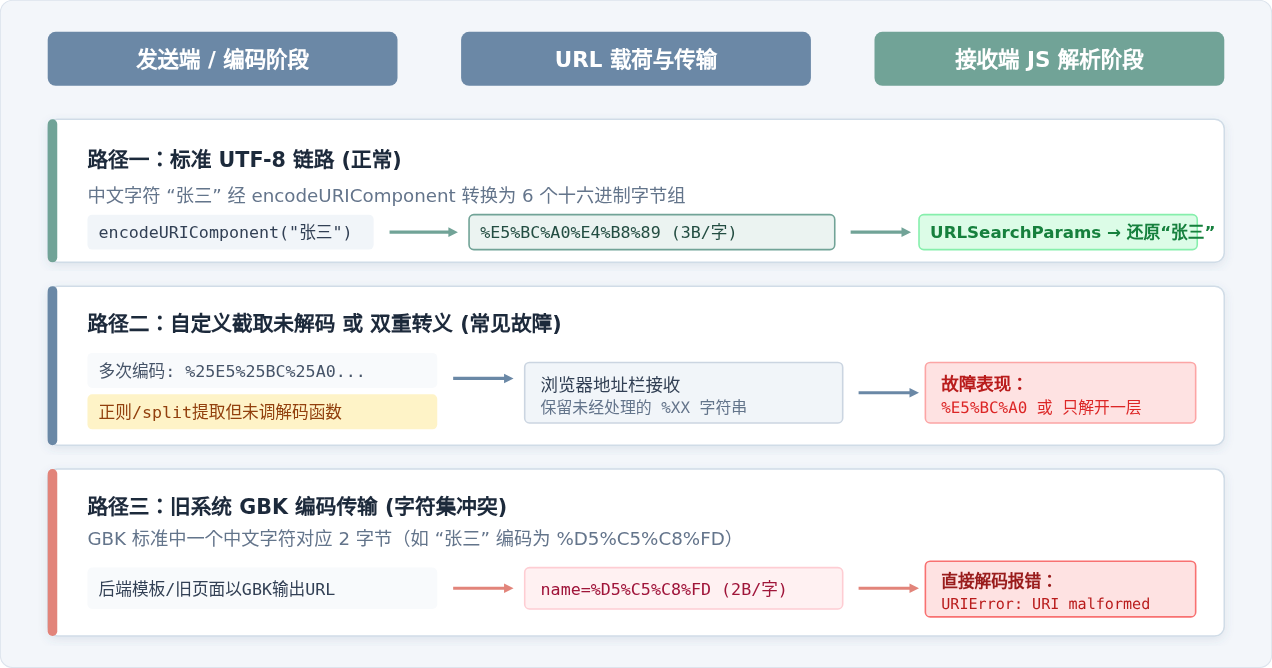
二、快速定位:三步排查乱码的具体表现
排查 URL 中文乱码问题时,切忌盲目套用 escape、unescape 或胡乱堆叠 decodeURIComponent。应先通过浏览器的开发者工具(F12 控制台)观察变量的实际取值,根据具体输出形态快速做出判定:
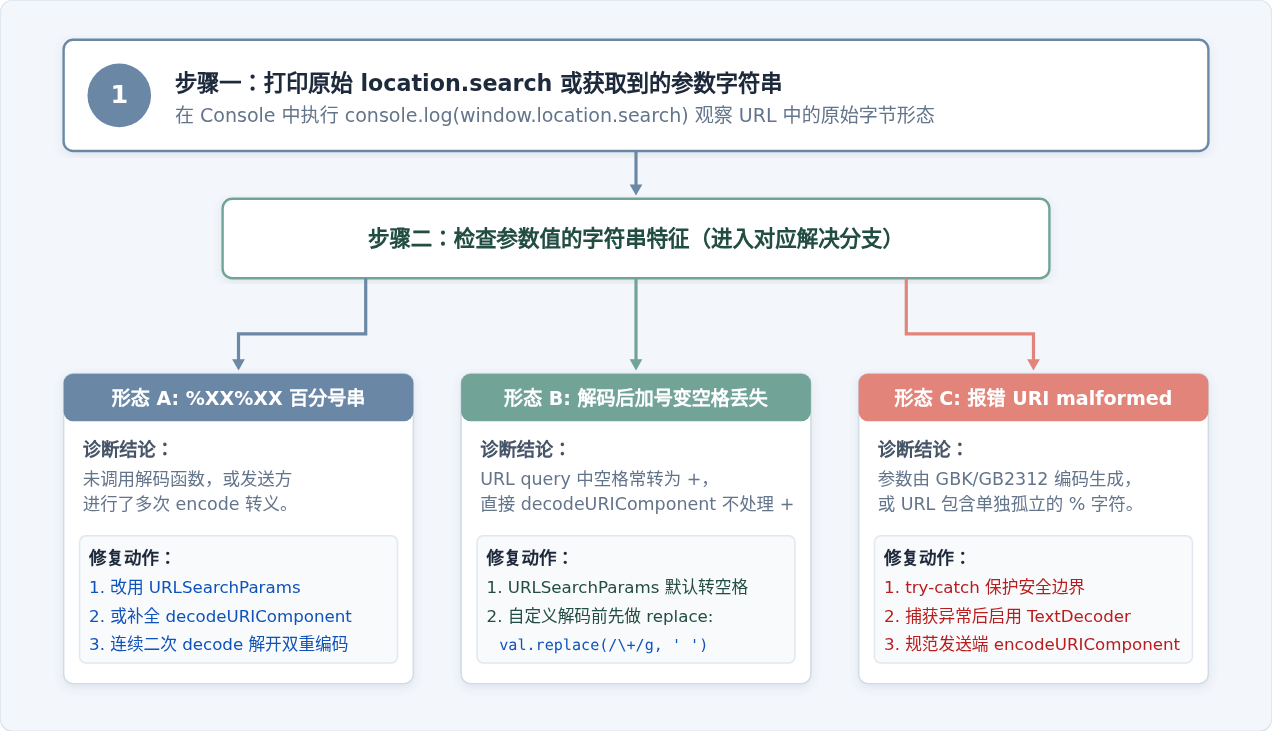
三、现代标准的解决方式:使用 URLSearchParams
在主流的现代浏览器环境(Chrome、Edge、Firefox、Safari 以及 Node.js 10+)中,获取 URL 参数不再推荐手写复杂的正则表达式或 split 字符串拼接。Web 标准规范提供了专用的 URLSearchParams 接口,它会自动根据 UTF-8 规范完成参数解码,并规范处理 + 号转换。
1. 标准 Search Query 参数获取(推荐用法)
假设当前页面访问地址为:
https://example.com/search.html?keyword=%E5%89%8D%E7%AB%AF%E5%BC%80%E5%8F%91&user=%E6%9D%8E%E9%9B%B7使用 URLSearchParams 获取参数的完整代码如下:
// 1. 创建 URLSearchParams 实例,传入 location.search
const searchParams = new URLSearchParams(window.location.search);

// 2. 直接使用 get() 方法读取参数
const keyword = searchParams.get('keyword');
const user = searchParams.get('user');

console.log(keyword); // 输出示例:"前端开发"
console.log(user);    // 输出示例:"李雷"

// 3. 校验参数是否存在
if (searchParams.has('keyword')) {
  console.log('搜索词已提供:', keyword);
}
在上述代码中,searchParams.get() 会在内部主动执行等价于 decodeURIComponent 的标准化解码流程,因此无需在取值后再手动套一层转码函数。
2. 单页面应用哈希路由(Hash Router)中的参数获取
如果你的项目使用了 Vue Router、React HashRouter 等哈希路由机制,URL 可能形如:
https://example.com/#/detail?name=%E5%BC%A0%E4%B8%89&type=%E6%B5%8B%E8%AF%95
此时参数跟在 # 哈希片段之后,window.location.search 取出来会是空字符串。应改用 window.location.hash 并截取问号后面的部分:
function getHashParam(key) {
  const hash = window.location.hash;
  const questionMarkIndex = hash.indexOf('?');

  if (questionMarkIndex === -1) {
    return null;
  }

  const queryString = hash.slice(questionMarkIndex + 1);
  const params = new URLSearchParams(queryString);
  return params.get(key);
}

// 示例调用
const name = getHashParam('name');
console.log(name); // 输出示例:"张三"
四、传统与自定义解析场景的修复方式
如果因为兼容性要求(例如需要兼容 IE 浏览器)或者在第三方拦截器中自行编写了正则解析函数,就必须明确了解 decodeURIComponent 与 decodeURI 的职责界限,避免误用导致新的问题。
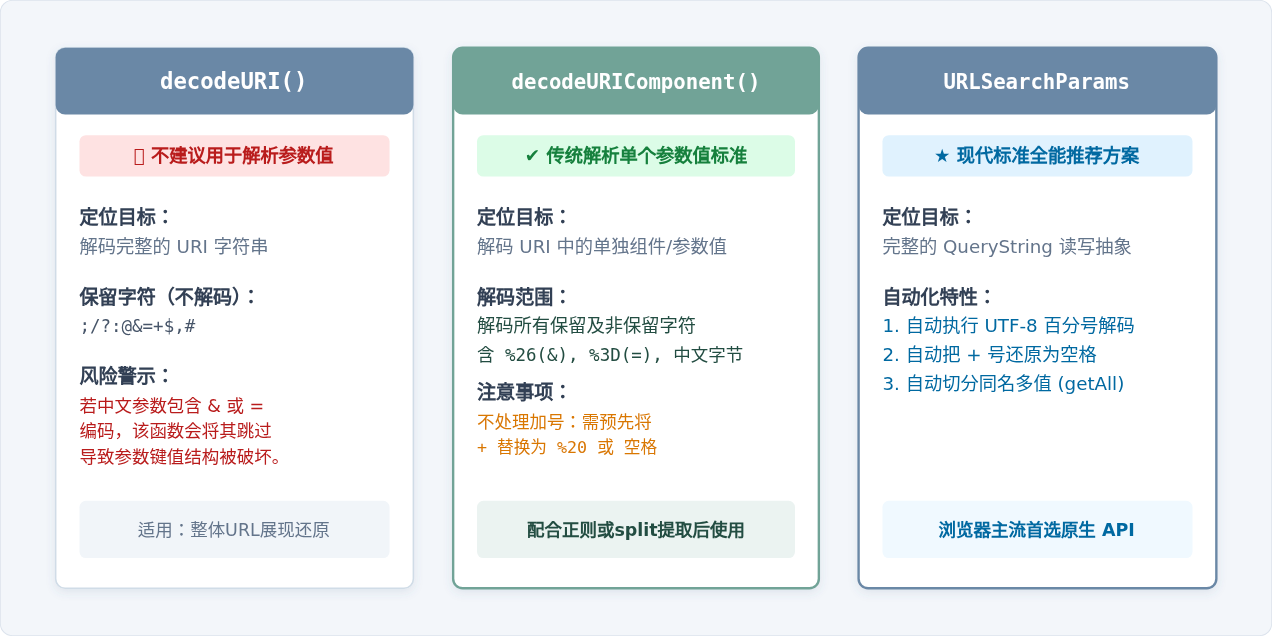
安全自定义提取函数示例
当使用正则表达式或自定义遍历函数提取单个参数时,规范的实现必须包含两项防范机制:
- 在解码前,将
+替换为空格或%20; - 使用
try...catch包裹decodeURIComponent,防止遇到不合法字节时导致全站 JavaScript 执行中断。
/**
 * 健壮的自定义获取 URL 参数函数
 * @param {string} name 参数键名
 * @param {string} [search] 可选传入的 search 字符串,默认为 window.location.search
 * @returns {string|null} 成功解析的中文字符串,未提供则返回 null
 */
function getUrlParamSafe(name, search = window.location.search) {
  // 构造精准匹配键名的正则表达式(匹配 &name=xxx 或 ?name=xxx)
  const reg = new RegExp('(^|&)' + name + '=([^&]*)(&|$)', 'i');
  const matched = search.substr(1).match(reg);

  if (!matched) {
    return null;
  }

  // 提取原始字符串,并将 query 中的加号替换为空格
  const rawVal = matched[2].replace(/\+/g, ' ');

  try {
    // 进行标准 UTF-8 解码
    return decodeURIComponent(rawVal);
  } catch (err) {
    console.warn(`参数 [${name}] UTF-8 解码失败,可能为非 UTF-8 编码或格式畸变:`, err);
    // 降级返回原始字符串或进一步转入字节流解码
    return rawVal;
  }
}

// 示例验证
// 假设 URL: https://example.com/?title=%E4%BD%A0%E5%A5%BD+%E4%B8%96%E7%95%8C
console.log(getUrlParamSafe('title')); // 输出示例:"你好 世界"
五、特殊场景:处理 GBK / GB2312 编码的中文参数
当对接老系统时,很多开发者会遇到无论怎么调用 decodeURIComponent 都会报错抛出 URIError: URI malformed。这是因为 GBK 采用双字节编码中文,例如“技术”两字在 GBK 下被编码为:
// GBK 编码示例
%BC%BC%CA%F5 (每个汉字 2 个十六进制字节组)

// 对应的 UTF-8 编码示例
%E6%8A%80%E6%9C%AF (每个汉字 3 个十六进制字节组)
JavaScript 引擎的原生解码器会按照 UTF-8 首字节规范去寻找后续的 10xxxxxx 字节模式,遇到 GBK 的高位字节便会判定为非法序列并报错。
在现代浏览器中,可以通过原生提供的 TextDecoder API,将 %XX 拆解为无符号 8 位整数数组(Uint8Array),然后指定以 gbk 字符集进行流式解码。
/**
 * 将十六进制百分号编码的字符串按 GBK 字符集解码
 * @param {string} percentStr 形如 "%BC%BC%CA%F5" 的字符串
 * @returns {string} 还原后的中文文本
 */
function decodeGBKPercentString(percentStr) {
  // 1. 去除加号干扰
  const cleanStr = percentStr.replace(/\+/g, ' ');

  // 2. 将百分比编码按字节切分转换为数字字节数组
  const byteMatches = cleanStr.match(/%[0-9A-Fa-f]{2}|[^%]/g);
  if (!byteMatches) {
    return cleanStr;
  }

  const byteList = [];
  for (const item of byteMatches) {
    if (item.startsWith('%')) {
      // 提取两位十六进制数并转为 10 进制整型字节
      byteList.push(parseInt(item.slice(1), 16));
    } else {
      // 普通 ASCII 字符按字符编码推入
      byteList.push(item.charCodeAt(0));
    }
  }

  // 3. 利用 TextDecoder 以 gbk 模式解码字节数组
  const decoder = new TextDecoder('gbk');
  return decoder.decode(new Uint8Array(byteList));
}

// 测试 GBK 编码字符串 "%BC%BC%CA%F5"(技术)
const gbkQuery = "%BC%BC%CA%F5";
console.log(decodeGBKPercentString(gbkQuery)); // 输出示例:"技术"
提示:现代浏览器的
TextDecoder 已原生完整支持 'gbk' 与 'gb2312' 字符集,无需引入大型三方转码库即可完成离线解析。
六、健壮的防御性参数获取封装与总结
在真实业务工程中,最稳健的做法是建立一条自适应防护流水线:优先使用 UTF-8 进行高效解码;一旦触发 URIError 则自动平滑降级到 GBK 字节流探测解码;如果仍然遇到畸形百分号,则进行实体逃逸保底,杜绝脚本中断。
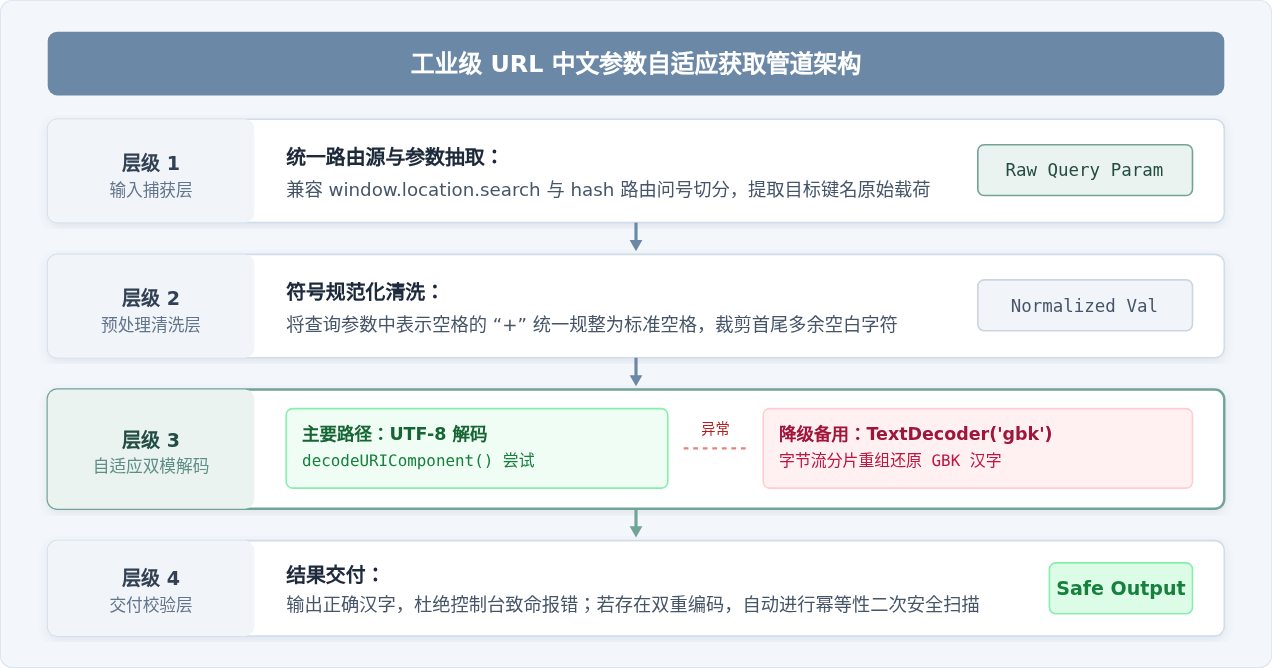
生产级全功能获取函数实现
/**
 * 生产级通用 URL 参数中文获取函数
 * 自动适配:原生 UTF-8 / GBK 异构编码 / Hash 与 History 路由 / 双重编码探测
 * @param {string} key 参数名称
 * @returns {string|null} 成功返回中文文本,无参数返回 null
 */
function getUrlChineseParam(key) {
  // 1. 获取完整的 Query 字符串(兼容常规路由与哈希路由)
  let queryString = window.location.search;
  if (!queryString && window.location.hash.includes('?')) {
    queryString = window.location.hash.substring(window.location.hash.indexOf('?'));
  }

  if (!queryString) return null;

  // 2. 优先通过现代 URLSearchParams 快速获取
  const params = new URLSearchParams(queryString);
  let value = params.get(key);
  if (!value) return null;

  // 3. 探测是否遭遇双重编码(例如取出的字符串仍包含形如 %E6%B5%8B 的模式)
  if (/%[0-9A-Fa-f]{2}/.test(value)) {
    try {
      value = decodeURIComponent(value);
    } catch (e) {
      // 若标准解码异常,尝试使用 TextDecoder 进行 GBK 降级还原
      if (typeof TextDecoder !== 'undefined') {
        try {
          value = decodeGBKPercentString(value);
        } catch (gbkErr) {
          console.error('GBK解码降级失败:', gbkErr);
        }
      }
    }
  }

  return value;
}

// 实际使用示例:
// 访问页面:https://domain.com/?title=%E7%A7%BB%E5%8A%A8%E7%AB%AF%E9%80%82%E9%85%8D
const articleTitle = getUrlChineseParam('title');
console.log(articleTitle); // 输出示例:"移动端适配"
七、关键排查清单与避坑要点
| 常见场景 / 现象 | 产生诱因 | 正确解决做法 |
|---|---|---|
获取到的值是 %E6%9F%A5%E8%AF%A2 |
使用了自定义正则或字符串分割,未执行 URI 解码 | 改用 URLSearchParams.get() 或补充 decodeURIComponent() |
只解开了一半,仍有 %25E6... |
发送端调用了两次 encodeURIComponent |
与发送端协同统一为单次编码,或在前端检测后再次 decodeURIComponent |
控制台抛出 URIError: URI malformed |
URL 含有非法百分号,或参数来自 GBK 编码系统 | 外层添加 try...catch,捕获后调用 TextDecoder('gbk') 解码字节 |
参数中的 + 号未变成空格 |
decodeURIComponent 遵循 URI 规范不会主动转换加号 |
在解码前调用 .replace(/\+/g, ' '),或直接使用 URLSearchParams |
旧项目中使用了 escape / unescape |
该组 API 属于已被废弃的非标准历史遗留方法 | 全面替换为 encodeURIComponent 与 decodeURIComponent |
按照上述步骤排查与处理,便可以解决大部分 JavaScript 获取 URL 参数时的中文乱码问题。在日常开发中,建议统一规范:前端跳转传参时,使用标准的 encodeURIComponent 对单个参数值进行编码;接收端优先选用标准 URLSearchParams 进行读取,并在必要位置加入针对 GBK 与异常格式的防御性降级。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章