

深入解析JavaScript中正则表达式回溯灾难的产生机理与危害,提供识别高危回溯模式的方法,并通过互斥字符集、前瞻模拟原子分组、原生字符串降级及工程兜底加固等四项策略彻底优化正则性能。
怎么优化JavaScript正则性能以避免回溯灾难
作者:性能诊所
时间:2026-11-18
浏览:111
文章目录
JavaScript 性能与工程化
阅读时长:约 10 分钟
适用场景:Node.js 服务端 / 前端高频表单校验 / 安全防护
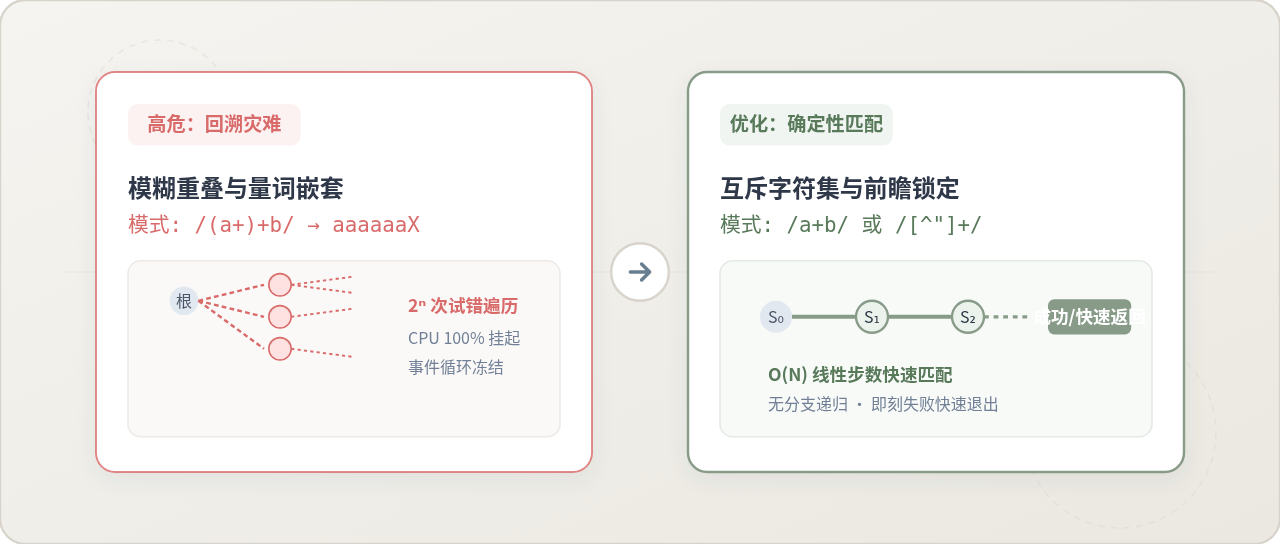
优化 JavaScript 正则性能并避免回溯灾难的核心,在于消除模式中重叠模糊的匹配分支,把引擎原本指数级试错的探索路径降维为线性确定的单向扫描。通过拆除嵌套量词、使用互斥字符集收拢边界、利用前瞻断言模拟原子分组,并在应用入口设置输入长度上限与超时熔断,能够彻底根绝因畸形字符串引发的单线程挂起与正则拒绝服务漏洞。
一、什么是正则回溯灾难与核心成因
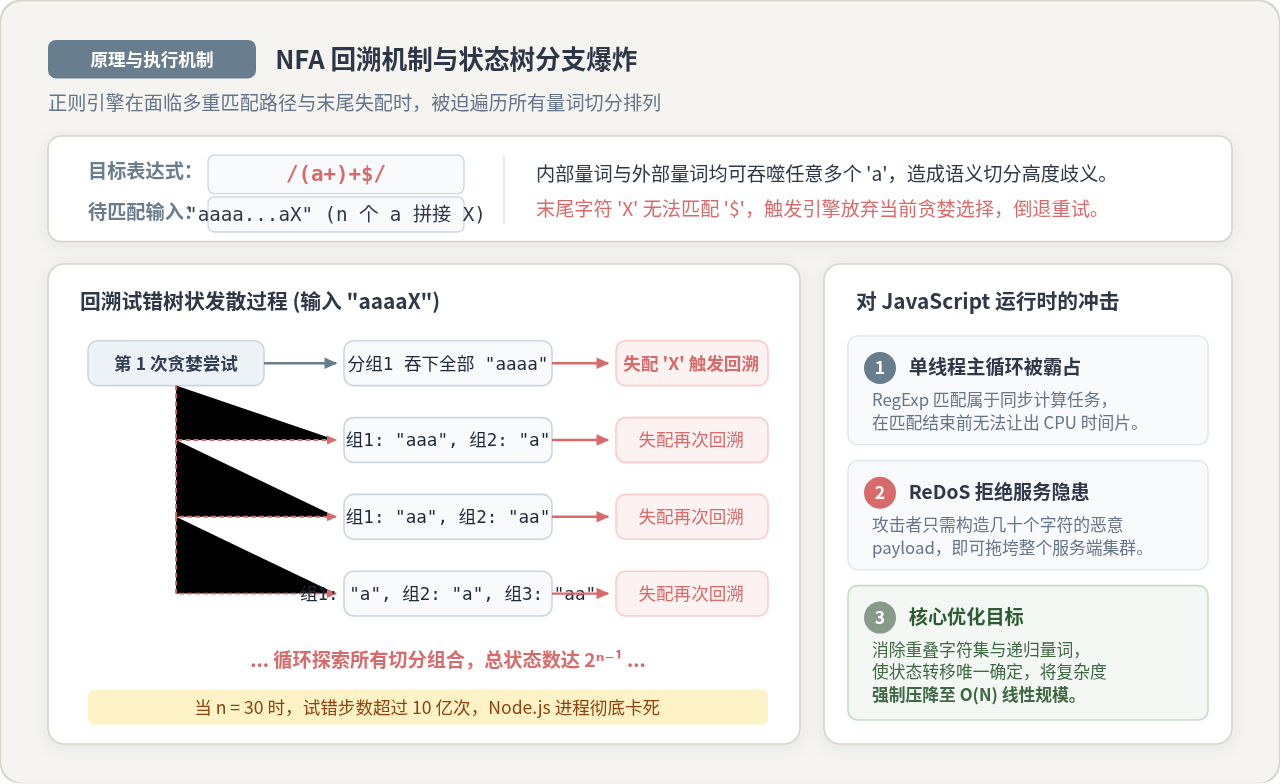
在 JavaScript 规范中,RegExp 引擎采用传统的 非确定性有限状态自动机(NFA,Nondeterministic Finite Automaton) 算法。NFA 引擎的特点是“贪婪优先”与“深度优先记忆”:每当遇到重复量词(如 +、*)或多选分支(|)时,引擎会尽可能多地消耗字符,并在每一次做出选择的地方记录一个“回溯点”。
当待匹配字符串完全符合规则时,NFA 能够很快命中并成功退出。然而,当输入文本与正则模式大部分高度相似、却在末尾关键位置失配时,引擎不会立即判定失败,而是根据历史回溯点逐个回退,尝试重新拆分和组合这些量词所消耗的字符。
灾难的数学本质:如果一个正则表达式中包含多个可以互相重叠、嵌套的量词(例如
/(a+)+$/),对于长度为 \(N\) 且末尾无法匹配的字符串(如 "aaaaaaaaaaaaaX"),引擎需要探索的排列组合数将以 \(O(2^N)\) 的几何级数暴涨。仅需 30 个字符,试错步数就高达上亿次。
更严重的是,JavaScript 的代码执行是单线程事件循环模型。RegExp 的 test()、match() 或 exec() 属于完全同步的 CPU 密集型运算。在主线程进行千万次无效回溯的过程中,事件循环将陷入彻底停滞——Node.js 无法处理后续任何 HTTP 请求,浏览器端则表现为标签页直接冻结无响应。这一现象在安全工程中被称为 ReDoS(Regular Expression Denial of Service,正则拒绝服务)。
二、识别三类最高危的回溯陷阱模式
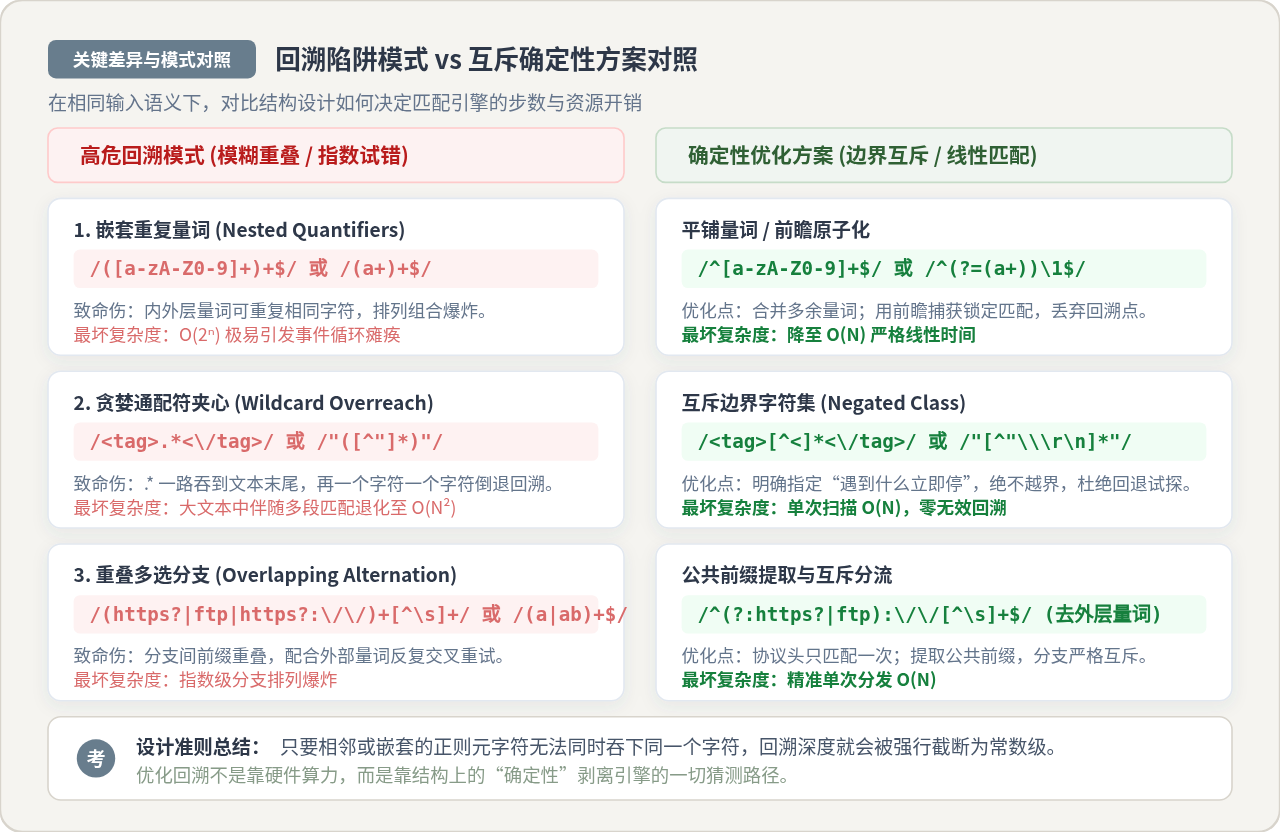
回溯灾难并非随机发生,它们几乎都源于模式定义中的“结构歧义”。在日常代码审查中,以下三类模式最容易埋下隐患:
1. 嵌套量词与同义组合(Nested Quantifiers)
形如 (pattern+)+、(pattern*)* 或 (pattern+)* 的结构。内层量词与外层量词均可反复匹配相同的字符集,导致引擎在切分字符串长度时产生无数种组合方式。
// 危险模式:内层与外层均为 \w+ 或 a+
const badRegex = /^([a-zA-Z0-9]+)+$/;
const input = "aaaaaaaaaaaaaaaaaaaaaaaaaaaaaa!";

// 运行时测试:立即陷入漫长假死,CPU 达到 100%
// badRegex.test(input);
2. 贪婪通配符夹心(Wildcard Sandwich)
在两个特定标记之间使用无限制的 .* 或 .+。例如在解析 HTML 标签、双引号字符串或括号内容时写作 /<tag>.*<\/tag>/。因为 .* 会直接吞下整段文本直至文档尾部,然后一个字符一个字符往前回退,若目标文档很大且缺少闭合标签,将引发成千上万次回溯探寻。
3. 存在包含关系的重叠多选分支(Overlapping Alternation)
在分支结构 | 内部,多个分支可以匹配相同的子序列,并且外部被重复量词修饰。例如 /(a|ab)+$/ 或 /(https?|ftp|https?:\/\/)+[^\s]+\/。遇到未命中输入时,引擎将在不同分支间反复来回切换排列,引发组合爆炸。
三、优化正则性能以消除回溯的四项策略
要彻底消除回溯灾难,不能寄希望于提升服务器硬件性能,而是要从正则语法结构和程序逻辑上剥离引擎的试错空间。以下是经过实战验证的四项重构策略。
策略一:使用互斥字符集明确截断边界(Mutually Exclusive Classes)
当需要匹配由特定边界符号界定的内容时,永远不要使用通配符 .* 或 .*?,而是使用显式的否定字符类(Negated Character Class)。
例如需要匹配被双引号包裹的文本,很多人下意识写作 /".*"/。优化做法是改用 /"[^"]*"/:
// 优化前:贪婪通配,当引号未闭合时长文本回溯巨大
const naivePattern = /"([^"\]|\.)*"/;

// 优化后:显式排斥双引号与换行符,遇到引号即停止,绝不越界回溯
const safePattern = /"[^"\
]*(?:\.[^"\
]*)*"/;
同理,提取 HTML 标签内容时,将 /<div>.*<\/div>/ 替换为 /<div>[^<]*<\/div>/。否定字符集确保了引擎“每走一步都互斥”,一旦遇到失配字符立刻跳出,步数被严格锁定在 \(O(N)\)。
策略二:利用“前瞻断言+反向引用”在 JavaScript 中模拟原子分组
在 Java 或 PCRE 等语言中,支持独占量词(如 a++)和原子分组(Atomic Grouping,如 (?>pattern)),其原理是一旦该部分匹配成功,引擎就会自动丢弃其中的所有回溯点,决不退回重新尝试。
ECMAScript 标准原生尚未引入 (?>...) 语法,但我们可以在 JavaScript 中利用先行断言(Positive Lookahead)与反向引用(Backreference)完美模拟这一行为:
// 核心技巧:利用 (?=(模式))\1 锁定匹配结果
// 原理:先行断言在判断成功后退出,其内部产生的回溯点会被引擎全部清空;
// 紧接着的 \1 消费刚刚断言捕获的内容,此时已没有多余的排列可选。

// 容易发生回溯的写法:
const unsafeRegex = /a+b/;

// 利用前瞻模拟独占量词 a++:
// 匹配 a+ 后立即固化,绝对不允许退让字符给后续的 b
const atomicRegex = /^(?=(a+))b$/;
这种技巧在需要重复匹配长模式但绝不允许部分吐出的场景下极其有效,能在不改动业务逻辑的前提下彻底掐断回溯树的分叉。
策略三:用简单的原生字符串 API 替代模糊通配
正则并非所有文本处理的最佳工具。如果匹配逻辑仅是判断前缀、后缀或子串是否存在,原生字符串方法的执行速度通常比正则引擎快 3 至 10 倍,且绝无回溯风险。
// 避免使用不必要的模糊通配正则
// 不推荐:/.*foo.*/.test(str)
// 推荐使用线性检索:
if (str.includes("foo")) {
  // 业务逻辑
}

// 避免使用 /^prefix/.test(str)
// 推荐:
if (str.startsWith("prefix")) {
  // 业务逻辑
}
策略四:拆解复合规则为管道式验证,避免巨型单体正则
在表单密码复杂度或凭证验证中,开发者经常尝试把所有逻辑写成一个包含多重断言的巨型正则:
// 高危且难以维护的复合正则:
const complexPassRegex = /^(?=.*[a-z])(?=.*[A-Z])(?=.*\d)(?=.*[!@#$%^&*])[A-Za-z\d!@#$%^&*]{8,32}$/;

// 推荐的管道式拆解:清晰、线性、零回溯开销
function validatePassword(password) {
  // 1. 快速基础约束拦截
  if (typeof password !== "string" || password.length < 8 || password.length > 32) {
    return false;
  }
  // 2. 独立互斥判断,单次失败立即短路退出
  if (!/[a-z]/.test(password)) return false;
  if (!/[A-Z]/.test(password)) return false;
  if (!/\d/.test(password)) return false;
  if (!/[!@#$%^&*]/.test(password)) return false;

  return true;
}
管道式校验不仅执行效率更高,而且能针对性给用户返回“缺少大写字母”或“缺少特殊字符”的具体提示,大幅提升交互体验。
四、关键差异对比:回溯陷阱模式 vs 互斥确定性模式
为了让读者更直观地理解两者的本质差异,我们在相同测试条件下(待匹配串为 30 个连续字符 'a' 追加 1 个失配破坏字符 '!',即 "aaaaaaaaaaaaaaaaaaaaaaaaaaaaaa!")对两种写法进行了对比:
| 对比维度 | 回溯陷阱模式 (以 /^([a-z]+)+$/ 为例) |
互斥确定性模式 (以 /^[a-z]+$/ 为例) |
|---|---|---|
| 匹配步数 (Steps) | 超过 1,073,741,824 次(指数级) | 仅需 31 步(线性扫描至末尾) |
| 执行耗时 | 数秒至数分钟(主线程假死) | 小于 0.01 毫秒(即时返回) |
| 时间复杂度 | \(O(2^N)\) 几何爆炸 | \(O(N)\) 严格线性 |
| 回溯栈空间 | 持续压栈可能造成栈溢出 | 零额外记忆开销,常数级内存 |
| 工程可维护性 | 隐蔽性强,遇特定输入突发雪崩 | 语义单一确定,符合代码审查规范 |
从对照中可以看出,两者的区别并不是“微小的代码调优”,而是计算复杂度的量级跃迁。在生产系统中,只要存在一个未经验证的量词嵌套正则,就相当于给应用留下了一个随时可能被击穿的拒绝服务入口。
五、正则性能诊断与防回溯落地步骤
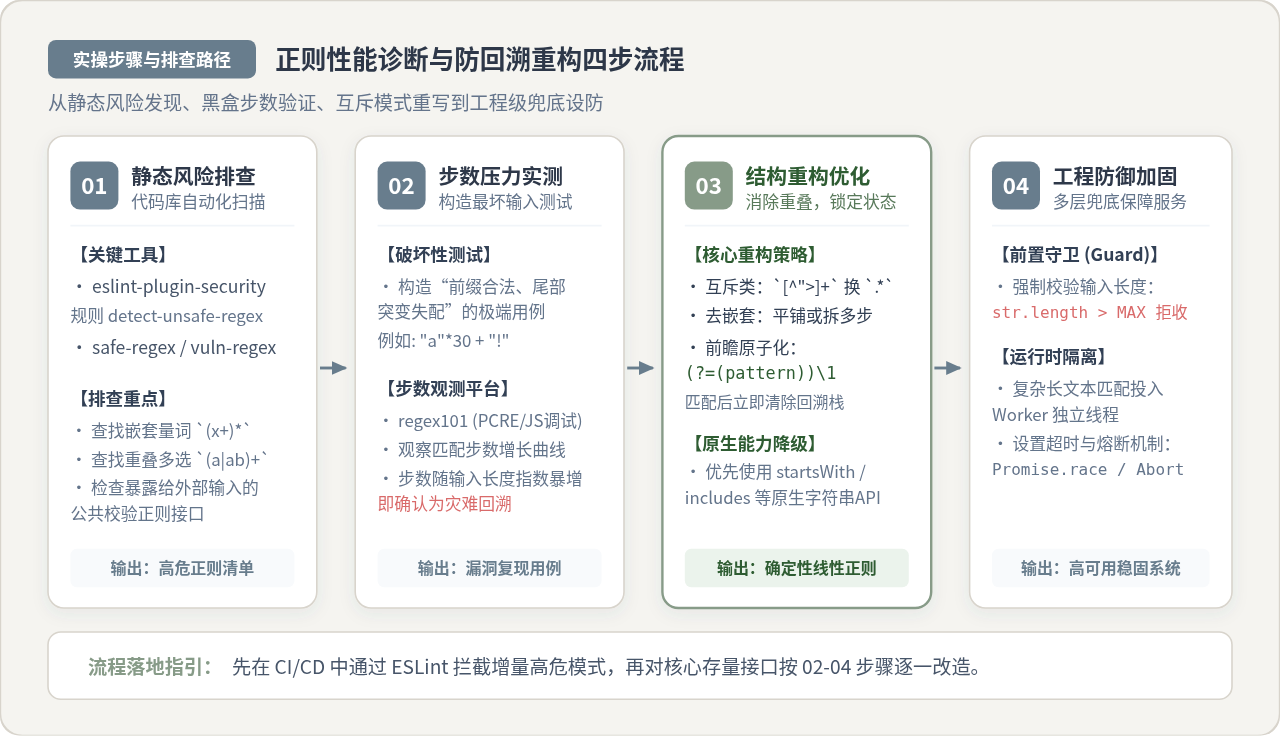
在成熟的软件工程中,防止正则回溯应当形成一条从代码扫描到运行兜底的完整防御链条:
-
步骤 1:静态代码扫描与高危模式拦截
在前端或 Node.js 项目工程中配置 ESLint 安全插件:
在npm install --save-dev eslint-plugin-security.eslintrc.js中开启"security/detect-unsafe-regex": "error",在提交代码与 CI 流水线阶段自动阻断包含高危回溯特征的正则合并。 -
步骤 2:构造失配极端用例进行压力验证
将可疑正则放入 regex101.com 等调试工具中,输入重复前缀且尾部故意失配的字符串,在 Regex Debugger 面板中观察步数(Backtracks)。步数随输入长度线性递增为安全,若呈指数递增则必须重写。 -
步骤 3:运用互斥集与平铺原则实施重构
按照第二节与第三节的方法,将嵌套量词压平,通配符替换为否定字符集,必要时引入前瞻断言锁定状态。 -
步骤 4:入口守卫与运行时隔离兜底
无论正则如何优化,业务代码都必须在入口处做长度防御。同时,对于需要执行用户自定义复杂正则的场景,必须移入独立 Worker 线程:// 1. 输入长度截断保护 function safeValidate(input) { const MAX_SAFE_LENGTH = 1000; if (!input || input.length > MAX_SAFE_LENGTH) { return false; // 超出上限直接拒绝,杜绝长报文渗透 } return SAFE_REGEX.test(input); } // 2. 极端场景使用 Worker 线程超时中断 // 在 Node.js 中通过 worker_threads 运行正则匹配,主线程设定 50ms 超时 // 超时直接 worker.terminate(),保证 HTTP 服务主事件循环不受威胁
六、总结与防御规范
要彻底避免 JavaScript 中的正则回溯灾难,关键不是熟记复杂的 NFA 引擎内部状态机转移图,而是牢牢掌握几项通用的编码防御准则:
- 不给量词嵌套机会:坚决不写
(a+)+、(\d+)*这类模式;需要重复多个项时,改用互斥字符集或将逻辑拆散。 - 慎用贪婪通配符:用明确的终止符否定类(如
[^"< ]+)取代.*。 - 输入前置设防:所有公开接口在调用正则前必须强制校验
input.length,切断算力爆炸的输入源头。 - 关键边界锁定:熟练运用
(?=(pattern))前瞻技术在 JavaScript 中实现确定性原子化匹配。
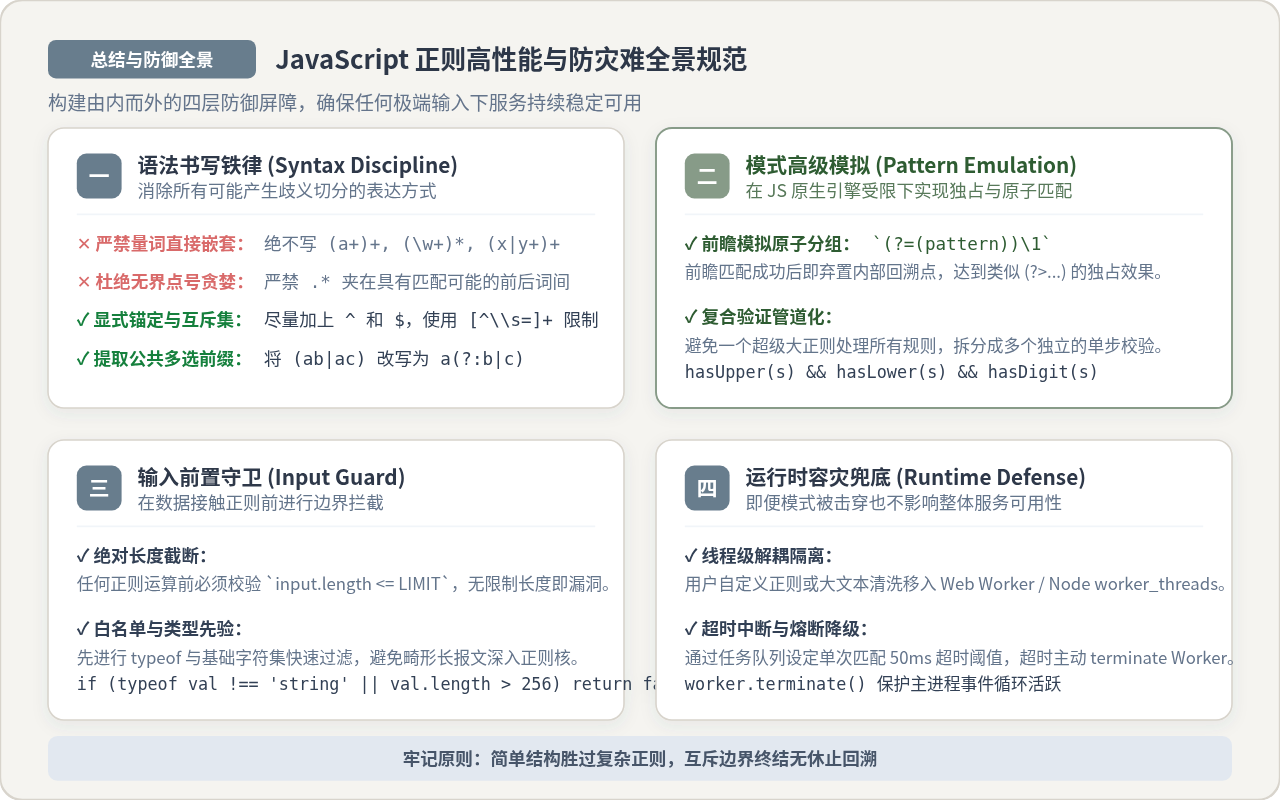
总结:正则表达式是文本处理的锋利工具,但它绝不是银弹。理解它的物理限制,用清晰互斥的边界替代模糊猜测,才能在保持高效文本匹配的同时,筑牢系统稳定运行的高可用防线。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章