
深入讲解在Node.js中如何将各类编码字符串转换为字节数组,利用Buffer与TypedArray进行严谨高效的二进制数据处理,剖析底层内存原理并规避常见编码陷阱。

当前位置:首页 > Node.js 基础 > 正文
js字符串转数组处理二进制BufferNode.js
作者:终端旅客
时间:2026-11-13
浏览:513
文章目录
在 Node.js 与 JavaScript 中处理二进制数据时,最关键的一环是将不同编码格式的字符串(如常规 UTF-8 文本、十六进制 Hex、Base64)准确转换为字节序列,再组织为数组进行位运算、校验和计算或报文重组。核心解决方案并不是简单的 str.split('') 拆分字符,而是依托 Node.js 原生的 Buffer.from(str, encoding) 生成字节缓冲区,直接将其作为 Uint8Array 遍历,或使用 Array.from(buf) 转为常规数字数组进行底层字节处理。
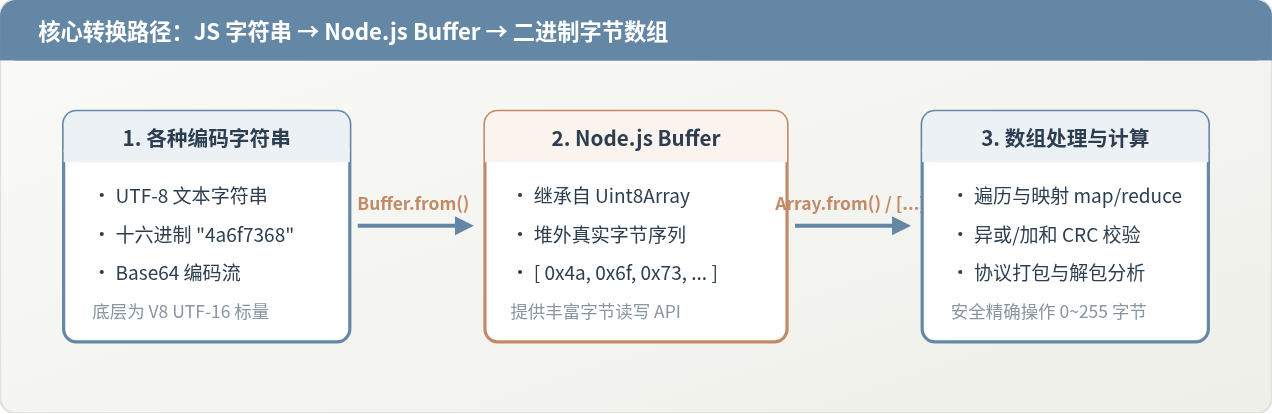
图 0:JavaScript 字符串转数组处理二进制数据的核心通路
一、为什么不能直接用 split('') 处理二进制
初学者在尝试将字符串转化为数组时,通常会直觉地调用 str.split('')。在纯 ASCII 文本场景下,结合 charCodeAt(0) 或许看似能得到一组数字,但在实际的二进制场景(如解析网络报文、处理文件流、加密算法输入)中,这种做法会直接引发数据破坏:
- 编码深度差异:JavaScript 内部的字符串采用 UTF-16 编码存储,而绝大多数网络协议和文件存储使用 UTF-8 编码或原始单字节。一个包含中文或 Emoji 的字符,在 UTF-16 中对应 1 到 2 个码元,而在 UTF-8 下实际占 3 到 4 个物理字节。直接按字符分割完全丢失了真实的底层字节长度。
- 数值截断问题:
charCodeAt(0)返回的是 0 到 65535 的双字节整数,而底层二进制通信单位是 0 到 255 的单字节(Byte)。直接分割无法还原真实的字节流。 - 特定格式解析失败:如果输入是十六进制字符串(如
"0A1B2C")或 Base64 编码字符串,每两个字符或每四个字符代表一组字节,字符本身并不等于字节数值。
二、各种格式字符串转二进制数组的具体实现
在 Node.js 中,最标准且高效的做法是先用 Buffer.from() 明确指定解码规则获取字节序列,再将 Buffer 实例作为类数组对象进行转换或直接遍历。
1. 常规 UTF-8 文本字符串转换为字节数组
当需要将普通的文本转换为对应的 UTF-8 字节并存入数组时:
// Node.js 环境下完整示例
const str = 'Node.js二进制';

// 步骤一:转为 UTF-8 编码的 Buffer 实例
const buf = Buffer.from(str, 'utf8');

// 步骤二:将 Buffer 转为标准 JS 数组(数字类型,范围 0-255)
const byteArray = Array.from(buf);
// 也可以使用展开运算符:const byteArray = [...buf];

console.log('字节长度:', buf.length);
// 示例输出:字节长度: 16 (英文字符各占1字节,中文各占3字节)
console.log('字节数组:', byteArray);
// 示例输出: [ 78, 111, 100, 101, 46, 106, 115, 238, 186, 140, 232, 191, 155, 229, 136, 182 ]
跨平台通用提示(浏览器与 Node.js 通用):
在现代前端或无 Node.js 内置模块的环境中,可以使用标准的 Web API
在现代前端或无 Node.js 内置模块的环境中,可以使用标准的 Web API
new TextEncoder().encode(str),它直接返回一个 Uint8Array,同样可以通过 Array.from() 转为常规数组。
2. 十六进制(Hex)字符串转换为字节数组
在硬件串口通信、Modbus 协议或哈希验签场景下,数据通常以十六进制字符串表示(例如 "010300000002C40B"):
// 必须确保 Hex 字符串长度为偶数
const hexStr = '48656c6c6f'; // ASCII 对应的 "Hello"

// 通过 'hex' 编码直接解析
const hexBuffer = Buffer.from(hexStr, 'hex');
const hexArray = Array.from(hexBuffer);

console.log('十进制字节数组:', hexArray);
// 示例输出: [ 72, 101, 108, 108, 111 ]

const formattedHex = hexArray.map(b => '0x' + b.toString(16).padStart(2, '0'));
console.log('规范十六进制数组:', formattedHex);
// 示例输出: [ '0x48', '0x65', '0x6c', '0x6c', '0x6f' ]
3. Base64 编码字符串转换为字节数组
图片传输、加密传输中常常涉及 Base64 字符串:
const base64Str = 'SGVsbG8gV29ybGQ=';

const base64Buffer = Buffer.from(base64Str, 'base64');
const base64Bytes = Array.from(base64Buffer);

console.log('解析结果:', base64Bytes);
// 示例输出: [ 72, 101, 108, 108, 111, 32, 87, 111, 114, 108, 100 ]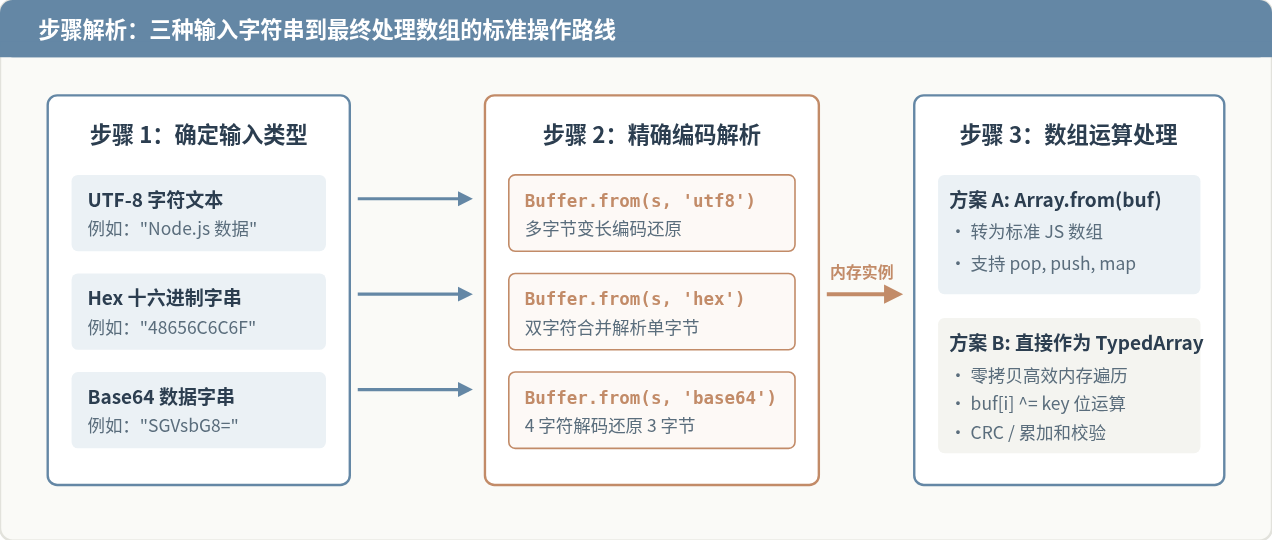
图 1:从不同编码形式字符串到二进制数组的操作流程
三、深入原理:V8 字符串、Buffer 与 TypedArray 内存机制
为了在实际应用中避免内存泄漏与意外开销,必须理解 JavaScript 引擎内部处理字符串与 Node.js 内存分配的底层机理:
- V8 堆内存中的 String:JavaScript 中的字符串是不可变的(Immutable),内部通常以 UTF-16 形式分配在 V8 虚拟机的垃圾回收堆(V8 Heap)上。频繁通过字符串拼接和裁剪会产生大量短生命周期的临时字符串对象,给 GC 带来压力。
- Node.js Buffer 的底层本质(Uint8Array 的子类):从 Node.js v8.0 起,
Buffer类直接继承自 ECMAScript 标准的Uint8Array。它内部指向一段底层的ArrayBuffer,其物理内存是在 C++ 层面通过堆外内存(ArrayBuffer allocator)分配的。 - Slab 内存池分配机制:对于小于 4KB(
Buffer.poolSize / 2,默认 8KB 的一半)的小 Buffer,Node.js 不会单独向操作系统申请内存,而是从一个预先分配好的 Slab 连续内存池中切片(slice)出来。这意味着你获得的小 Buffer 实际上只是某个大ArrayBuffer的一段视图(View)。
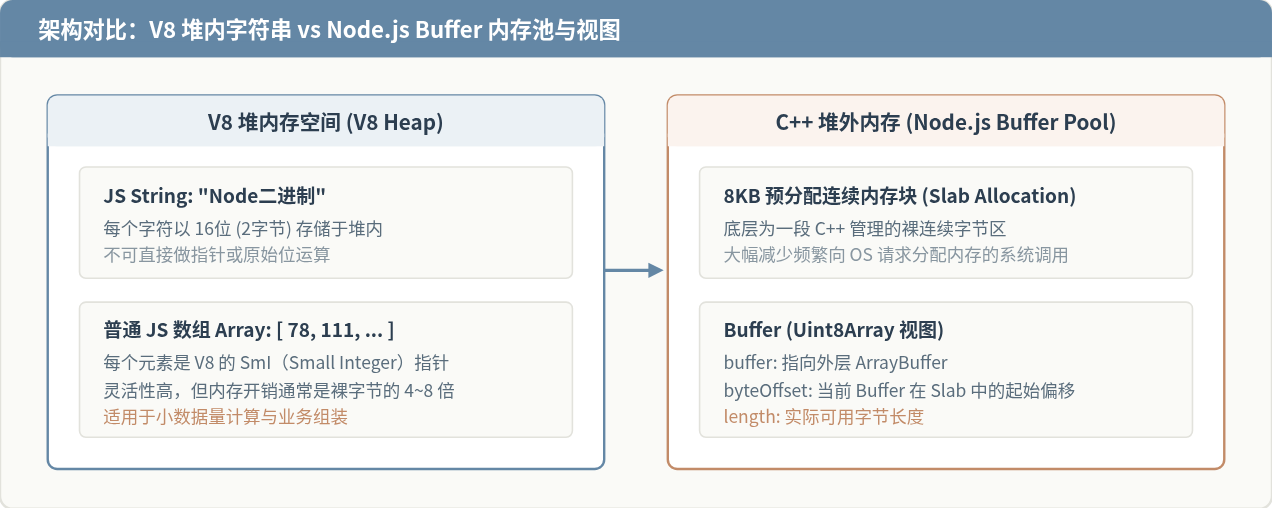
图 2:V8 堆内存中的字符串与 Node.js 堆外 Buffer 内存架构
四、关键陷阱与避坑指南
在字符串转数组和处理 Buffer 的过程中,有三个最容易导致线上故障的隐蔽细节,需要开发者格外留心。
1. 陷阱一:直接通过 split('') + charCodeAt 截断多字节字符
很多代码片段试图通过以下方式将字符串转为字节数组:
// 错误示范:切勿在生产环境中使用!
function badStringToBytes(str) {
    return str.split('').map(char => char.charCodeAt(0));
}

const result = badStringToBytes('A中');
console.log(result);
// 输出: [ 65, 20013 ] -> '中' 的 Unicode 是 20013 (0x4E2D)
// 20013 远远超出单字节 0-255 的限制!写入二进制流将直接溢出或截断!
在网络 I/O 中,单字节传输要求值在 0 ~ 255。字符 '中' 的标准 UTF-8 字节应当是三字节:[ 0xE4, 0xB8, 0xAD ](十进制 228, 184, 173)。使用 charCodeAt(0) 完全无法获取真实的 UTF-8 字节数组。
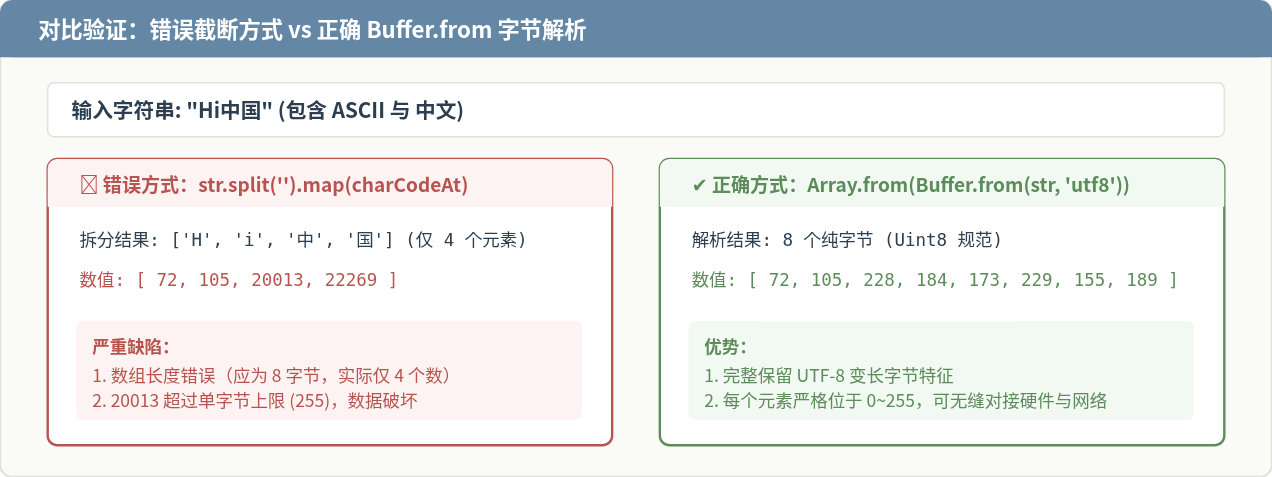
图 3:字符串转字节数组时错误与正确做法的实际产物对比
2. 陷阱二:Slab 内存共享导致的 buf.buffer 越界
当通过 buf.buffer 直接获取底层 ArrayBuffer 时,如果不检查 buf.byteOffset 和 buf.length,会读到同属于同一个 Slab 的其他 Buffer 数据:
const smallBuf = Buffer.from('abc');

// 错误做法:直接拿 underlying ArrayBuffer 当作整个数据
const rawBuffer = smallBuf.buffer;
console.log(rawBuffer.byteLength);
// 输出很可能是 8192 (8KB),而不是 3!包含了其他内存片段!

// 正确做法:必须带上 byteOffset 与 length 进行裁剪或零拷贝视图创建
const accurateArray = new Uint8Array(
    smallBuf.buffer,
    smallBuf.byteOffset,
    smallBuf.length
);
console.log(accurateArray.length); // 精确的 3
3. 陷阱三:Hex 字符串奇数长度截断
使用 Buffer.from(hexStr, 'hex') 时,Node.js 要求两个十六进制字符凑成一个字节。如果输入的字符串长度是奇数(例如 "abc"),Node.js 会自动忽略最后一个无法配对的字符,导致原本的最后一个半字节数据静默丢失。在处理来自用户输入或日志中未对齐的 Hex 字符串时,务必提前补齐前导 0 或进行长度校验:
function safeHexToBuffer(hex) {
    const cleanHex = hex.startsWith('0x') ? hex.slice(2) : hex;
    const alignedHex = cleanHex.length % 2 !== 0 ? '0' + cleanHex : cleanHex;
    return Buffer.from(alignedHex, 'hex');
}
五、二进制数组的操作与逆向转换
将字符串成功转为字节数组后,通常需要进行修改、掩码计算或生成校验和,最后再将数组重新打包还原为 Buffer 发送或存储:
// 1. 将字符串转为数字字节数组
const initialStr = 'UserAuthToken';
const bytes = Array.from(Buffer.from(initialStr, 'utf8'));

// 2. 对字节数组进行二进制处理(例如简单的异或掩码加密)
const XOR_KEY = 0x5A;
const encryptedBytes = bytes.map(byte => byte ^ XOR_KEY);

// 3. 计算简单累加和校验码(Checksum 0-255)
const checksum = encryptedBytes.reduce((acc, curr) => (acc + curr) & 0xFF, 0);
encryptedBytes.push(checksum);

// 4. 将处理完成的数字数组逆向转回 Node.js Buffer
const finalBuffer = Buffer.from(encryptedBytes);

// 5. 按需转为 Hex 或 Base64 格式进行传输
console.log('最终传输Hex:', finalBuffer.toString('hex'));
console.log('最终传输Base64:', finalBuffer.toString('base64'));
六、方案选型与决策总结
面对不同的业务场景与性能要求,选择最合适的转换路径能大幅减少内存开销并提升吞吐量:
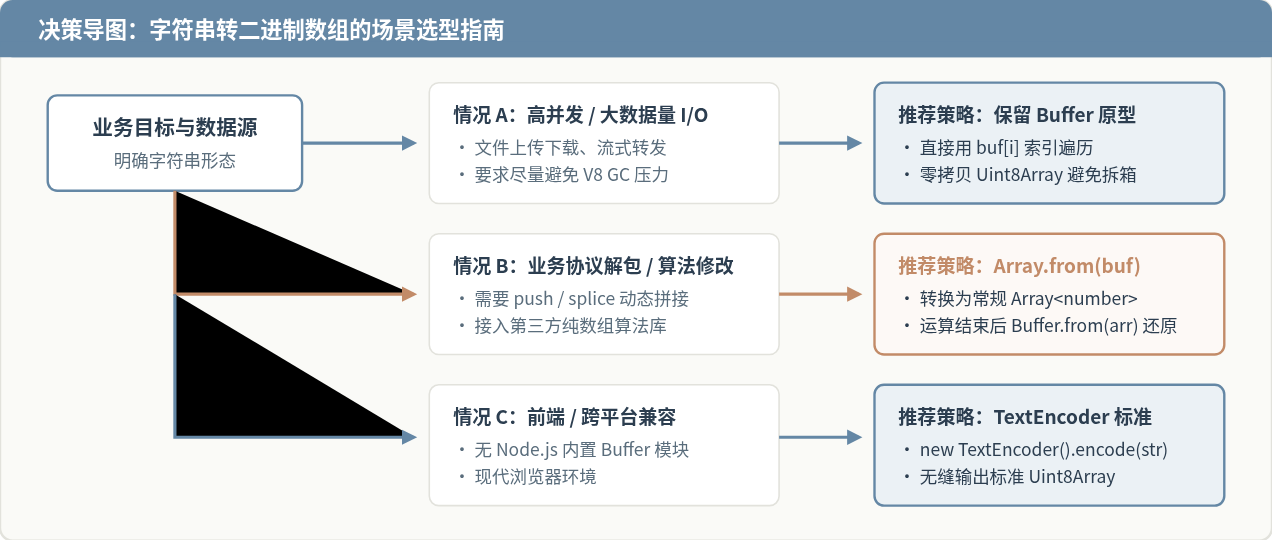
图 4:JavaScript 与 Node.js 字符串转二进制数组的决策路径
总结而言,处理二进制数据时,务必将字符视作高层抽象表示,将字节视作底层物理序列。无论是 UTF-8 文本、Hex 还是 Base64,始终先通过 Buffer.from(str, encoding) 正确解码获取精确的字节流,再按需选择在 Buffer 原型上高效处理或展开为标准 JavaScript 数组,这是保障数据准确性与执行效率的最稳妥实践。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章