
深入解析 ECMAScript 全新 Uint8Array.fromBase64 API,从底层原理、核心参数配置到 Base64 字符串转 Uint8Array 及普通数组的完整实战与兼容方案。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
js字符串转数组ES2026Uint8Array.fromBase64新API
作者:纸飞机
时间:2026-11-13
浏览:427
文章目录
ECMAScript 原生新特性 · 二进制数据处理
知识分类:JavaScript 进阶 / 标准库规范
适用环境:现代浏览器、Node.js 22+、Deno、Bun
在过去的 JavaScript 开发中,将 Base64 编码的文本字符串解码并转换为字节数组一直缺乏语言级标准 API,开发者不得不依赖浏览器特有的
atob() 配合手动遍历,或者在 Node.js 中调用专有的 Buffer.from()。全新的 Uint8Array.fromBase64 静态方法将 Base64 解码直接纳入 ECMAScript 标准库,使 JavaScript 开发者无需任何第三方依赖即可高效、安全地完成字符串到定型数组(Uint8Array)乃至普通 JavaScript 数组的转换。
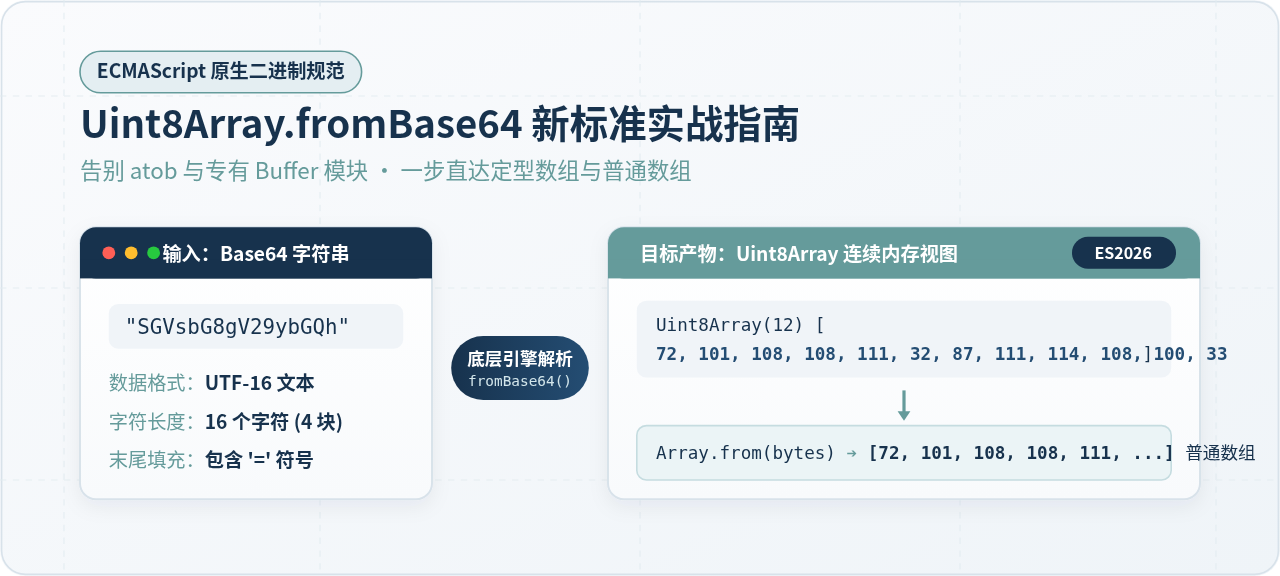
一、传统 Base64 转数组的痛点与新标准解法
在实际 Web 应用与服务端接口中,诸如图片音视频数据、文件下载流、加密签名(Web Crypto API)以及网络传输数据包,经常以 Base64 字符串的形式呈现。然而,底层的字节比对、数据解包或像素操作,必须在数组或定型数组(TypedArray)中完成。
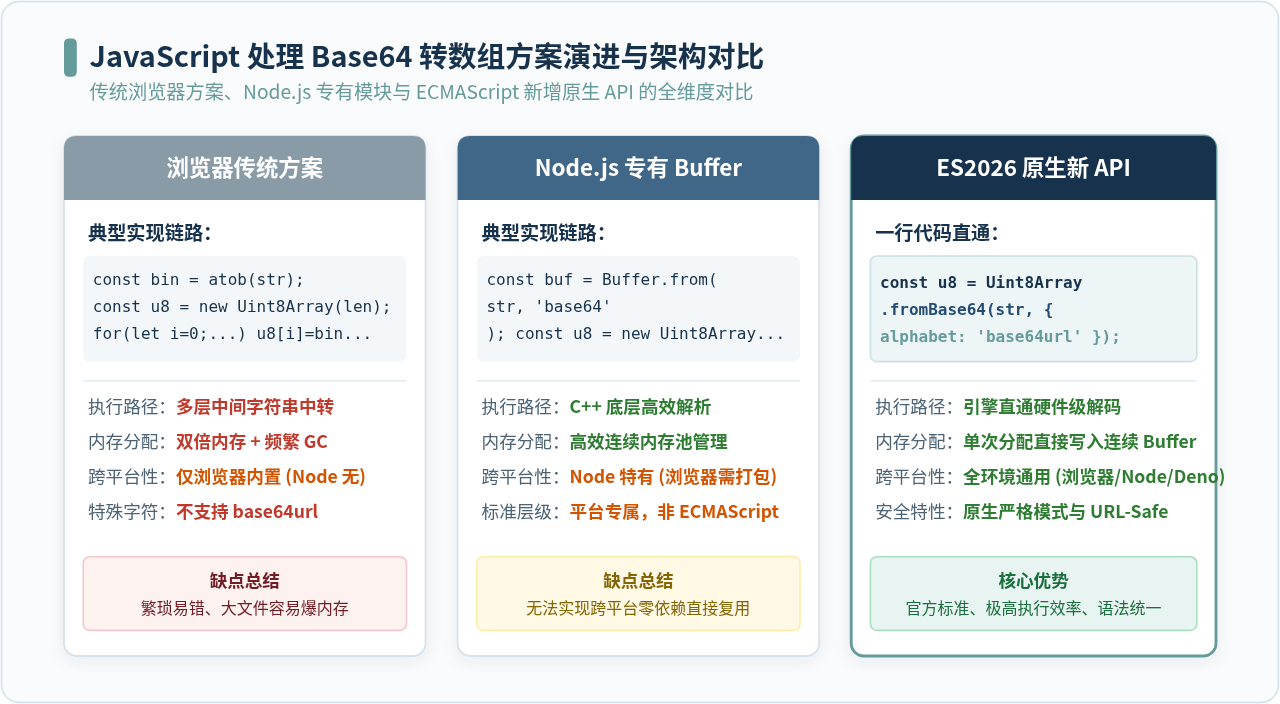
在 Uint8Array.fromBase64 推出之前,行业内长期存在两套互不通用的转换路径:
-
浏览器传统路径:依赖全局函数
atob(base64Str)解码为二进制字符串(Binary String),随后开辟一个Uint8Array,通过for循环调用charCodeAt(i)逐字节写入。这一过程产生了不必要的中间字符串对象,在大文件或高并发解析时会导致显著的垃圾回收(GC)开销与卡顿。 -
Node.js 专有路径:依赖
Buffer.from(base64Str, 'base64')。该方案虽然执行性能优秀,但属于 Node.js 运行时特有的平台 API,无法直接在浏览器或其他非 Node 环境下无缝复用,编写跨平台库时往往需要打包庞大的垫片库。
ECMAScript 推出的 Uint8Array.fromBase64 静态方法从底层终结了这种碎片化局面。它由 JavaScript 虚拟机底层(如 V8、JavaScriptCore)采用原生 C++ 实现,直接在分配好的连续内存块中完成位运算与字节填充,实现了全平台一致的语言级标准规范。
二、核心转换步骤:从 Base64 到 Uint8Array 及普通数组
使用新 API 将 Base64 字符串解析为数组仅需两步:首先调用 Uint8Array.fromBase64() 生成高效的定型数组,若后续业务需要使用常规数组的完整原型方法,再将其映射为普通数组。
1. 基础转换:解析为 Uint8Array
直接将待解码的字符串传入 Uint8Array.fromBase64(),方法会同步返回一个包含对应字节数据的 Uint8Array 实例:
// 待解码的标准 Base64 字符串(对应 ASCII 文本 "Hello World!")
const base64String = "SGVsbG8gV29ybGQh";

// 使用全新 API 一步解码为 Uint8Array
const uint8Bytes = Uint8Array.fromBase64(base64String);

console.log(uint8Bytes);
console.log(uint8Bytes.byteLength); // 12 字节
示例运行输出
Uint8Array(12) [ 72, 101, 108, 108, 111, 32, 87, 111, 114, 108, 100, 33 ]12
2. 派生为常规 JavaScript 数组
Uint8Array 属于定型数组(TypedArray),具备极高的内存紧凑度与读取性能,但它并不具备某些常规数组的方法(如 push、pop、splice 等,因为定型数组的内存长度是固定的)。若业务逻辑需要操作普通数组,可以通过以下两种方式完成转换:
// 方式一:使用 Array.from()
const normalArray1 = Array.from(uint8Bytes);

// 方式二:使用扩展运算符 (Spread Syntax)
const normalArray2 = [...uint8Bytes];

console.log(Array.isArray(normalArray1)); // true
console.log(normalArray1);
示例运行输出
true[ 72, 101, 108, 108, 111, 32, 87, 111, 114, 108, 100, 33 ]
3. 配套对称方法:字节数组转回 Base64
与 fromBase64 对应,新标准还同时在原型链上提供了 Uint8Array.prototype.toBase64(),用于快速将字节数组反向编码为 Base64 字符串:
// 将已有字节数组直接转回 Base64 文本
const encodedStr = uint8Bytes.toBase64();
console.log(encodedStr); // 输出: "SGVsbG8gV29ybGQh"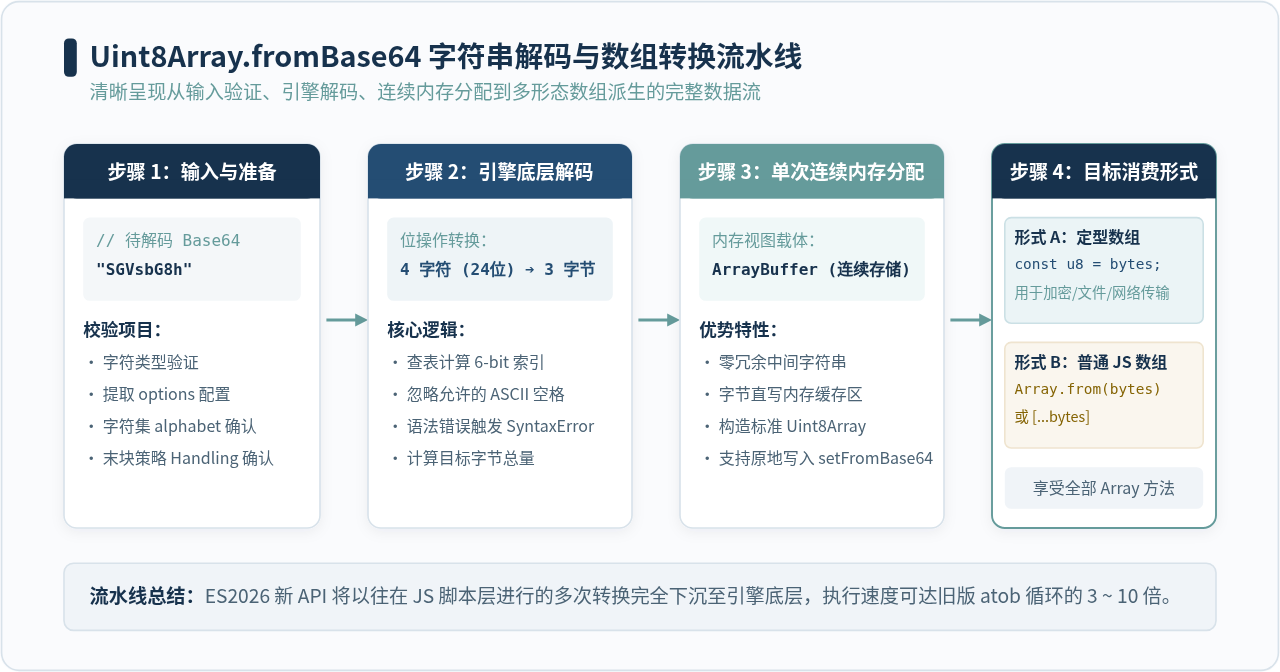
三、深入 options 配置项:字符集与末端对齐控制
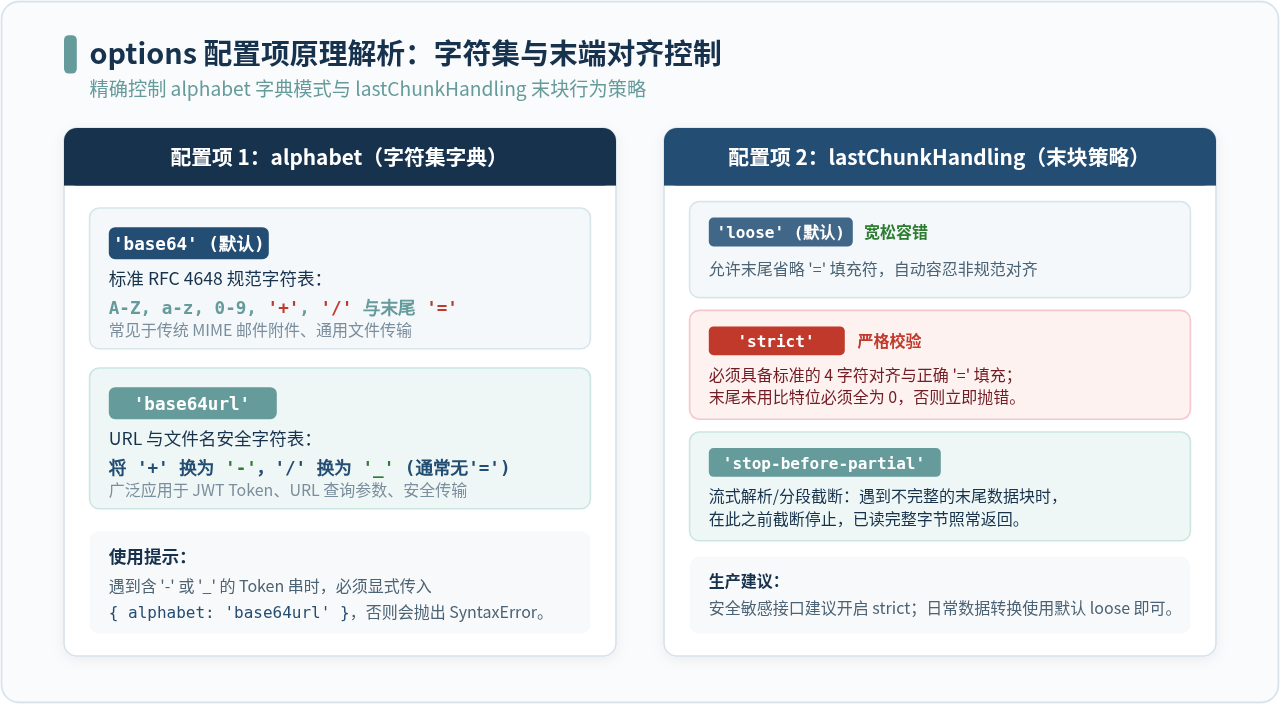
Uint8Array.fromBase64(string, options) 支持第二个可选的配置对象 options。合理使用这些参数可以处理非标准字符集、缺失填充符以及流式解析等特殊场景。
| 参数名称 | 可选值 | 默认值 | 核心作用与适用场景 |
|---|---|---|---|
alphabet |
'base64' | 'base64url' |
'base64' |
指定字符集编码。为 'base64url' 时兼容 URL-safe 模式(+ 替换为 -,/ 替换为 _)。 |
lastChunkHandling |
'loose' | 'strict' | 'stop-before-partial' |
'loose' |
控制末尾非完整数据块的容错机制。'strict' 模式校验必须有规范的 = 补齐且剩余位为 0。 |
1. 处理 URL-Safe Base64(URL 与 Token 场景)
在 JSON Web Token (JWT) 或 URL 参数中,为了避免字符在 URL 解析中产生混淆,通常会将 + 和 / 分别替换为 - 和 _,且经常省略末尾的 =。此时只需声明 alphabet: 'base64url':
// 包含 URL-Safe 字符 '-' 的 Base64 字符串
const tokenPart = "2-j_";

// 若直接按默认 base64 解析会报 SyntaxError
// 显式传入 alphabet: 'base64url' 即可正确解析
const urlSafeBytes = Uint8Array.fromBase64(tokenPart, {
  alphabet: 'base64url'
});

console.log(urlSafeBytes);
示例运行输出
Uint8Array(3) [ 219, 232, 255 ]
2. lastChunkHandling 的三种行为差异
Base64 规定每 4 个 ASCII 字符映射 3 个原始字节。当遇到末尾不满足 4 字符对齐的数据块时:
-
'loose'(默认模式):宽松宽容。如果字符串结尾缺失了=填充符号,底层解析器会自动推导并补齐,不会中断程序执行。 -
'strict'(严格模式):安全合规。要求输入串必须具备标准且正确的=补位,同时未使用的冗余位必须全为 0。若检测到任何不合规填充,立即抛出SyntaxError异常。适合对数据完整性要求严苛的金融支付或密码学校验场景。 -
'stop-before-partial'(部分截断模式):流式友好。若末端出现不完整的字符块,解析器会在该块之前安全停止,只返回前面完整 4 字符块解码出的数据,为流式分片缓冲处理提供了便利。
四、进阶特性:原地填充 setFromBase64 与十六进制 API
除了静态方法 fromBase64,该标准还一并引入了两个非常重要的高性能配套 API:
1. 原地写入:Uint8Array.prototype.setFromBase64
在高频解码或者大文件分块处理时,每次解码都创建一个新的 Uint8Array 会持续消耗内存并造成 GC 负担。通过 setFromBase64 可以直接将 Base64 数据解码写入已经存在的数组缓冲区中:
// 预先分配一块 32 字节的缓冲区
const reusableBuffer = new Uint8Array(32);

// 原地解码并写入,返回写入状态报告
const writeResult = reusableBuffer.setFromBase64("SGVsbG8=");

console.log(writeResult);
// 输出: { read: 8, written: 5 }
// read: 消耗的源字符串字符数
// written: 实际向缓冲区写入的字节数
性能建议
在网络长连接接收高频小报文时,建议维护一个可复用的预分配 Uint8Array 内存池,配合 setFromBase64 执行原地更新,能有效压低 V8 堆内存波动。
2. 兄弟方法:十六进制互转 (fromHex 与 toHex)
过去将 "48656c6c6f" 这类 HEX 十六进制字符串转为字节数组同样需要繁琐的截取转换,如今 ECMAScript 同时提供了对应的标准静态方法:
// 十六进制字符串一步转字节数组
const hexBytes = Uint8Array.fromHex("48656c6c6f");
console.log(hexBytes); // Uint8Array(5) [ 72, 101, 108, 108, 111 ]

// 逆向转回十六进制文本
const hexString = hexBytes.toHex();
console.log(hexString); // "48656c6c6f"
五、生产环境适配与向前兼容方案
新标准已在现代主流浏览器内核(如 Chrome 125+、Safari 17.4+、Firefox 最新版)以及 Node.js 22+ 中原生实装。在面向多样化客户端的生产项目中,推荐使用“特性检测 + Polyfill / 优雅降级”的工程化策略。
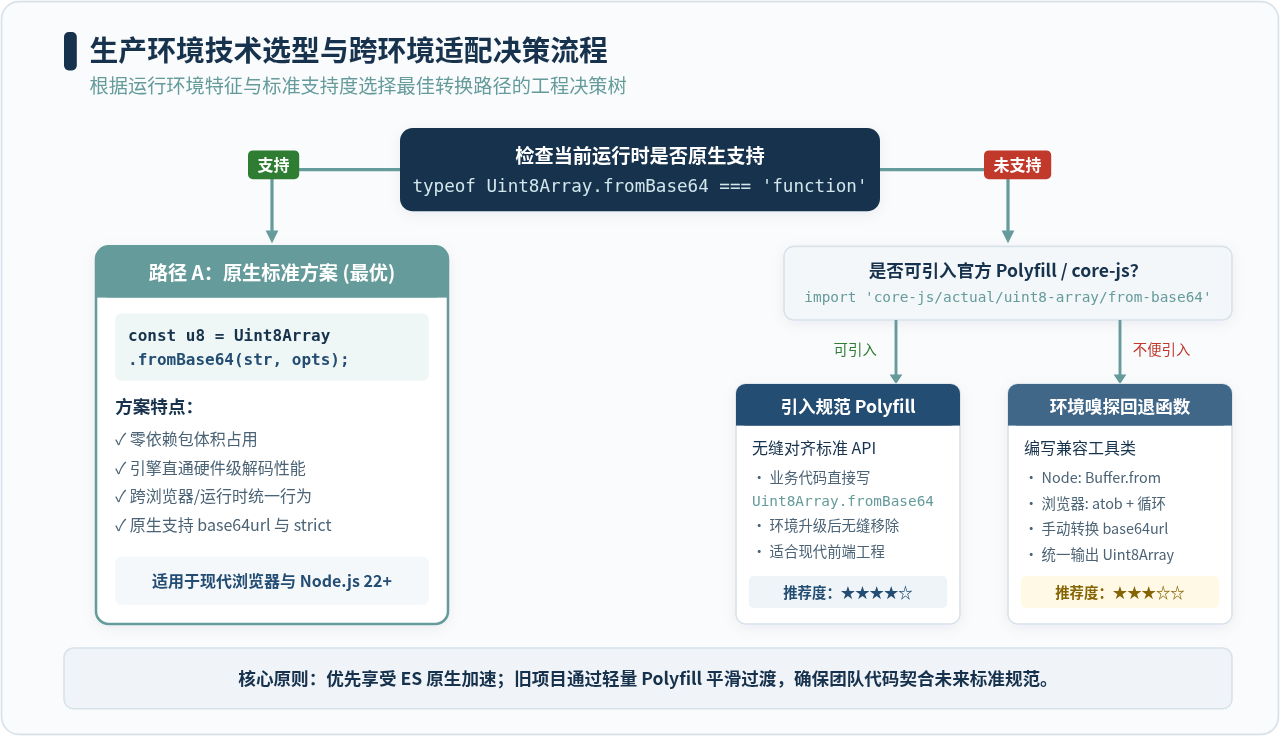
编写全环境兼容的万能解码工具函数
如果项目中暂时不便引入大型 Polyfill 库,可以编写如下独立的通用兼容函数。该函数优先使用原生 Uint8Array.fromBase64,若环境未就绪,则自动嗅探 Node.js 或浏览器环境并平滑回退:
/**
 * 通用 Base64 字符串转 Uint8Array 工具函数(兼容全运行环境)
 * @param {string} base64Str 待解码 Base64 文本
 * @param {object} [options] 配置选项
 * @returns {Uint8Array}
 */
function base64ToUint8Array(base64Str, options = {}) {
  // 1. 首选:原生标准 API(高性能、统一规范)
  if (typeof Uint8Array.fromBase64 === 'function') {
    return Uint8Array.fromBase64(base64Str, options);
  }

  // 规范化 base64url 字符集回退处理
  let normalized = base64Str;
  if (options.alphabet === 'base64url' || /[-_]/.test(normalized)) {
    normalized = normalized.replace(/-/g, '+').replace(/_/g, '/');
    while (normalized.length % 4) normalized += '=';
  }

  // 2. Node.js 环境回退:借助 Buffer
  if (typeof Buffer !== 'undefined') {
    const buf = Buffer.from(normalized, 'base64');
    return new Uint8Array(buf.buffer, buf.byteOffset, buf.byteLength);
  }

  // 3. 旧版浏览器环境回退:借助 atob + 内存拷贝
  if (typeof atob === 'function') {
    const binaryString = atob(normalized);
    const len = binaryString.length;
    const bytes = new Uint8Array(len);
    for (let i = 0; i < len; i++) {
      bytes[i] = binaryString.charCodeAt(i);
    }
    return bytes;
  }

  throw new Error("当前运行环境不支持 Base64 解码");
}
六、技术要点总结
Uint8Array.fromBase64 的标准化为 JavaScript 原生二进制操作补齐了至关重要的一块拼图。在日常项目开发中,建议牢记以下核心实践:
- 一步到位:直接使用
Uint8Array.fromBase64(str)即可获得标准的定型数组,如需常规数组操作,追加Array.from(u8)或[...u8]即可。 - 参数控制:遇到包含
-或_的 URL-Safe 编码时,务必配置{ alphabet: 'base64url' };安全敏感场景建议开启lastChunkHandling: 'strict'。 - 极致性能:在长周期循环或大规模网络数据解码场景下,优先结合
reusableBuffer.setFromBase64()复用内存,规避 GC 损耗。 - 工程演进:新项目建议通过
core-js或前向兼容垫片拥抱新 API,使团队代码风格全面契合 ECMAScript 最新规范。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章