
深入讲解JavaScript字符串转数组时乱码产生的原因,并使用ES2024规范新增的isWellFormed和toWellFormed方法检测与修复孤立代理码元,实现安全无痛的字符串数组化。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
js字符串转数组ES2024isWellFormed修复乱码
作者:半夏
时间:2026-11-13
浏览:198
文章目录
在 JavaScript 中将字符串拆解为字符数组时,直接使用
str.split('') 极易将占用双码元的 Emoji 表情或生僻字强行切断,造成形如 \uD83D 的代理乱码;即使改用扩展运算符 [...str],如果输入源本身由于网络截断或非标准编码残留了“孤立代理码元”,依然会在序列化与后续处理中引发异常。ES2024 正式引入了 String.prototype.isWellFormed() 与 String.prototype.toWellFormed() 两个原生实例方法,分别用于检测字符串是否存在畸变代理与自动将孤立代理修复为标准替换字符。结合这两者,我们可以在将字符串转为数组前完成字符良构性清洗,彻底杜绝转数组过程中的乱码与崩溃。
一、JS 字符串转数组的乱码陷阱与底层原理
要彻底理解转数组为什么会产生乱码,必须先回到 JavaScript 引擎底层的字符串存储机制。在 ECMAScript 规范中,JavaScript 字符串是由一系列 16 位整数构成的 UTF-16 码元(Code Units) 序列。
在 Unicode 字符集中,字符被划分为多个平面:
- 基本多语言平面(BMP,U+0000 到 U+FFFF): 包含了大多数国家的常用文字、拉丁字母与基础符号。这些字符每个恰好对应一个 16 位码元,字符串长度属性为 1。
- 补充平面(U+010000 到 U+10FFFF): 包含了绝大多数现代 Emoji 表情(如 😀、🎉)、历史生僻字(如“𠮷”)以及特殊的数学符号。因为 16 位无法直接容纳超过
0xFFFF的数值,UTF-16 规定使用两个连续的 16 位码元组成的代理对(Surrogate Pair)来共同表示一个字符。其中前一个码元位于0xD800 ~ 0xDBFF之间,称为高位代理(Leading Surrogate);后一个码元位于0xDC00 ~ 0xDFFF之间,称为低位代理(Trailing Surrogate)。
传统的 str.split('') 方法完全按照 UTF-16 码元切分。当它遇到一个 Emoji 代理对时,由于无法感知码点(Code Point)的完整语义,会无情地将高位代理与低位代理割裂成两个单独的数组元素:
const emoji = "😀"; // UTF-16 编码为 \uD83D\uDE00
console.log(emoji.length); // 输出: 2

const brokenArray = emoji.split("");
console.log(brokenArray);
// 示例输出: ['\uD83D', '\uDE00'] -> 此时每一个元素都成了没有配对的半边乱码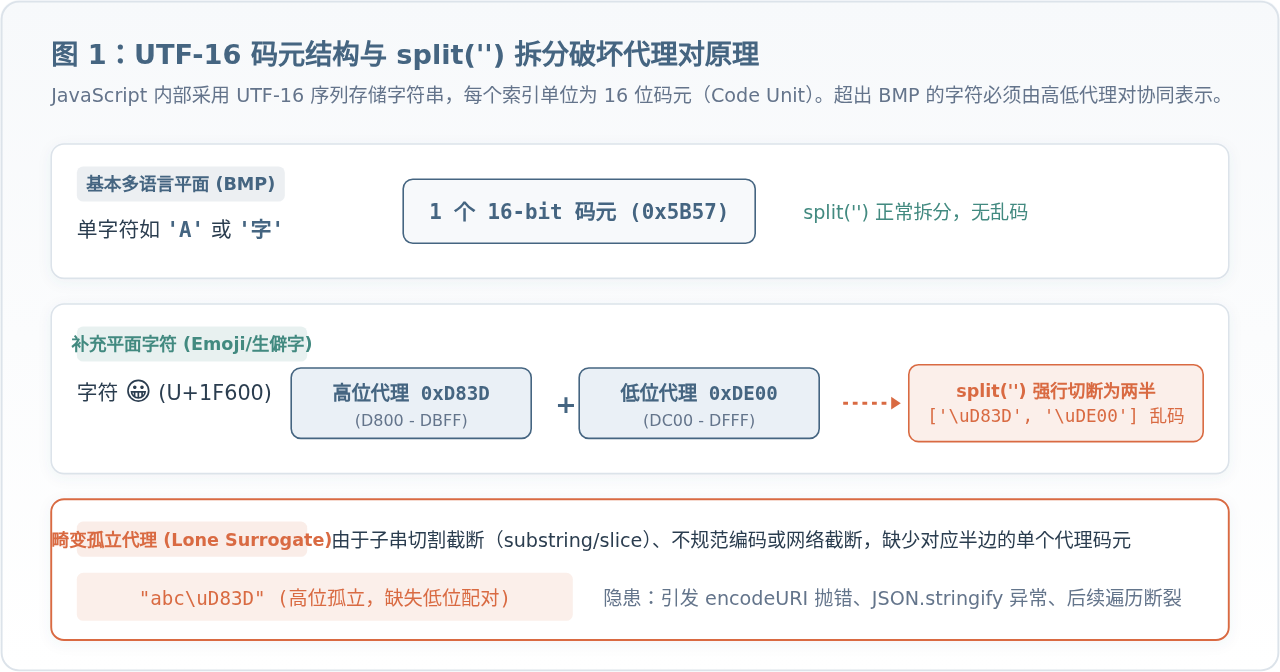
更危险的是孤立代理(Lone Surrogate)。当外部传入的字符串被不当截断(例如截取前 N 个字节/字符时刚好截在了代理对中间),或者二进制文件以错误的编码被反序列化时,字符串内部会留下单个没有配对的代理码元。这种畸变字符串不仅会在渲染时显示为不可识别的问号,而且如果在后续代码中传递给 encodeURI(),还会直接抛出未捕获的 URIError: URI malformed 崩溃。
二、ES2024 isWellFormed 与 toWellFormed 的工作机制
为了解决长期以来无法低成本甄别和纠正孤立代理的问题,ECMAScript 2024 规范正式将良构性检查纳入了 String.prototype。
1. String.prototype.isWellFormed()
该方法返回一个布尔值,用于高效判断当前字符串是否是良构的(Well-formed) UTF-16 字符串。如果字符串中不含任何孤立的高位或低位代理,则返回 true;一旦探测到任意一个未成对的代理码元,立即返回 false。
// 1. 正常字符串与成对代理
const validStr = "Hello 😀";
console.log(validStr.isWellFormed()); // 示例输出: true

// 2. 含孤立高位代理的畸变字符串
const loneHigh = "ab\uD83Dcd";
console.log(loneHigh.isWellFormed()); // 示例输出: false

// 3. 含孤立低位代理的畸变字符串
const loneLow = "ab\uDE00cd";
console.log(loneLow.isWellFormed()); // 示例输出: false
性能优势
在以往,开发者通常需要编写复杂的正则表达式(如 /(?:[^\uD800-\uDBFF]|^)[\uDC00-\uDFFF]|[\uD800-\uDBFF](?![\uDC00-\uDFFF])/)或者在 JS 层逐个码元遍历判断。原生 isWellFormed() 由 JavaScript 引擎直接在 C++ 底层循环扫描,耗时远低于正则匹配与用户层循环。
2. String.prototype.toWellFormed()
如果字符串被检测出存在孤立代理,toWellFormed() 能够以规范标准的方式自动完成修复。它会遍历字符串,并将每一个孤立的代理码元单独替换为 Unicode 官方定义的替换字符 \uFFFD(视觉上呈现为带问号的菱形图标 �)。如果字符串本身已经是良构的,它将原样返回字符串副本。
const dirtyStr = "A\uD83DB\uDE00C"; // 两个互不相邻的孤立代理

const cleanStr = dirtyStr.toWellFormed();
console.log(cleanStr);
// 示例输出: "A�B�C"

console.log(cleanStr.isWellFormed());
// 示例输出: true (经过修复后已具备完备的良构性)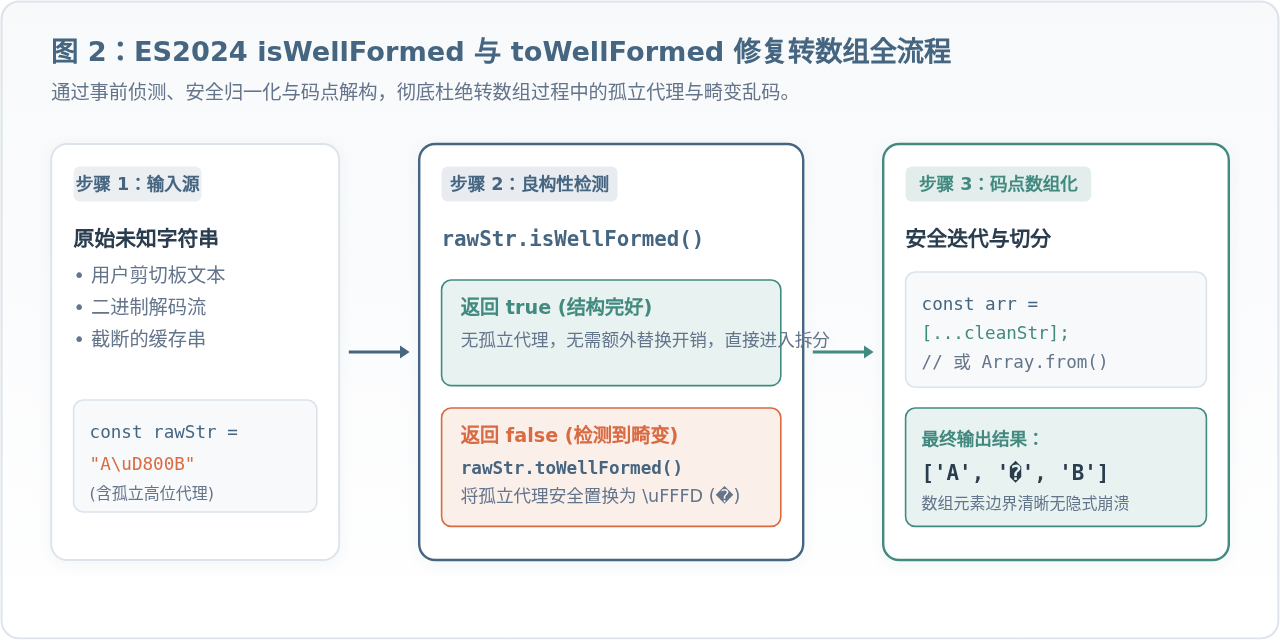
三、安全将字符串转为数组的操作步骤与实践
在明确了底层机制后,我们可以将“字符串转数组”的工程实践总结为标准的三步操作路径。
步骤一:先对输入源进行清洗保障良构性
对于来自不可信环境(如接口请求报文、URL SearchParams、用户粘贴文本、文件上传切片)的字符串,务必先通过 toWellFormed() 进行归一化。即使原字符串存在孤立代理,也会被安全转换为 \uFFFD,防止后续迭代器在边界处失真。
步骤二:选用码点级迭代方案转为数组
放弃 split(''),采用具备 Unicode 码点识别能力的语法结构:
- 扩展运算符:
[...cleanStr] - Array.from:
Array.from(cleanStr)
这两个特性均基于 ECMAScript 的字符串迭代协议(String.prototype[Symbol.iterator]),它们在遇到成对的 \uD83D\uDE00 时,会自动将其合并为一个完整的码点输出到数组元素中。
function stringToCharArray(input) {
  if (typeof input !== "string") {
    throw new TypeError("参数必须为字符串");
  }
  // 1. 利用 ES2024 toWellFormed() 纠偏潜在乱码
  const safeStr = input.toWellFormed();

  // 2. 使用扩展运算符按完整码点拆解为数组
  return [...safeStr];
}

// 测试验证
const rawInput = "Hi 😊\uD800字";
const result = stringToCharArray(rawInput);
console.log(result);
// 示例输出: ['H', 'i', ' ', '😊', '�', '字']
// 结果分析:Emoji 被完整保留为一个数组项,孤立的高位代理被安全替换为 '�',汉字正常呈现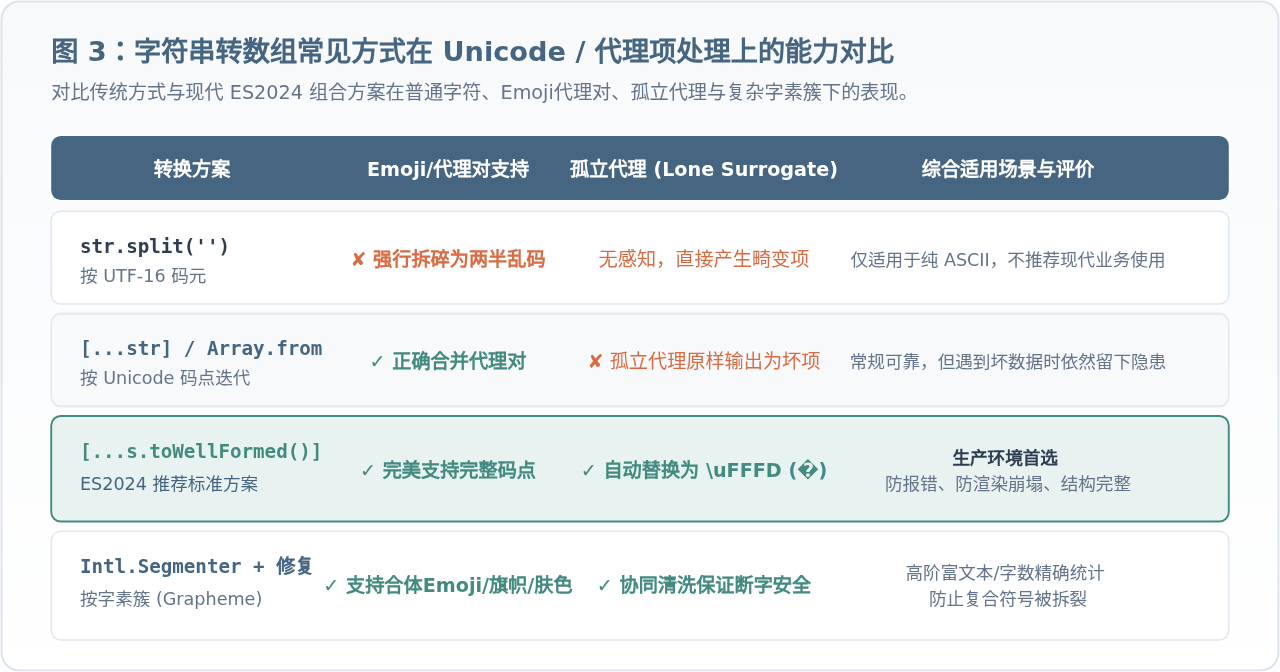
步骤三:针对复杂字素簇(Emoji 组合序列)的进阶增强
需要特别说明的是,扩展运算符 [...str] 是按单码点(Code Point)进行拆分的。在现代表情符号中,存在由零宽连字(ZWJ,\u200D)连接起来的复合 Emoji(字素簇 Grapheme Cluster),例如家庭表情 👨👩👧👦 或带有肤色修饰符的表情 👍🏽。
如果业务场景要求这类复合 Emoji 在视觉上也必须作为一个整体单元出现在数组中,应当在 toWellFormed() 清洗后,配合现代浏览器的 Intl.Segmenter 进行字素级拆分:
function stringToGraphemeArray(input) {
// 确保输入良构
const safeStr = input.toWellFormed();
// 利用 Intl.Segmenter 按字素簇分割
const segmenter = new Intl.Segmenter("zh-CN", { granularity: "grapheme" });
const segments = segmenter.segment(safeStr);
return Array.from(segments, item => item.segment);
}
const complexEmoji = "👨👩👧👦\uD83D好";
console.log(stringToGraphemeArray(complexEmoji));
// 示例输出: ['👨👩👧👦', '�', '好']
// 复合表情不被拆碎,孤立代理依然被规范修复四、环境支持度与向前兼容 Polyfill
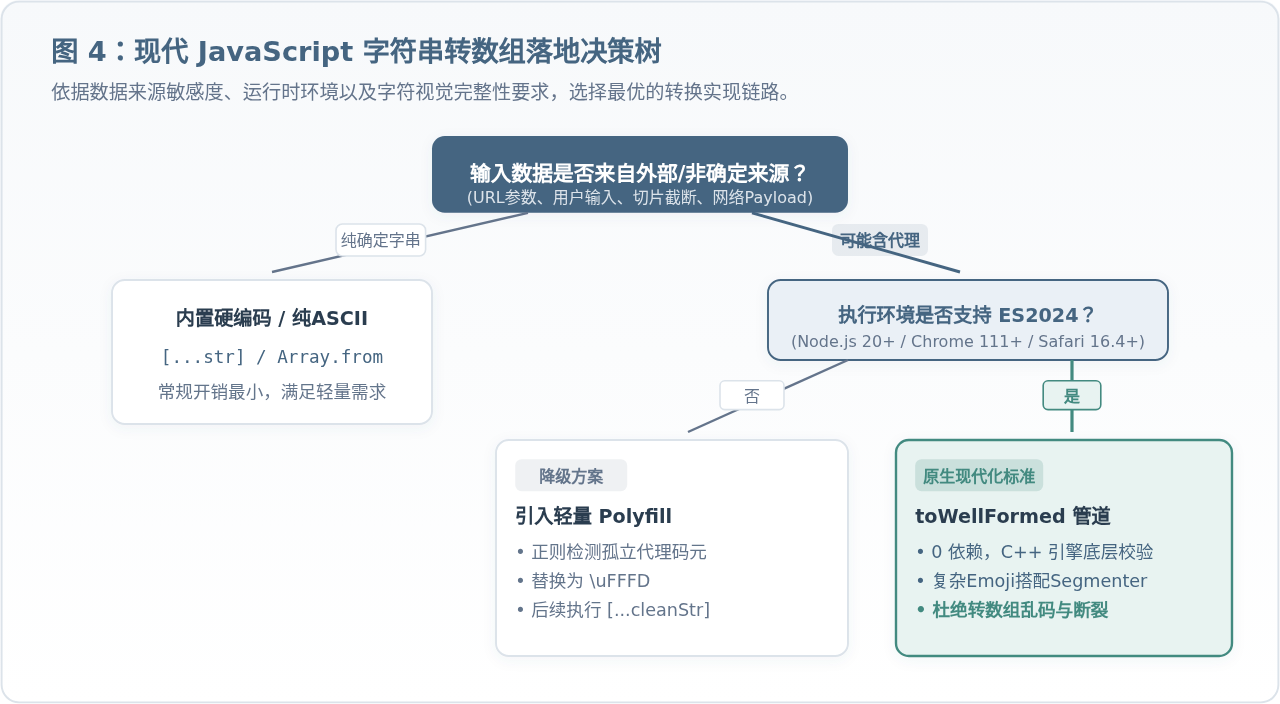
作为 ECMAScript 2024 的正式标准,主流前端运行时对 isWellFormed 和 toWellFormed 的支持情况非常迅速且广泛:
- Node.js: 从 v20.0.0 开始原生支持。
- Chrome / Edge: 从版本 111 起原生支持。
- Safari: 从 macOS/iOS 16.4 起原生支持。
- Firefox: 从版本 119 起原生支持。
若项目需要运行在较旧的 Node.js LTS 版本(如 Node 16/18)或老旧移动端 WebView 中,可以利用如下轻量 Polyfill 提供无缝降级支持:
// Polyfill: isWellFormed 与 toWellFormed
if (!String.prototype.isWellFormed) {
  String.prototype.isWellFormed = function () {
    const str = String(this);
    // 孤立代理正则检测
    const loneSurrogateRegex =
      /(?:[^\uD800-\uDBFF]|^)[\uDC00-\uDFFF]|[\uD800-\uDBFF](?![\uDC00-\uDFFF])/;
    return !loneSurrogateRegex.test(str);
  };
}

if (!String.prototype.toWellFormed) {
  String.prototype.toWellFormed = function () {
    const str = String(this);
    const loneSurrogateGlobalRegex =
      /(?:[^\uD800-\uDBFF]|^)[\uDC00-\uDFFF]|[\uD800-\uDBFF](?![\uDC00-\uDFFF])/g;

    return str.replace(loneSurrogateGlobalRegex, match => {
      // 若匹配项包含前导合法字符,保留该前导字符并将孤立代理部分替换为 \uFFFD
      if (match.length === 2) {
        return match[0] + "\uFFFD";
      }
      return "\uFFFD";
    });
  };
}
五、关键总结与开发建议
| 开发环节 | 推荐做法 | 需规避的反模式 |
|---|---|---|
| 预检判断 | 在数据入库、序列化、转码前使用 str.isWellFormed() 校验合法性 |
盲目直接调用 encodeURI() 导致线上抛出 URIError 崩溃 |
| 转数组前清洗 | 对不可信外部文本优先使用 str.toWellFormed() 归一化 |
直接操作含有单边 \uD800 的畸变字符串 |
| 拆分为字符项 | 采用 [...cleanStr] 或 Array.from(cleanStr) |
沿用 str.split('') 拆分 UTF-16 码元 |
| Emoji 与复杂文本 | 复合连字表情配合 Intl.Segmenter 按字素簇分割 |
将连字表情强行拆成零宽字符与多段碎片 |
将字符串转换为数组在前端日常业务(如逐字打字机动画、文本截断省略、敏感词过滤、字数限制统计)中极其常见。理解 UTF-16 代理对机制,并借助 ES2024 的 isWellFormed() 与 toWellFormed() 将乱码防御前置,是保障前端现代应用健壮性的必备技巧。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章