
深入解析在 JavaScript 中利用 ECMAScript 2025 Iterator Helpers 实现字符串转数组的高性能方案。通过 Iterator.from、惰性链式调用与终结方法 toArray,彻底规避传统 split 与 map、filter 产生的成倍中间数组与 GC 停顿。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
js字符串转数组避免中间数组IteratorES2025
作者:半夏
时间:2026-11-13
浏览:548
文章目录
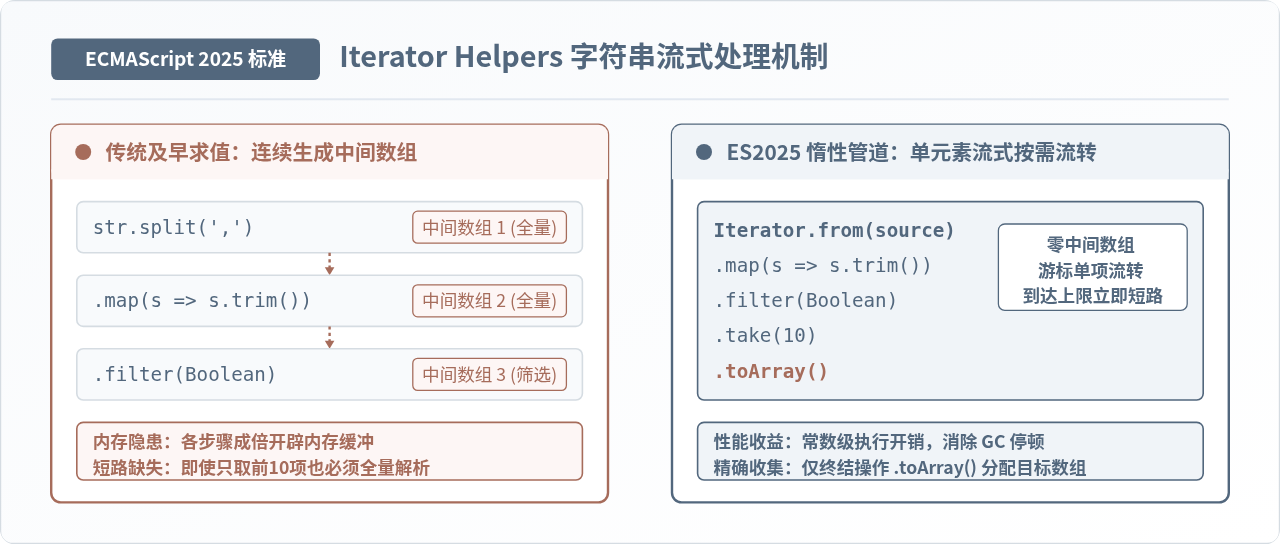
在 JavaScript 开发中,将一段文本解析、过滤并最终转化为特定格式的数组是极高频的操作。长久以来,开发者习惯使用 str.split(',').map(...).filter(...).slice(...) 这种经典的数组链式写法。然而,这种写法的核心缺陷是及早求值(Eager Evaluation):链条上的每一个环节都会在堆内存中立即分配一个完整的全新数组。当面对体积可观的日志流、CSV 数据或几十万项的长字符串时,这种级联产生的“中间数组”不仅造成内存峰值数倍飙升,还会频繁触发 V8 引擎的主垃圾回收(Major GC),引起明显的页面掉帧甚至服务停顿。随着 ECMAScript 2025(ES2025) 正式将 Iterator Helpers 纳入国际标准,我们终于拥有了原生级别的惰性流式计算能力:利用 Iterator.from() 接入字符串或正则迭代器,搭配 .map()、.filter() 与 .take() 实现单项游标驱动,并在终结时刻调用 .toArray() 一次性收敛结果,彻底消除了所有中间数组。
一、传统方法为什么会产生不可忽视的“中间数组”
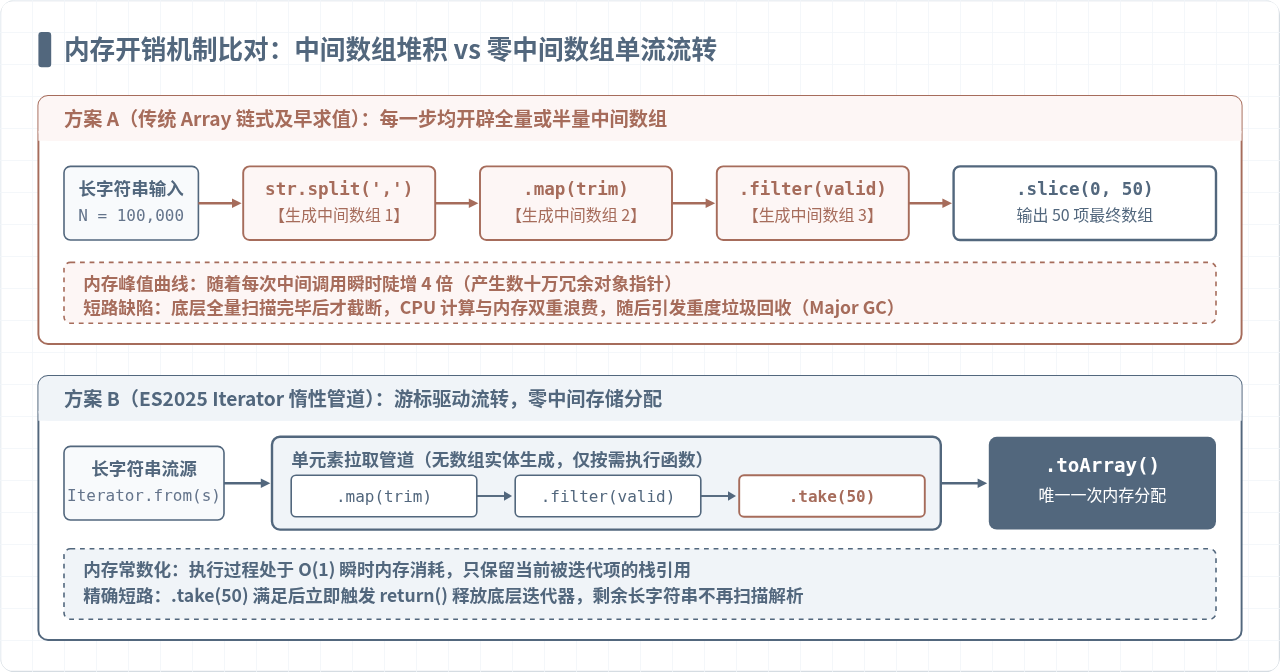
要理解 ES2025 迭代器助手的价值,首先需要看清传统数组转换链条在 V8 引擎内部的实际内存走向。考虑一个常见任务:从一段由逗号隔开的大字符串中,提取出前 10 个去除首尾空格后的非空元素。
// 传统经典写法:多重中间数组堆叠
const rawText = "item_1, item_2, , item_3, ... (包含100,000个子项的大文本)";

const result = rawText
  .split(',')            // ① 立即创建并分配大小为 100,000 的临时数组
  .map(s => s.trim())     // ② 再次在堆中分配第 2 个大小为 100,000 的映射数组
  .filter(Boolean)        // ③ 再次在堆中分配第 3 个大小约为 90,000 的过滤数组
  .slice(0, 10);          // ④ 最后才提取前 10 项,丢弃前面所有中间数组
这段代码在逻辑上毫无问题,但在运行时体系中存在两处致命隐患:
-
乘数级的堆内存分配:
rawText.split(',')会立即将整段字符串全量扫描并切分为 100,000 个独立的子字符串对象,并将其指针封装进第一个数组;随后的.map()和.filter()又在堆中申请第二块、第三块连续的数组内存空间。即使原始字符串只有 5MB,这一连串操作可能瞬间产生数十兆字节的短暂内存毛刺。 -
完全丧失“提前短路(Early Termination)”能力:尽管业务最终只需要前 10 项,但
split()、map()与filter()不具备反向感知能力,必须将后方 99,990 项全部计算并存入中间数组后,最后的slice(0, 10)才会接盘。前序环节消耗的所有 CPU 时间和内存空间几乎全部被白白抛弃,随后引发垃圾回收器的大力清扫。
二、ES2025 Iterator Helpers 核心机制与字符串接入
在 ECMAScript 2025 之前,JavaScript 原生已经存在可迭代协议(Iterable Protocol)与迭代器协议(Iterator Protocol),例如 String.prototype[Symbol.iterator]() 和生成器 function*。但原生的迭代器只提供了基础的 .next() 接口,缺少类似数组的 map、filter 辅助操作。如果要把迭代器处理完的数据收集为数组,往往只能写笨重的 for...of 循环,或者使用展开运算符 [...iterator],而展开操作依然是一次性及早求值。
ES2025 正式完善了全局 Iterator 原型链,为原生迭代器引入了一套完整的“惰性中间操作(Intermediate Operations)”与“终结操作(Terminal Operations)”。其核心设计遵循拉取驱动(Pull-based Streaming)模型:
| 方法名称 | 方法类型 | 计算时机 | 内存与返回值特征 |
|---|---|---|---|
Iterator.from(source) |
静态适配器 | 立即执行包装 | 接收可迭代对象或迭代器,返回 Iterator 助手实例,零元素计算 |
.map(mapperFn) |
惰性中间操作 | 下游消费时触发 | 返回包装迭代器,单元素通过时映射,不生成中间数组 |
.filter(predicate) |
惰性中间操作 | 下游消费时触发 | 返回包装迭代器,跳过不符合条件的项,不生成中间数组 |
.take(limit) |
惰性截断操作 | 下游消费时计数 | 达到阈值立即向底层发出 return(),实现原生短路提前终止 |
.drop(limit) |
惰性跳过操作 | 下游消费时计数 | 跳过前 N 项元素,无内存分配 |
.flatMap(mapperFn) |
惰性展开操作 | 下游消费时展平 | 惰性消费子迭代器,避免嵌套数组分配 |
.toArray() |
终结消费操作 | 立即启动拉取循环 | 驱动整条流水线逐项执行 next(),唯一定量分配最终数组 |
1. 字符串原生迭代器的字符级流式转换
在 JavaScript 中,字符串本身就是原生可迭代对象(实现了 Symbol.iterator)。字符串的原生迭代器具备一个极其关键的语言特性:它是按 Unicode 码点(Code Point)进行迭代的。传统 str.split('') 会粗暴按 UTF-16 码元拆分,遇到 Emoji 或生僻字会导致代理对被拆散成乱码;而 Iterator.from(str) 既安全又完全没有中间数组:
// 场景:从包含 Emoji 与多国语言的长文本中过滤出前 5 个有效字符数组
const text = "🌟 A_1 🚀 B_2 🎯 C_3 ... (大字符串)";

// ES2025 规范:单步驱动,无中间数组
const cleanChars = Iterator.from(text)
  .filter(char => char.trim().length > 0) // 惰性过滤空格,不生成任何数组
  .map(char => char.toLowerCase())        // 惰性转换字符
  .take(5)                                // 取满 5 个即刻终止遍历
  .toArray();                             // 终结操作:单次分配大小为 5 的数组

console.log(cleanChars);
// 示例输出: [ "🌟", "a", "_", "1", "🚀" ]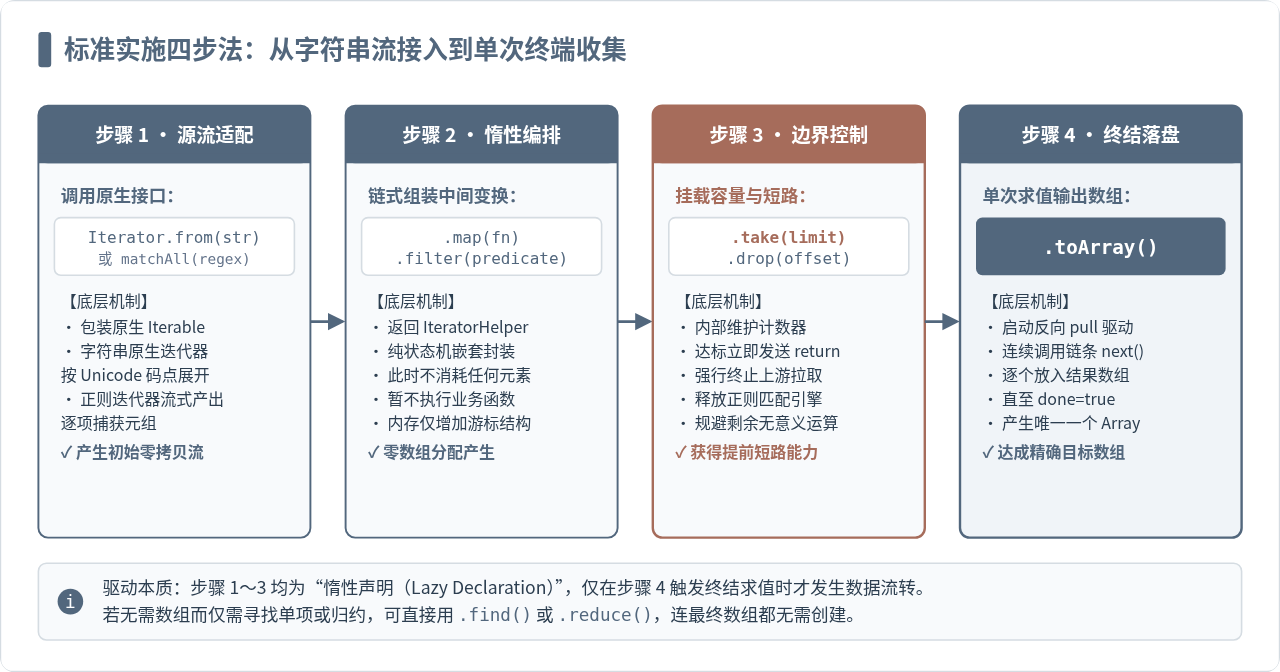
三、实战进阶:彻底规避 split() 内存风暴的两种流式解析模式
在实际工程中,绝大多数“字符串转数组”并非简单的逐字拆解,而是带有特定定界符(如逗号、制表符、竖线)或结构化规则(如键值对、日志格式)。很多开发者即使使用了 ES2025,仍然会在第一步下意识写出 Iterator.from(str.split(','))——这相当于在一开始依然全量制造了最庞大的那个中间数组,后续的惰性链条就失去了大部分内存意义。
为了从根源上消灭这个初始的 split 数组,我们可以使用以下两种流式解析模式。
模式一:基于 RegExp.prototype.matchAll() 的正则惰性分词
JavaScript 的 str.matchAll(/.../g) 原生返回一个 RegExpStringIterator(正则字符串迭代器)。该迭代器内部维护着正则引擎的 lastIndex 游标指针,只有在被外部调用 .next() 时,才会向前扫描并产出下一个匹配结果,期间绝不会对整个字符串进行全量预先切割。
将 str.matchAll() 接入 Iterator.from(),是处理定界符文本或结构化日志时性能最高、语义最精炼的工业级方案:
/**
 * 需求:从体积可能高达 50MB 的 CSV 单行或逗号字符串中提取前 20 个非空大写标识符
 * 传统做法:str.split(',').map(...).filter(...).slice(0, 20) -> 内存瞬间暴增
 * ES2025 方案:matchAll 游标扫描 + Iterator Helpers 管道
 */
function extractTopTokens(largeText, limit = 20) {
  // 正则表达式匹配非逗号且非空白的连续有效字符
  const tokenRegex = /[^,
	 ]+/g;

  // matchAll 产生原生迭代器,Iterator.from 赋予其 ES2025 辅助方法
  return Iterator.from(largeText.matchAll(tokenRegex))
    .map(match => match[0])                      // 提取捕获到的字符串 token
    .map(token => token.toUpperCase())           // 惰性格式规整
    .filter(token => !token.startsWith("DEBUG")) // 惰性滤除调试标识
    .take(limit)                                 // 找到所需数量后立即强行截断
    .toArray();                                  // 唯一一次数组分配
}

// 示例调用
const sample = "prod_srv1, debug_02, prod_srv2, test_api, prod_cache, ... (100万行文本)";
const activeServers = extractTopTokens(sample, 2);
console.log(activeServers);
// 示例输出: [ "PROD_SRV1", "PROD_SRV2" ]
// 注意:在获取到前 2 个符合条件的元素后,底层正则匹配器立即停止运行,后续文本根本不会被读取!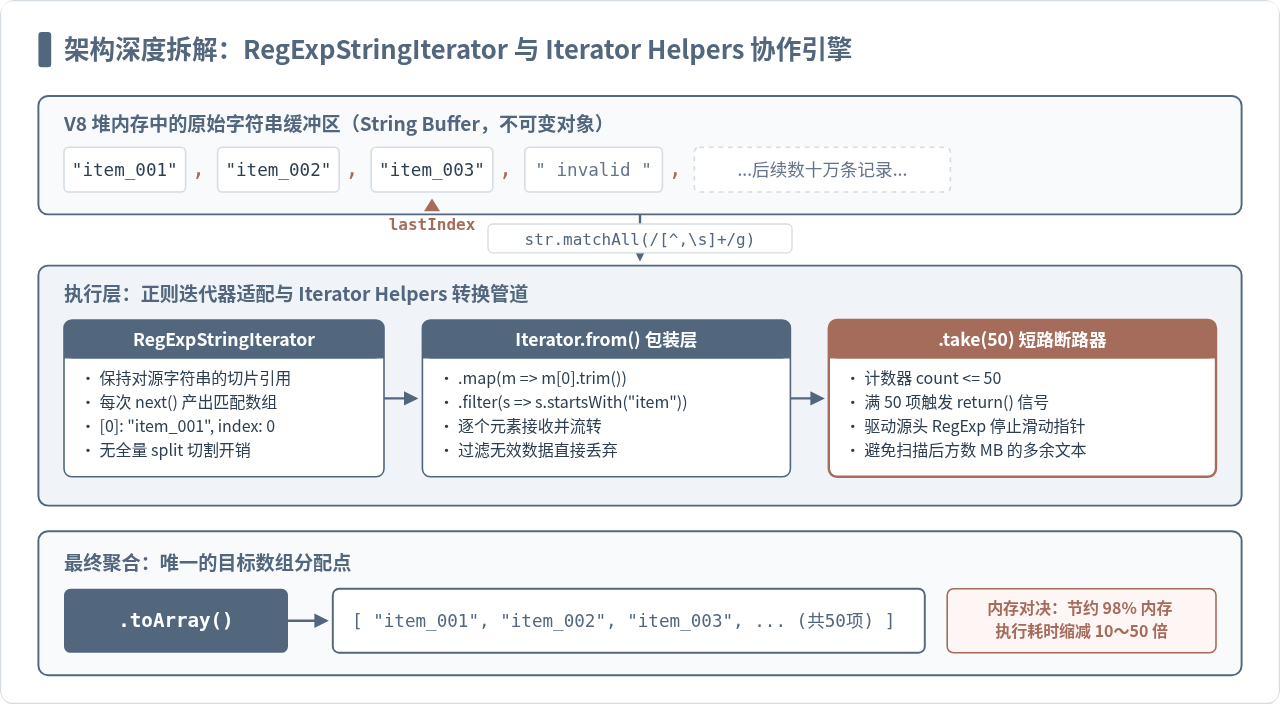
模式二:基于 Generator 的零拷贝字符扫描器
如果定界符不仅是单一字符,或者存在复杂的转义引号规则,使用正则表达式可能难以精确兼顾状态机。此时可以手写一个微型的生成器函数(Generator)。由于生成器函数天生返回迭代器,它可以与 ES2025 的 Iterator.from() 做到无缝对接:
// 零中间数组的惰性定界符扫描生成器
function* lazySplit(str, delimiter = ',') {
  let start = 0;
  let delimIndex = str.indexOf(delimiter, start);

  while (delimIndex !== -1) {
    // 仅在外部调用 next() 时才截取当前这个片段产出
    yield str.slice(start, delimIndex);
    start = delimIndex + delimiter.length;
    delimIndex = str.indexOf(delimiter, start);
  }

  // 产出末尾剩余片段
  if (start < str.length) {
    yield str.slice(start);
  }
}

// 组装进 ES2025 流水线
const csvLine = "order101|paid|299.00|order102|refund|15.00|order103|pending|50.00";

const paidOrders = Iterator.from(lazySplit(csvLine, '|'))
  .filter(token => token.startsWith("order"))
  .take(2)
  .toArray();

console.log(paidOrders);
// 示例输出: [ "order101", "order102" ]
四、避坑指南与生产环境注意事项
注意事项一:迭代器的单次消耗性(One-shot Consumption)
数组是常驻内存的容器,可以随时多次读取 arr[0] 或调用多次 arr.map(...);但 Iterator 本质是一个有状态的动态游标指针。一旦执行过一次 .toArray() 或遍历完成,该迭代器即被耗尽(done: true)。若后续业务需要再次遍历同一批数据,不能复用已完成的迭代器变量,必须重新获取源迭代器。
注意事项二:与异步流(Async Iterator)的边界区分
ES2025 标准的 Iterator Helpers 针对的是同步迭代器。如果你的大字符串来源于 Node.js 的 fs.createReadStream 或 Fetch API 的 response.body,数据是以异步数据块(Chunks)到达的。对于这种异步流,应当使用 for await (const chunk of stream),或者引入 AsyncIterator Helpers(该规范处于单独的推进通道)。切勿混淆同步与异步流水线。
注意事项三:运行环境版本与 Polyfill 策略
Iterator Helpers 已在 ECMAScript 2025 正式确立,现代主流运行环境已全线原生支持:
- Node.js 22.0.0+(全功能原生启用)
- Chrome / Edge 122+ / V8 12.2+
- Safari 18+ / WebKit
- Firefox 131+
如果项目仍需运行在旧版本浏览器或老旧 Node.js LTS 环境(如 Node 18/20),只需安装工业级垫片 core-js,并在入口文件顶部引入:
// 在构建工具或入口引入垫片
import "core-js/actual/iterator";
引入后即可全局无缝使用 Iterator.from() 及原型链辅助方法。
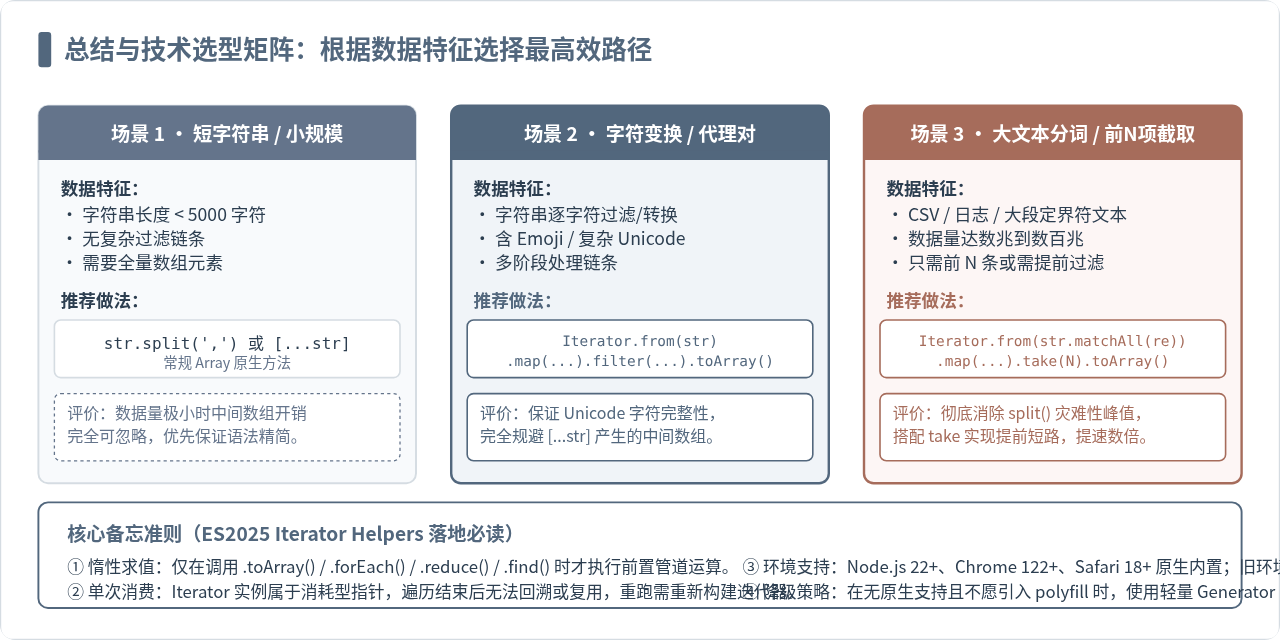
五、总结
将字符串转换为数组在 JavaScript 编程中俯拾皆是,但在大文本、高并发日志解析或性能敏感场景下,传统的 split() 级联不仅是一场“内存分配灾难”,还剥夺了系统提前短路的可能。
ECMAScript 2025 带来的 Iterator Helpers 补齐了 JavaScript 标准库中最后一块关键拼图:
-
接入标准流:优先利用
str.matchAll()或原生字符串迭代器,配合Iterator.from(source)获得零内存代价的输入游标。 -
声明式惰性组装:在消费前自由连接
.map()、.filter()、.drop()等操作,整个流水线处于纯状态机等待阶段,不产生任何中间数组。 -
早停与唯一分配:合理插入
.take(limit)实现按需解析,并在终点调用.toArray()完成单次目标数组构建。如果仅仅需要判定是否存在或单项匹配,直接使用.some()或.find()甚至可以达成“整条流程零数组分配”的极致性能。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章