
深入解析JavaScript中通过取模生成随机整数时引发的Modulo Bias(取模偏差)数学根源,提供标准的拒绝采样法、Lemire快速乘法算法以及Node.js/浏览器原生API的完整修正实现与验证方案。

当前位置:首页 > JavaScript 基础 > 正文
JS随机数取模偏差分析及修正方法
作者:青柠
时间:2026-11-06
浏览:265
文章目录
密码学与算法安全
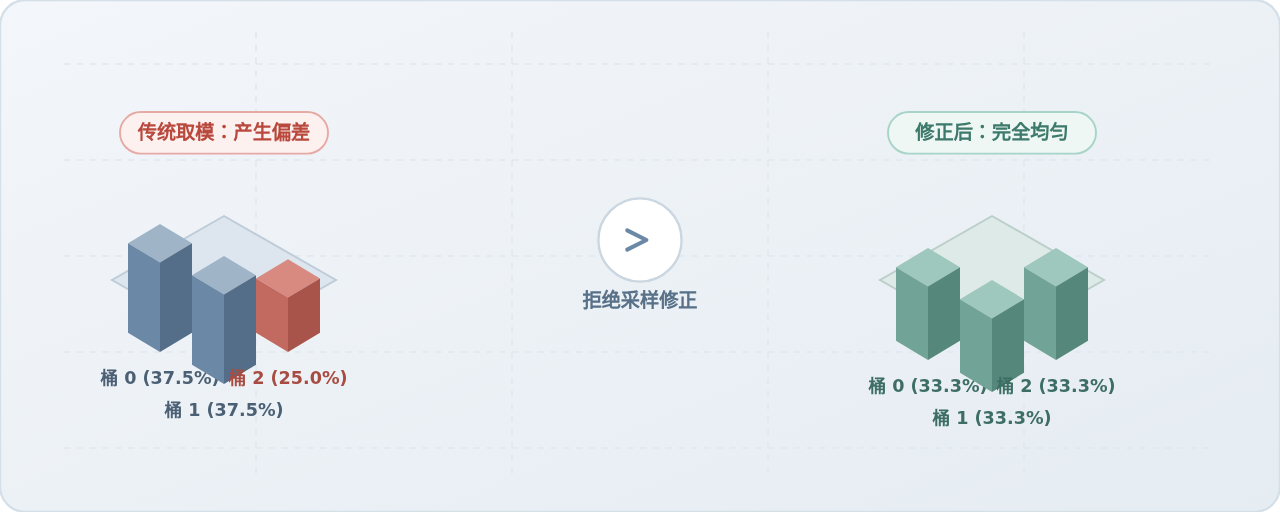
图 0:取模偏差的产生与均衡修正对比概念图
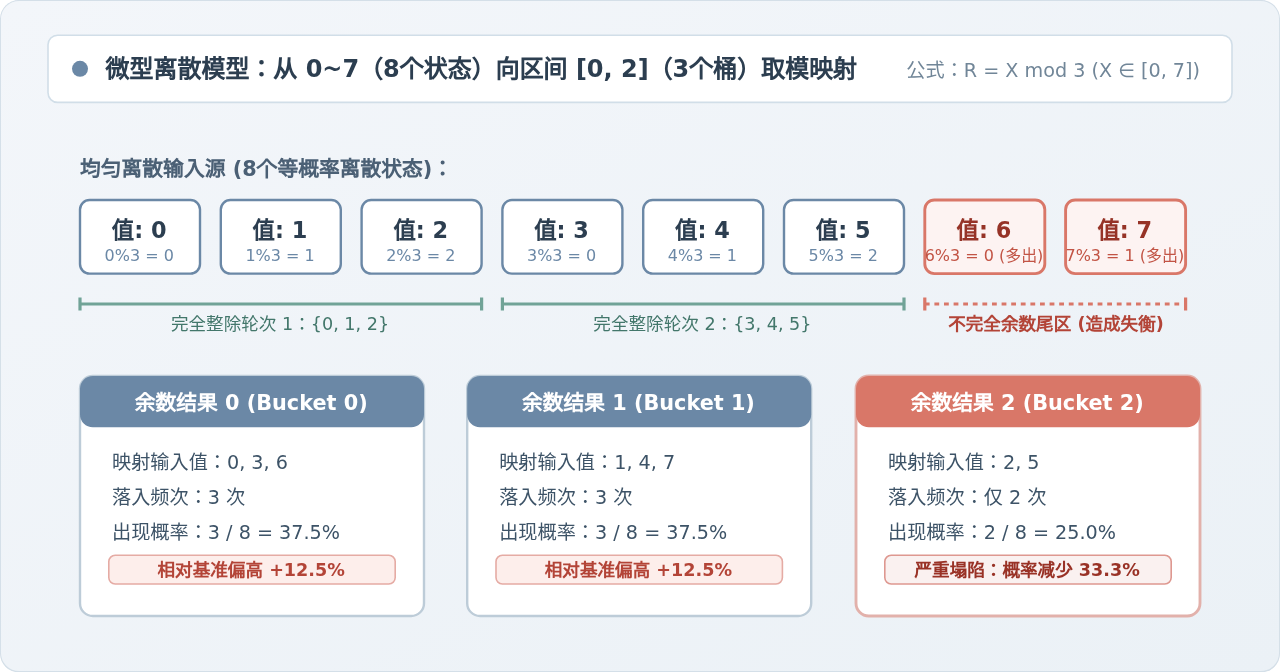
图 1:微型离散模型中的空间映射与桶失衡分布
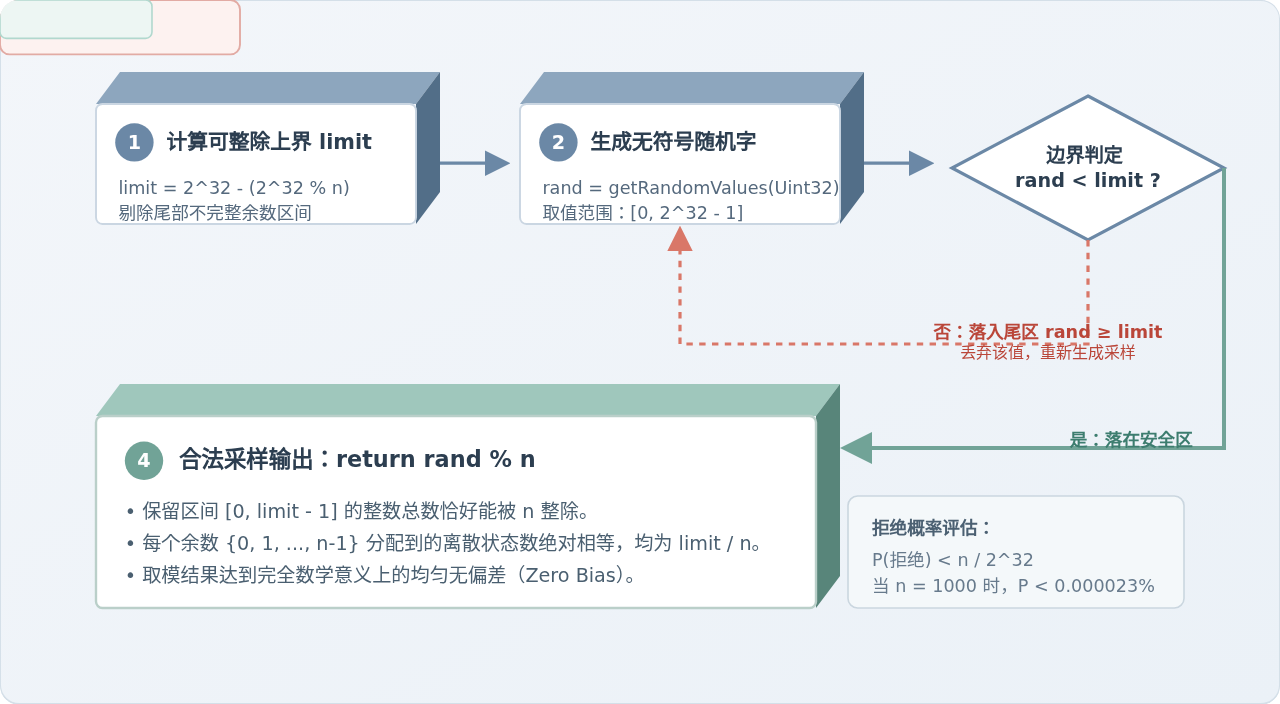
图 2:拒绝采样法状态流转与过滤逻辑
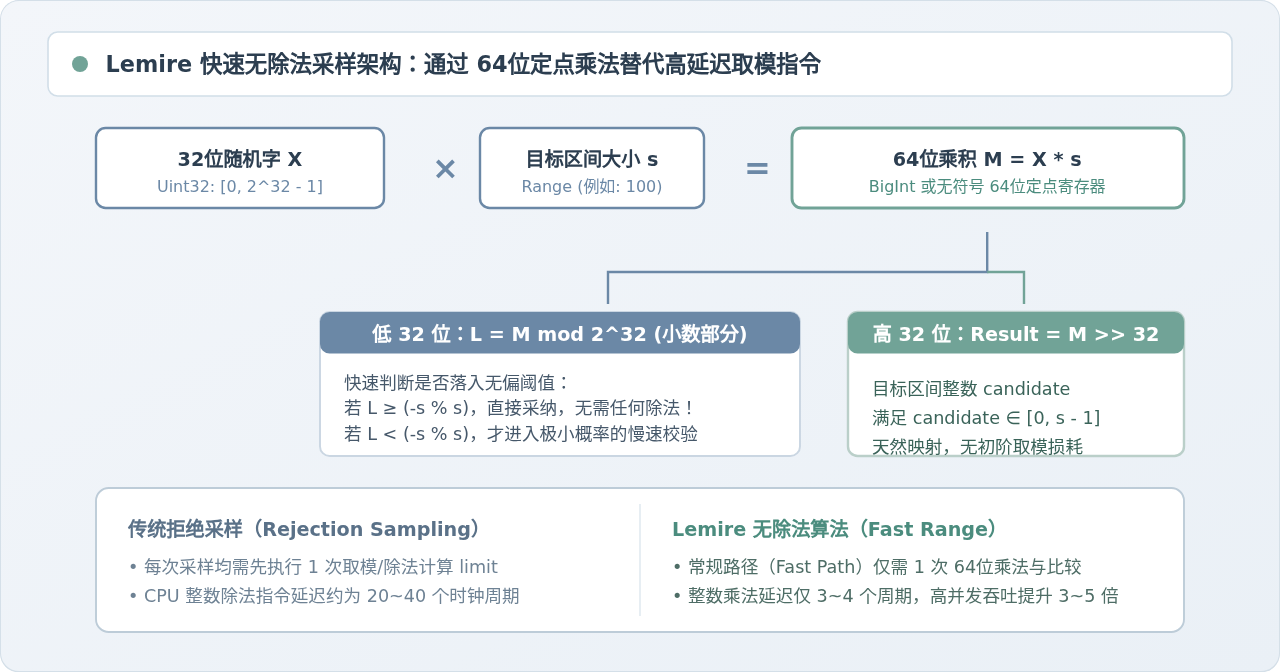
图 3:Lemire 无除法乘法缩放与快速过滤结构示意图
1. Node.js 环境:优先选用
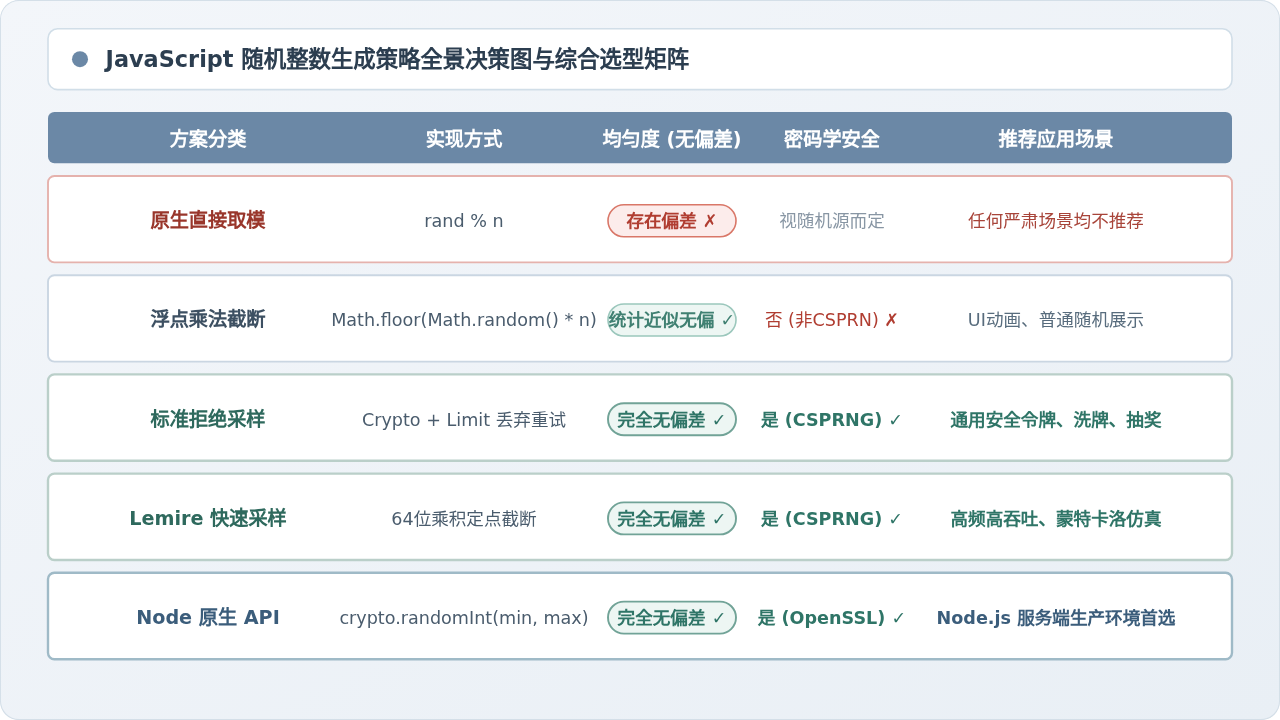
图 4:JavaScript 各类随机数生成方案综合选型矩阵
在 JavaScript 中,当开发者需要生成范围在
[0, n-1] 的随机整数时,常会直观地调用无符号随机源并直接取模 rand % n。然而,当输入随机源的状态总数无法被 n 整除时,靠前的余数将获得额外的命中机会,产生取模偏差(Modulo Bias)。本文直接剖析取模偏差的数学本质及其在抽奖、洗牌与密钥生成等场景下的潜在安全隐患,并提供标准的拒绝采样法、面向高并发的 Lemire 乘法算法与原生 API 的完整工程实现。
一、取模偏差的直观模型与产生机理
为了直观理解取模偏差,先排除复杂的 32 位大数,建立一个微型数学模型:假设有一个完全理想的随机数发生器,每次等概率输出 3 位二进制无符号整数,其离散状态空间为 [0, 7],共计 8 种可能。
如果业务目标是生成 0、1、2 这 3 个数字之一(即 n = 3),并采用直接取模的方式 val % 3,映射关系如下:
- 数值
0, 3, 6映射为余数0(共 3 次机会) - 数值
1, 4, 7映射为余数1(共 3 次机会) - 数值
2, 5映射为余数2(仅 2 次机会)
此时各个输出值的概率分布为:P(0) = 3/8 = 37.5%,P(1) = 3/8 = 37.5%,而 P(2) = 2/8 = 25.0%。结果显示,数字 0 和 1 的出现概率比数字 2 高出了整整 50%。这就是典型的取模偏差。
如图 1 所示,偏差的本质在于:状态空间总量(8)不能被目标区间大小(3)整除。整数商为 2,余数为 2。前两轮循环 [0, 2] 和 [3, 5] 能够均匀填满 3 个桶,而多出来的尾部区间 [6, 7] 只能分配给前两个桶,造成了严重的概率倾斜。
二、JavaScript 真实场景下的偏差量化与危害
在实际的前端或 Node.js 开发中,开发者通常借助 Web Crypto API 的 crypto.getRandomValues() 获取密码学安全的无符号 32 位整数(Uint32Array),其离散状态空间为:
M = 2^32 = 4,294,967,296 // [0 到 4294967295]如果直接写出以下代码:
// 存在取模偏差的不安全写法
function getUnsafeRandomInt(n) {
  const array = new Uint32Array(1);
  crypto.getRandomValues(array);
  return array[0] % n;
}
1. 偏差量的数学公式
对于任意目标区间 n,令 k = M mod n。
- 余数在
[0, k - 1]范围内的数值,命中次数为floor(M / n) + 1。 - 余数在
[k, n - 1]范围内的数值,命中次数仅为floor(M / n)。
2. 现实场景下的潜在风险
风险警示:
- 随机洗牌(Fisher-Yates Shuffle): 在扑克或洗牌算法中,每一步都需要从递减的区间
[0, remaining - 1]中选择索引。若每一步都存在取模偏差,整副牌的特定排列出现的概率将显著高于其他排列,在竞技游戏或线上棋牌中会导致致命的作弊或漏洞。 - 令牌与验证码生成: 常用字符集(如 Base62:数字+大小写字母,
n = 62),2^32 mod 62 = 4。若开发人员错误地使用Uint8Array(仅 256 种状态),256 mod 62 = 8,前 8 个字符的出现概率为5/256 ≈ 1.95%,而其余字符仅为4/256 ≈ 1.56%,相对偏差高达 25%! - 高并发抽奖与分桶服务: 在千万级抽奖请求中,微小的偏差会被流量成倍放大,导致特定奖项过早耗尽或特定用户群中奖率异常。
三、核心修正方法一:拒绝采样法(Rejection Sampling)
消除取模偏差最经典、最严谨的方法是拒绝采样法。其核心逻辑非常纯粹:既然偏差是由末尾无法凑齐完整周期的“残余区间”引起的,那么只要在随机数落入该残余区间时直接将其丢弃并重新抽取,即可彻底消除偏差。
1. 安全截断边界的确定
对于 32 位无符号整数,能够被 n 完整整除的最大边界值 limit 满足:
limit = 2^32 - (2^32 % n)
落入 [0, limit - 1] 内的任意数值,取模 n 后的每个余数出现的次数完全一致(均为 limit / n 次)。一旦生成的随机数 rand >= limit,则判定为落入尾区,触发重抽。
2. 拒绝概率与性能损耗分析
许多开发者担心重新采样会导致程序性能下降甚至陷入死循环。实际上这种担忧在数学上是不成立的:
- 被丢弃的尾区长度严格小于
n,因此单次采样的拒绝概率为P(reject) = (2^32 % n) / 2^32 < n / 2^32。 - 在通常场景下,若
n = 1,000,000(一百万),拒绝概率也仅为0.023%。平均采样次数为1 / (1 - P) ≈ 1.00000023次。 - 重试次数服从几何分布,连续发生多次拒绝的概率呈指数级坍缩,理论与工程上均不存在性能瓶颈。
3. 严谨的 JavaScript 生产级实现
在 JS 中编写无符号 32 位整数运算时,必须注意 JS 位运算默认将数值当作有符号 32 位整数处理的特性,需使用无符号右移 >>> 0 或使用大整数 BigInt 保证数值不溢出。
/**
 * 基于拒绝采样法的无偏差随机整数生成器 [0, n - 1]
 * @param {number} n 目标区间大小 (正整数,且 n <= 2^32)
 * @returns {number} 严格均匀分布在 [0, n - 1] 的整数
 */
function getRandomIntUniform(n) {
  if (!Number.isInteger(n) || n <= 0 || n > 0xFFFFFFFF) {
    throw new RangeError("参数 n 必须是位于 1 到 2^32 之间的合法正整数");
  }
  if (n === 1) return 0;

  // 2^32 = 4294967296
  const MAX_UINT32 = 0x100000000;
  // 计算合法的完全整除上界
  const limit = MAX_UINT32 - (MAX_UINT32 % n);

  const buffer = new Uint32Array(1);
  let rand;

  do {
    crypto.getRandomValues(buffer);
    rand = buffer[0];
  } while (rand >= limit); // 落入不完整尾区则重新生成

  return rand % n;
}
四、核心修正方法二:Lemire 无除法快速整数采样
虽然拒绝采样法消除了偏差,但在底层指令层面,取模与整数除法属于高延迟指令(在现代 CPU 上通常消耗 20~40 个时钟周期)。在每秒需要生成数千万随机数的极端高性能场景(如蒙特卡洛模拟或高频撮合系统)中,取模运算会成为瓶颈。
计算机科学家 Daniel Lemire 提出了一种基于定点乘法的快速采样算法(Fast Random Integer Generation in an Interval)。该算法完全避开了除法指令的主流程,仅在极低概率的分支中才进行阈值核验。
1. 算法推导
给定 32 位无符号随机数 x 和目标上限 s:
- 将两者相乘得到 64 位乘积:
m = x * s。 - 将
m的高 32 位作为候选结果:result = m >> 32。这一步等价于计算floor(x * s / 2^32),完全通过乘法与移位完成。 - 乘积的低 32 位
l = m & 0xFFFFFFFF表示小数部分。如果l >= (-s % s),则该结果被直接确认为无偏差,立即返回! - 仅当
l < (-s % s)时,才说明乘积落在了可能导致舍入不均的临界边界,此时进入慢速路径拒绝并重试。
2. JavaScript (BigInt) 完整实现
/**
 * Lemire 无除法快速随机整数生成算法
 * @param {number} s 目标范围大小 (s < 2^32)
 * @returns {number} 严格无偏随机整数 [0, s - 1]
 */
function lemireRandomInt(s) {
  if (s <= 1) return 0;

  const sBig = BigInt(s);
  const MAX_32 = 0x100000000n;
  // 计算拒绝阈值 threshold = (2^32 % s) = (-s % s)
  const threshold = (MAX_32 - sBig) % sBig;

  const buf = new Uint32Array(1);

  while (true) {
    crypto.getRandomValues(buf);
    const x = BigInt(buf[0]);
    // 64 位乘积
    const m = x * sBig;
    // 取低 32 位
    const l = m & 0xFFFFFFFFn;

    // 绝大多数情况下(>99.9%)在此直接返回,完全不需要除法
    if (l >= threshold) {
      return Number(m >> 32n);
    }
  }
}
五、工程实践与原生 API 选用策略
在实际工程开发中,不必所有场景都手写底层算法。根据运行环境与安全要求选择最适合的方案:
1. Node.js 环境:优先选用 crypto.randomInt
Node.js 从 v14.10.0+ 开始在内置 crypto 模块中提供了 crypto.randomInt 方法。该方法直接在 C++ 底层实现了无偏差的拒绝采样,且具备极高的执行效率:
const crypto = require('crypto');

// 生成 [min, max) 范围内的安全随机整数,严格无偏差
const randomVal = crypto.randomInt(0, 100); // 包含 0,不包含 100
2. 浏览器环境:封装统一的通用工具函数
由于目前 Web 标准暂未提供与 crypto.randomInt 完全对等的原生简写 API,建议在前端工具库中统一封装基于 crypto.getRandomValues 的拒绝采样实现,替换所有旧有的直接取模代码。
六、偏差验证实验与测试方法
如何科学地验证一段随机数代码是否存在取模偏差?最可靠的工程手段是运用皮尔逊卡方拟合优度检验(Pearson's Chi-square Test)。
通过采集海量样本并统计各个桶的实际观测频次(Observed)与理论均匀期望频次(Expected)之间的偏离程度:
/**
 * 卡方检验验证随机数发生器分布质量
 * @param {Function} rngFunc 待测试的随机数函数 () => integer in [0, k-1]
 * @param {number} k 桶数量
 * @param {number} totalSamples 总采样次数 (如 1,000,000)
 */
function verifyDistributionQuality(rngFunc, k, totalSamples = 1000000) {
  const counts = new Uint32Array(k);
  for (let i = 0; i < totalSamples; i++) {
    counts[rngFunc()]++;
  }

  const expected = totalSamples / k;
  let chiSquare = 0;

  for (let i = 0; i < k; i++) {
    const diff = counts[i] - expected;
    chiSquare += (diff * diff) / expected;
  }

  console.log(`总采样数: ${totalSamples}, 桶数: ${k}`);
  console.log(`卡方统计量: ${chiSquare.toFixed(2)}, 自由度: ${k - 1}`);

  // 若卡方统计量显著超出临界阈值,则说明存在统计学偏差
  return { chiSquare, counts };
}
在 8 位微型随机源的极端对照实验中,直接取模函数的卡方值会达到数万级别,严重拒绝均匀假设;而采用本文给出的拒绝采样法后,卡方值均稳定落在自由度允许的正常置信区间内。
七、常见疑问与实施细节总结
| 关键问题 | 分析原因 | 正确实施方案 |
|---|---|---|
能否用 Math.floor(Math.random() * n) 替代取模? |
Math.random() 返回 53 位双精度浮点数,通过乘法缩放后在一般业务上偏差极小。但其底层为伪随机数生成器(PRNG),绝非密码学安全,种子可被预测。 |
非安全展示类场景可用;抽奖、洗牌、令牌等安全敏感业务严禁使用。 |
为什么直接使用 array[0] % n 在大范围时感觉不明显? |
当源空间 2^32 远大于 n 时,单个数字的绝对偏差极小(例如 10^-9 量级),常规小样本测试很难察觉,但在长时间运行或大样本下必然暴露。 |
即使偏差极小,在密码学与安全审计中也是致命缺陷,必须始终遵循拒绝采样规范。 |
小字节随机源(如 Uint8Array)取模有什么特殊危害? |
Uint8Array 仅有 256 个状态,若目标范围为几十(如字符集 62),相对偏差可暴增至 20% 以上,极易遭受碰撞攻击。 |
切勿使用 8 位或 16 位数组直接取模,至少使用 32 位随机字配合拒绝采样。 |
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章