
深入解析JavaScript展开运算符(...)与迭代器协议的底层关联。剖析规范运行机制、手写底层执行模拟、辨析数组展开与对象展开的本质区别,以及掌握异常清理与工程避坑指南。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JavaScript展开运算符与迭代器的底层关联
作者:青柠
时间:2026-11-05
浏览:208
文章目录
ECMAScript 深入
规范剖析
阅读时间:约 12 分钟
适用范围:Node.js & 现代前端工程
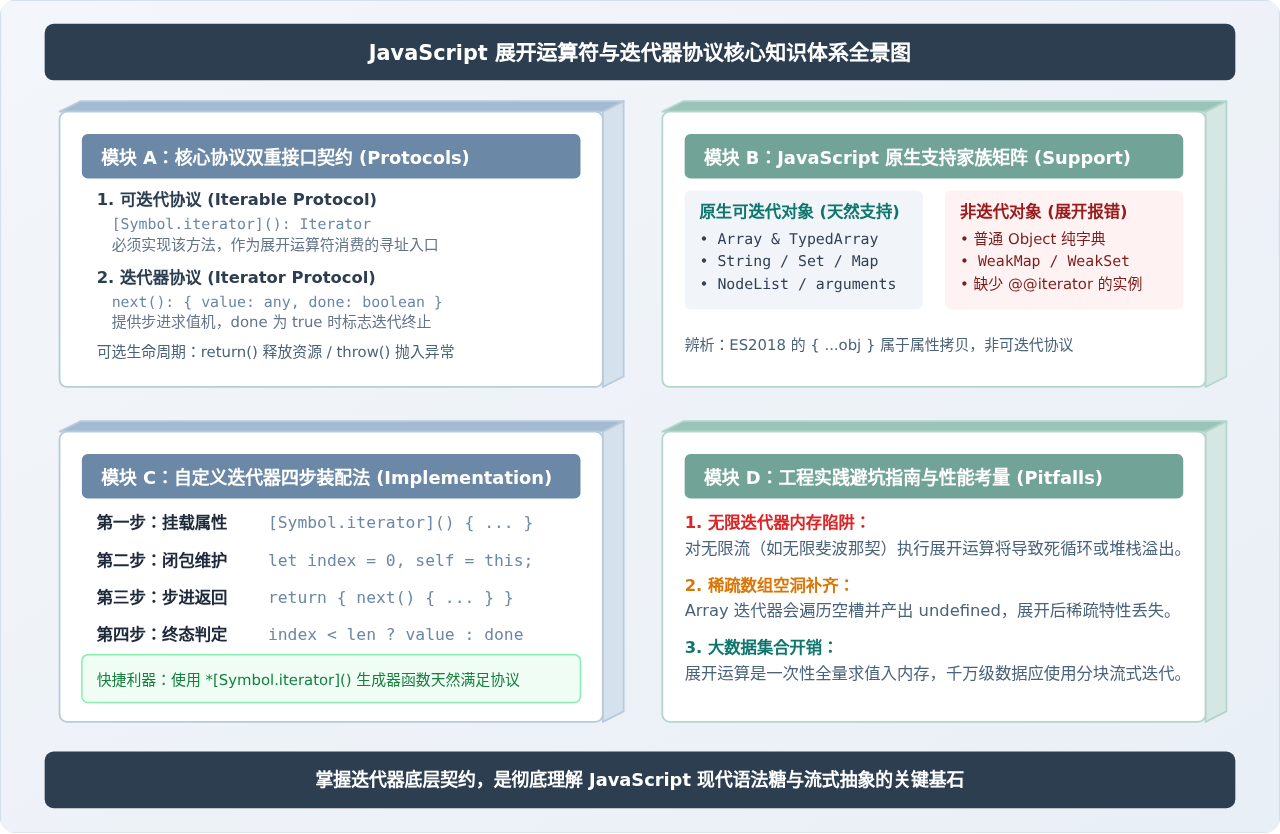
在 JavaScript 中,用于数组构造 [...iterable] 与函数实参传递 fn(...iterable) 的展开运算符(Spread Syntax),本质上是迭代器协议(Iteration Protocols)的高阶语法糖。展开运算符并不会直接读取索引或通过私有插槽提取数据,而是严格遵循 ECMA-262 规范中的迭代抽象操作:先调用目标对象的 [Symbol.iterator] 方法获取迭代器,再循环调用其 next() 方法消费每一项数据,直到返回 { done: true } 为止。
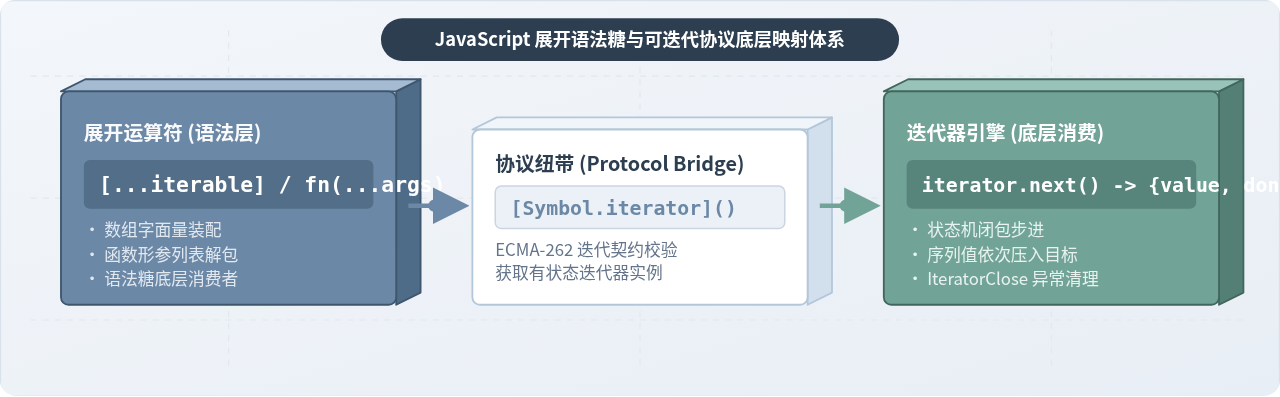
一、核心问题引入:展开运算符是如何找到并消费数据的?
在日常开发中,我们习惯使用展开运算符将数组解包、合并 Set 集合,或者把字符串拆解为字符数组:
const set = new Set([1, 2, 3]);
const arr = [...set]; // [1, 2, 3]

const str = "hello";
const chars = [...str]; // ["h", "e", "l", "l", "o"]
但当开发者尝试对一个结构清晰的普通对象执行同样的操作时,却会直接抛出运行期异常:
const user = { id: 101, name: "Alice" };
const result = [...user];
// ❌ Uncaught TypeError: user is not iterable (cannot read property Symbol(Symbol.iterator))
为什么数组、Set、字符串可以被放进方括号中展开,而普通对象却不行?错误信息中出现的 is not iterable 与 Symbol(Symbol.iterator) 揭示了答案:展开运算符的求值逻辑完全寄生于可迭代协议。只要一个对象没有提供符合规范的迭代器访问入口,展开运算符就无法识别并提取它内部的任何数据。
二、ECMA-262 规范层面的底层执行流程
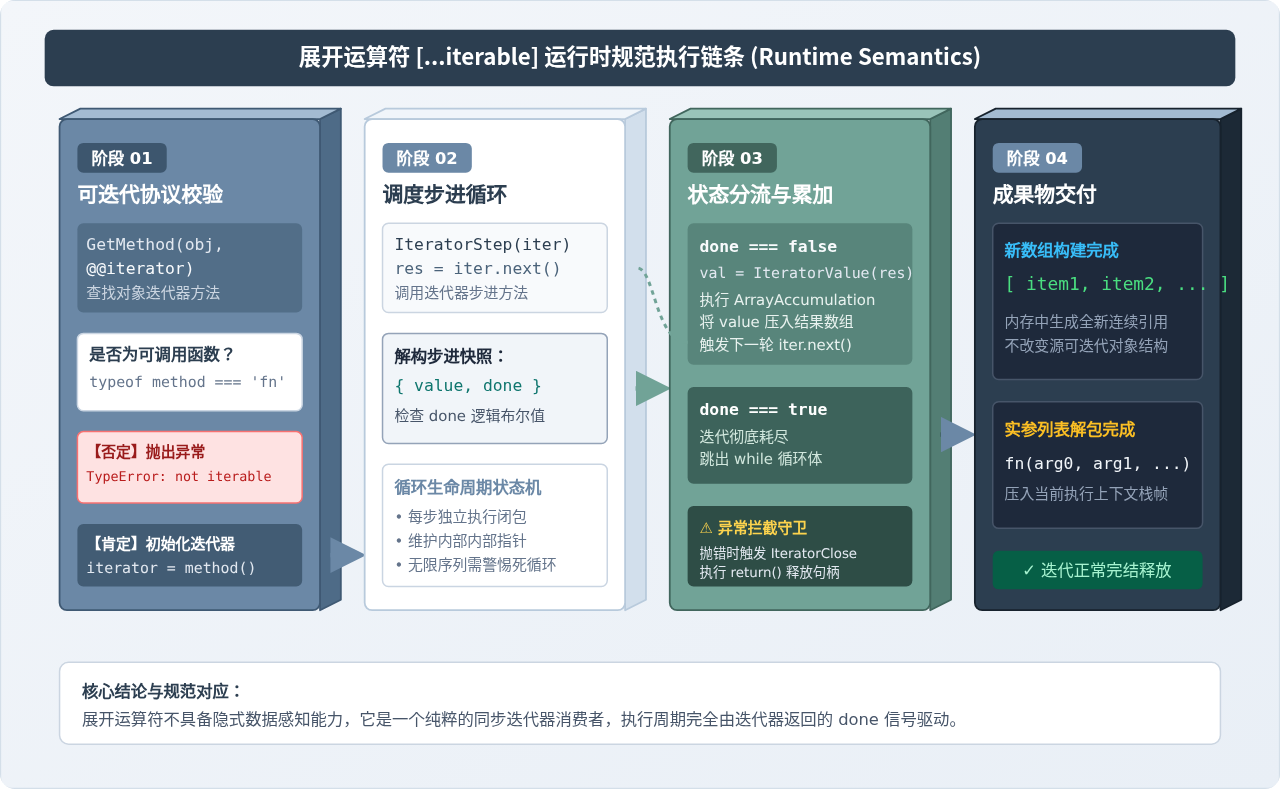
要透彻理解这种关联,我们需要查看规范在执行 [...iterable] 时的具体语义。在 ECMAScript 规范的 Runtime Semantics: ArrayAccumulation(数组累积求值)与 ArgumentListEvaluation(实参列表求值)中,展开运算的具体步骤可形式化概括为四个阶段:
- 寻址协议接口(GetIterator):引擎内部执行抽象操作
GetIterator(obj, sync)。该操作通过GetMethod(obj, @@iterator)查找目标对象的[Symbol.iterator]属性。如果该属性值为undefined或不是可调用函数,引擎立即终止并抛出TypeError: obj is not iterable。 - 实例化迭代器:调用查找到的
[Symbol.iterator]()函数,返回一个具备迭代器接口的对象iterator。 - 步进循环(IteratorLoop):进入死循环调用
IteratorStep(iteratorRecord)。其内部会触发iterator.next(),获得形如{ value: any, done: boolean }的迭代步进对象。 - 分流与收集(ArrayAccumulation):
- 若
done === false:执行IteratorValue(result)提取当前值,将其作为新元素追加到结果数组中(或放入函数调用栈的形参列表),随后继续执行下一次next()。 - 若
done === true:跳出迭代循环,返回已经完成填充的新数组。
- 若
手写还原:用原生 JavaScript 模拟展开运算符底层
我们可以用原生的 while 循环与协议方法,完全复刻展开运算符在数组构建时的底层行为:
function manualSpread(iterable) {
  // 1. 检查是否存在 Symbol.iterator 属性
  if (iterable == null || typeof iterable[Symbol.iterator] !== "function") {
    throw new TypeError(`${typeof iterable} is not iterable (cannot read property Symbol(Symbol.iterator))`);
  }

  // 2. 调用该方法获取迭代器实例
  const iterator = iterable[Symbol.iterator]();
  const result = [];

  // 3. 循环步进消费
  while (true) {
    const step = iterator.next();

    // 如果迭代器返回非对象类型,规范规定抛出 TypeError
    if (typeof step !== "object" || step === null) {
      throw new TypeError("Iterator result " + step + " is not an object");
    }

    // 检查终止信号
    if (step.done) {
      break;
    }

    // 将每次产出的 value 追加至结果数组
    result.push(step.value);
  }

  return result;
}

// 验证原生数组
console.log(manualSpread([10, 20, 30])); // 输出: [10, 20, 30]

// 验证 Set 结构
console.log(manualSpread(new Set(["A", "B"]))); // 输出: ["A", "B"]
通过上述模拟可以清楚地看到,展开运算符本身没有任何特殊的“内部后门”,它与标准的 for...of 循环共享了同一套迭代器驱动内核。
三、关键分野:为什么 [...obj] 报错,而 {...obj} 却能正常工作?
许多初学者常对 JavaScript 中的对象展开产生误解:“既然展开运算符依赖迭代器,为什么 ES2018 引入的对象字面量展开 { ...obj } 可以直接展开普通对象?”
这是因为 JavaScript 语意中存在两种完全独立的展开机制,虽然它们在语法上都使用三点号 ...:
- 可迭代展开(Iterable Spread):作用于数组字面量
[...item]或函数参数列表fn(...args)。底层强依赖Symbol.iterator。 - 对象属性展开(Object Spread Properties):作用于对象字面量
{ ...obj }。底层依赖对象内部方法[[OwnPropertyKeys]]与[[Get]],用于复制自身可枚举属性(Own Enumerable Properties)。
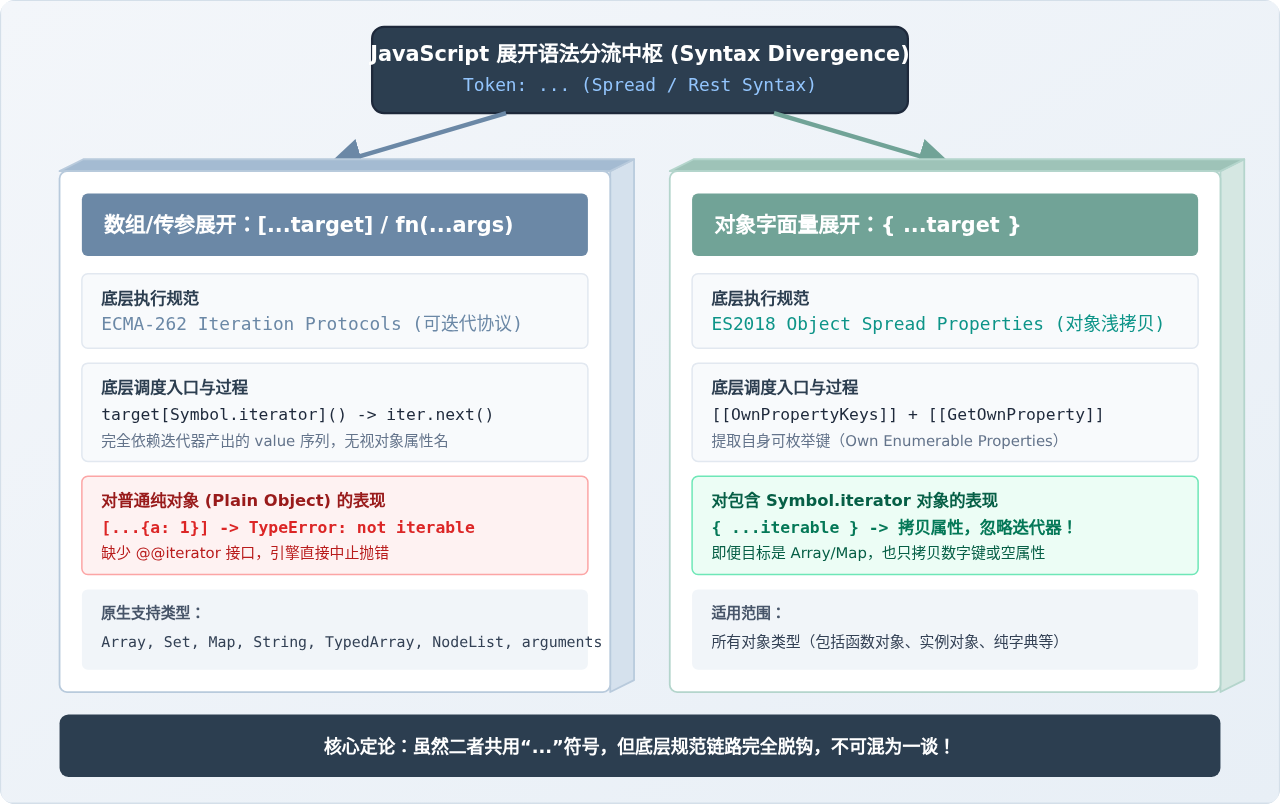
为了证实这一底层分水岭,我们可以做一个对照实验:为一个对象同时定义普通属性与 [Symbol.iterator] 方法,分别观察两种展开的行为:
const hybridObject = {
  name: "ServiceWorker",
  port: 8080,
  // 挂载自定义迭代器
  *[Symbol.iterator]() {
    yield "Active";
    yield "Listening";
  }
};

// 1. 数组展开:走可迭代协议,完全无视 name 与 port
console.log([...hybridObject]);
// 输出: ["Active", "Listening"]

// 2. 对象展开:走自身可枚举属性拷贝,完全不调用 Symbol.iterator
console.log({ ...hybridObject });
// 输出: { name: "ServiceWorker", port: 8080 }
// 注意:[Symbol.iterator] 属于方法属性(不可枚举或作为函数属性),其生成器的 yield 逻辑根本未被触发!实验结果明确验证了:对象字面量展开不是迭代器协议的消费者。因此,谈及“展开运算符与迭代器的底层关联”时,技术规范所指的一定是数组构建与参数解包场景。
四、实践落地:为普通对象挂载自定义迭代器
既然 [...iterable] 的核心是检测 [Symbol.iterator],那么只要我们在普通对象上实现符合规范的迭代器,普通对象也能直接被展开为数组。
1. 完整手写标准迭代器协议
标准迭代器协议要求返回的对象具备 next() 方法,且 next() 执行后必须返回包含 value 与 done 属性的对象:
const paginationData = {
  pageSize: 2,
  items: ["Node.js", "TypeScript", "V8 Engine", "WebAssembly"],

  // 实现可迭代协议接口
  [Symbol.iterator]() {
    let currentIndex = 0;
    const data = this.items;

    // 返回迭代器对象
    return {
      next() {
        if (currentIndex < data.length) {
          return { value: data[currentIndex++], done: false };
        }
        // 迭代结束
        return { value: undefined, done: true };
      }
    };
  }
};

// 现在 paginationData 成为合法的可迭代对象
const list = [...paginationData];
console.log(list);
// 输出: ["Node.js", "TypeScript", "V8 Engine", "WebAssembly"]
2. 使用 Generator(生成器函数)简化实现
手写闭包和指针状态容易出现边界遗漏。在现代 JavaScript 中,生成器函数(function*)天然返回一个生成器对象,而生成器对象本身既实现了 Iterable 接口也实现了 Iterator 接口:
const team = {
  lead: "Alice",
  devs: ["Bob", "Charlie"],
  qa: "David",

  // 使用 Generator 挂载迭代器
  *[Symbol.iterator]() {
    yield this.lead;
    yield* this.devs; // 委托迭代子数组
    yield this.qa;
  }
};

console.log([...team]);
// 输出: ["Alice", "Bob", "Charlie", "David"]
五、异常边界与资源回收:IteratorClose 规范与 return() 钩子
在实际生产中,迭代过程可能并不是平稳耗尽的。如果迭代器内部抛出错误,或者在展开执行时发生了运行时异常,系统持有的底层资源(如打开的文件描述符、网络长连接或数据库游标)该如何安全关闭?
ECMAScript 规范为此定义了 IteratorClose(iteratorRecord, completion) 抽象操作:
- 当迭代过程以非正常模式中断(Abrupt Completion)时,引擎会在向外冒泡异常之前,检查该迭代器实例上是否存在
return()方法。 - 如果
return是一个可调用函数,引擎会立即执行它,让开发者有机会清理未释放的状态。
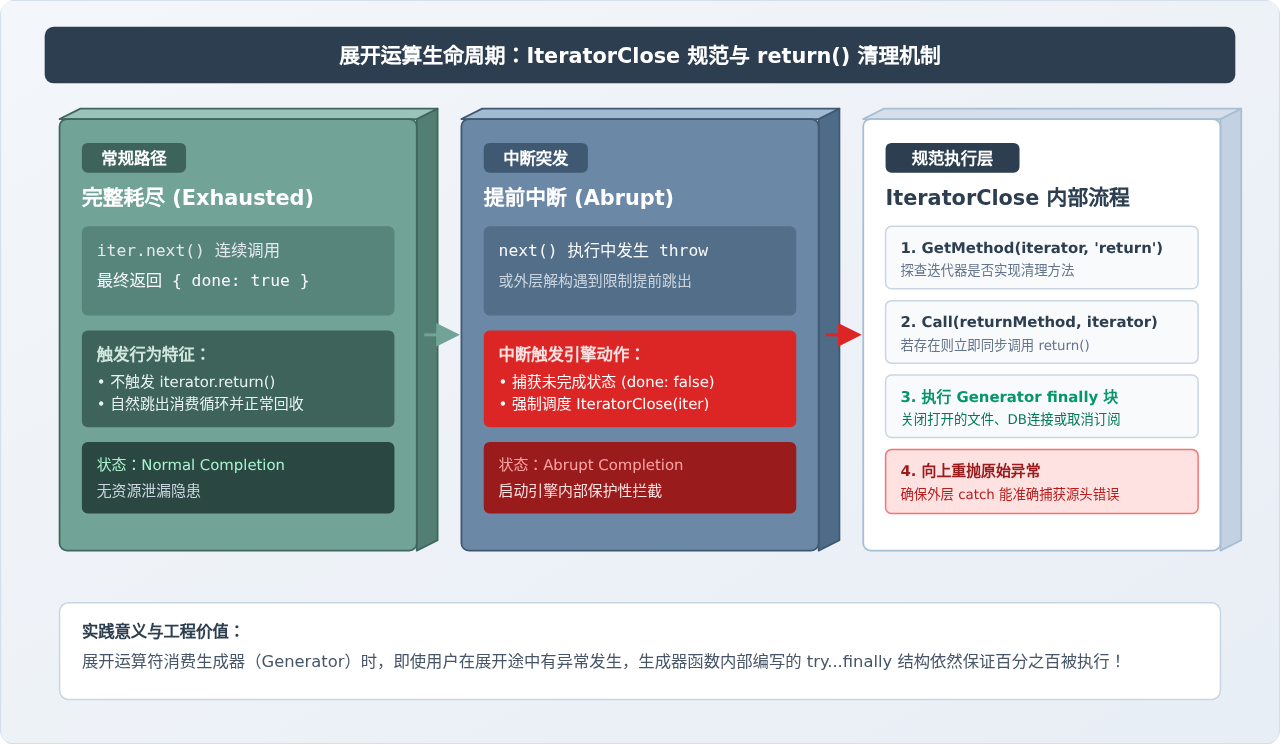
我们可以通过以下案例观察这一机制在生成器展开中的实际运作:
function* resourceReader() {
  console.log("-> 1. 占用文件流资源");
  try {
    yield "CHUNK_A";
    yield "CHUNK_B";
    // 模拟内部发生异常
    throw new Error("Disk Read Error");
    yield "CHUNK_C";
  } finally {
    // 无论是正常完结还是被中途打断,finally 块均被 IteratorClose 驱动执行
    console.log("-> 2. 安全释放文件流资源 (Finally executed)");
  }
}

try {
  const data = [...resourceReader()];
} catch (err) {
  console.log("-> 3. 外层捕获异常:", err.message);
}

// 执行输出顺序:
// -> 1. 占用文件流资源
// -> 2. 安全释放文件流资源 (Finally executed)
// -> 3. 外层捕获异常: Disk Read Error
规范提示:当展开运算符完整消费了数据(即
step.done === true 自然结束)时,引擎不会调用 return();只有在遇到中途异常退出的场景下,IteratorClose 才会介入调用 return()。
六、工程实践避坑指南与性能考量
理解了展开运算符与迭代器的底层关系后,在复杂工程架构中还需规避以下典型陷阱:
1. 警惕无限迭代器(Infinite Iterable)导致内存溢出
展开运算符是贪婪求值(Eager Evaluation)的,它必须等到 done: true 才会完成内存装配。如果将展开运算符用于数学序列生成器、事件流等无限迭代器,程序将直接陷入死循环,最终引发浏览器卡死或 Node.js 进程 JavaScript heap out of memory 崩溃:
// ❌ 危险操作:无限数列生成器
function* naturalNumbers() {
  let n = 1;
  while (true) yield n++;
}

// 绝不能直接展开无限流:
// const allNumbers = [...naturalNumbers()]; // 内存瞬间被撑爆!

// 正确做法:配合限制函数或在固定步数后截断消费
function take(iterable, count) {
  const iterator = iterable[Symbol.iterator]();
  const res = [];
  for (let i = 0; i < count; i++) {
    const step = iterator.next();
    if (step.done) break;
    res.push(step.value);
  }
  return res;
}

console.log(take(naturalNumbers(), 5)); // [1, 2, 3, 4, 5]
2. 稀疏数组(Sparse Array)展开后的空洞填补
JavaScript 允许数组中存在“空洞”(holes)。由于 Array.prototype[Symbol.iterator] 的实现机制是按索引连续递增访问,当访问到未定义的位置时,迭代器产出的是 { value: undefined, done: false }。因此展开运算符会把所有“空槽”显式转换为 undefined,改变数组的存储形态:
const sparse = [1, , 3]; // 长度为 3,索引 1 处为空洞
console.log(1 in sparse); // false

const dense = [...sparse]; // 展开重塑
console.log(dense); // [1, undefined, 3]
console.log(1 in dense); // true (空洞被填补为实际键值)
3. 极大数据集合下的临时数组分配开销
展开运算符会一次性在堆内存中开辟容纳所有元素的空间。如果处理数百万条记录,直接展开会造成显著的垃圾回收(GC)压力和瞬时内存尖峰。对于超大规模数据集,推荐直接使用 for...of 逐项流式消费,或借助异步迭代器(Async Iterator)分批处理。
七、总结
JavaScript 展开运算符与迭代器协议的关系,是现代语言设计中“语法层与语义规范解耦”的典范体现:
| 对比维度 | 展开运算符视角(语法层) | 可迭代协议视角(底层语义) |
|---|---|---|
| 角色职责 | 语法糖消费者,提供精炼的书写表达 | 标准契约提供者,规范数据的流式产出 |
| 核心依赖 | 隐式寻址 [Symbol.iterator] 属性 |
暴露 next() 与返回 { value, done } |
| 生命周期 | 贪婪读取直到 done: true |
通过状态机维持当前读取偏移量与资源清理 |
| 异常应对 | 捕获异常并交还调用栈 | 触发 IteratorClose,执行 return() 钩子 |
| 对象字面量区别 | { ...obj } 走属性拷贝,脱离本体系 |
严格仅服务于有序集合构造与实参展开 |
理解这一底层纽带,不仅能帮助我们彻底消除 object is not iterable 的疑惑,更为我们设计灵活的数据流管道、掌控生成器模式以及优化内存性能提供了清晰的底层视角。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章