

深入对比现代原生JavaScript文件下载(a标签download属性与Blob)与FileSaver.js库的底层实现、兼容性差异、内存管理及适用场景,帮助前端开发者在技术选型中做出精准决策。
原生JavaScript下载与FileSaver.js库该怎么选择
作者:窗边听雨
时间:2026-11-05
浏览:172
文章目录
前端工程实践
主题:客户端文件保存技术对比
适用环境:现代主流浏览器与遗留系统
导读概览:原生方式与第三方库在现代开发中的定位
在前端页面中导出报表、生成配置文件或保存用户绘制的图片,是日常开发中极高频的功能。实现该能力时,开发者通常面临两个路径:直接用原生 JavaScript 拼接 Blob 并触发 <a download>,或者直接引入开源库 FileSaver.js(调用 saveAs)。
先给出一个明确的选型结论:如果你的项目面向的是现代主流浏览器(即 Chrome、Edge、Firefox 以及近几年的 Safari),推荐直接使用原生 JavaScript 封装的下载函数;如果你的系统仍需兼顾 Internet Explorer、老旧移动端 WebView,或不希望在团队内部重复编写兼容防御逻辑,引入成熟的 FileSaver.js 依然是最省心的选择。本文将从底层机制、兼容性演变、内存控制与适用边界四个维度展开具体分析,并给出工业级的封装参考代码。
一、原生 JavaScript 下载的核心机制与标准实现
原生前端下载并不神秘,其核心逻辑建立在 HTML5 的超链接下载属性以及 W3C File API 之上。具体由四个环环相扣的环节构成:将数据转为二进制对象、生成内存地址、构建 DOM 触发下载行为、并在合适的时机释放内存引用。
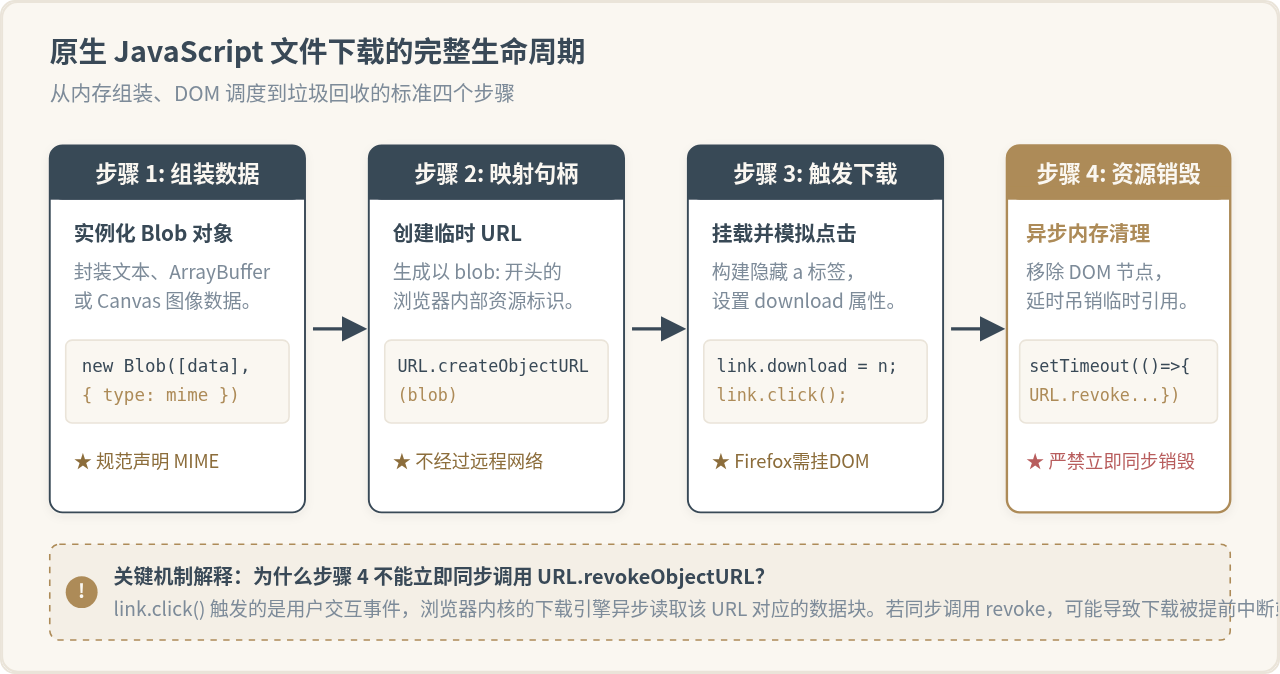
图 1:原生 JavaScript 文件下载的完整生命周期与资源释放流程
在上面的四个步骤中,有两个非常关键的技术细节值得单独说明:
- 必须将
<a>标签挂载到document.body:在 Chrome 中,未挂载到 DOM 树的独立节点调用.click()通常能够工作,但 Firefox 对安全规范的要求更为严格,未挂载到页面上下文的节点派发点击事件可能会被忽略或静默失败。因此,先appendChild,触发后再removeChild是保证多浏览器行为统一的必要手段。 - 内存泄露与异步回收(
URL.revokeObjectURL):浏览器为 Blob 创建的临时 Object URL 会一直驻留在当前 Document 的内存中,直到文档卸载或手动释放。如果频繁导出数据而未主动调用revokeObjectURL,会造成显著的内存泄露。但若在link.click()后紧跟着同步调用revokeObjectURL,在部分浏览器(特别是 Safari 与较旧内核)中,底层的下载进程尚未完成首字节流拉取,地址就已被销毁,最终导致下载静默失败。因此,业内通行做法是将其放入宏任务队列(如setTimeout(..., 1000))进行延时释放。
基于上述原理,我们可以写出一段简洁、标准且具备防御性的原生下载封装函数:
/**
 * 原生前端文件下载函数
 * @param {Blob|string} content - 文件内容,支持 Blob 实例或纯文本/JSON 字符串
 * @param {string} filename - 保存的文件名(含扩展名)
 * @param {string} [mimeType='application/octet-stream'] - 仅在 content 为字符串时指定的类型
 */
function downloadFileNative(content, filename, mimeType = 'application/octet-stream') {
  // 1. 统一归一化为 Blob 实例
  const blob = content instanceof Blob ? content : new Blob([content], { type: mimeType });

  // 2. 生成内部内存链接
  const objectUrl = URL.createObjectURL(blob);

  // 3. 构建并配置超链接节点
  const link = document.createElement('a');
  link.href = objectUrl;
  link.download = filename;
  link.style.display = 'none';

  // 4. 挂载到文档树并模拟点击触发下载
  document.body.appendChild(link);
  link.click();

  // 5. 延迟清理 DOM 与内存映射
  setTimeout(() => {
    document.body.removeChild(link);
    URL.revokeObjectURL(objectUrl);
  }, 1000);
}
二、FileSaver.js 的核心机制与历史使命
既然原生仅仅用十余行代码就能完成下载,为什么 FileSaver.js 能够在 npm 上累积数亿次的下载量?要回答这个问题,我们需要理解前端文件导出在过去十余年中的兼容性痛点。
由前端先驱 Eli Grey 创造的 FileSaver.js,其核心价值在于抹平历史浏览器的特异怪癖。在 HTML5 规范刚落地的阶段,各个浏览器对客户端直接保存文件的支持极为碎片化:
- IE 10 与 IE 11:完全不支持
<a download>属性,直接点击链接只会将文件在浏览器内部打开。但微软提供了独有的私有 APInavigator.msSaveOrOpenBlob(blob, filename)。 - 早期 iOS 与 Safari:对
download属性支持迟钝,点击生成链接时会弹出一个空白预览标签页,或者强制将文件名命名为Unknown。 - 早期 Chrome 与 Android 浏览器:对于大体积 Blob 生成的
data:URI 存在 URL 长度硬限制(一般为 2MB 左右)。
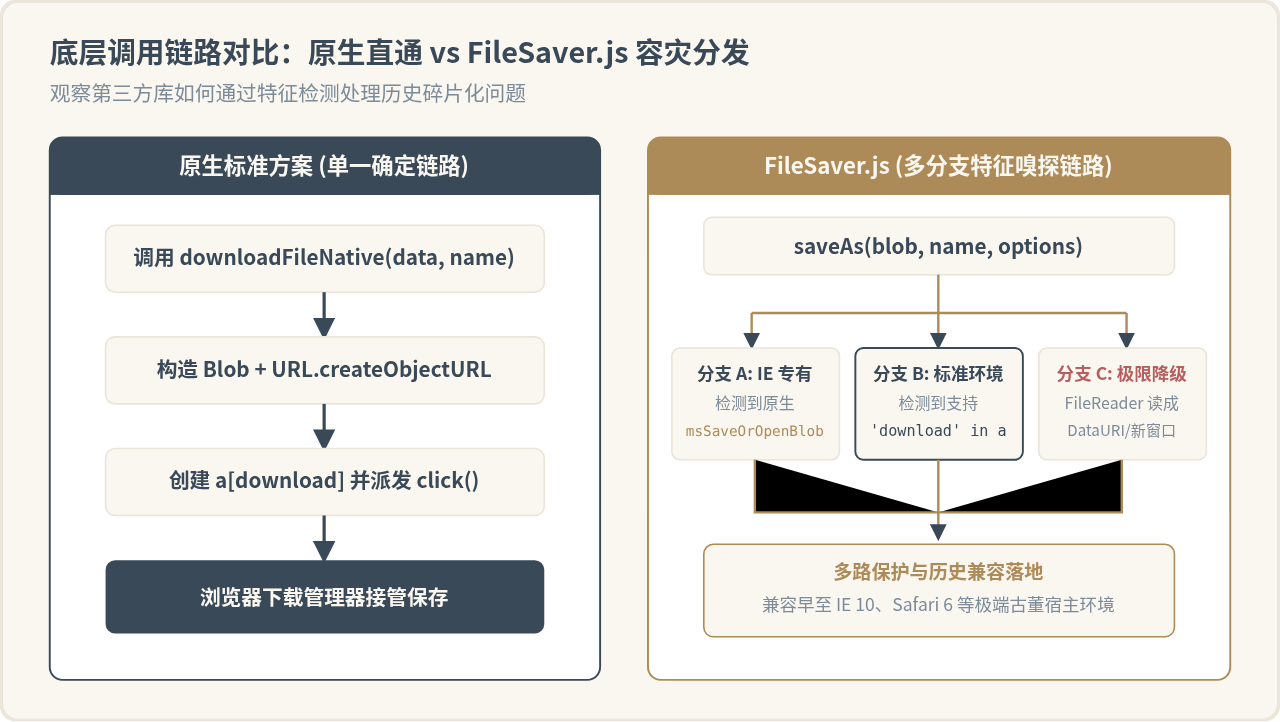
图 2:原生下载与 FileSaver.js 底层调用链路与回退机制对比
从底层实现来看,在现代浏览器执行环境中,FileSaver.js 内部走的分支与我们编写的原生代码几乎完全相同——都是判断 'download' in HTMLAnchorElement.prototype 是否为真,随后生成 Object URL、创建节点并调用 click()。这意味着在现代浏览器中,FileSaver.js 并未提供额外的魔法性能,它在此时仅仅是一个经过历史沉淀的“外壳包装”。
三、核心维度横向剖析:原生与库的差异
在做技术决策时,不能单纯看“谁的名气大”或“代码行数多”,而要根据项目的实际运行环境、打包约束、大文件处理与维护成本进行立体对比。
图 3:原生方案与 FileSaver.js 在关键技术维度的特性矩阵
| 对比维度 | 原生 JavaScript 方案 | FileSaver.js 开源库 |
|---|---|---|
| 核心 API 依赖 | HTMLAnchorElement.download, URL.createObjectURL |
saveAs(),底层分发原生、msSaveOrOpenBlob 与降级 |
| 打包体积与维护成本 | 0 KB,无需维护依赖版本,无 npm 供应链安全风险 | 约 2.5KB (gzipped),需维护构建配置与类型声明包 |
| 现代浏览器表现 | 完全一致,执行开销极低,标准规范直接支持 | 内部走原生链路,体验无实质差异 |
| 老旧 IE (10/11) 支持 | 不支持(除非手动补充 msSaveBlob 分支) |
内置完备支持,开箱即用 |
| TypeScript 支持 | 浏览器内置 lib.dom.d.ts,原生强类型 |
需额外安装 @types/file-saver |
| 超大文件 (500MB+) | 受内存限制,易导致浏览器 OOM 崩溃 | 同样受内存限制,无法突破单 Blob 上限 |
四、选型决策树:按实际场景给出归宿
面对技术选型,最好的做法不是非此即彼,而是设立清晰的条件过滤器。根据目标受众、浏览器要求和数据规模,可以通过下图所示的决策树得出最适合当前工程的方案:
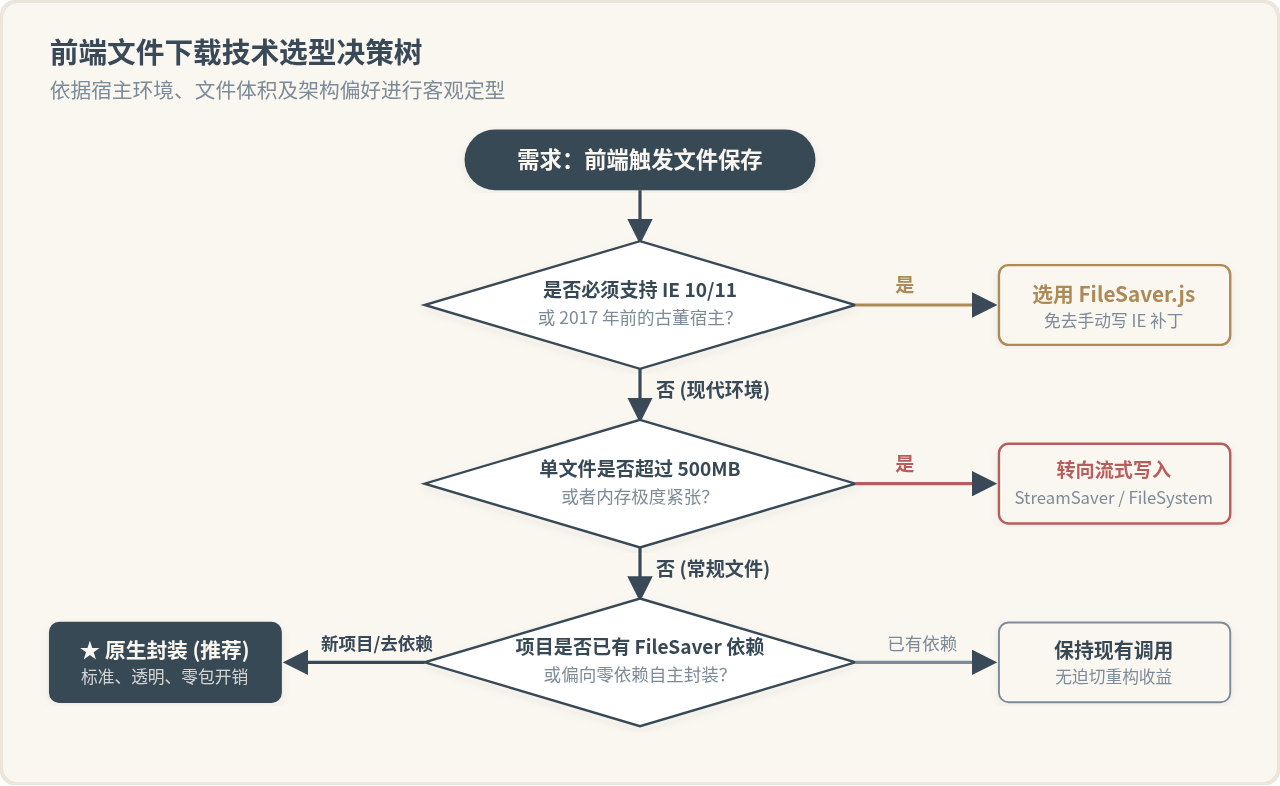
图 4:前端文件下载技术选型决策树
五、高频踩坑点与工程排查事项
无论选用原生还是库,在实际业务场景中都会遇到一些共性的边界问题,以下是三个最高频的陷阱及其规避方案:
陷阱 1:直接给 a 标签赋予跨域 URL 导致 download 属性失效
很多开发者尝试将远程图片或接口地址直接赋给 <a href="https://other-domain.com/file.pdf" download="report.pdf">,发现浏览器并没有触发下载,而是直接在当前标签页打开了文件。这是因为 W3C 规范中明确规定:当且仅当超链接资源处于“同源”环境下,download 属性才会被浏览器采纳;跨域资源会被视为普通导航链接。
解决方法:先通过 fetch 带着同源或允许的跨域凭证请求该远程地址,调用 response.blob() 获取二进制数据,再把生成的同源 blob: 协议地址交给下载逻辑。
陷阱 2:移动端内嵌容器(微信 / 钉钉 / 微博)拦截下载动作
在移动端混合应用(Hybrid App)或微信等内置浏览器中,出于安全或策略考量,宿主往往屏蔽了对底层存储卡写入文件的系统权限。在这些环境中调用 link.click() 或 saveAs,界面通常没有任何反应,或者静默闪退。
解决方法:在移动端内嵌环境中,应先检测 User Agent。若处于受限容器,建议通过右上方“在浏览器中打开”的引导蒙层提示用户跳转至系统自带浏览器,或由后端提供下载直链及对应 Content-Disposition 响应头。
陷阱 3:单页面应用(SPA)频繁导出未释放 Object URL
在报表或数据可视化后台,用户可能会在同一页面内连续导出数十次 Excel、CSV 或高清图表。如果封装函数漏掉了 URL.revokeObjectURL(url),这些庞大的内存块将常驻内存直至用户关闭标签页,极易引起页面卡顿乃至崩溃。
解决方法:严格执行生命周期回收,如前文所示,在 setTimeout(..., 1000) 后自动注销所有由 createObjectURL 产生的引用。
六、总结与落地建议
综上所述,关于“原生 JavaScript 下载与 FileSaver.js 库该怎么选择”的答案已经非常清晰:
- 对于 2026 年以后的新开发项目与现代 Web 系统:优先采用原生代码封装。现代浏览器对
Blob、URL.createObjectURL与<a download>的支持已经坚如磐石,自研几行精简的工具函数不仅省去了外部依赖和构建配置,而且逻辑完全透明可控。 - 对于需要长期维护的老旧政企系统或有历史债务的工程:如果系统仍需运行在旧版 IE、低版本国产特种浏览器,或者已有数十处旧代码调用了
saveAs,保留并使用 FileSaver.js 是性价比最高的务实选择。 - 对于体量超过 500MB 的海量数据导出:请跳出原生与 FileSaver.js 的争论,因为基于客户端全量内存的方案在此类场景下必然存在内存溢出风险。此时应当考虑服务端预压缩下载,或者引入
StreamSaver.js以及现代的showSaveFilePicker(File System Access API)进行边拉取边落盘的流式写入。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章