

深入解析JavaScript反混淆核心原理,讲解如何从AST抽象语法树层面准确识别控制流平坦化与字符串加密数组移位特征,并掌握规避陷阱与结构还原的系统化方法。
JavaScript反混淆原理:怎么识别控制流平坦化与字符串加密
作者:沉舟
时间:2026-11-05
浏览:297
文章目录
反混淆进阶
AST 语法分析
阅读时长:约 12 分钟
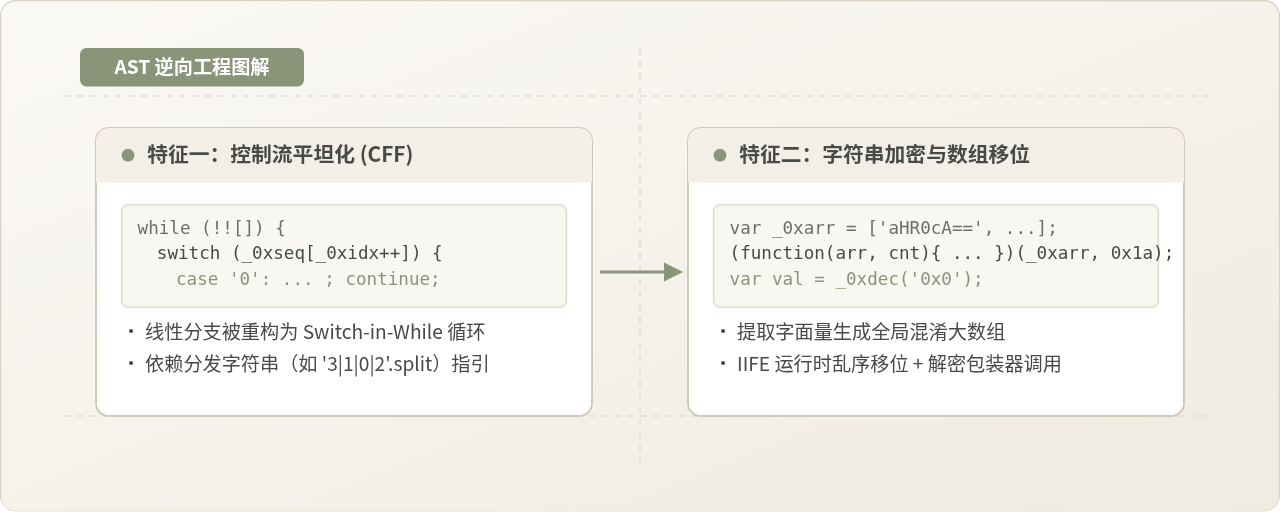
图 0:JavaScript 核心混淆形态概览:控制流循环重排与字符串表调用链路
JavaScript 反混淆的本质是逆向还原被破坏的代码语义与控制结构。在现代混淆器(如 javascript-obfuscator)中,绝大部分保护机制都建立在两个核心基石之上:将线性逻辑打散为分发循环的控制流平坦化,以及将字面量剥离为外部数组的字符串加密。面对高混淆脚本,反混淆工作的第一步不是盲目单步调试,而是从抽象语法树(AST)层面准确识别这两项特征的结构指纹与调用关系。
一、控制流平坦化的结构特征与识别方法
控制流平坦化(Control Flow Flattening,简称 CFF)的设计目标是抹去原本由 if/else、while、for 以及顺序代码块构建的树状嵌套层级,把所有执行逻辑强行降维成同一个层次。
它的工作机理非常确定:混淆器将原函数中的一段连续逻辑拆分为若干互不嵌套的基本块(Basic Blocks),并将每个块包裹在一个 switch 的 case 分支中;接着,在 switch 外部包裹一个无限循环(例如 while(true) 或 while(!![])),并在外部维护一个存储了执行序号的分发器(Dispatcher)。代码在运行时并非按物理书写顺序执行,而是由分发器读取下一个分支标签,驱动 switch 跳转到对应代码块。
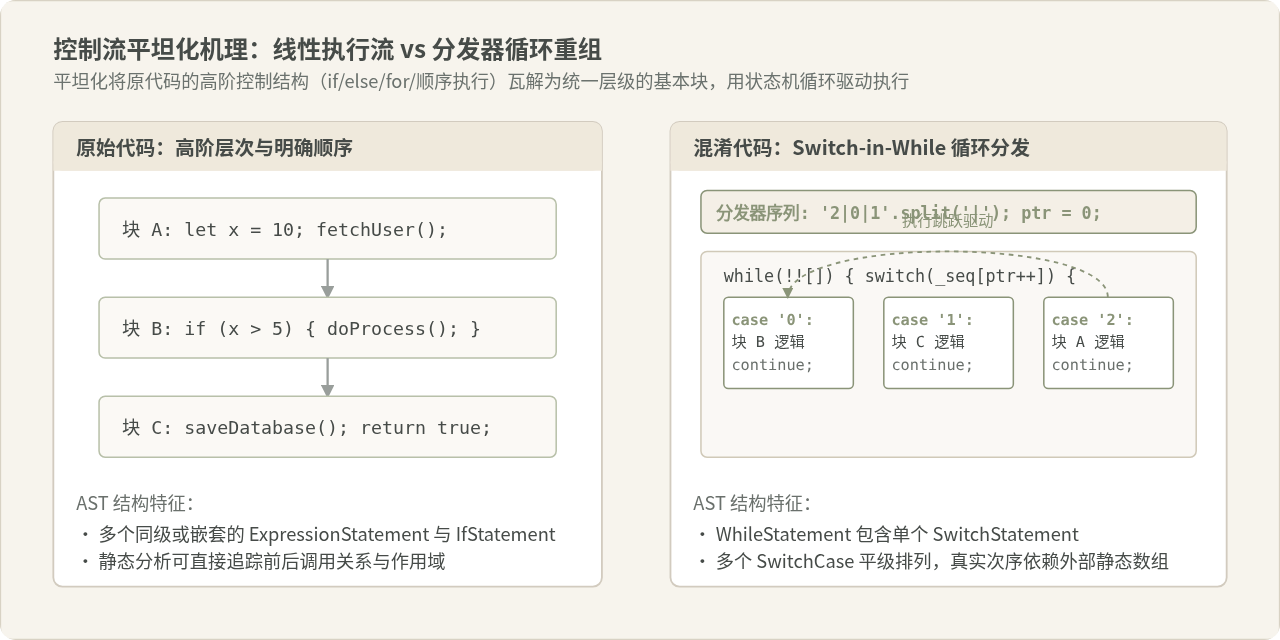
图 1:控制流平坦化结构机理:线性执行流与 Switch-in-While 循环分发器的对比
1. 关键代码模式对比
理解控制流平坦化最直观的方法是观察代码被处理前后的语法形态:
// 原始线性代码
function calculateOrder(user, price) {
  let discount = 1.0;
  if (user.isVip) {
    discount = 0.8;
  }
  const finalPrice = price * discount;
  saveRecord(finalPrice);
  return finalPrice;
}
经过控制流平坦化混淆后,原本清晰的顺序与分支逻辑被转化为状态机结构:
// 混淆后的控制流平坦化形态
function calculateOrder(_0x1a, _0x2b) {
  var _0xdispatcher = '3|1|0|4|2'['split']('|');
  var _0xindex = 0x0;
  while (!![]) {
    switch (_0xdispatcher[_0xindex++]) {
      case '0':
        const _0x5e = _0x2b * _0x3c;
        continue;
      case '1':
        if (_0x1a['isVip']) {
          _0x3c = 0.8;
        }
        continue;
      case '2':
        return _0x5e;
      case '3':
        var _0x3c = 1.0;
        continue;
      case '4':
        saveRecord(_0x5e);
        continue;
    }
    break;
  }
}
2. 识别控制流平坦化的三项指纹特征
在静态分析或 AST 遍历过程中,判断一个函数体是否应用了控制流平坦化,可以依据以下三项充要指纹:
- 外层循环结构(WhileStatement / ForStatement):循环测试条件通常恒为真(如
BooleanLiteral: true、UnaryExpression: ![]或NumericLiteral: 1),内部直接嵌套单个SwitchStatement。 - 分发器声明(Dispatcher Array):循环之前紧邻一个数组或字符串拆分表达式(如
'3|1|0|4|2'.split('|')),且循环内部通过后置自增指针(_0xindex++)连续读取该数组。 - 分支特征(SwitchCase & Continue):包含多个平级的
SwitchCase,绝大部分分支以ContinueStatement结尾,迫使控制流返回循环头部;分支顺序被打乱,不体现真实的时间先后顺序。
易混淆辨析:状态机(FSM)与控制流平坦化的区别
在部分业务逻辑中(如词法解析器、协议解析或游戏状态机),也会出现 while + switch 的写法。二者的本质区别在于状态跳转的驱动源:
业务状态机的跳转依赖于分支内部根据外部输入动态修改的状态变量(如 state = NEXT_TOKEN);而混淆器生成的平坦化代码,其跳转顺序是静态硬编码的(无论是通过 '3|1|0'.split('|') 还是预设固定数组),且每个分支只负责纯粹的单一步骤,分支之间通过外部闭包或函数作用域变量传递中间结果。
二、字符串加密与数组移位的特征与识别方法
字符串字面量(如 API 地址、关键字段名、协议指令、DOM 选择器)是逆向工程中最关键的线索。混淆器为了抹除所有可读信息,会将源码中的所有字符串抽出,替换为全局解密函数的动态调用。
标准的现代字符串混淆并非仅对字符串做 Base64 编码,而是由三个紧密耦合的组件构成经典“三件套”体系:全局大字符串数组、自执行乱序移位函数(IIFE),以及解密包装函数(Wrapper Function)。
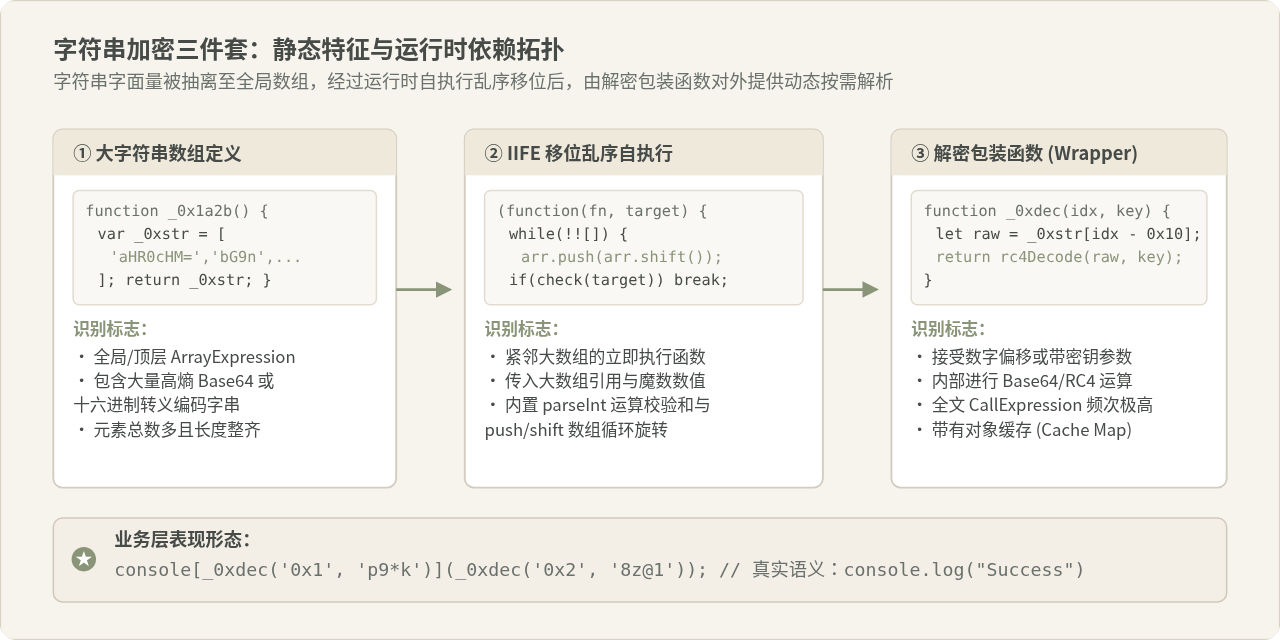
图 2:字符串加密三件套拓扑结构:大数组定义、运行时乱序移位与解密包装函数依赖链
1. 字符串加密三件套的结构拆解
以下是该保护模式在反编译脚本头部的典型骨架:
// 1. 全局大字符串数组(存放所有被抽取的字面量)
var _0x4d12 = ['aHR0cHM6Ly9hcGkueHl6LmNvbQ==', 'UE9TVA==', 'Y29udGVudC10eXBl', 'YXBwbGljYXRpb24vanNvbg=='];

// 2. 自执行乱序移位函数(IIFE)
(function (_0xarr, _0xnum) {
  var _0xshift = function (_0xtarget) {
    while (--_0xtarget) {
      _0xarr['push'](_0xarr['shift']());
    }
  };
  // 内置校验算法,当计算出的校验和匹配预设魔数时终止循环
  var _0xcheck = function () {
    var _0xsum = parseInt(_0x4d12[0x0], 16) + ...;
    if (_0xsum === _0xnum) return true;
  };
  _0xshift(++_0xnum);
}(_0x4d12, 0x1f4));

// 3. 解密包装函数
function _0x2e8a(_0xindex, _0xkey) {
  _0xindex = _0xindex - 0x0;
  var _0xraw = _0x4d12[_0xindex];
  // 内部进行 Base64 解码或 RC4/异或运算
  var _0xresult = atob(_0xraw);
  return _0xresult;
}
2. 为什么需要自执行移位函数?
很多逆向初学者常问:为什么混淆器不直接在 _0x4d12 数组中按正确顺序存放字符串,而必须多加一层自执行函数进行数组循环移位(push(shift()))?
这是混淆器针对纯静态字面量查表设计的防御机制。如果大数组内的元素位置与解密函数的下标索引一一对应,反混淆工具只需读取大数组,即可直接完成静态替换。加入了自执行移位函数后,大数组必须经过运行时的循环左移或右移,真实的下标映射才得以生效。如果直接用静态文本下标去大数组取值,只会得到错误的乱码。
3. 识别字符串加密的指纹特征
- 大数组特征:通常位于文件首部或独立自执行闭包作用域顶部,为一个仅包含字符串字面量的
ArrayExpression,数组项通常是 Base64、十六进制转义序列(形如http)或乱序密文。 - IIFE 移位特征:紧随大数组之后,是一个接受大数组引用和一个固定整数(校验魔数)的立即执行函数表达式(CallExpression)。函数体内通常包含
while(true)循环,伴随arr.push(arr.shift())操作及包含parseInt的校验逻辑。 - 解密包装器特征:定义了一个接受 1 到 2 个参数的命名函数,参数包含一个数字偏移值或解码密钥。代码全文中充斥着对该函数的高频调用(如
_0x2e8a('0x1')或_0x2e8a(0x3, 'k#9P')),原有的属性访问也被改写为方括号语法(例如console[_0x2e8a('0x0')](...))。
三、从正则匹配到 AST 遍历:识别流程与判定规则
在小规模混淆分析中,开发者习惯使用正则表达式搜索特征关键字(如 split\('\|'\) 或 push\(.*shift\(\)\))。然而,现代混淆器生成的标识符随机变化、代码格式经过高度压缩,且容易使用模板字符串、十六进制转义或对象属性间接访问打碎关键字,导致正则匹配极易漏报或误报。
工业级反混淆必须建立在 AST(抽象语法树)分析工具链(如 @babel/parser、@babel/traverse)之上,通过明确的四步操作流程进行模式匹配。
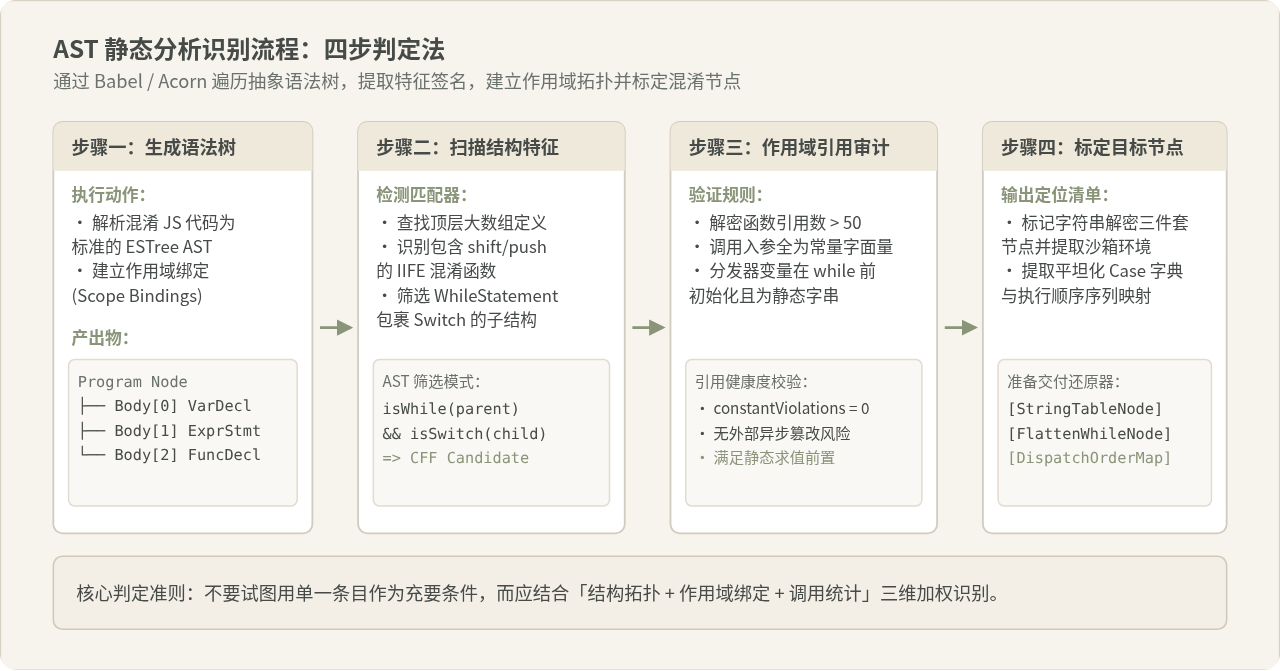
图 3:基于 AST 的混淆特征识别四步操作流程图
基于 Babel AST 的静态识别实践步骤
在脚本解析为语法树后,可以按以下具体步骤进行模式定位:
步骤 1:构建语法树并捕获全局绑定
使用 Babel 解析器将代码转为 AST,并启动 traverse,记录顶级作用域中所有的变量声明(VariableDeclarator):
// 检查大数组与包装函数的作用域绑定
const visitor = {
  VariableDeclarator(path) {
    const { id, init } = path.node;
    // 判定大字符串数组:初始值为长度较大且全为 StringLiteral 的 ArrayExpression
    if (init && init.type === 'ArrayExpression' && init.elements.length > 15) {
      const allStrings = init.elements.every(el => el && el.type === 'StringLiteral');
      if (allStrings) {
        console.log('发现大字符串数组标识符:', id.name, '元素数:', init.elements.length);
      }
    }
  }
};
步骤 2:识别控制流平坦化节点
遍历所有 SwitchStatement 节点,向上回溯其父节点结构:
// 定位控制流平坦化中的 Switch-in-While 结构
const cffVisitor = {
  SwitchStatement(path) {
    const parent = path.parentPath;
    // 条件一:外层直接父节点为 WhileStatement 或 ForStatement
    if (!parent.isWhileStatement() && !parent.isForStatement()) return;

    // 条件二:Switch 的判定表达式来源于成员访问或数组自增下标
    const discriminant = path.node.discriminant;
    const isMemberOrUpdate = discriminant.type === 'MemberExpression' ||
                             discriminant.type === 'UpdateExpression';

    // 条件三:包含大量 case 且多数以 continue 结尾
    const cases = path.node.cases;
    if (cases.length >= 3 && isMemberOrUpdate) {
      console.log('标定控制流平坦化结构,分支总数:', cases.length);
      // 提取外层分发器初始化的语句并分析执行序列
    }
  }
};
步骤 3:验证解密函数的作用域与引用健康度
通过 AST 的 scope.getBinding(fnName) 获取解密函数的绑定对象,重点检查:
binding.referencePaths.length:若引用计数超过数十次甚至数百次,且分布在不同的函数体内,通常为全局解密函数。binding.constantViolations.length:必须为 0,即该标识符从未在后续代码中被重新赋值篡改,确保静态替换时的确定性。
四、反混淆还原路径与注意事项
正确识别特征后,反混淆的下一步是执行结构重组与字面量还原。还原过程必须遵循严格的依赖拓扑顺序,否则会导致程序崩溃或进入混淆器预埋的防御陷阱。
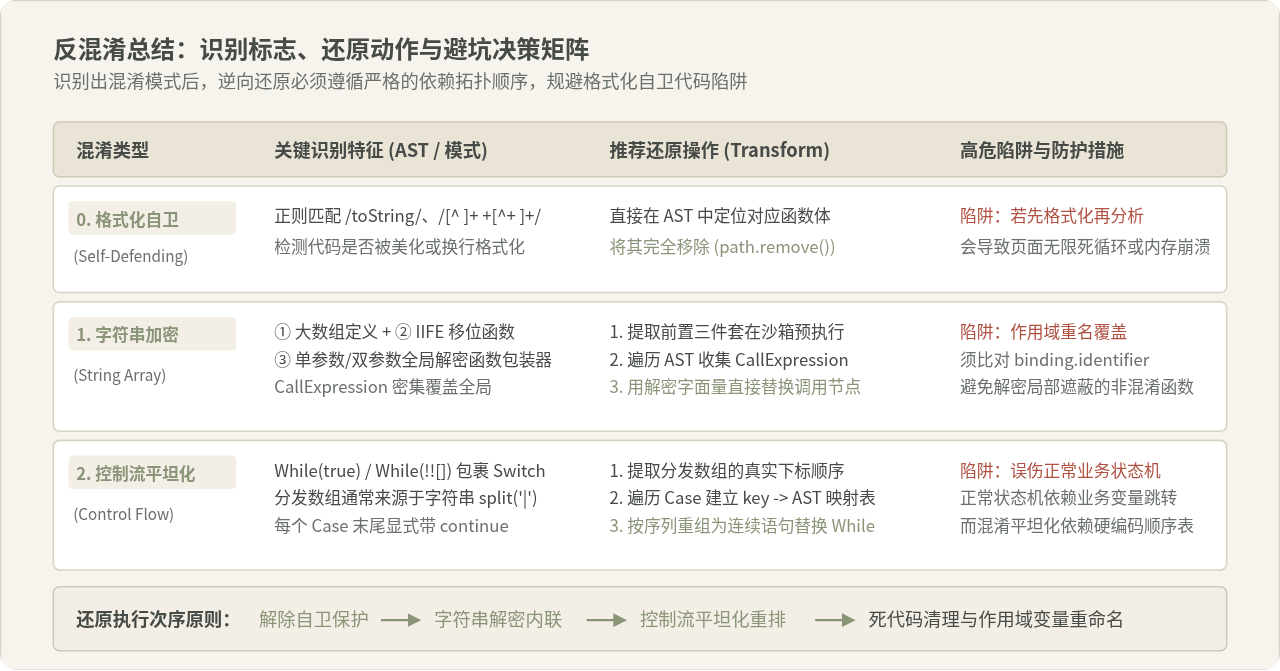
图 4:反混淆识别特征、还原步骤与避坑决策全景图
1. 为什么必须先解密字符串、后还原控制流?
控制流平坦化的分发器字符串(如 '3|1|0|4|2')本身往往也是被字符串加密函数保护的。如果先尝试还原控制流平坦化,分发器在 AST 中表现为一个函数调用 _0x2e8a('0x5'),无法在静态层面解析出执行序列 ['3','1','0','4','2']。因此,必须优先在 AST 中将所有字符串解密函数求值并替换为纯字面量,解开分发数组后,再进行分支重排。
2. 必须警惕的高危陷阱:自卫代码(Self-Defending)
绝大部分应用了控制流平坦化与字符串加密的代码,都会植入防格式化自卫代码。其识别标志是:脚本中存在检测函数通过 Function.prototype.toString() 或正则测试 /[^ ]+ +[^+ ]+/ 验证代码是否被美化、换行。
如果在还原分析之前使用了 IDE 的一键格式化(Prettier 等),代码一旦在 Node.js 或沙箱中运行,就会触发死循环,导致内存占满溢出。因此,在提取大数组和 IIFE 进入 Node.js 沙箱执行字符串初始化之前,必须先在 AST 中静态定位并移除自卫函数调用。
3. 总结与规范流程
系统化识别与还原 JavaScript 核心混淆的标准化执行链条如下:
- 定位并清除自卫代码:静态移除检测
toString与控制台防调试(debugger)的独立代码块。 - 提取字符串环境在沙箱求值:在独立的无宿主风险环境中执行大数组定义与 IIFE 移位函数,初始化解密函数。
- AST 内联字面量:遍历全代码树,把所有匹配解密函数的
CallExpression替换为对应解密后的StringLiteral。 - 重组平坦化控制流:读取已内联的分发序列数组,按索引将
SwitchCase中的语句顺序拉平,构建新的BlockStatement替换外层WhileStatement。 - 死代码消除与变量重命名:清理失去引用的平坦化循环变量及无用的大数组,恢复清晰易读的业务源代码。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章