

深入剖析JavaScript表单序列化过程中中文乱码的产生根源,提供覆盖前端编码规范、HTTP请求头设置、服务端字符集对齐的全链路解决方案与排查流程。
JS表单序列化出现中文乱码怎么解决
作者:工具松鼠
时间:2026-11-05
浏览:571
文章目录
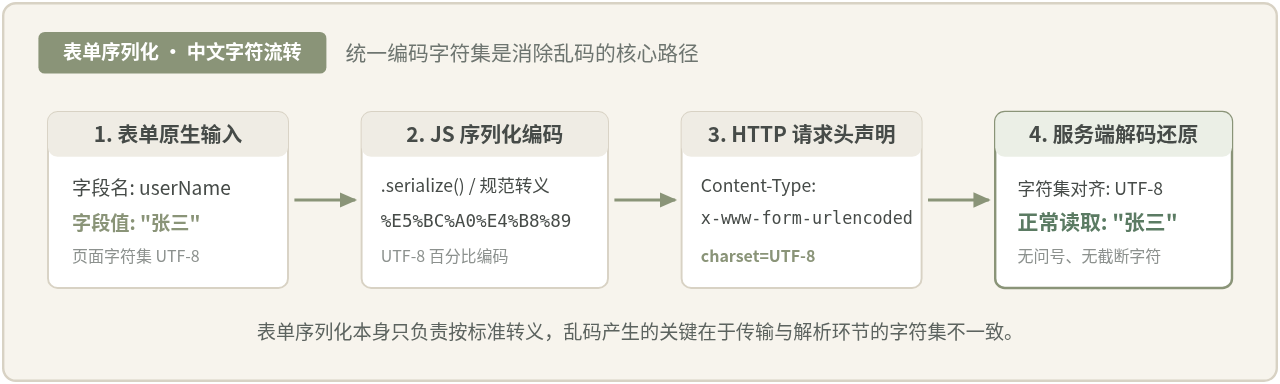
图 0:JavaScript 表单序列化全链路数据与字符集对齐缩略图
JavaScript 表单序列化出现中文乱码,核心原因几乎从来不是“序列化方法本身损坏”,而是前端将表单内容转化为 UTF-8 百分比编码(Percent-Encoding)后,服务端在接收时却使用了不匹配的字符集(例如默认的 ISO-8859-1 或 GBK)进行反序列化;或者前端页面本身未声明 UTF-8 导致提取字符时源头失真。解决这一问题的根本路径非常直接:统一 HTML 页面源头字符集为 UTF-8,使用规范的序列化 API,并在 HTTP 请求头显式附带字符集声明,同时配置服务端解析容器的编码规则,使全链路编码严格对齐。
一、现象与根因:序列化后的中文到底经历了什么
在网页开发中,表单序列化指的是将表单控件内的键值对转换为可供网络传输的字符串,最常见的标准格式是 application/x-www-form-urlencoded。
例如在页面输入姓名“张三”,执行序列化操作后,字符串通常呈现为 userName=%E5%BC%A0%E4%B8%89。
很多开发者看到这串带有百分号的字符时,会误以为程序已经出现了乱码。事实上,这是符合 RFC 3986 规范的百分比编码(Percent-Encoding)。
在标准 UTF-8 字符集中,每个常规汉字通常占用 3 个字节,“张”的十六进制编码是 E5 BC A0,“三”的十六进制编码是 E4 B8 89。
序列化程序将其转换为 %E5%BC%A0%E4%B8%89 是完全正确的行为。
真正的乱码出现在服务端“还原”这串数据的时刻。当服务端收到 %E5%BC%A0%E4%B8%89 后,需要按照特定字符集将这些字节还原为字符。
如果服务端框架(例如早期的 Tomcat 连接器或未加配置的 Servlet 容器)默认使用单字节的 ISO-8859-1 解码,它会把每个字节当作一个独立字符读取,最终拼接出类似于 å¼ ä¸ 的无意义符号;如果服务端误以 GBK 双字节编码解析 3 字节的 UTF-8 数据,就会出现 锟斤拷 或者成对的错位怪字。
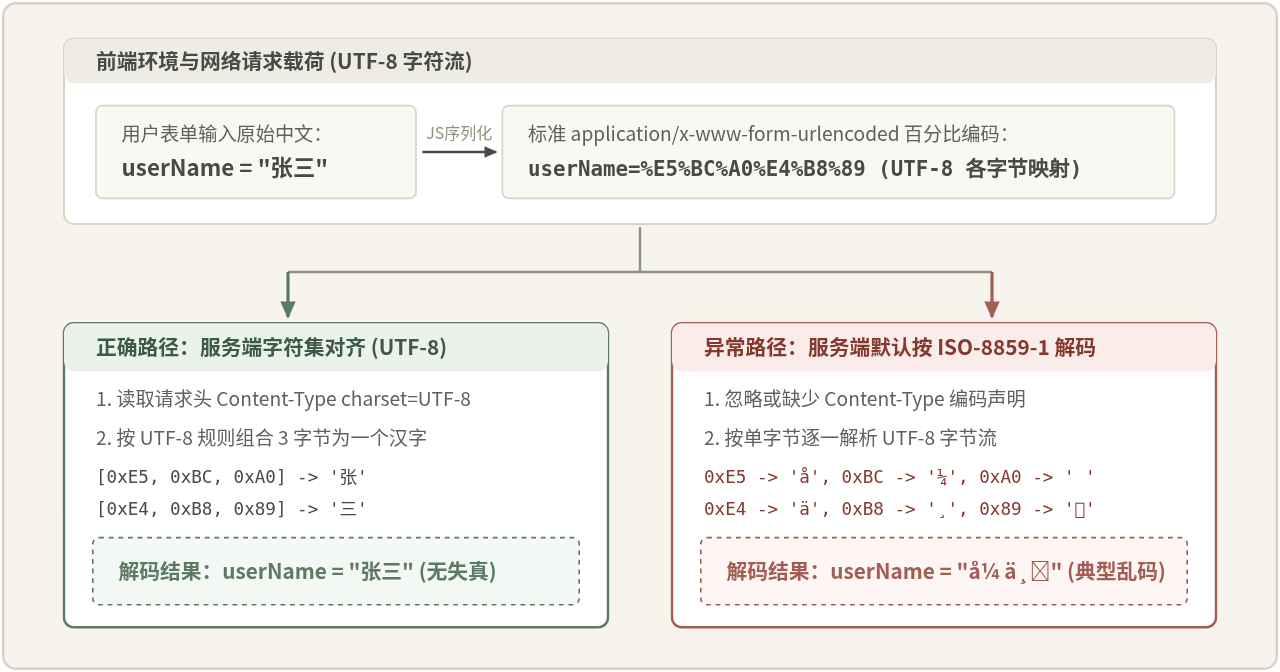
图 1:表单序列化中文字符流转与服务端解码分歧机理图
二、认知误区辨析:常见但容易混淆的说法
在排查表单乱码时,网络上常流传一些“偏方”。这些做法往往在特定遗留场景下能够凑效,但如果不了解其成立的前提,容易引入更隐蔽的代码隐患。
说法辨析一:“序列化后出现百分号就是乱码,需要用 decodeURI 解回来再提交”
分析与修正:这种说法混淆了“URL 百分比转义”与“乱码”。
HTTP 协议规定,URL 中的 Query 参数以及 application/x-www-form-urlencoded 格式的主体,非 ASCII 字符必须转义为 %XX 形式。
如果前端强行用 decodeURI 或 decodeURIComponent 将序列化字符串解码成中文明文后再发送,
不仅破坏了序列化格式规范,当字符串中包含 & 或 = 等关键分隔符时,还会直接造成参数解析错位。
保留百分比编码格式并交给服务端由框架自动解码才是标准流程。
说法辨析二:“用 encodeURIComponent 对中文做两次编码就能彻底解决乱码”
分析与修正:为什么 encodeURIComponent(encodeURIComponent(str)) 常常“看似有效”?
因为第一次编码将“张”转为 %E5%BC%A0,第二次编码将百分号 % 转成了纯 ASCII 码 %25,整串内容变成 %25E5%25BC%25A0。
在请求到达服务端时,即使 Tomcat 等容器默认按 ISO-8859-1 解码,由于全都是英文字符与百分号,它只解开了第一层,将 %25 还原为 %,
在 Java 中变量拿到的恰好是 %E5%BC%A0。此时开发者再在业务代码中手动调用一次 URLDecoder.decode(param, "UTF-8"),就绕过了容器的错误解码。
结论:这是一种典型的“用绕道掩盖容器配置缺陷”的妥协方案。它要求前后端双方写死两次编码和一次手动解码的耦合逻辑,增加了维护成本。 在现代项目中,直接通过配置统一前后端字符集为 UTF-8 才是正规解决方案。
说法辨析三:“escape()、encodeURI() 和 encodeURIComponent() 可以随意替换”
分析与修正:这是早期前端最常见的错误。
escape() 是已被废弃的标准,它对中文字符采用 %uXXXX 的 Unicode 格式转义,后端标准 URL 规范解析器无法识别此格式;
encodeURI() 用于对完整 URI 转码,它不会转义 ?、&、=、/ 等保留字符;
而 encodeURIComponent() 专门针对单一参数值进行编码,会将包含在参数内的特殊分隔符完整转义。
因此在手动处理表单序列化时,单个键值必须使用 encodeURIComponent()。
三、排查与定位:四个步骤锁定问题环节
当出现中文乱码时,按照从“输入端”到“服务端”的数据流动顺序排查,可以迅速定位问题出现在前端、传输层还是后端配置。
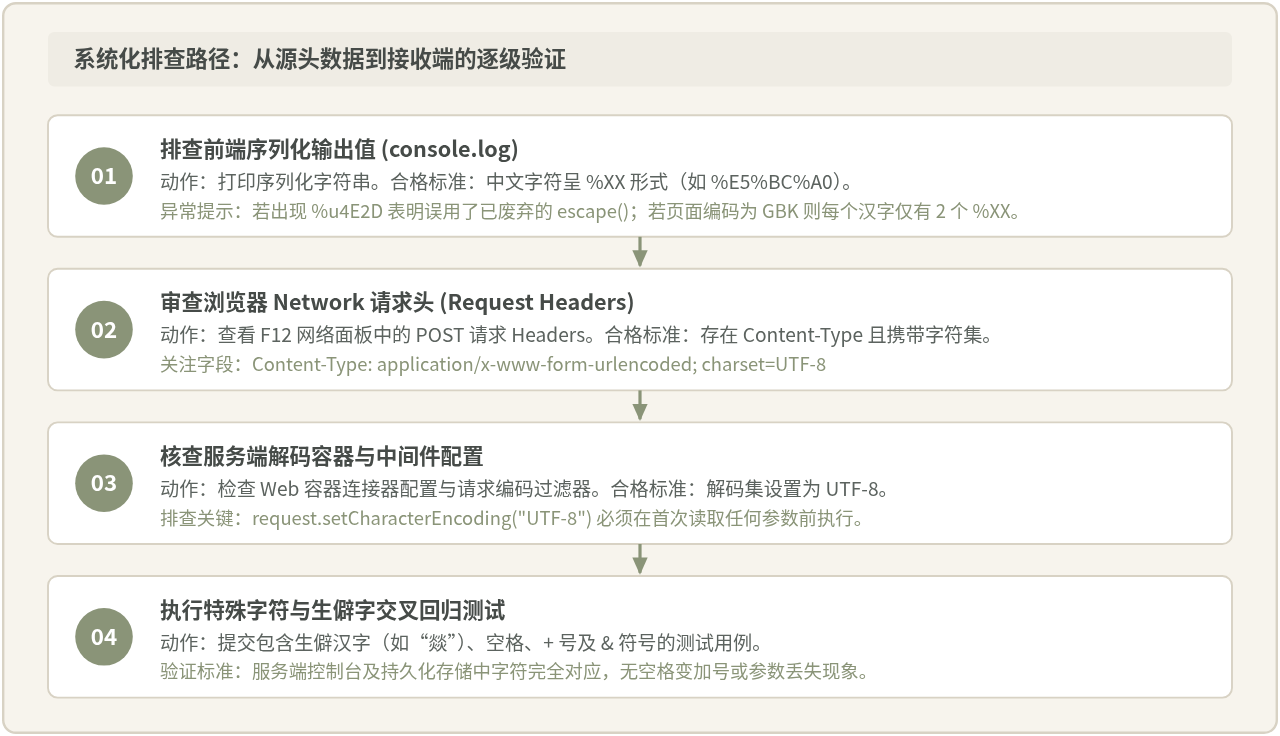
图 2:JS 表单序列化中文乱码四步排查与定位操作流程图
四、解决方案:从前端到后端的完整修复实践
要彻底杜绝表单序列化乱码,应当遵循“全链路统一 UTF-8”的原则。以下按照系统层级给出具体的操作方案与代码示例。
1. 前端基础配置:确保 HTML 文档编码
浏览器在读取 DOM 文本和表单值时,依赖当前网页文档的字符集。如果 HTML 页面本身以 GBK 载入,序列化函数可能产生 GBK 编码的转义序列。
确保在 HTML 的 <head> 标签内部第一行声明:
<!DOCTYPE html>
<html lang="zh-CN">
<head>
    <meta charset="UTF-8">
    <title>用户表单提交</title>
</head>
2. 前端序列化方式选型与正确实现
针对不同的技术栈,应选用符合规范的序列化实现方式。
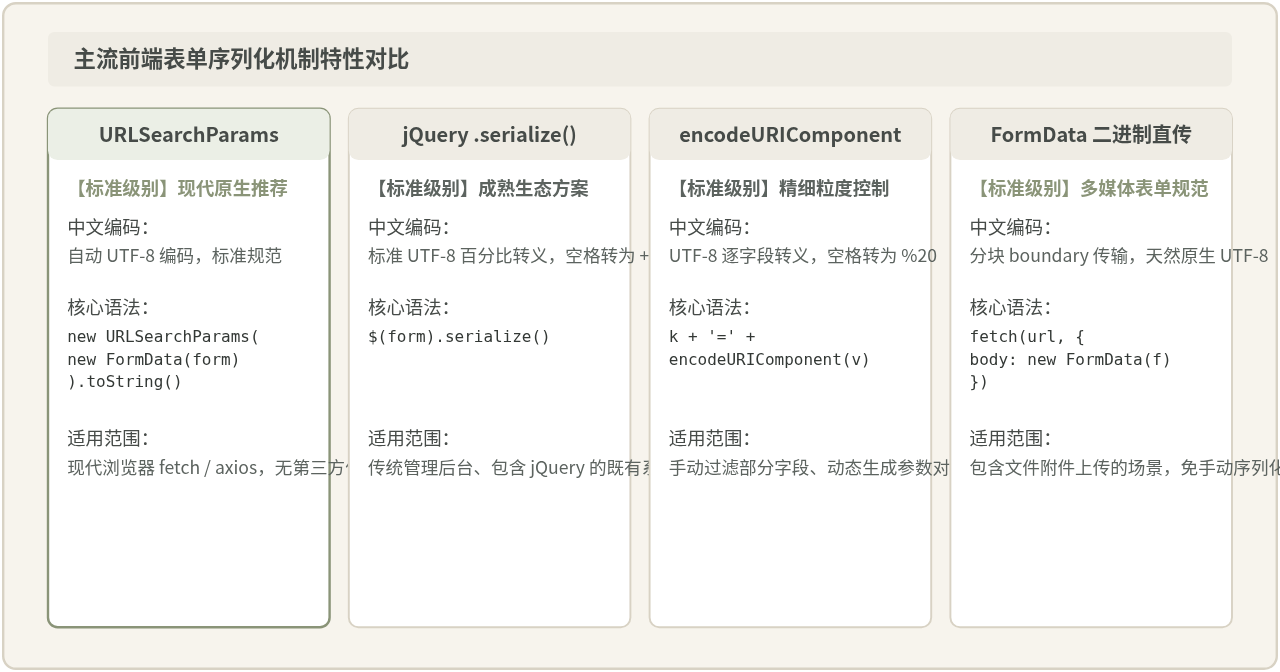
图 3:主流前端表单序列化方案及中文处理特性对比
原生 JavaScript 推荐方案 (URLSearchParams)
// 获取表单 DOM 元素
const formElement = document.querySelector('#userForm');

// 1. 将表单包装为 FormData
const formData = new FormData(formElement);

// 2. 转换为标准 URL 编码查询参数字符串 (自动完成 UTF-8 百分比转义)
const serializedData = new URLSearchParams(formData).toString();

// 3. 通过 Fetch 发送请求,显式在请求头声明 charset=UTF-8
fetch('/api/user/save', {
    method: 'POST',
    headers: {
        'Content-Type': 'application/x-www-form-urlencoded; charset=UTF-8'
    },
    body: serializedData
})
.then(response => response.json())
.then(result => {
    console.log('提交成功:', result);
});
jQuery 项目中的规范写法
在 jQuery 项目中,$.serialize() 内部会自动按照 UTF-8 转码。关键在于 $.ajax 的请求参数配置:
$('#userForm').on('submit', function(e) {
    e.preventDefault();

    // 序列化表单
    const serializedData = $(this).serialize();

    $.ajax({
        url: '/api/user/save',
        type: 'POST',
        data: serializedData,
        // 关键点:显式声明 contentType 及其字符集
        contentType: 'application/x-www-form-urlencoded; charset=UTF-8',
        success: function(res) {
            console.log('保存成功');
        }
    });
});
3. 服务端解码对齐与配置
不论前端传递的数据多么规范,如果服务端未明确指定解码编码集,依然会出现乱码。根据服务端语言与框架,执行对应的配置:
Java / Spring Boot 环境
在传统 Java Web 应用中,必须在首次调用 request.getParameter() 之前设置字符集。在 Spring Boot 项目中,通常由 CharacterEncodingFilter 统一管理:
// application.properties 配置统一字符过滤
server.servlet.encoding.charset=UTF-8
server.servlet.encoding.enabled=true
server.servlet.encoding.force=true

// 若为原生 Servlet,在 Filter 中拦截设置
public void doFilter(ServletRequest req, ServletResponse res, FilterChain chain)
        throws IOException, ServletException {
    req.setCharacterEncoding("UTF-8");
    res.setCharacterEncoding("UTF-8");
    chain.doFilter(req, res);
}
Node.js / Express 环境
Express 内置的 express.urlencoded 中间件默认采用 UTF-8 解析 URL 编码的表单数据:
const express = require('express');
const app = express();

// 解析 x-www-form-urlencoded 请求体,默认使用 UTF-8
app.use(express.urlencoded({ extended: true }));

app.post('/api/user/save', (req, res) => {
    // req.body.userName 将直接获取到正确的中文明文 "张三"
    console.log('接收到用户名:', req.body.userName);
    res.json({ status: 'ok' });
});
Python / Flask 环境
Werkzeug 与 Flask 默认以 UTF-8 解码 request.form:
from flask import Flask, request, jsonify

app = Flask(__name__)

@app.route('/api/user/save', methods=['POST'])
def save_user():
    # request.form 自动完成 UTF-8 解码
    user_name = request.form.get('userName', '')
    return jsonify({"received": user_name})
五、全链路解决方案与验证清单
在实际工程落地时,可以依照下述四个阶段进行复查。保证每一层都遵循 UTF-8 规范,即可彻底根除乱码隐患。
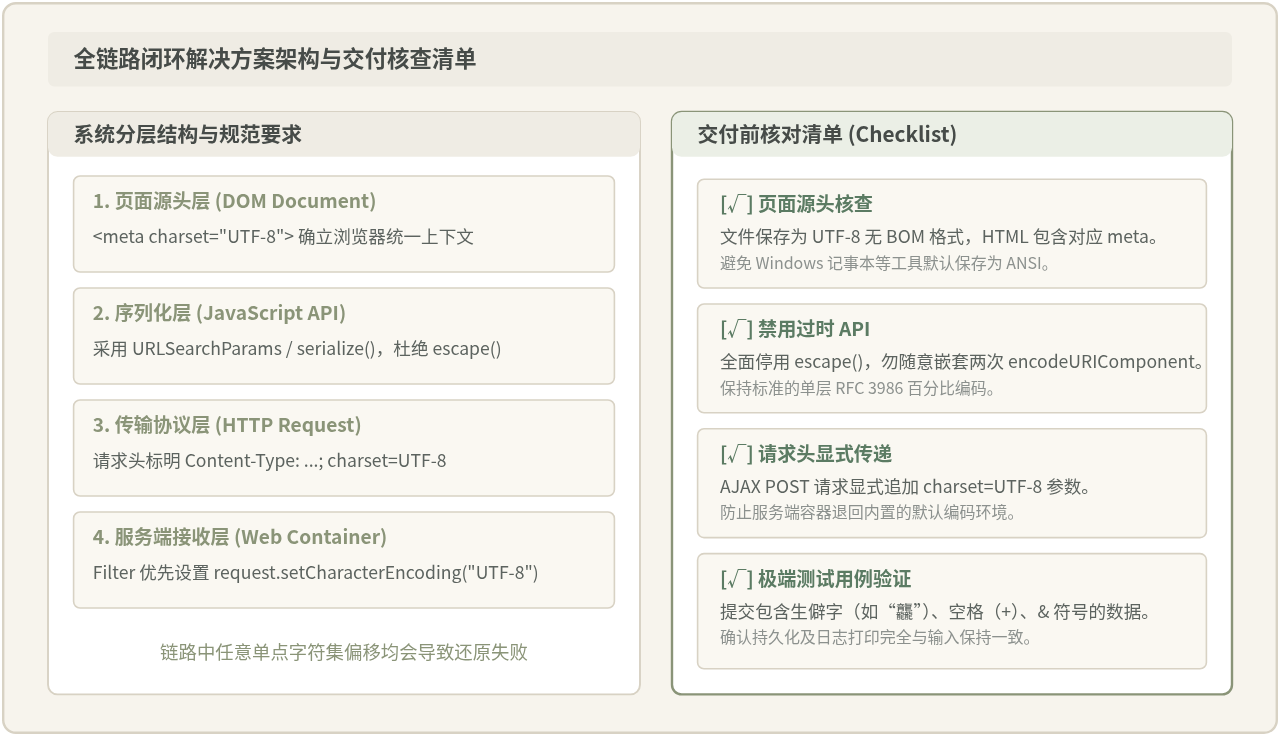
图 4:全链路解决方案架构与工程交付核对清单
如何验证问题已经彻底解决
在完成前后端调整后,建议使用包含不同特征的中文字符组合进行回归验证:
- 常见汉字与生僻字组合:例如输入
测试用户·䶮燚,验证 UTF-8 多字节序列(包括 3 字节与 4 字节字符)是否能完整还原。 - 特殊边界符号:例如输入
研发部 & 运营部 (北京+上海),验证序列化过程是否正确保留了&和+,确认后端没有因字符转义发生参数截断或空格丢失。
如果在前端控制台、HTTP 抓包数据以及服务端业务代码中,字符的长度和字面值均完全一致,则表明该表单序列化通道已经彻底建立了标准的字符集对齐机制。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章