

深入解析 crypto-js 解密时抛出 Malformed UTF-8 data 异常或呈现乱码的根本原因,涵盖 WordArray 转换机制、密钥/IV 格式、填充模式对齐及端到端排查方案。
为什么 crypto-js 解密报错 Malformed UTF-8 data 或出现乱码
作者:白帽猫
时间:2026-11-03
浏览:398
文章目录
CryptoJS 故障诊断
核心答案:
Malformed UTF-8 data 异常并不是在 AES 解密计算阶段产生的,而是在执行 toString(CryptoJS.enc.Utf8) 解析字节流时触发的。解密过程中只要密钥、IV、加密模式、填充规则或密文格式有任意一项不匹配,AES 输出的就是一组伪随机字节;当解码器在这组随机字节中读到了不符合 UTF-8 编码规则的非法前导码或不完整的字节序列时,便会直接抛出此异常;若恰好碰巧能组成合法字节,则会解析为无法阅读的“乱码”。
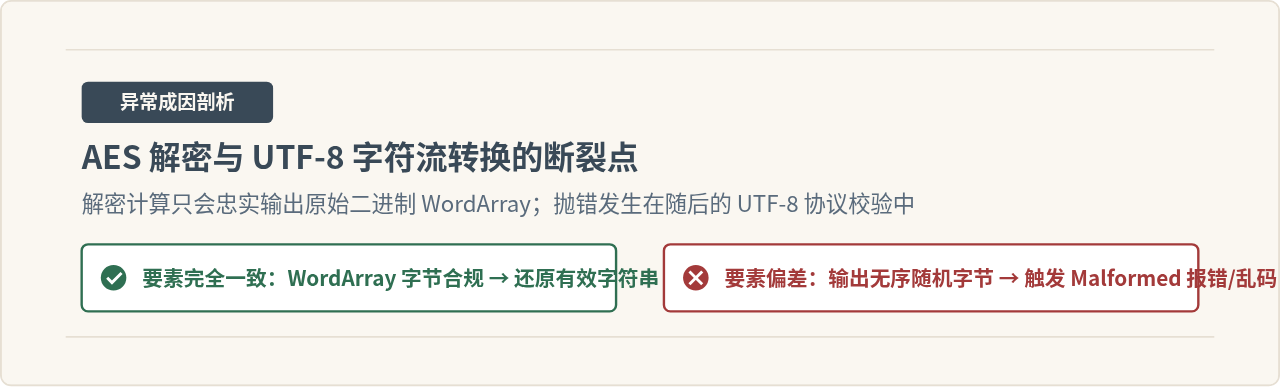
一、解密机制:从 WordArray 到 UTF-8 字符串
在使用 crypto-js 的日常开发中,许多开发者容易把 CryptoJS.AES.decrypt() 误认为是一个“直接返回明文字符串”的方法。在源码实现中,解密函数的返回值是一个内部自定义对象:WordArray(即 32 位整型字数组,对应底层的原始二进制字节序列)。
// 常见的调用方式
const decrypted = CryptoJS.AES.decrypt(ciphertext, key, config);
// 真正的报错点发生在这一行:
const plaintext = decrypted.toString(CryptoJS.enc.Utf8);
现代对称加密算法(如 AES)本质上只进行高强度的数学置换与扩散,它对字节所代表的实际语义一无所知。只要提供了密文,即使你给的密钥、IV 或者解密模式完全是错的,算法内部仍然能够机械地执行完矩阵置换并输出一段长度相仿的二进制字节。
当开发者接着调用 decrypted.toString(CryptoJS.enc.Utf8) 时,crypto-js 的 UTF-8 编码器开始逐字节检验字节序列是否符合 UTF-8 编码标准:
- 单字节字符(ASCII):首位必须为
0(范围0x00 - 0x7F)。 - 多字节字符(如汉字、Emoji):首字节必须是
110xxxxx、1110xxxx或11110xxx,且后续连续字节(Continuation Bytes)必须严格以10xxxxxx开头。 - 非法前导码:若首字节直接出现了
10xxxxxx或11111xxx,或者后续跟随字节不符合格式,UTF-8 规范就会判定为非法数据。
如果解密参数错误,还原出的就是杂乱无章的高熵随机字节。解码器在校验时发现不合规的字节分布,就会抛出致命错误:Error: Malformed UTF-8 data。如果这串随机字节极其巧合地能够全部对上 UTF-8 的字节格式,或者开发者使用的是宽容度较高的单字节编码(如 Latin1 / Hex),则不会报错,而是呈现为毫无意义的乱码符号(如 7d&)。
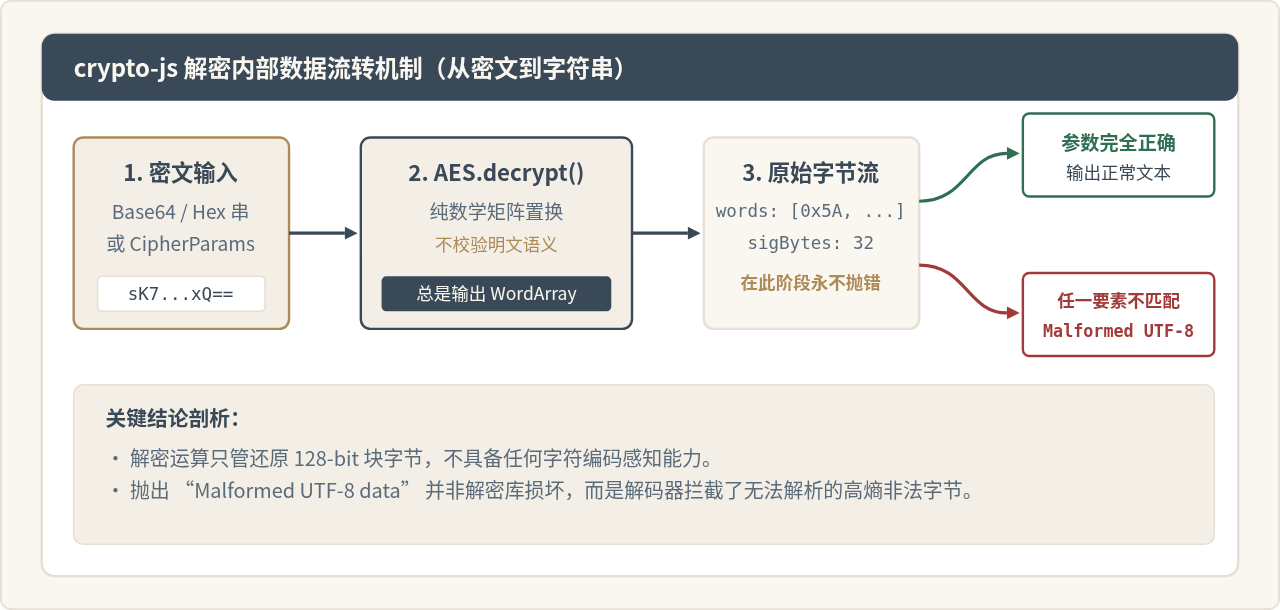
二、导致报错与乱码的五大根源
排查解密异常不能盲目修改代码。在绝大多数工程实践中,导致该问题的根源均集中在以下五个技术细节中:
1. 密钥(Key)或偏移量(IV)的编码解析方式错误
这是最常见但也最隐蔽的错误。在 crypto-js 中,直接传入字符串密钥与传入解析后的 WordArray 是两套完全不同的逻辑:
- 如果向
CryptoJS.AES.decrypt(ciphertext, "my-secret-key")直接传递普通字符串作为密钥,crypto-js会认为这是一个口令(Passphrase),并在底层自动使用 OpenSSL 风格的EvpKDF算法和随机盐值推导出一个实际密钥。 - 而后端(如 Java、Go、Python)通常直接将 16 字节或 32 字节的字符串按字节使用,即等价于:
CryptoJS.enc.Utf8.parse("16bytessecretkey")。
前后端若一方使用直接字符串派生,另一方使用原始字节,密钥将彻底不同,解密必败。
2. 加密模式(Mode)与填充算法(Padding)不一致
AES 作为分组密码,需要指定工作模式与填充方式:
- 模式不一致:例如后端使用
AES/ECB/PKCS5Padding,而前端crypto-js默认工作模式是CBC模式。CBC 模式强制要求提供 IV,若未对齐则首块或全块数据解密混乱。 - 填充不一致:Java 的
PKCS5Padding与crypto-js的CryptoJS.pad.Pkcs7在 128 位块大小下是完全等价兼容的;但若后端采用ZeroPadding或NoPadding,前端使用 PKCS7 则会在剔除尾部填充字节时发生越界或解析出脏字节,产生多余的尾部乱码。
3. 密文传输中的 URL 转义损坏
Base64 编码的密文字符串通常包含 +、/ 和 = 三种特殊符号。当密文通过 HTTP GET 请求的 URL 参数或未正确声明 Content-Type 的表单传递时:
- 浏览器或后端 Web 框架常会自动把
+替换为空格 - Base64 字符串一旦出现空格,字符序列遭到结构性破坏,导致 Base64 解码后的原始密文错位,进而导致解密出的数据全毁。
4. 密文格式处理失误:Hex 与 Base64 混淆
后端输出的密文通常为 Base64 格式或 16 进制(Hex)格式:
- 如果密文是十六进制字符串(如
"4a6f686e..."),直接传给CryptoJS.AES.decrypt()会被当作普通字符串或 Base64 解析,导致密文字节失真。 - 正确做法是显式转换为
WordArray:CryptoJS.enc.Hex.parse(hexCiphertext)。
5. 多语言实现间的默认参数冲突
不同语言环境的标准加密库默认行为截然不同。下表直观列出了各语言默认行为与 crypto-js 的差异:
| 运行环境 / 语言 | 常见默认模式 | 默认填充方式 | 常见对接隐患 |
|---|---|---|---|
| CryptoJS | CBC | Pkcs7 | 直接传字符串会触发 EvpKDF 口令派生 |
| Java (Cipher) | ECB (或平台相关) | PKCS5Padding | 默认无 IV,需显式声明 AES/CBC/PKCS5Padding |
| Go (crypto/cipher) | 无默认(需手写 CBC/GCM) | 需手动实现 PKCS7 填充 | Go 标准库不带 PKCS7 填充,容易手写出错 |
| Python (pycryptodome) | 需显式指定 | 需搭配 pad/unpad | key 与 iv 必须严格为 bytes 类型 |
| Node.js (crypto) | 显式指定(如 aes-128-cbc) | 默认 auto-padding: true | Buffer 处理与 Utf8 parse 映射问题 |
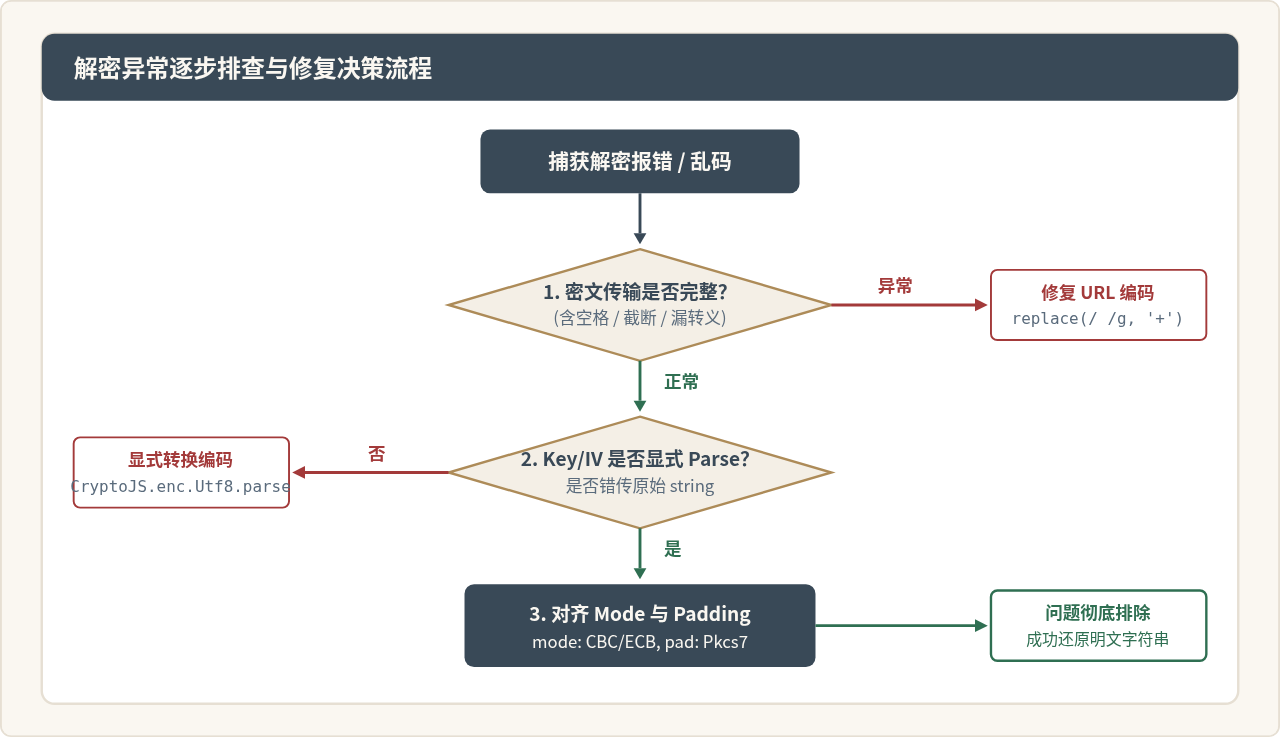
三、前后端对称加密的四要素对齐
为了从根本上消除解密异常,前端与服务端在实现加解密通信时,必须严格逐项核对以下四项配置:
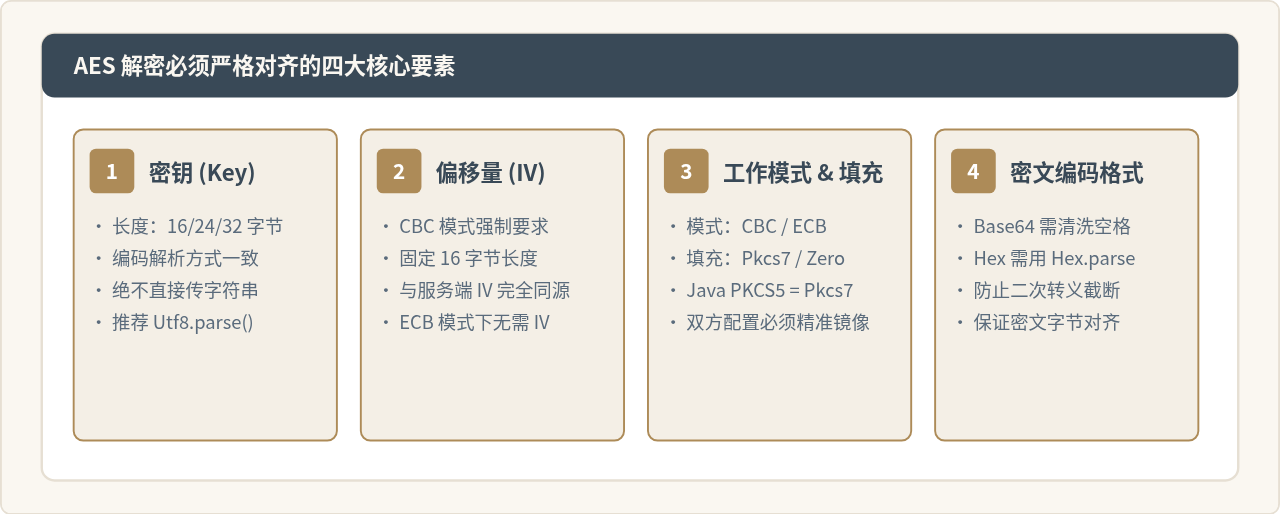
四、规范代码示例与健壮性处理
以下提供在生产环境中推荐的 crypto-js 完整解密实现,包含前置格式清洗与安全异常捕获机制:
import CryptoJS from 'crypto-js';

/**
 * 安全解密 AES 密文(CBC 模式 / Pkcs7 填充)
 * @param {string} rawCiphertext - 服务端返回的 Base64 密文
 * @param {string} rawKey - 16/24/32 字符的密钥
 * @param {string} rawIv - 16 字符的初始向量
 * @returns {string|null} 解密后的明文字符串;若失败返回 null
 */
export function safeDecryptAesCbc(rawCiphertext, rawKey, rawIv) {
  // 1. 密文清洗:纠正 URL 传输可能导致的 + 变空格问题
  if (!rawCiphertext || typeof rawCiphertext !== 'string') {
    console.error('密文格式无效');
    return null;
  }
  const cleanCiphertext = rawCiphertext.trim().replace(/\s/g, '+');

  // 2. 严格显式转换 Key 与 IV 为 WordArray,严禁直接传入原始字符串
  const key = CryptoJS.enc.Utf8.parse(rawKey);
  const iv = CryptoJS.enc.Utf8.parse(rawIv);

  // 3. 执行 AES 解密计算
  try {
    const decryptedWords = CryptoJS.AES.decrypt(cleanCiphertext, key, {
      iv: iv,
      mode: CryptoJS.mode.CBC,
      padding: CryptoJS.pad.Pkcs7
    });

    // 4. 重点:防御性执行 UTF-8 字符流转换
    const result = decryptedWords.toString(CryptoJS.enc.Utf8);

    // 5. 校验结果非空(防止极端情况下静默失败返回空字符串)
    if (!result && cleanCiphertext.length > 0) {
      console.warn('解密成功但明文为空,请排查填充模式或空明文');
    }
    return result;
  } catch (error) {
    // 捕获 Malformed UTF-8 data 异常,避免前端白屏崩塌
    console.error('解密失败(密钥不匹配或数据损坏):', error.message);
    return null;
  }
}
针对 Hex 格式密文的适配提示
如果服务端返回的是十六进制格式(Hex)密文,不能直接作为字符串传给 CryptoJS.AES.decrypt,应当先通过 CryptoJS.enc.Hex.parse(hexString) 转换为 WordArray,再构造 CipherParams 或转为 Base64 格式后传入:
const cipherParams = CryptoJS.lib.CipherParams.create({
  ciphertext: CryptoJS.enc.Hex.parse(hexCiphertext)
});
const decrypted = CryptoJS.AES.decrypt(cipherParams, key, { iv, mode, padding });
五、排查清单与避坑总结
当项目出现此类问题时,按以下清单可快速定位并彻底解决:
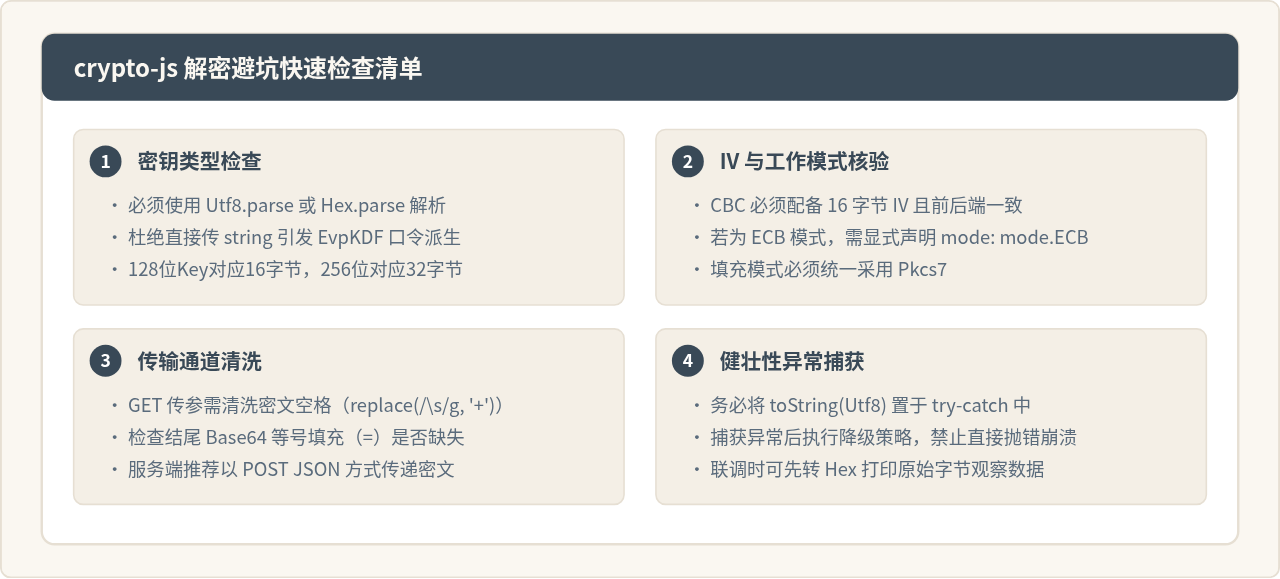
调试技巧:如何确认是密钥错误还是密文损坏?
如果在排查中不确定是密钥不对还是传输损坏,可以尝试将 decrypted.toString(CryptoJS.enc.Utf8) 改为 decrypted.toString(CryptoJS.enc.Hex):
toString(CryptoJS.enc.Hex)永远不会抛出Malformed UTF-8 data异常,因为它只是把每个字节忠实打印成十六进制。- 如果打印出来的 Hex 结尾是一连串连续相同的字节(例如
05 05 05 05 05或0a 0a ...),这说明 PKCS7 填充是完全正确的,很可能解密已经成功,只是原明文本身就不是 UTF-8 字符串;反之,如果结尾没有符合规律的填充字节,则 100% 说明密钥、IV、模式或密文本身不匹配。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章