

深入解析 JavaScript 中的 DOM 查询性能瓶颈,系统阐述缓存 DOM 引用、读写分离规避强制同步布局、离线批量修改及减少重排重绘的完整实践方案与避坑指南。
JS DOM查询性能优化:缓存引用与减少重排重绘
作者:白帽猫
时间:2026-11-03
浏览:528
文章目录
前端性能优化
浏览器渲染原理
技术领域:JavaScript / 网页渲染管线
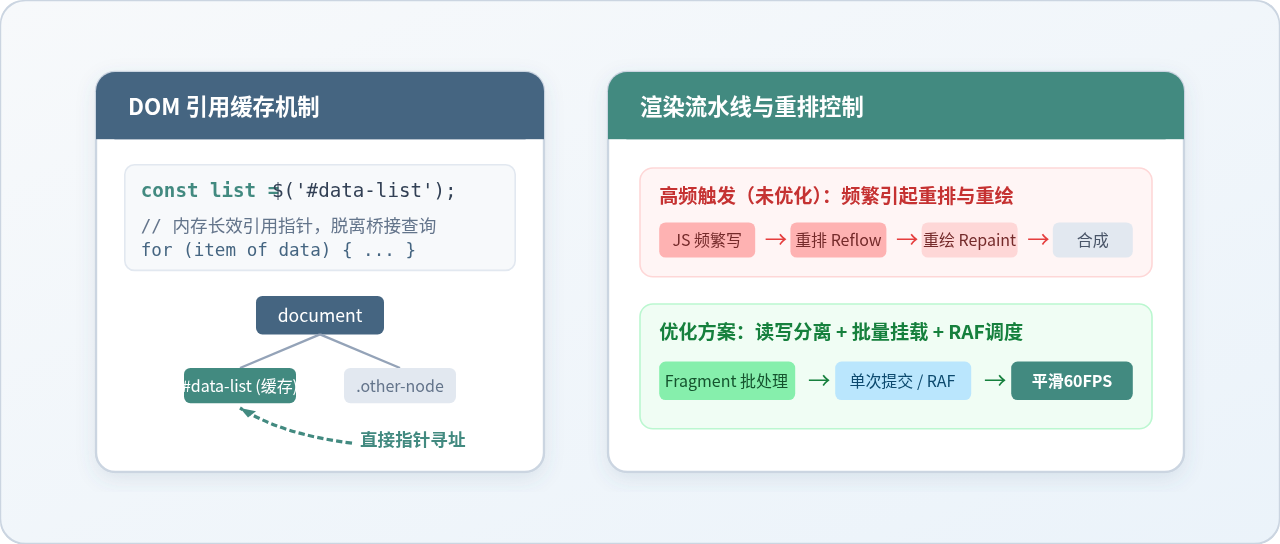
在前端界面开发中,DOM 操作往往是脚本执行耗时与主线程卡顿的最大来源。由于 DOM 并非存在于 JavaScript 引擎内部,每一次 DOM 访问都需要跨越 JS 引擎与浏览器渲染引擎的边界;而频繁修改几何样式或盲目读取排版属性,更会强行打断浏览器的批量渲染队列,引发昂贵的重排(Reflow)与重绘(Repaint)。本文针对这两个核心痛点,从底层机制剖析跨引擎桥接与渲染流水线,并给出缓存节点引用、集中读写分离、利用文档碎片批量更新等一套切实可行的工程优化方案。
一、为什么 DOM 操作如此昂贵:跨引擎桥接机制
许多初学者常误以为 DOM 节点就保存在 JavaScript 的本地作用域中,可以像普通 JS 对象一样以纳秒级速度任意读取。然而,以 Chrome(V8 引擎 + Blink 渲染引擎)或 Safari(JavaScriptCore + WebKit)为例,JavaScript 运行时环境与底层的 C++ DOM 树结构是两个完全独立的系统。
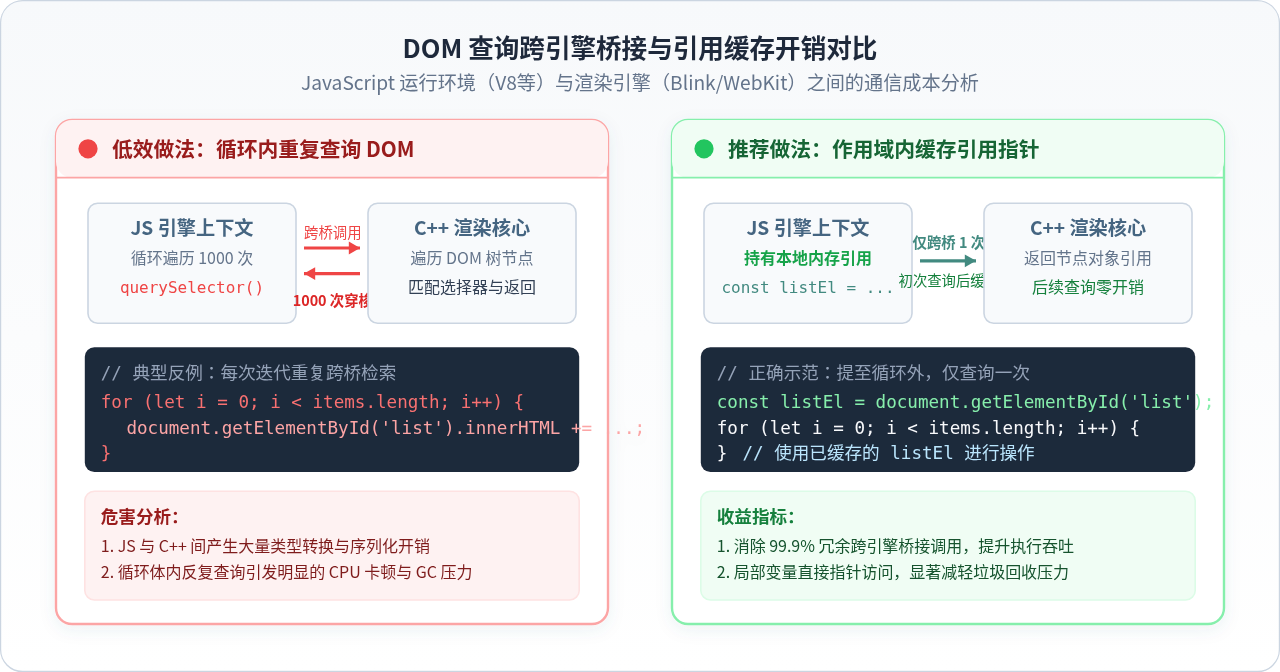
当我们在 JavaScript 中调用 document.getElementById('target') 或 document.querySelector('.item') 时,JS 引擎必须通过一层“C++ 桥接接口”(Bridge)向渲染引擎发起查询请求。渲染引擎需要解析选择器、沿着庞大的 DOM 树节点进行层级检索,然后包装成对应的宿主对象(Host Object)跨桥返回给 JS 引擎。
📌 跨桥通信的代价
每一次跨引擎调用,不仅伴随着参数校验与类型序列化转换,而且在处理类似 getElementsByTagName 这类动态 HTMLCollection 时,每次访问其 .length 属性都会重新遍历 DOM 树。如果将查询语句写在循环体内,跨桥惩罚就会被成百上千倍放大。
二、核心手段一:缓存 DOM 引用与减少重复查询
优化 DOM 查询的首要准则极其直观却至关重要:绝不在高频调用的函数或循环体内重复执行 DOM 查询。只要查询到的节点在生命周期内没有被彻底销毁重建,就应该在更高的作用域中将其指针缓存在变量中。
1. 典型的反模式与重构对比
在批量处理列表或高频事件监听中,最容易出现重复查询的典型代码如下:
// ❌ 严重低效:循环 1000 次,发生 1000 次 DOM 检索与跨桥通信
function renderBadList(dataList) {
  for (let i = 0; i < dataList.length; i++) {
    // 每次循环都在重新查询 #user-container,并频繁修改 innerHTML
    document.getElementById('user-container').innerHTML +=
      `<div class="user-card">${dataList[i].name}</div>`;
  }
}
通过在循环外部定义一个局部变量保存该节点指针,即可将 1000 次昂贵的查询骤降为 1 次:
// ✅ 高效做法:在外部缓存 DOM 引用,仅检索一次
function renderGoodList(dataList) {
  const container = document.getElementById('user-container');
  let htmlBuffer = '';

  for (let i = 0; i < dataList.length; i++) {
    htmlBuffer += `<div class="user-card">${dataList[i].name}</div>`;
  }
  // 一次性写入已缓存的容器
  container.innerHTML = htmlBuffer;
}
2. 选择器 API 选型建议
不同的 DOM 查询 API 在内部实现上的性能效率存在差异。对于可预知结构的查询,合理选择 API 能够进一步削减引擎消耗:
getElementById(): 底层维护了全局哈希映射表,检索时间复杂度接近 \(O(1)\),是定位单个具名元素最快的选择。getElementsByClassName()/getElementsByTagName(): 返回动态集合(Live HTMLCollection),查询速度优于选择器引擎,但需注意遍历时应缓存集合的length。querySelector()/querySelectorAll(): 支持复杂 CSS 选择器语法,但每次都要解析 CSS 语法树并进行节点匹配,返回的是静态 NodeList。在只需基于简单 ID 查询时,避免滥用querySelector('#id')。
3. 事件委托:减少深层子节点的反复查询与绑定
当界面中有成百上千个列表项需要响应点击时,逐一查询子元素并绑定事件不仅导致大量的查询开销,还会占用过量内存。利用事件冒泡机制,只需在父容器上绑定一次监听器,通过 event.target.closest() 匹配目标即可实现高效分发。
三、深入理解浏览器的重排(Reflow)与重绘(Repaint)
如果说 DOM 查询的开销在于跨引擎通信,那么修改 DOM 引发的重排与重绘则是造成页面掉帧、动画卡顿以及主线程阻塞的头号元凶。
1. 关键渲染路径(Critical Rendering Path)
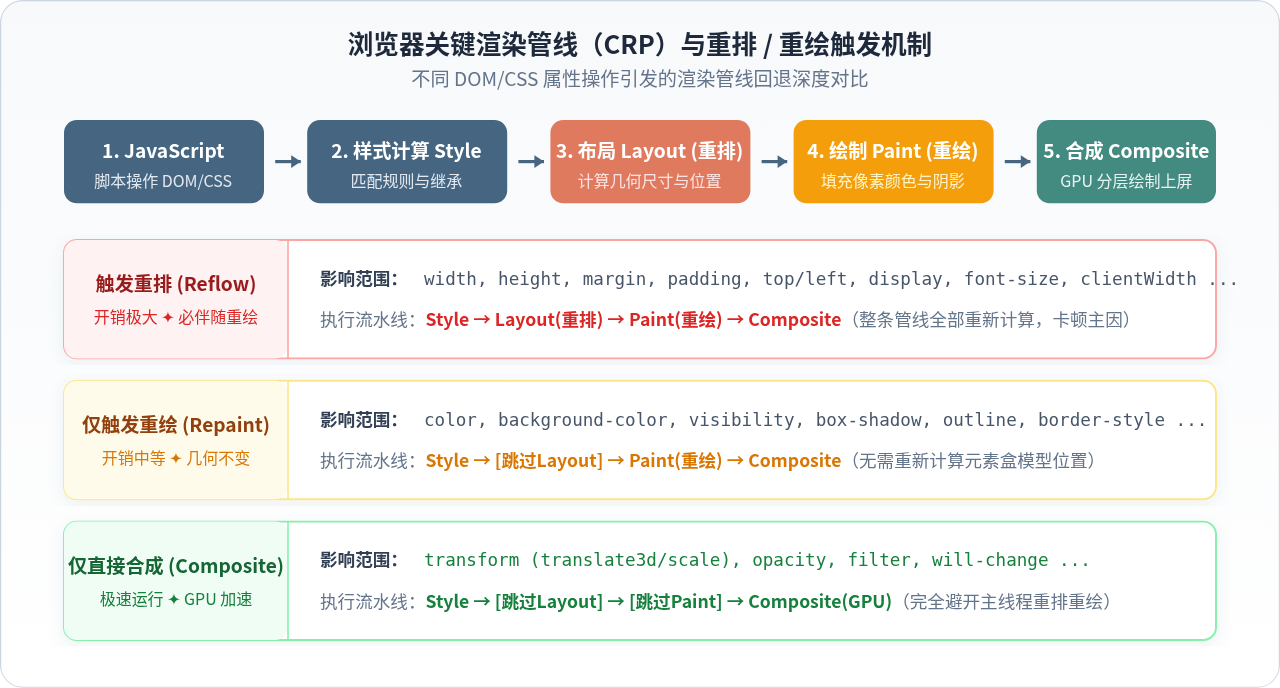
浏览器将 HTML 和 CSS 转换为屏幕像素的过程分为五个阶段:
- 解析构建: 解析 HTML 构建 DOM 树,解析 CSS 构建 CSSOM 树。
- 生成渲染树(Render Tree): 将 DOM 与 CSSOM 合并,剔除不可见元素(如
display: none),计算所有可见节点的计算样式。 - 布局(Layout / Reflow,重排): 计算每个可见节点在视口中的几何尺寸(宽、高)与具体屏幕坐标位置。
- 绘制(Paint / Repaint,重绘): 将节点的可见样式(文本、背景色、边框、阴影等)转换为具体的像素点绘制指令列表。
- 合成(Composite): 将页面划分的图层(Layers)提交给 GPU 线程,由 GPU 完成栅格化并最终输出到显示器。
2. 重排与重绘的核心区别
| 指标 / 概念 | 重排(Reflow / Layout) | 重绘(Repaint) |
|---|---|---|
| 本质定义 | 重新计算页面中元素的几何位置、盒模型尺寸与排版分布。 | 在几何空间不变的前提下,重新绘制元素的视觉外观像素。 |
| 连锁影响 | 级联效应强:一个元素的几何变动往往迫使父元素、兄弟元素及祖先元素全部重新排版。 | 局部影响:只更新受影响元素的绘制指令,不会波及周围元素的几何位置。 |
| 性能开销 | 极高(通常 5ms ~ 50ms+) | 中等(通常 < 5ms) |
| 两者的包含关系 | 关键定律:重排必然导致重绘,而重绘不一定会引起重排。 例如修改颜色只会触发重绘,修改宽度则会先触发重排、随后必然触发重绘。 | |
3. 致命杀手:强制同步布局(Forced Synchronous Layout)与布局抖动
为了提高性能,现代浏览器内部实现了一个异步渲染队列。当你通过 JavaScript 修改元素的样式(如 el.style.width = '200px')时,浏览器并不会立刻执行布局计算,而是将变更推入队列中,等待当前宏任务执行完毕或下一次屏幕刷新时合并批量处理。
然而,如果在修改样式后,脚本立刻请求读取元素的最新几何属性(例如 offsetHeight、clientWidth、getComputedStyle()),浏览器为了返回最新最精确的几何数值,就被迫立刻清空并强制冲刷当前的渲染队列,强行同步执行一次 Layout 计算。这种现象被称为“强制同步布局”。
// ❌ 布局抖动(Layout Thrashing)反例:在循环中交替读写几何属性
for (let i = 0; i < elements.length; i++) {
  // 1. 读:读取 offsetWidth 强行冲刷队列,触发同步重排
  const width = elements[i].offsetWidth;
  // 2. 写:推入样式变更队列
  elements[i].style.width = (width + 10) + 'px';
  // 下一次循环再次读时,浏览器又必须再重排一次!循环 N 次就重排 N 次!
}
⚠️ 会强制冲刷队列的常见 API 属性清单
只要在修改样式后调用以下属性或方法,就会引发强制同步布局,务必严加防范:
- 几何尺寸:
offsetTop,offsetLeft,offsetWidth,offsetHeight - 客户端区域:
clientTop,clientLeft,clientWidth,clientHeight - 滚动参数:
scrollTop,scrollLeft,scrollWidth,scrollHeight - 测量方法:
getBoundingClientRect(),getClientRects() - 计算样式:
window.getComputedStyle()
四、减少重排与重绘的核心实践方案
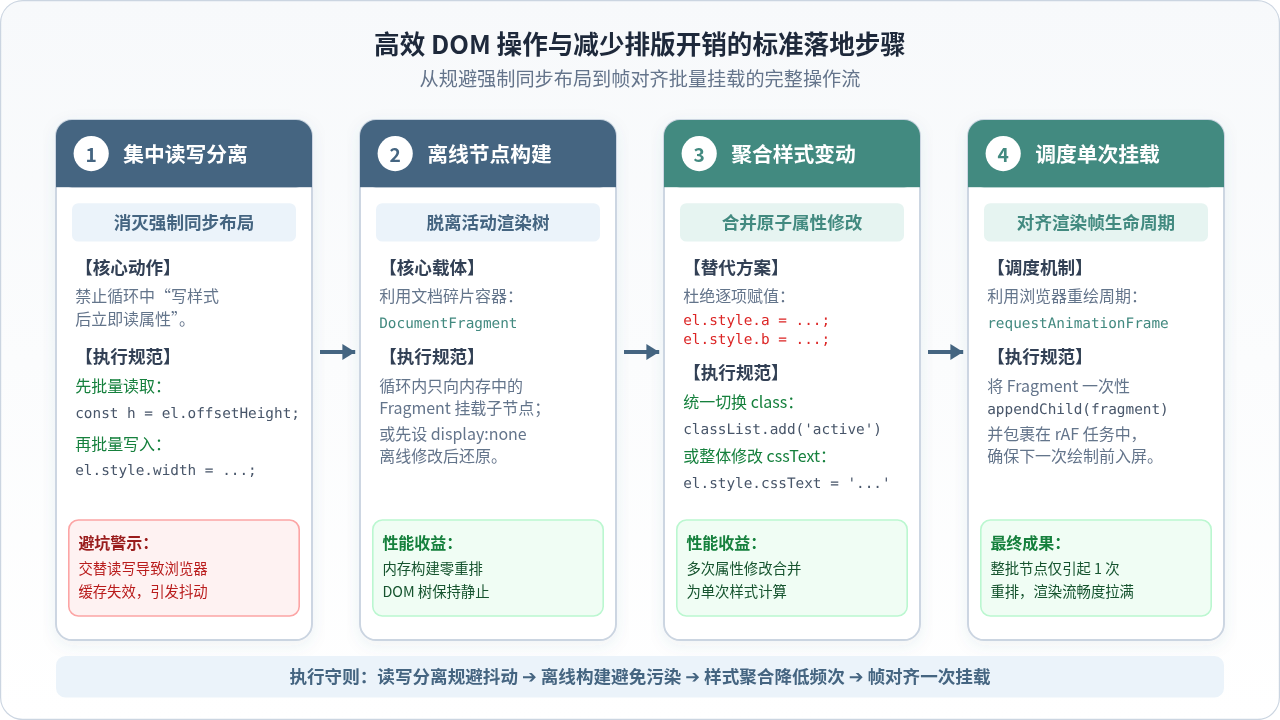
遵循一套规范的排版优化流程,能够彻底隔绝布局抖动并大幅精简浏览器的渲染开销。
-
集中读写分离(Phase Separation)
将所有针对几何属性的“读操作”集中在最前面一次性读完并保存在 JS 变量中,随后的“写操作”集中在后半段统一赋值。这样浏览器只需要在脚本执行完毕后进行单次批量排版,杜绝了反复冲刷队列的布局抖动。
// ✅ 读写分离改进:读写各自成批 // 1. 批量读取阶段 const widths = []; for (let i = 0; i < elements.length; i++) { widths.push(elements[i].offsetWidth); } // 2. 批量写入阶段 for (let i = 0; i < elements.length; i++) { elements[i].style.width = (widths[i] + 10) + 'px'; } -
使用 DocumentFragment 构建离线节点
如果需要向页面中动态插入 1000 个 DOM 节点,如果每次调用
parentElement.appendChild(newChild),都会导致活动 DOM 树发生一次结构变异。DocumentFragment是一个轻量级的脱机文档碎片容器。在内存中对它追加任意数量的子元素都不会影响可见的渲染树。当最后将其一次性挂载到目标父节点时,DocumentFragment的自身并不会被插入,只有其内部的所有子节点会被以单一原子的方式移入活动 DOM,整个过程仅触发一次重排。const fragment = document.createDocumentFragment(); for (let i = 0; i < 1000; i++) { const li = document.createElement('li'); li.textContent = `项目序号 ${i}`; fragment.appendChild(li); // 离线操作,零重排 } container.appendChild(fragment); // 单次原子插入,仅 1 次重排 -
聚合样式变更:合并 class 类名或使用 cssText
不要逐条修改多个行内样式属性。如果需要同时改变一个元素的位置、尺寸和边框,请将其封装在一个预先写好的 CSS 类名中,通过
classList.add('is-expanded')一次性应用;或者使用element.style.cssText进行单次覆写。 -
脱离文档流与借道 display: none
若必须对现有页面中复杂的 DOM 树进行大量频繁的节点调整或几何测试,可以先将其样式的
display设为none。处于display: none状态的元素会被彻底移出 Render Tree,在此期间对其进行的成百上千次修改均不会触发全局排版计算,修改完毕后再恢复为可见,从而将多次重排锁死在两次切换之中。 -
利用 GPU 合成加速属性与 requestAnimationFrame
对于位移动画与缩放过渡,务必优先采用
transform: translate3d()、scale()以及opacity属性。如我们在图 2 中所展示的,修改这些属性完全跳过了布局(Layout)与绘制(Paint)阶段,直接在合成线程(Compositor Thread)上调用 GPU 计算,能够稳定跑满 60FPS 或 120FPS 的高刷新率。
五、优化实战验证:DevTools Performance 性能面板对比
要验证优化策略是否真正生效,最可靠的手段是使用 Chrome DevTools 的 Performance(性能) 面板进行帧录制分析。
🔍 观测与诊断指标
打开 DevTools,切换至 Performance 标签页,点击 Record 录制一段 DOM 频繁更新的交互行为:
- Main 主线程火焰图: 如果出现密集的紫色长条(标记为
Layout或Recalculate Style),并且下方带有红色的右上角小三角形报警,展开后提示 “Forced reflow is a likely bottleneck”,即证明代码中存在强制同步布局与布局抖动。 - 帧率波形图(FPS): 绿色波形骤降至红色区间表示发生了掉帧,对应时间线下方通常会显示长任务(Long Task,超过 50ms)。
- 优化后形态: 密集的紫色 Layout 碎块应当消失,合并为一个极窄的单次 Layout 任务,FPS 波形保持稳定在 60fps 水平线,主线程耗时大幅缩减 80% 以上。
六、DOM 性能优化决策全景与避坑指南
为了在实际架构中快速进行技术选型,我们可以将 DOM 查询与变更的全部优化策略归纳为以下决策矩阵:
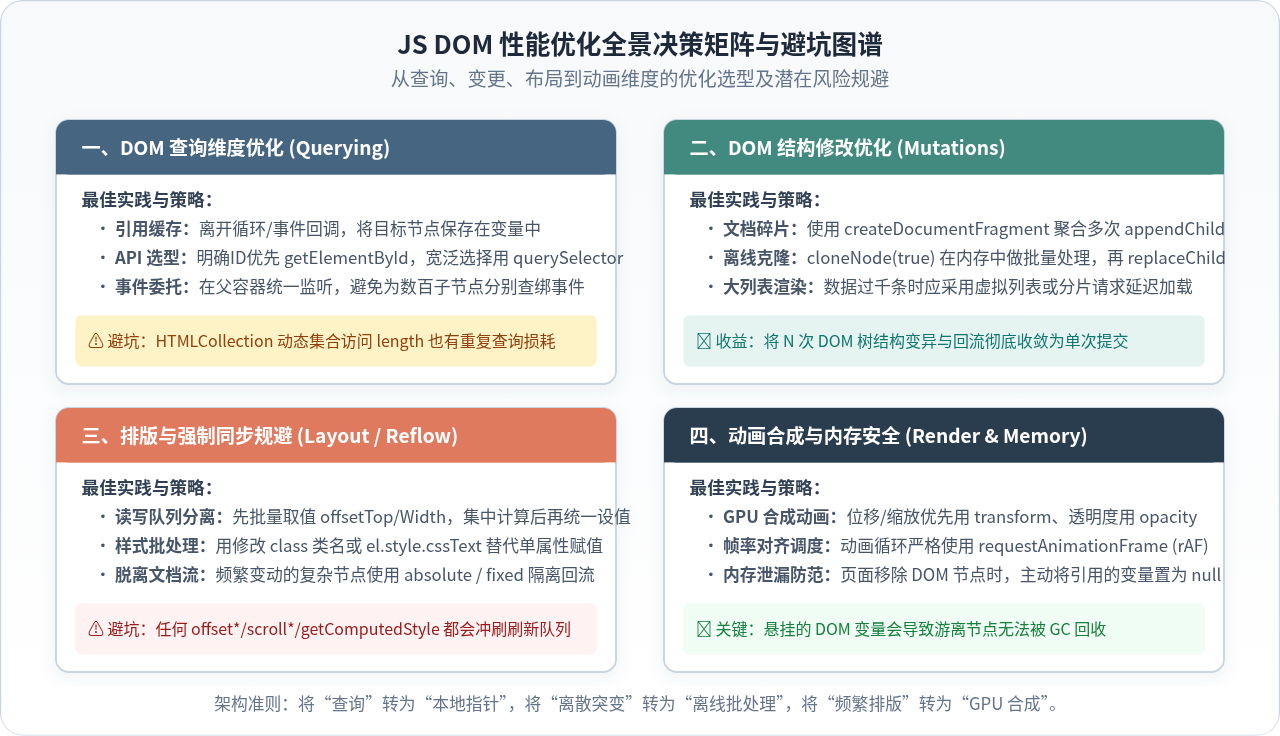
重要的内存安全警示:悬挂引用与游离 DOM 泄漏
缓存 DOM 引用虽然消除了跨桥通信损耗,但在单页面应用(SPA)中必须格外注意内存生命周期:
- 游离 DOM 节点(Detached DOM Tree): 当某个元素已被从页面的活动 DOM 树中移除(例如组件卸载、页面路由切换),如果 JavaScript 的全局变量或未销毁的闭包依然持有着该元素的引用指针,该元素及其拥有的所有子节点就无法被浏览器的垃圾回收器(Garbage Collector)回收。
- 治理规范: 在组件销毁阶段(如 React
useEffect cleanup、VuebeforeUnmount)或移除节点后,必须将对应的 DOM 变量显式置为空:cachedNode = null,同时解绑关联的事件监听器。
总结
DOM 查询与更新优化的核心逻辑非常纯粹:把查询降到最低,把变动集中处理,把动画交给 GPU。在编写任何一段涉及界面的逻辑时,时刻牢记将 DOM 节点引用保存在局部作用域内;对样式与几何信息的修改保持严格的“先集中读取、后集中写入”;善用 DocumentFragment 与现代 CSS 合成属性。通过这几项基础而强韧的工程习惯,就能从根本上消灭浏览器的布局抖动与重排卡顿,让 Web 应用保持平滑高效的响应体验。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章