

深入解析如何在JavaScript中运用尾调用优化(TCO)与记忆化(Memoization)消除递归性能瓶颈:通过累加器与蹦床函数将空间复杂度降至O(1)消除调用栈溢出,通过哈希查表消除重复子问题将时间复杂度降至O(N),附完整工程代码与选型决策指南。
怎么利用尾调用优化和记忆化提升JS递归效率
作者:白帽猫
时间:2026-11-03
浏览:363
文章目录
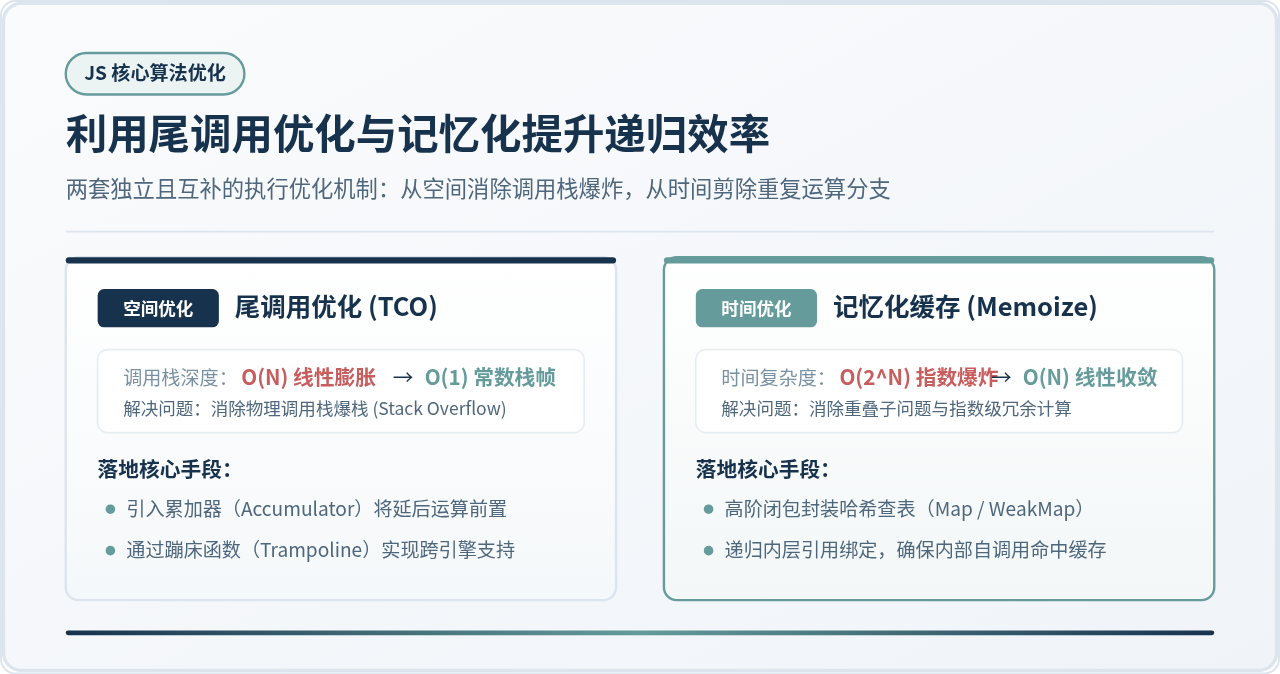
提升 JavaScript 递归效率的核心路径有两个维度:空间维度的“尾调用优化”(Tail Call Optimization, TCO)与时间维度的“记忆化”(Memoization)。普通递归容易遇到两个致命瓶颈——调用栈无限累加导致的栈溢出(RangeError: Maximum call stack size exceeded),以及分支重叠子问题导致的指数级耗时(O(2^n))。针对空间爆栈,核心做法是通过累加器将递归推演状态向前传递,并结合蹦床函数在主流引擎中消除物理调用栈;针对时间耗竭,核心做法是通过高阶函数与哈希查表缓存分支结果,将指数树剪枝为线性链路。
一、识别 JS 递归的两大性能杀手
在 JavaScript 中编写算法或业务逻辑时,递归是一种极具表达力的代码组织方式。无论是遍历嵌套树形结构、深拷贝复杂对象,还是实现动态规划算法,递归都能让逻辑贴近数学归纳法。然而,未经优化的递归在 V8、JavaScriptCore 等引擎中极易遭遇性能滑铁卢,其根本原因源于两个物理层面的约束:
-
物理调用栈的线性膨胀(空间开销瓶颈):每次函数调用时,JavaScript 引擎都需要在执行栈(Call Stack)上开辟一个独立的执行栈帧(Stack Frame),用于保存当前函数的作用域变量、参数以及返回地址。在普通递归中,外部函数必须等待内部调用的返回结果才能继续结算(例如
return n * factorial(n - 1)中的乘法操作),这导致各层栈帧不能被销毁,必须全部驻留在内存中。当递归深度达到一万层左右时,就会抛出致命的栈溢出错误:RangeError: Maximum call stack size exceeded。 -
重叠子问题的指数级重复求值(时间开销瓶颈):当递归函数包含多个分支递归调用时(例如多叉树搜索、斐波那契数列
fib(n - 1) + fib(n - 2)),递归调用图会演变为一棵庞大的递归树。大量子树的输入参数完全相同,却被完全重复地遍历计算。随着输入规模增大,计算耗时呈 O(2^n) 指数爆炸,导致主线程长时间被独占,页面出现卡顿甚至崩溃。
优化递归绝不能盲目下手,必须先看准瓶颈属于哪一类:若问题出在调用深度太深(空间爆炸),应选用“尾调用优化”;若问题出在计算分支重叠繁多(时间爆炸),则必须选用“记忆化”。
二、原理与对比:传统调用栈 vs 尾调用优化
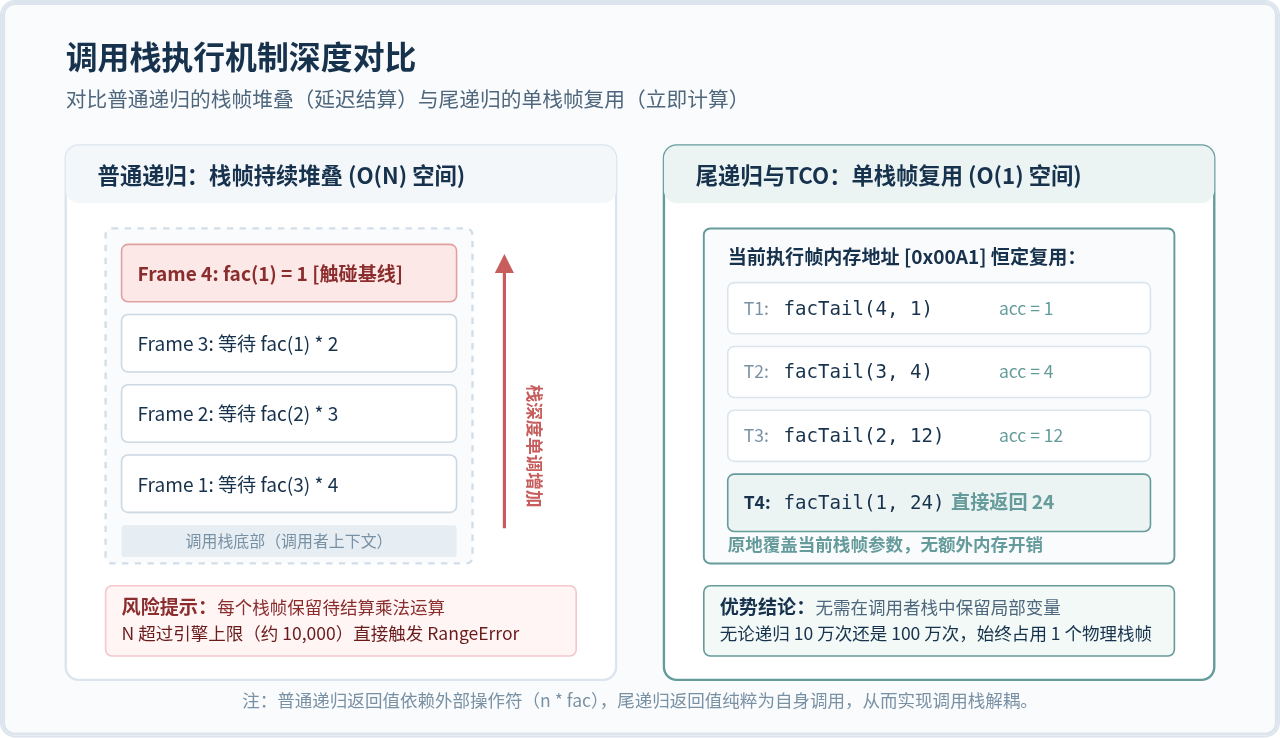
理解尾调用优化的前提是准确掌握什么是尾调用(Tail Call)。尾调用并非简单指“代码写在函数的最后一行”,而是指某个函数的最后一步操作是纯粹的函数调用,且该调用的返回值被直接当作当前函数的返回值,当前作用域内没有任何后续操作需要结算。
请看下面两段代码的本质区别:
// 【非尾调用】:最后一步操作是乘法操作符(*),当前函数必须保留自身栈帧以暂存 n 的值
function factorial(n) {
  if (n <= 1) return 1;
  return n * factorial(n - 1); // 必须等待 factorial(n-1) 返回后才能做乘法
}

// 【纯正尾调用】:最后一步只有函数调用,无需保留当前栈帧状态
function factorialTail(n, acc = 1) {
  if (n <= 1) return acc;
  return factorialTail(n - 1, n * acc); // 直接返回函数调用的结果
}
在左侧的普通递归中,计算 factorial(4) 时,调用栈中会同时存在 4 个活跃栈帧;如果计算 factorial(100000),栈深度就是 10 万层。
而在右侧的尾递归中,由于当前栈帧在发起下一次调用时已经没有任何未完成的计算任务,具备尾调用优化(TCO)特性的引擎可以直接复用当前栈帧(In-place Frame Reuse),只需更新入参寄存器,空间复杂度从 O(n) 骤降为 O(1)。
注意当前 JS 引擎的支持现状:
虽然 ECMAScript 2015 (ES6) 规范正式规定了在严格模式(
因此,在工程实践中,我们不能寄希望于引擎的隐式优化,而必须掌握尾递归改写与蹦床函数(Trampoline)相结合的通用落地手段。
虽然 ECMAScript 2015 (ES6) 规范正式规定了在严格模式(
'use strict')下的尾调用优化(Proper Tail Calls, PTC),但截至目前,主流的 Google Chrome (V8)、Node.js 以及 Mozilla Firefox (SpiderMonkey) 均出于保留错误调用栈追踪(Stack Trace)和调试便利性的考量,默认关闭或未实现隐式 PTC,目前仅 Apple 的 Safari (JavaScriptCore) 完整开启了该优化。因此,在工程实践中,我们不能寄希望于引擎的隐式优化,而必须掌握尾递归改写与蹦床函数(Trampoline)相结合的通用落地手段。
三、实战改造:从普通递归到尾递归与蹦床函数
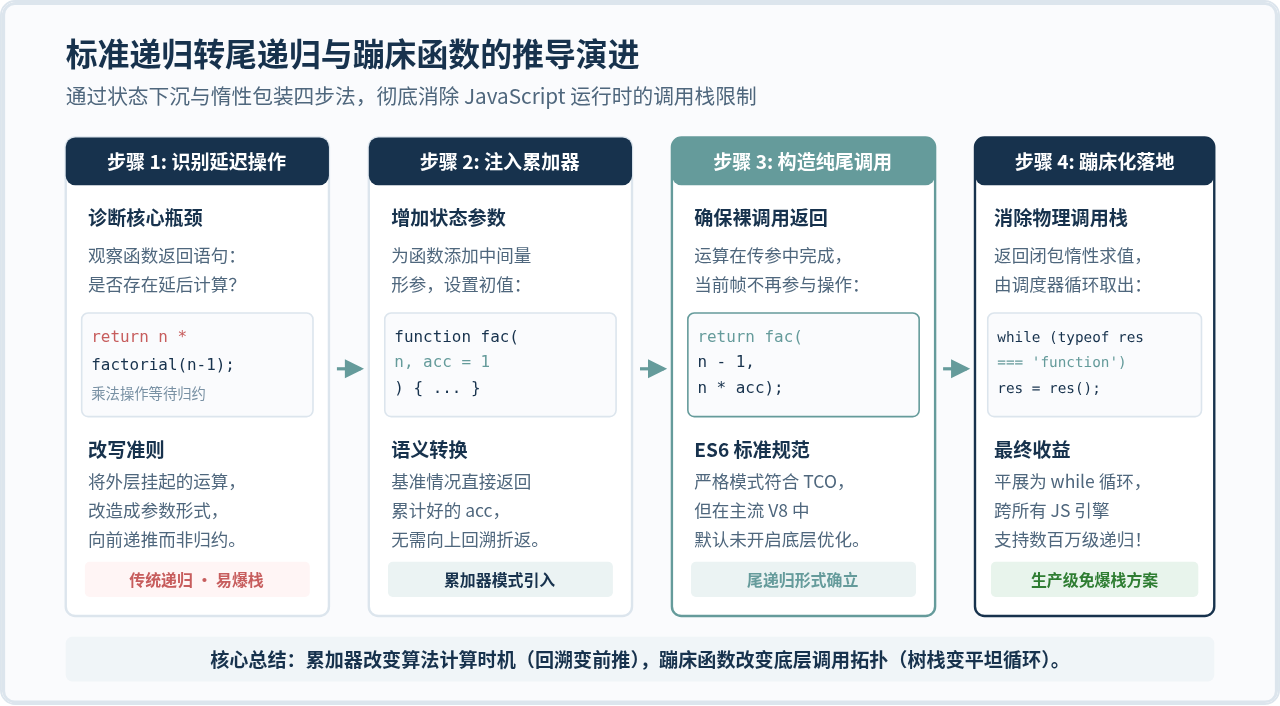
要把一个会导致爆栈的普通递归改造为可安全执行的高效代码,通常分为算法状态下沉(改写为尾递归)与物理栈消除(接入蹦床函数)两个阶段。
步骤一:引入累加器(Accumulator),将回溯计算转为前推
普通递归之所以不能成为尾调用,是因为它的运算是“由外向内递进,再由内向外回溯结算”的。要打破这一点,我们需要引入额外的参数作为累加器(Accumulator),让计算在向下递进的同时立刻完成:
- 找出原来在
return处推迟结算的操作(如乘法、加法、数组连接)。 - 把操作的结果在当前函数的调用参数中直接算出,传递给下一个函数。
- 当达到边界条件时,直接返回累加器的最终值,不再需要层层回弹。
// 数组扁平化的尾递归改写示例
function flattenTail(arr, acc = []) {
  for (const item of arr) {
    if (Array.isArray(item)) {
      flattenTail(item, acc);
    } else {
      acc.push(item);
    }
  }
  return acc;
}
步骤二:编写通用的蹦床函数(Trampoline)
为了让尾递归代码在没有开启原生 TCO 的 Node.js 和各大浏览器中同样安全运行,我们需要使用“蹦床函数”模式。
其原理极其巧妙:函数不再直接递归调用自身,而是返回一个包含下一次调用的闭包(惰性求值函数 Thunk);外部由一个简单的 while 循环不断执行返回的函数,直到返回最终结果。这样,每一次调用都在当前事件循环中完成并销毁栈帧,物理调用栈深度永远为 1。
/**
 * 通用蹦床执行器 (Trampoline Runner)
 * @param {Function} fn 待执行的尾递归包装函数
 * @returns {*} 最终计算结果
 */
function trampoline(fn) {
  return function (...args) {
    let result = fn(...args);
    // 只要返回值是一个待执行的函数,就在同一层栈中循环解包
    while (typeof result === 'function') {
      result = result();
    }
    return result;
  };
}

// 改造阶乘函数:将尾调用包装进闭包
function factorialThunk(n, acc = 1n) {
  if (n <= 1n) return acc;
  // 返回一个匿名函数,将下一次调用推迟到外层 while 中运行
  return () => factorialThunk(n - 1n, n * acc);
}

// 组装并测试:在任意 JS 引擎中执行 10 万次递归都不会爆栈
const safeFactorial = trampoline(factorialThunk);
console.log(safeFactorial(100000n)); // 正常运行返回超大整数,物理调用栈不溢出
四、实战落地:利用记忆化消除重复子问题
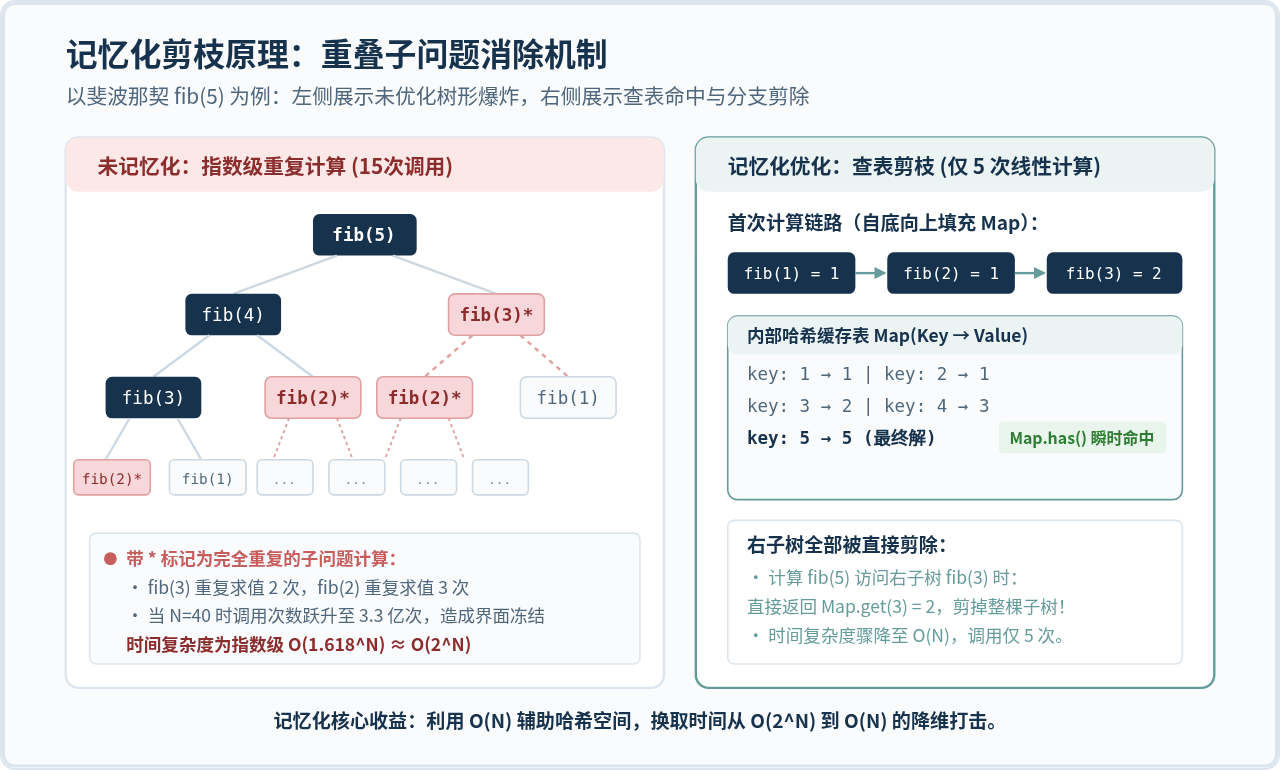
尾递归解决了单路径上的调用栈深度问题,但当算法本身具有重叠子问题(Overlapping Subproblems)时,单靠尾递归无法降低时间复杂度。例如多重分支递归的斐波那契数列,计算 fib(40) 需要进行超过 3 亿次递归调用。
记忆化(Memoization)的核心思想是空间换时间:在函数内部维护一个缓存字典(如 Map),每次计算前先在缓存中查找;如果已计算过则直接返回缓存结果,若未计算过则执行计算并将结果写入缓存。
通用的高性能记忆化高阶函数
在编写生产级通用记忆化函数时,需要考虑多参数序列化与内存引用问题。下面是一个支持多入参、支持自定义哈希生成器的通用实现:
/**
 * 高性能通用记忆化函数
 * @param {Function} fn 目标纯函数
 * @param {Function} [keyResolver] 可选的缓存键生成函数
 * @returns {Function} 具备缓存能力的包裹函数
 */
function memoize(fn, keyResolver) {
  const cache = new Map();

  const memoized = function (...args) {
    // 单入参时直接使用原参数作为键,避免字符串序列化开销
    const key = keyResolver
      ? keyResolver(...args)
      : (args.length === 1 ? args[0] : JSON.stringify(args));

    if (cache.has(key)) {
      return cache.get(key);
    }

    const result = fn.apply(this, args);
    cache.set(key, result);
    return result;
  };

  // 暴露清理缓存接口,便于垃圾回收
  memoized.cache = cache;
  return memoized;
}
使用记忆化优化递归时的关键避坑点
致命陷阱:千万不要只包装外部入口函数!
很多开发者容易犯这样一个错误:先定义了普通的递归函数
很多开发者容易犯这样一个错误:先定义了普通的递归函数
fib,然后通过 const safeFib = memoize(fib) 导出。此时虽然最外层的 safeFib(40) 会查缓存,但在其内部执行 fib(39) + fib(38) 时调用的依然是没有缓存的原始 fib,导致递归树内部的数亿次重复计算依然发生!
正确的做法是确保函数内部的递归自调用指向已经记忆化的包裹函数自身。以下是两种规范的写法:
// 正确写法一:利用闭包自绑定内部递归调用
const fibMemo = memoize(function (n) {
  if (n <= 0) return 0;
  if (n === 1) return 1;
  // 注意:这里递归调用的是已记忆化的 fibMemo,而非裸函数
  return fibMemo(n - 1) + fibMemo(n - 2);
});

console.log(fibMemo(40)); // 瞬间输出 102334155,计算次数仅 41 次

// 正确写法二:在递归签名中内置缓存参数(纯函数式写法)
function fibExplicit(n, memo = new Map()) {
  if (n <= 0) return 0;
  if (n === 1) return 1;
  if (memo.has(n)) return memo.get(n);

  const res = fibExplicit(n - 1, memo) + fibExplicit(n - 2, memo);
  memo.set(n, res);
  return res;
}
五、综合决策与最佳实践
在实际业务与算法工程中,尾调用优化和记忆化并非互斥,而是各司其职。为了帮助读者在不同业务场景中做出最合适的架构选型,请参考下述决策流程与技术对比。
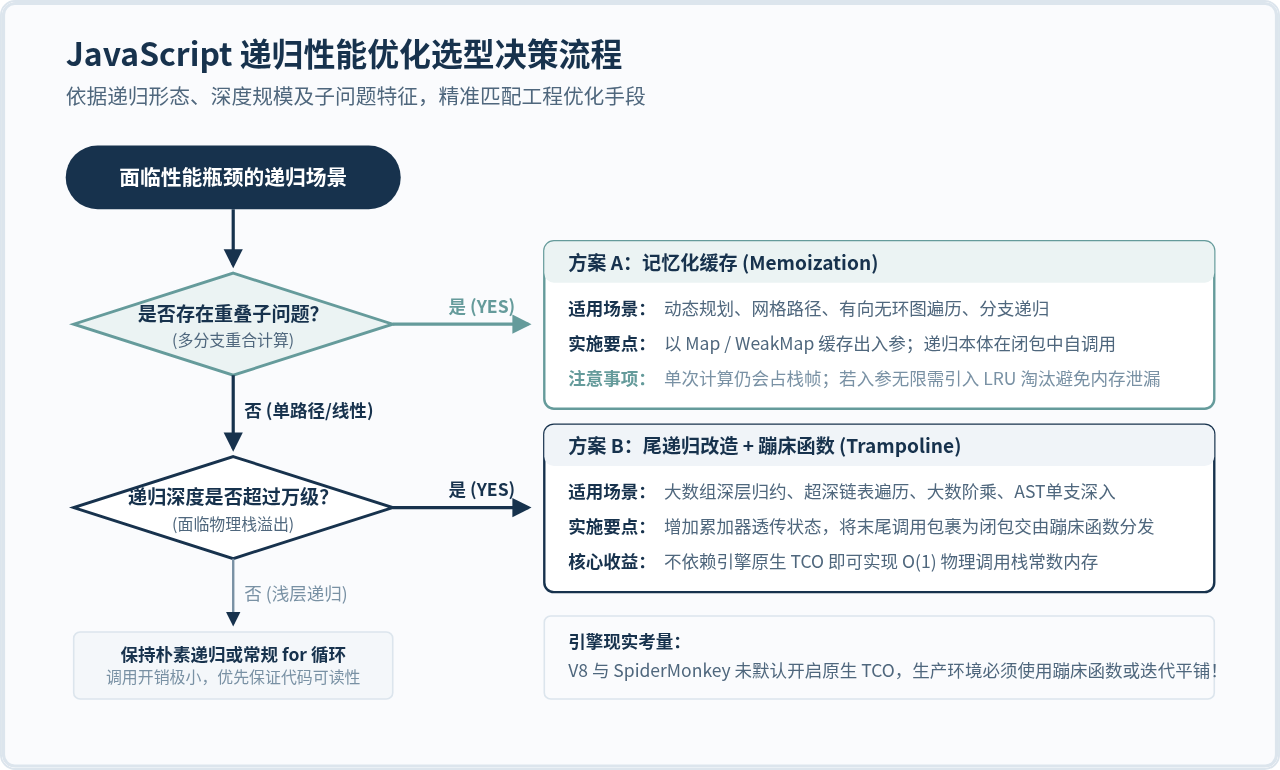
| 优化方案 | 主要解决的瓶颈 | 时间复杂度 | 空间复杂度 | 典型适用场景 | 主要权衡与限制 |
|---|---|---|---|---|---|
| 尾递归 + 蹦床函数 | 物理调用栈溢出 (Stack Overflow) | O(N) | O(1) 常数栈 | 超大数组深度折叠、长链表迭代、大数单向计算 | 仅适用于单路径线性递归;改写代码稍繁琐 |
| 记忆化高阶缓存 | 重复分支计算、指数级耗时 | O(2^N) 降为 O(N) | O(N) 堆内存 | 斐波那契、动态规划路径求解、重叠子问题搜索 | 单次计算仍然受限于调用栈深度;缓存占用堆内存 |
| 改写为迭代(循环) | 综合性能极致追求 | O(N) | O(1) 至 O(N) | 性能敏感的底层库计算、工业级树遍历 | 代码结构有时不如递归直观,需手动维护模拟栈 |
生产环境落地四大注意事项
-
防范记忆化导致的堆内存泄漏:如果函数的入参取值空间无限大(例如不断传入随机生成的字符串),缓存的
Map会无限膨胀。此时必须为记忆化函数配置容量上限,或结合 LRU(Least Recently Used)淘汰算法。 - 确保目标函数是纯函数(Pure Function):记忆化的基本前提是“相同的输入必然得到相同的输出”。如果被记忆化的函数依赖全局变量、随机数、外部时间戳或具有修改 DOM 等副作用,记忆化会导致逻辑严重失真。
-
多参数缓存键的序列化开销:如果函数接收复杂嵌套对象作为入参,使用
JSON.stringify生成缓存键可能会消耗大量 CPU 时间,甚至超过递归本身的开销。对于对象引用,优先使用WeakMap或依据核心唯一字段提取简单键值。 -
优先考虑改写为循环:对于简单的单分支尾递归,在 JavaScript 中最直接、性能最强的永远是原生的
while或for循环。尾递归与蹦床函数更适合在不改变原有递归算法架构、需保持函数式编程范式的场景下作为稳妥的防爆栈屏障。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章