
深入讲解在 JavaScript 中进行字符串查找时如何忽略大小写,涵盖 toLowerCase()、RegExp i 修饰符、动态正则转义、Intl.Collator 本地化支持及性能与边界防坑指南。

当前位置:首页 > JavaScript 基础 > 正文
JS 查找字符串怎么忽略大小写
作者:代码拾荒
时间:2026-11-03
浏览:655
文章目录
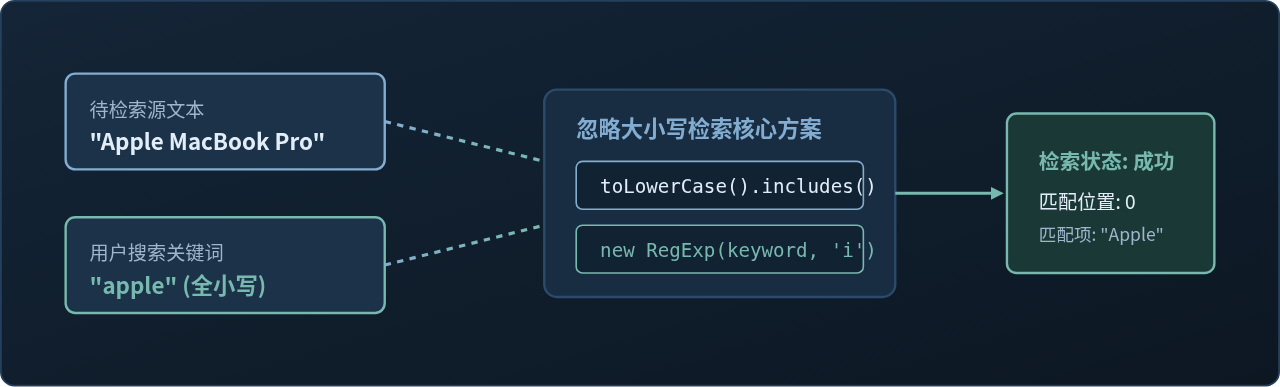
假设你正在网页中制作一个商品或文章搜索框,列表中包含标题 "Apple MacBook Pro"。当用户在输入框键入小写的 "apple" 时,如果你直接使用 str.includes("apple") 进行判断,返回结果会是 false。在 JavaScript 中,默认的字符串比较是严格区分大小写的。
要实现忽略大小写的字符串查找,核心思路主要有两种:一种是将源文本与搜索词统一转换为全小写或全大写后再比对;另一种是借助正则表达式的 i(ignoreCase)修饰符直接匹配。本文将围绕这两个主流解法展开,说明具体实现步骤、动态输入转义、返回原始匹配文本的技巧,以及应对特殊语言环境时的注意事项。
一、为什么默认查找无法匹配?
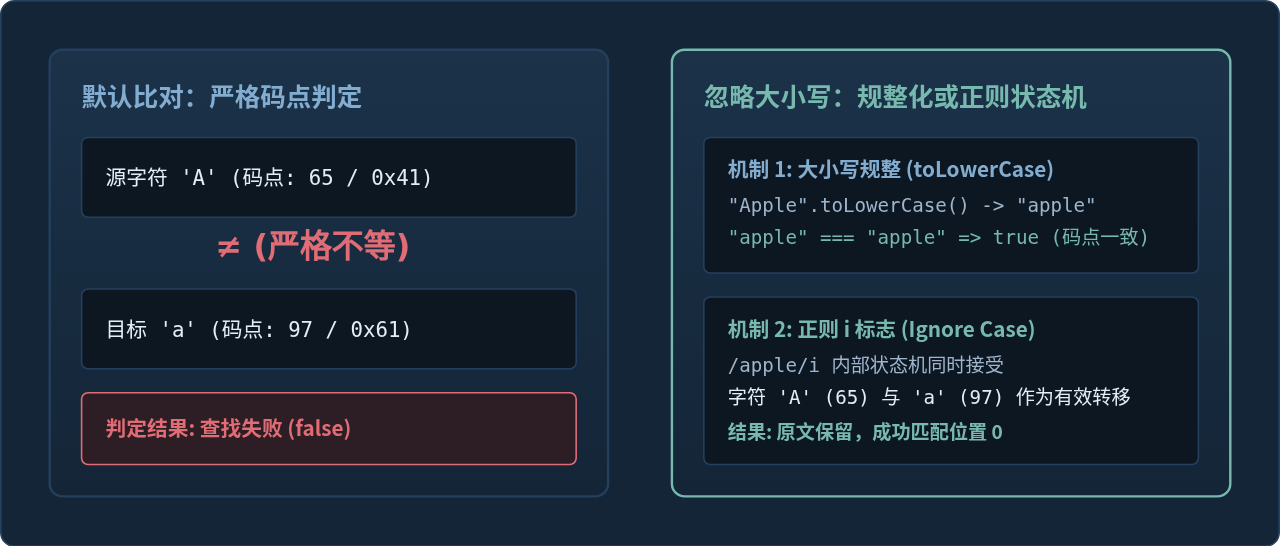
在深入具体代码前,先了解 JavaScript 底层的匹配机制有助于写出更稳健的代码。JavaScript 中的字符串比较(无论是 === 还是 includes()、indexOf())本质上是按字符的 UTF-16 编码单元(Code Point)逐个进行数值比对。
大写字母 'A' 的 Unicode 码点是 65,而小写字母 'a' 的码点是 97。因为 65 不等于 97,所以 "Apple".includes("apple") 必然返回 false。这就意味着,要实现不区分大小写,必须在比对环节“抹平”这种码点差异。
二、方法一:统一转为小写/大写后查找(最基础做法)
这是最直观且在日常开发中使用频率最高的方式。将母字符串和待查找字符串都统一转换成全小写(或全大写),然后再调用原生查找方法。
1. 判断是否存在:使用 includes()
如果只需要返回布尔值(即判断目标字符是否存在),结合 toLowerCase() 与 includes() 是最简洁的写法:
function containsIgnoreCase(source, target) {
  if (typeof source !== 'string' || typeof target !== 'string') {
    return false;
  }
  return source.toLowerCase().includes(target.toLowerCase());
}

// 测试示例
const title = "JavaScript String Manipulation Guide";
console.log(containsIgnoreCase(title, "guide")); // true
console.log(containsIgnoreCase(title, "STRING")); // true
console.log(containsIgnoreCase(title, "python")); // false
true
true
false
true
false
2. 获取首次出现的位置:使用 indexOf()
如果你需要知道目标字符串在母串中的起始索引位置,可以使用 indexOf()。如果未找到则返回 -1:
function indexOfIgnoreCase(source, target) {
  if (!source || !target) return -1;
  return source.toLowerCase().indexOf(target.toLowerCase());
}

const sentence = "Welcome to JavaScript World";
const index = indexOfIgnoreCase(sentence, "JAVASCRIPT");
console.log("找到位置:", index);
找到位置: 11
方法特点与注意事项
该方法的优点是简单、直观、执行效率高,不需要处理正则表达式特殊字符。但其局限在于:转换过程会创建两个新的临时字符串对象,并且通过小写化之后,无法直接保留并截取母串中原本的大小写样式。
三、方法二:使用正则表达式配合 i 修饰符(适合灵活检索)
在正则表达式中,末尾的 i 修饰符表示 ignoreCase(忽略大小写)。在处理包含通配模式、动态搜索或需要提取原文时,正则表达式非常强大。
1. 静态模式:字面量正则
当搜索关键词在编码时就已经确定,可以直接使用正则表达式字面量:
const content = "Contact us at support@example.COM";

// 1. 使用 RegExp.test() 检查是否存在
const hasCom = /\.com$/i.test(content);
console.log("是否以 .com 结尾 (忽略大小写):", hasCom);

// 2. 使用 String.search() 查找首次匹配索引
const matchIndex = content.search(/support/i);
console.log("support 所在索引:", matchIndex);
是否以 .com 结尾 (忽略大小写): true
support 所在索引: 14
support 所在索引: 14
2. 动态关键词搜索与必要防范:转义特殊字符
当搜索词来自于用户输入(例如输入框中的变量)时,必须使用构造函数 new RegExp(keyword, 'i')。但此时存在一个极其关键的安全与正确性细节:用户输入的字符串可能包含正则特殊元字符(如 ., *, ?, +, [, ], (, ) 等)。
如果用户输入了 "c++",直接传入 new RegExp("c++", "i") 会抛出语法错误 SyntaxError: Invalid regular expression。因此在构建动态正则前,必须先进行字符转义。
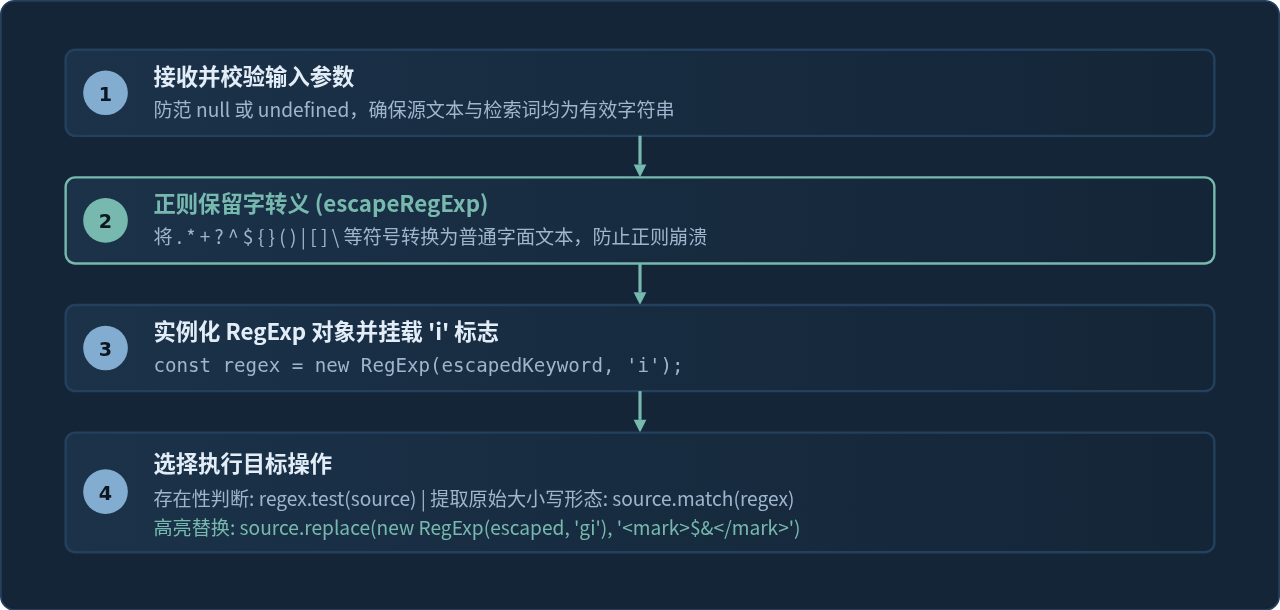
下面是带有完整安全转义的标准实现代码:
// 1. 安全转义正则保留字符
function escapeRegExp(string) {
  return string.replace(/[.*+?^${}()|[\]\\]/g, '\\$&');
}

// 2. 动态忽略大小写匹配
function searchCaseInsensitive(source, query) {
  if (!source || !query) return false;

  const safeQuery = escapeRegExp(query);
  const regex = new RegExp(safeQuery, 'i');
  return regex.test(source);
}

// 测试动态输入
const docText = "We offer C++ and Node.js backend courses.";
console.log(searchCaseInsensitive(docText, "c++"));      // true
console.log(searchCaseInsensitive(docText, "NODE.JS"));  // true
console.log(searchCaseInsensitive(docText, "java"));     // false
true
true
false
true
false
3. 提取原串中的真实匹配文本:使用 match() 或 matchAll()
使用 toLowerCase() 的一大缺陷是无法知道匹配到的文本原本长什么样。如果你的业务场景需要高亮显示匹配内容,或者提取用户命中的原始单词,正则的 match() 是最佳方案:
const log = "ERROR: Failed to connect, error code 404, Error logged.";
const targetKeyword = "error";

// 使用全局 + 忽略大小写标识 'gi'
const regex = new RegExp(escapeRegExp(targetKeyword), 'gi');

// 提取所有匹配的原始子串
const matches = log.match(regex);
console.log("所有匹配的原文本项:", matches);

// 提取位置与详情
const matchDetails = [...log.matchAll(regex)].map(m => ({
  text: m[0],
  index: m.index
}));
console.log("匹配详情:", matchDetails);
所有匹配的原文本项: [ 'ERROR', 'error', 'Error' ]
匹配详情: [
{ text: 'ERROR', index: 0 },
{ text: 'error', index: 24 },
{ text: 'Error', index: 40 }
]
匹配详情: [
{ text: 'ERROR', index: 0 },
{ text: 'error', index: 24 },
{ text: 'Error', index: 40 }
]
四、方案对比与技术选型
为了让不同场景下的选择更清晰,我们将 toLowerCase() 方案、RegExp 方案以及专门应对国际化语言的 Intl.Collator 方案进行综合对比:
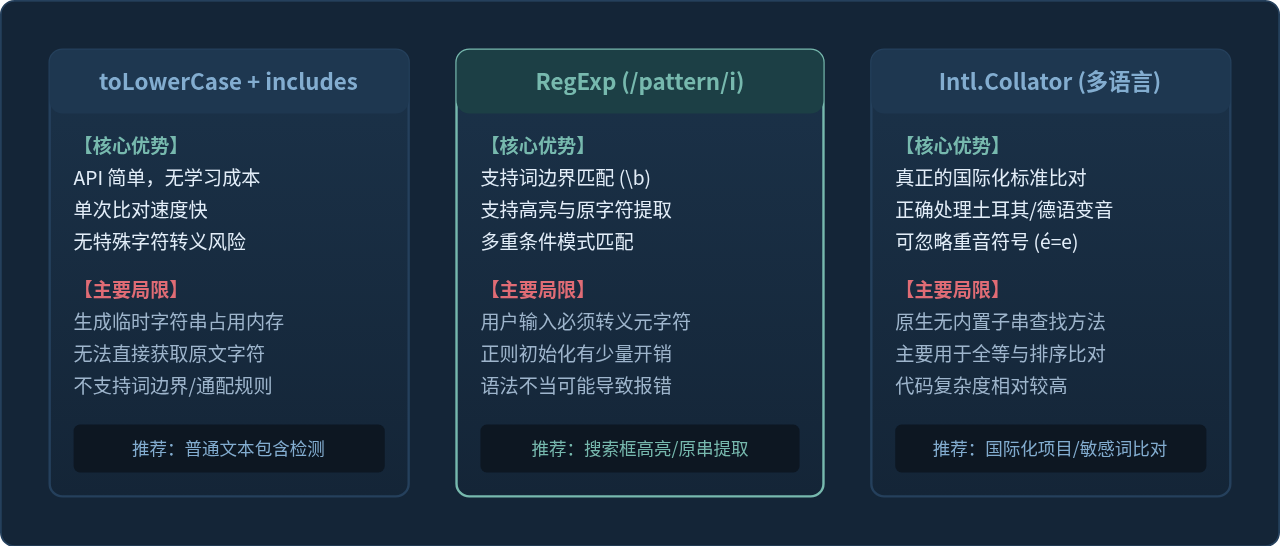
| 方案 | 典型代码 | 适用场景 | 性能与开销 |
|---|---|---|---|
| 大小写转换 | a.toLowerCase().includes(b.toLowerCase()) |
简单的关键词过滤、存在性判断 | 极高。但大数据集或超长文本循环转换会有内存分配开销。 |
| 动态正则 | new RegExp(escape(b), 'i').test(a) |
动态搜索框、需要高亮或词边界 | 高。若在密集循环中应预编译 RegExp 实例,避免重复构造。 |
| 国际化比较 | new Intl.Collator('zh', { sensitivity: 'base' }) |
多语言字符集、变音符号(如 é 与 e)匹配 | 中等。实例化一次后重复使用比对函数。 |
五、特殊场景:多语言与变音符号(i18n)
如果你的应用面向多语言国际用户,标准的 toLowerCase() 可能会遇到语言学上的边缘情况。例如在土耳其语中,大写字母 'I' 对应的小写字母带点符号是 'ı'(而非 'i');而带有变音符号的法语或德语单词(如 "café"),用户输入 "cafe" 时通常也期望能被匹配。
1. 本地化大小写转换:toLocaleLowerCase
当明确知道用户的语言环境时,应优先指定区域语言代码:
const trWord = "ISTANBUL";

// 标准转换可能无法满足特定地区规则
console.log(trWord.toLowerCase()); // "istanbul"

// 指定土耳其语言区域
console.log(trWord.toLocaleLowerCase('tr-TR')); // "ıstanbul"
istanbul
ıstanbul
ıstanbul
2. 使用 Intl.Collator 进行不区分大小写及重音的比对
现代浏览器与 Node.js 提供了 Intl.Collator API。将 sensitivity 设置为 "base",不仅可以忽略字母大小写,还能忽略字母的重音符号(Accent):
// sensitivity: 'base' 表示仅比较基本字符,忽略大小写和变音符号
const collator = new Intl.Collator('en', { sensitivity: 'base' });

// compare 返回 0 表示两者在语言规则下完全等价
function isEquivalent(a, b) {
  return collator.compare(a, b) === 0;
}

console.log("比对 'resume' 与 'résumé':", isEquivalent("resume", "résumé")); // true
console.log("比对 'APPLE' 与 'apple':", isEquivalent("APPLE", "apple"));   // true
比对 'resume' 与 'résumé': true
比对 'APPLE' 与 'apple': true
比对 'APPLE' 与 'apple': true
六、工程实践常见问题与避坑指南
在实际业务代码中,因为忽略大小写查找引发的线上 Bug 往往不是逻辑本身,而是边界防御不足或性能瓶颈。请牢记以下三个核心准则:
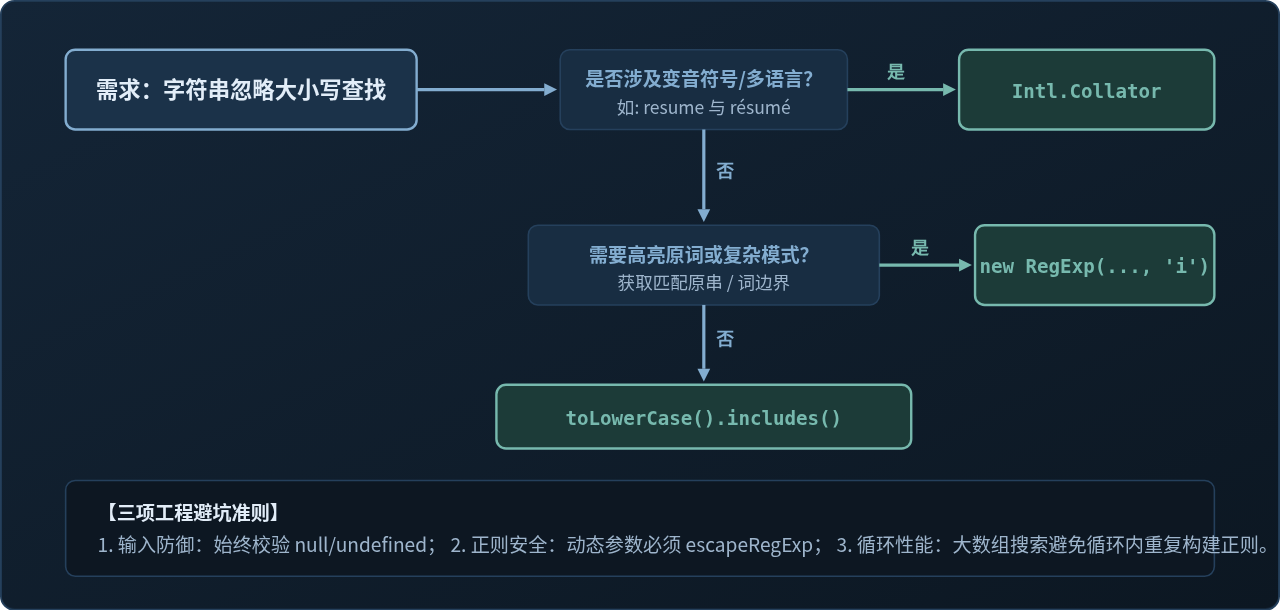
1. 严格做好非空防御
如果源文本或搜索参数是 null、undefined 或数字,直接调用 .toLowerCase() 会抛出致命的 TypeError: Cannot read properties of undefined。在封装工具函数时,必须做类型保护:
function safeSearch(source, keyword) {
  // 确保两个参数都被转换为安全字符串
  const str = String(source || '');
  const target = String(keyword || '');

  if (!target) return true; // 空搜索词默认命中或根据业务调整
  return str.toLowerCase().includes(target.toLowerCase());
}
2. 避免在超大数组遍历中重复创建正则
如果你需要在一个包含 10 万条数据的列表里过滤某个关键词,切忌在 filter 循环体内反复创建 new RegExp():
// ❌ 低效做法:每遍历一项就重新编译一次正则表达式
const badResult = bigList.filter(item => {
  return new RegExp(escapeRegExp(query), 'i').test(item.name);
});

// ✅ 高效做法:在循环外部仅编译一次
const safeRegex = new RegExp(escapeRegExp(query), 'i');
const goodResult = bigList.filter(item => safeRegex.test(item.name));
通过在外层预编译正则表达式,可以避免数十万次无意义的正则编译开销,显著提升前端界面的交互响应速度。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章