

深入解析在 Leaflet.js 地图应用中使用 Leaflet.markercluster 插件优化海量点位渲染的工程方案。通过原理解析、规范实施四步法、核心参数调优、完整代码实践及全生命周期排查,彻底解决 DOM 节点爆炸与交互卡顿难题。
Leaflet.js 性能优化:使用 MarkerCluster 处理海量点位渲染
作者:听澜
时间:2026-11-03
浏览:457
文章目录
WebGIS 性能优化
适用范围:Leaflet 1.7+ / 1.9+
核心依赖:leaflet.markercluster 1.5.3
性能指标:万级点位 60 FPS 稳定渲染
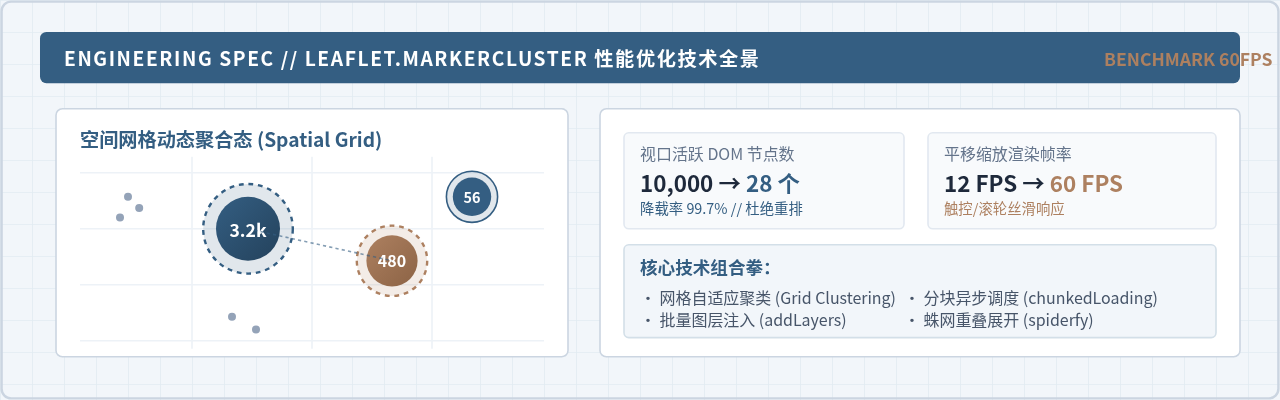
在 WebGIS 页面中直接渲染数千至上万个点位时,Leaflet.js 默认将每个
L.marker 实例化为独立的 DOM 节点并挂载至图层容器中。当用户执行平移或缩放操作时,海量 DOM 节点会引发连续的样式重新计算、重排(Reflow)与重绘(Repaint),导致帧率骤降、页面严重卡死甚至浏览器崩溃。解决这一工程瓶颈的标准方法是采用空间聚类技术:通过引入 Leaflet.markercluster 插件,将地理视口内密集的点位在内存中按网格聚类为数量极少的簇图标(Cluster Marker),并配合分块异步加载(Chunked Loading)机制释放主线程,使万级海量点位在各类终端上均能达到 60 FPS 的流畅交互。
一、海量点位卡顿的根本原因与聚类机制
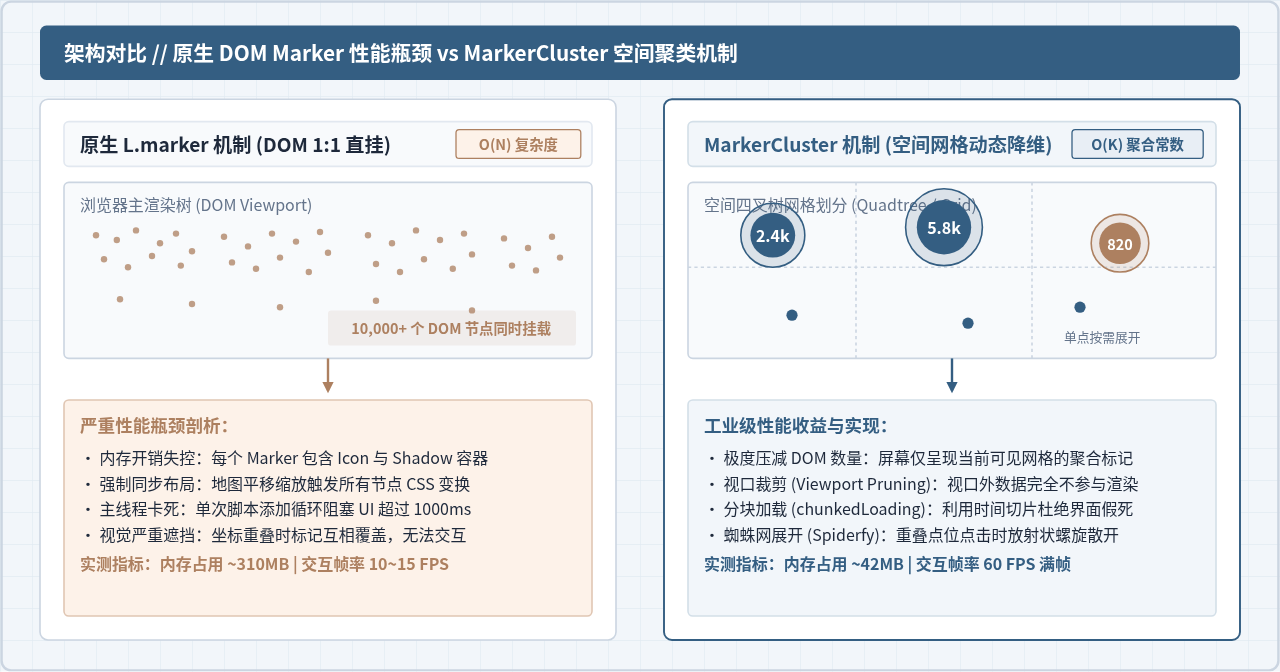
要彻底解决地图卡顿问题,必须首先理清 Leaflet 原生点位渲染的底层机制。在默认配置下,开发者每执行一次 L.marker([lat, lng]).addTo(map),Leaflet 就会在地图的 marker-pane 内创建一个包含图片或矢量图形的 HTML 元素。每一个 Marker 包含独立的坐标定位样式(如 transform: translate3d(...))、事件监听器以及阴影层。
当点位数量达到数千个时,浏览器的渲染树(Render Tree)急剧膨胀。每次用户拖拽地图或滚动滑轮缩放,Leaflet 都需要逐一计算每个 Marker 对应的新像素坐标并更新其 CSS 矩阵变换。成千上万次 DOM 属性更新会迅速耗尽浏览器的帧预算(16.6ms),直接导致帧率跌破 15 FPS。此外,坐标密集区域的点位互相覆盖堆叠,不仅在视觉上变成杂乱无章的色块,也使用户根本无法准确点击目标。
Leaflet.markercluster 从根本上改变了这种 1:1 的直接挂载模式。它在前端维护了一套基于屏幕像素与地理坐标的空间四叉树(Quadtree)和自适应网格聚类算法。其核心工作逻辑可总结为以下三点:
- 视口裁剪与按需渲染:视口外部的点位仅保存在 JavaScript 内存结构中,完全不生成任何真实的 DOM 节点,大幅降低内存消耗与渲染树负担。
- 动态距离合并:在当前地图缩放层级(Zoom Level)下,算法按照设定的像素半径(默认 80px)划分网格,落入同一网格单元的多个点位被合并为一个聚类点(Cluster Marker),DOM 节点数量从万级瞬间降为十几个或几十个。
- 层级逐级展开与蜘蛛网发散:随着用户持续放大地图,聚合网格对应的地理覆盖范围缩小,原本聚集的点位会平滑分裂展开为更小的聚合簇或独立点位;对于经纬度完全相同的重合点位,插件提供 Spiderfy(蜘蛛网发散)功能,将其沿环形或螺旋线展开,确保每个点位都具备交互可达性。
二、生产环境快速落地:标准实施四步法
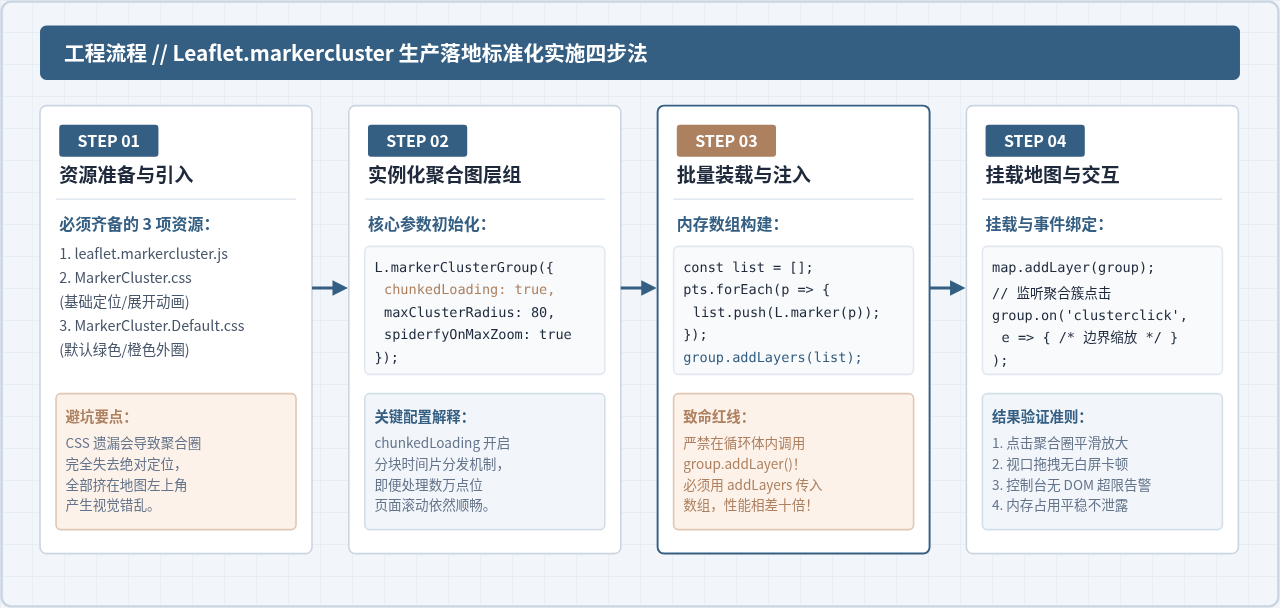
在实际项目中集成 Leaflet.markercluster,必须遵循规范的生命周期流程。由于插件涉及复杂的绝对定位样式和展开过渡动画,缺少关键依赖会导致视觉显示异常。以下是经过生产检验的标准实施四步法。
第 1 步:完整引入资源与样式文件
许多初学者常犯的错误是仅引入了 JavaScript 脚本而遗漏了样式文件。该插件需要两个不可或缺的 CSS 文件:MarkerCluster.css 负责聚合图标的基础定位、尺寸以及缩放动画;MarkerCluster.Default.css 提供经典的绿、橙、红渐变聚合圆圈样式。若缺少 CSS,聚合数字会失去居中定位与外边框,全部堆叠在地图左上方。
<!-- 1. 基础 Leaflet 样式与脚本 -->
<link rel="stylesheet" href="https://unpkg.com/leaflet@1.9.4/dist/leaflet.css" />
<script src="https://unpkg.com/leaflet@1.9.4/dist/leaflet.js"></script>

<!-- 2. MarkerCluster 核心样式(基础布局 + 默认主题) -->
<link rel="stylesheet" href="https://unpkg.com/leaflet.markercluster@1.5.3/dist/MarkerCluster.css" />
<link rel="stylesheet" href="https://unpkg.com/leaflet.markercluster@1.5.3/dist/MarkerCluster.Default.css" />

<!-- 3. MarkerCluster 核心脚本 -->
<script src="https://unpkg.com/leaflet.markercluster@1.5.3/dist/leaflet.markercluster.js"></script>
第 2 步:初始化地图与聚类图层组(MarkerClusterGroup)
在常规代码中,Marker 会直接添加到 map 实例中。在聚类方案中,需要先创建一个 L.markerClusterGroup 容器,并显式传入性能调优参数。创建后该容器充当统一的管理图层。
// 初始化地图实例
const map = L.map('map', {
  center: [31.2304, 121.4737],
  zoom: 10,
  maxZoom: 18
});

// 添加瓦片底图
L.tileLayer('https://{s}.tile.openstreetmap.org/{z}/{x}/{y}.png', {
  attribution: '© OpenStreetMap contributors'
}).addTo(map);

// 实例化聚合图层组,开启异步分块加载
const markerClusterGroup = L.markerClusterGroup({
  chunkedLoading: true,        // 开启分块时间片调度(核心)
  chunkInterval: 200,           // 批处理间隔时间(毫秒)
  chunkDelay: 50,               // 批次间让出主线程延迟(毫秒)
  maxClusterRadius: 80,         // 聚合像素半径
  spiderfyOnMaxZoom: true,      // 到达最大层级时发散同坐标点
  showCoverageOnHover: false    // 关闭鼠标悬浮凸包多边形,减少 Canvas 重绘
});
第 3 步:内存批量构建点位与一次性注入
这是关乎性能生死的关键步骤:绝对不要在循环体内逐个调用 markerClusterGroup.addLayer(marker)。每次调用 addLayer 都会触发内部聚类树的重平衡计算。如果点位有 10,000 个,就等于触发了 10,000 次重计算。正确做法是在内存中组装一个纯数组,最后调用 addLayers(markerArray) 一次性注入。
// 模拟 10,000 个业务坐标数据
const rawDataList = generateMockCoordinates(10000);

// 在纯内存中构建 Marker 数组(不触发任何渲染计算)
const markerBatch = [];
for (let i = 0; i < rawDataList.length; i++) {
  const item = rawDataList[i];
  const marker = L.marker([item.lat, item.lng]);

  // 绑定交互事件(注意:内容应轻量,避免预先生成复杂 DOM)
  marker.bindPopup(`<strong>设备编号:</strong> #${item.id}<br><span>状态: 正常运行</span>`);
  markerBatch.push(marker);
}

// 一次性批量装入聚类组(性能提升 10 倍以上)
markerClusterGroup.addLayers(markerBatch);
第 4 步:挂载图层至地图并注册事件
将装配好的 markerClusterGroup 添加到 map 中,并根据业务需求注册聚合簇相关的交互事件(如点击聚类簇时获取该簇包含的所有点位数据)。
// 挂载至地图
map.addLayer(markerClusterGroup);

// 监听聚合簇点击事件
markerClusterGroup.on('clusterclick', function (event) {
  const childMarkers = event.layer.getAllChildMarkers();
  console.log(`当前点击的聚合簇包含 ${childMarkers.length} 个独立点位`);
});
三、关键性能参数精细调优
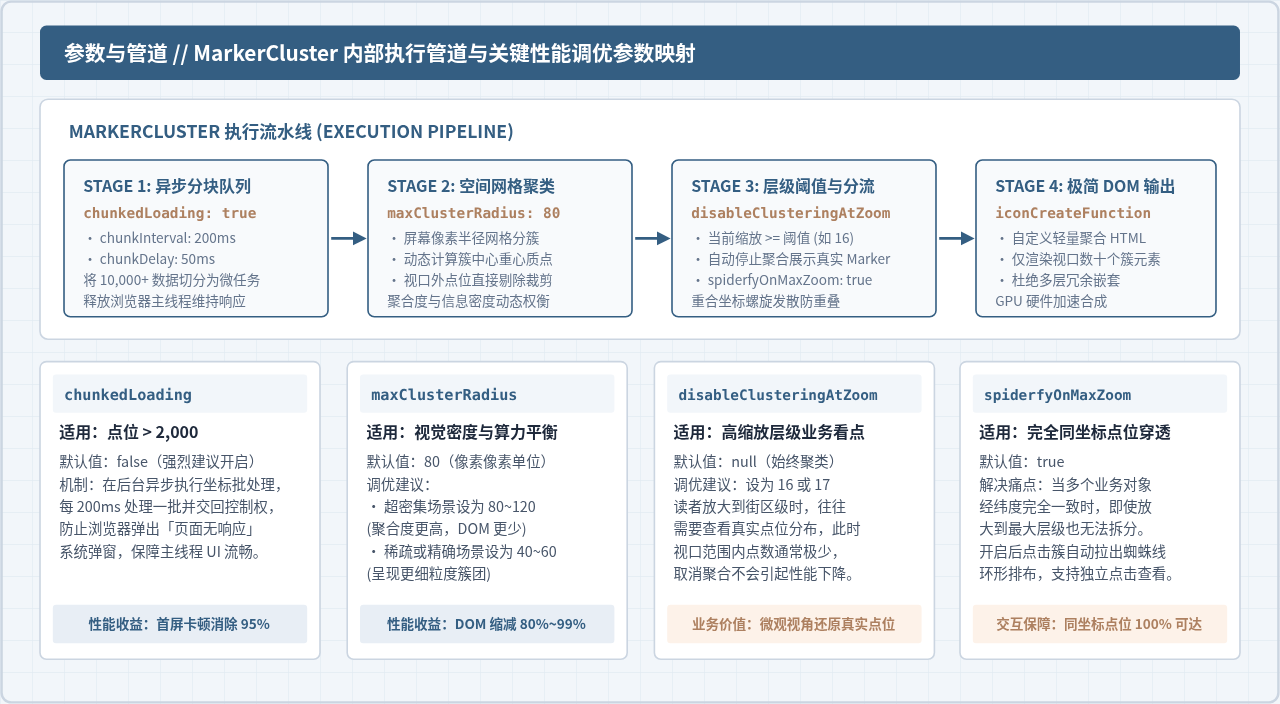
仅引入默认配置的 MarkerCluster 往往只能解决 3,000~5,000 级点位的基本渲染。当数据量上升至数万级,或者运行于低算力移动端设备时,必须针对插件的内部流水线进行精细化调优。下表列出影响性能与交互的核心参数矩阵。
| 参数名 | 默认值 | 推荐优化值 | 作用机理与性能影响 |
|---|---|---|---|
chunkedLoading |
false | true | 利用微任务时间切片分批加载数据,避免脚本长期霸占主线程引起浏览器假死。 |
chunkInterval |
200 | 150 ~ 200 (ms) | 每次分块处理的最大连续计算时间。数值越小,页面越流畅,但总体就绪时间略微延长。 |
chunkDelay |
50 | 20 ~ 50 (ms) | 两批任务之间的暂停时间,专门用于让浏览器执行 UI 绘制和用户手势响应。 |
maxClusterRadius |
80 | 60 ~ 100 (px) | 聚类像素距离。调大可减少簇总数,大幅降低 DOM 节点;调小可保留更多分散簇。 |
disableClusteringAtZoom |
null | 16 或 17 | 当用户放大到指定层级时关闭聚类,直接展现具体单点。街区微观视角下点位极少,无需聚类开销。 |
spiderfyOnMaxZoom |
true | true | 在最大缩放层级下,使重合点位沿螺旋线散开,解决多业务对象经纬度完全相同时的点击重叠。 |
animateAddingMarkers |
false | false | 添加标记时是否执行进入动画。数据量大于 1,000 时必须关闭,否则会产生严重的动画排队开销。 |
showCoverageOnHover |
true | false | 鼠标悬停时绘制聚类覆盖范围的半透明多边形。在大数据量下关闭可避免频繁创建临时 Canvas 遮罩。 |
深度优化 1:自定义轻量级聚合图标(iconCreateFunction)
默认的聚合图标虽然美观,但其内部包含两层嵌套 <div>,带有复杂的阴影和 CSS 伪元素。如果当前视口存在几百个聚合簇,样式计算依然存在优化空间。通过 iconCreateFunction,我们可以返回纯扁平、高可读性的轻量级 HTML 结构,彻底剔除冗余标签:
const optimizedClusterGroup = L.markerClusterGroup({
  chunkedLoading: true,
  maxClusterRadius: 80,
  iconCreateFunction: function (cluster) {
    const count = cluster.getChildCount();
    let sizeClass = 'cluster-small';
    let diameter = 36;

    if (count > 1000) {
      sizeClass = 'cluster-large';
      diameter = 52;
    } else if (count > 100) {
      sizeClass = 'cluster-medium';
      diameter = 44;
    }

    // 返回结构极简的单层 DivIcon,避免多层 DOM 嵌套与阴影重绘
    return L.divIcon({
      html: `<div class="flat-cluster-badge ${sizeClass}"><span>${count}</span></div>`,
      className: 'custom-cluster-wrapper',
      iconSize: L.point(diameter, diameter)
    });
  }
});
深度优化 2:弹窗内容的惰性构建(Lazy Popup Binding)
很多开发者习惯在遍历数据时,为每个 Marker 直接通过 bindPopup(complexHtmlString) 生成完整的富文本或图表结构。当有点位 20,000 个时,这会导致内存中同时驻留 20,000 个庞大的 HTML 字符串和相关的 DOM 缓存。
正确的高性能实践是惰性绑定:在生成 Marker 时只存储其核心唯一标识(如 marker.featureId = item.id)。当且仅当用户实际点击了某个具体 Marker 时,才动态异步拉取数据并渲染 Popup:
// 极简 Marker 创建:只存坐标与标识,不挂载任何富文本 HTML
const marker = L.marker([item.lat, item.lng]);
marker.businessId = item.id;

// 统一代理或单点点击时异步装配 Popup
marker.on('click', function (e) {
  const targetMarker = e.target;
  // 模拟异步请求或本地详细字典提取
  const detailHtml = renderDetailView(targetMarker.businessId);
  targetMarker.bindPopup(detailHtml).openPopup();
});
四、万级点位真实场景完整范例
下面是一个可以直接嵌入前端项目的完整工程范例。该脚本自动生成 10,000 个随机分布的坐标点,初始化高优化配置的 MarkerClusterGroup,并通过分块加载平滑挂载至地图。
// ========================================================
// Leaflet.js 万级点位高性能聚合渲染完整示例
// ========================================================

// 1. 创建地图
const map = L.map('map', {
  preferCanvas: true,           // 底层矢量元素优先开启 Canvas 渲染
  center: [39.9042, 116.4074],  // 中心点设在城市中心
  zoom: 11,
  zoomAnimation: true
});

L.tileLayer('https://{s}.tile.openstreetmap.org/{z}/{x}/{y}.png', {
  attribution: '© OpenStreetMap',
  maxZoom: 19
}).addTo(map);

// 2. 创建高参数调优的聚类图层
const clusterLayer = L.markerClusterGroup({
  chunkedLoading: true,          // 启用时间切片分块调度
  chunkInterval: 180,             // 每 180ms 作为一个切片批次
  chunkDelay: 30,                 // 让出主线程 30ms
  maxClusterRadius: 70,           // 聚合半径 70 像素
  disableClusteringAtZoom: 16,    // 放大至 16 级后全部展现真实单点
  spiderfyOnMaxZoom: true,        // 最大级别支持同坐标点蛛网散开
  animate: true,                  // 开启层级平滑缩放动效
  animateAddingMarkers: false,    // 严禁开启添加标记动效
  showCoverageOnHover: false      // 关闭悬浮凸包多边形
});

// 3. 生成 10,000 个测试点位并装入内存队列
console.time('数据装配耗时');
const totalMarkers = 10000;
const markerArray = [];
const baseLat = 39.9042;
const baseLng = 116.4074;

for (let i = 0; i < totalMarkers; i++) {
  // 模拟高斯分布与分散点位
  const lat = baseLat + (Math.random() - 0.5) * 0.35;
  const lng = baseLng + (Math.random() - 0.5) * 0.50;

  const m = L.marker([lat, lng]);
  m.bindPopup(`<div><h4>设备 #${i + 1}</h4><p>纬度: ${lat.toFixed(4)}<br>经度: ${lng.toFixed(4)}</p></div>`);
  markerArray.push(m);
}
console.timeEnd('数据装配耗时');

// 4. 批量添加至聚类容器,并挂载至地图
console.time('MarkerCluster 批量索引耗时');
clusterLayer.addLayers(markerArray);
map.addLayer(clusterLayer);
console.timeEnd('MarkerCluster 批量索引耗时');
运行结果验证准则:执行上述代码后,通过控制台观察耗时。在常规 PC 端浏览器中,10,000 个点位的纯内存装配耗时通常在 25ms 左右,Cluster 索引建立耗时在 150ms 左右。由于开启了
chunkedLoading: true,主线程在执行过程中始终维持交互能力,用户可立即拖拽地图而不会发生界面假死。
五、动态数据更新与全生命周期管理
在物联网监控、物流追踪或实时态势感知系统中,点位数据并非静态不变,而是需要定期拉取增量或全量替换。错误的数据更新方式极易引发严重的 JavaScript 内存泄漏。
1. 全量数据刷新规范
当后端接口返回全新批次的数据时,严禁直接销毁地图实例或创建新的 markerClusterGroup,否则旧实例中的事件监听器和 DOM 关联可能无法被垃圾回收器(GC)及时回收。正确的标准操作是调用 clearLayers() 方法:
function refreshAllPoints(newPointDataList) {
  // 1. 彻底清空已有聚类点位(内部自动解除所有 DOM 绑定与内部四叉树)
  clusterLayer.clearLayers();

  // 2. 重构内存 Marker 数组
  const newBatch = newPointDataList.map(item => {
    const marker = L.marker([item.latitude, item.longitude]);
    marker.bindPopup(`<b>${item.title}</b>`);
    return marker;
  });

  // 3. 再次批量注入
  clusterLayer.addLayers(newBatch);
}
2. 高频少量增量更新技巧
如果业务场景是高频增量变动(如每秒只有 5~10 辆运输车更新位置),则不需要清空全量数据。可以建立一个以业务 ID 为 Key 的 Map<string, L.Marker> 映射表,对发生位置变动的单个点位执行精确替换:
// 维护全局实例映射表
const activeMarkerMap = new Map();

function updateSingleVehicle(vehicleId, newLat, newLng) {
  const existingMarker = activeMarkerMap.get(vehicleId);

  if (existingMarker) {
    // 从聚类组中移除旧位置,更新坐标后再添加,触发局部聚类刷新
    clusterLayer.removeLayer(existingMarker);
    existingMarker.setLatLng([newLat, newLng]);
    clusterLayer.addLayer(existingMarker);
  } else {
    const newMarker = L.marker([newLat, newLng]);
    activeMarkerMap.set(vehicleId, newMarker);
    clusterLayer.addLayer(newMarker);
  }
}
六、性能边界与技术选型降级评估
虽然 Leaflet.markercluster 在处理常规海量点位时性能极为出众,但作为基于 DOM 抽象层的解决方案,它依然受制于浏览器 DOM 引擎的物理极限。技术选型必须根据实际数据规模制定边界原则:
- 1,000 ~ 50,000 级点位(黄金适用区间):
Leaflet.markercluster是综合开发成本、交互体验(点击平滑展开、自带聚合数气泡)与兼容性的绝对最佳方案。 - 50,000 ~ 150,000 级点位(极限临界区间):此时在放大到全单点层级(如
disableClusteringAtZoom: 16)时,视口内的单点 DOM 数量可能依然超出千级,导致局部掉帧。此时需要结合Leaflet.Canvas-Markers插件,将底层的 DOM Marker 替换为基于单个 HTML5 Canvas 绘制的静态图元。 - 150,000+ 级超大规模点位(架构降级方案):任何基于主线程 DOM 的方案均不可行。此时应将前端空间计算转移至 Web Worker(如使用
supercluster纯数学聚类库),渲染层必须全面升级至 WebGL 硬件加速引擎(如Deck.gl、MapLibre GL或Cesium.js),利用 GPU 顶点着色器实现百万级点位的毫秒级瞬时渲染。
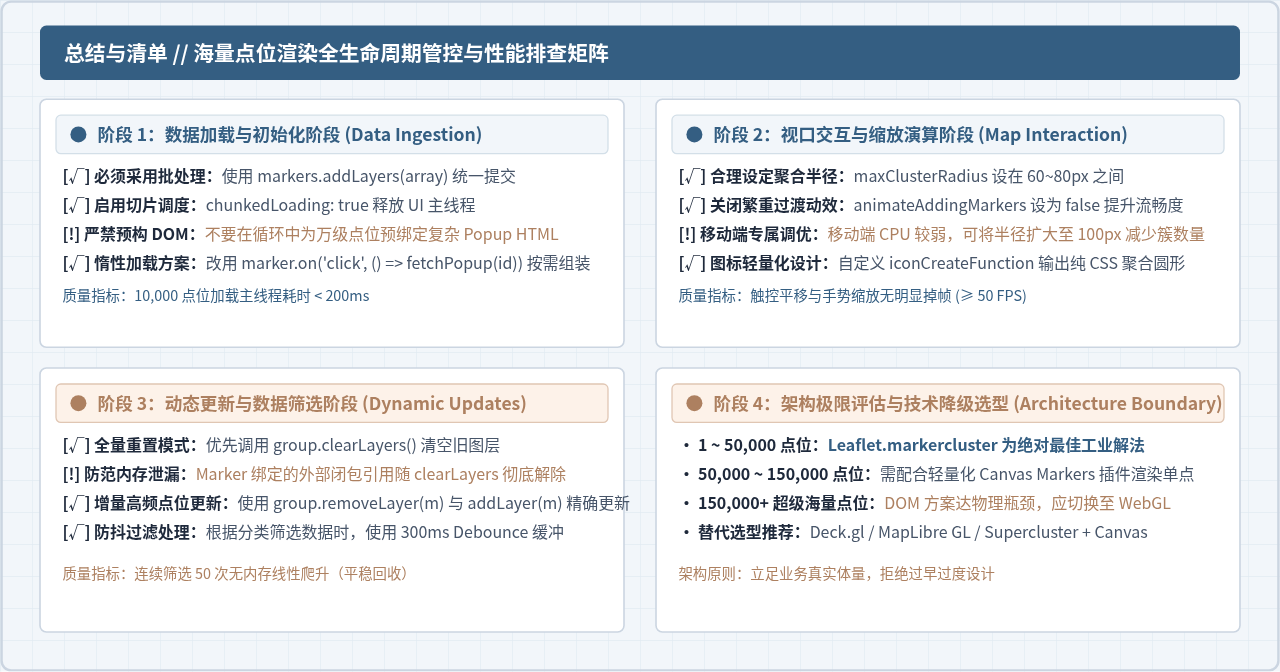
七、常见排查与避坑清单
在实际联调过程中,如果遇到渲染异常或性能未达预期的情况,可以对照以下清单逐项排查:
- 聚合数字散乱或贴在左上角:检查 HTML 的
<head>中是否正确引入了MarkerCluster.css和MarkerCluster.Default.css。这两个样式文件必须与 Leaflet.css 一并加载。 - 页面拖拽依然存在严重卡顿:确认是否在初始化配置中遗漏了
chunkedLoading: true;检查是否在循环内错误地调用了addLayer而非addLayers;排查是否有其他代码在频繁触发map.panTo。 - 点位点击弹窗延迟明显:检查是否在创建 Marker 时向 Popup 注入了过大的 Base64 图片或未压缩的复杂 SVG;应改用懒加载机制,在
popupopen事件触发时再去动态请求或渲染富文本。 - 缩放动画掉帧:数据密集时,建议将
showCoverageOnHover设为false,将animateAddingMarkers设为false,减少动画帧之间的重叠绘制开销。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章