

深入讲解如何使用 JavaScript Fetch API 与 ReadableStream 逐块拦截网络流,精确计算文件下载进度百分比、平滑下载速率与预估剩余时间,并提供生产环境避坑指南与完整代码。
JavaScript基于Fetch API实时计算文件下载速度与进度
作者:阿沐
时间:2026-11-02
浏览:161
文章目录
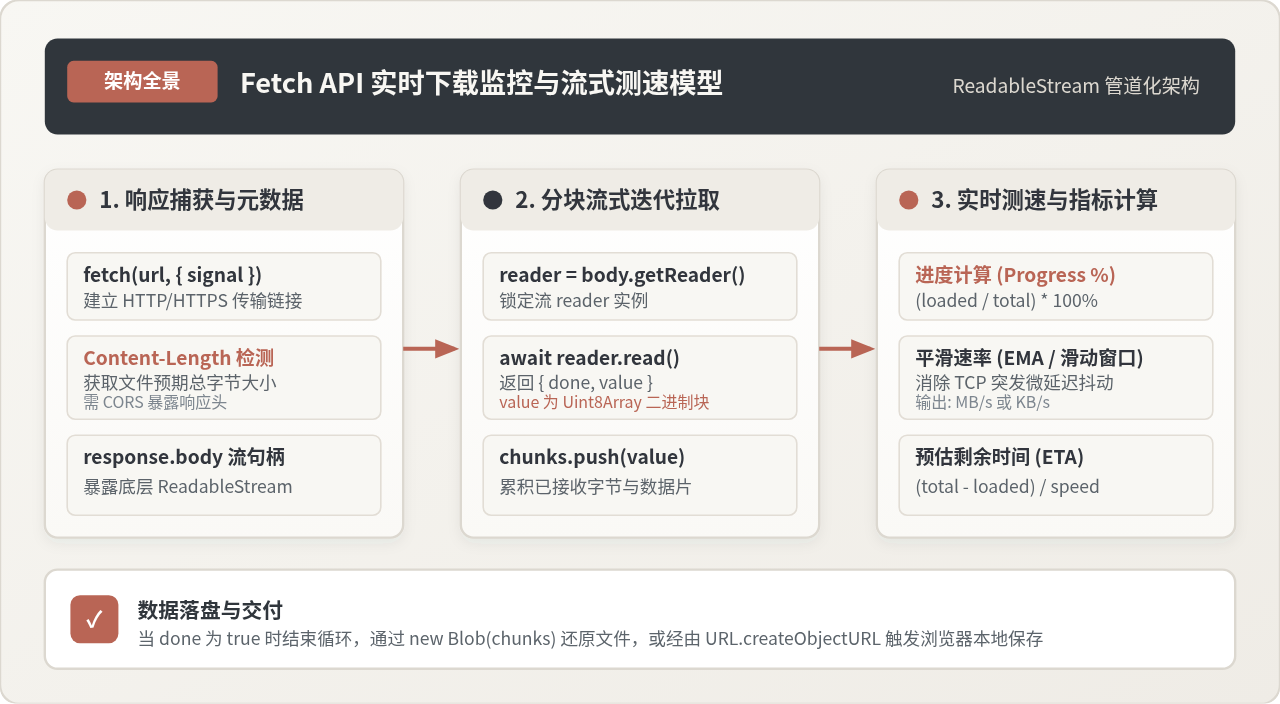
在现代 Web 应用中,当用户需要下载数百兆或数吉字节的安装包、离线数据集、视频素材或系统固件时,为用户呈现稳定可预期的下载进度条、实时传输速率以及剩余预估时间,是保障操作确定性与产品交互体验的关键要素。
传统的 XMLHttpRequest 原生暴露了 onprogress 事件,开发者可以直接通过事件对象的 loaded 与 total 属性计算百分比。然而,现代前端技术栈广泛采用基于 Promise 的 Fetch API。默认情况下,调用 const res = await fetch(url) 并使用 await res.blob() 会将整个响应完整缓冲在底层网络栈中,直到最后一个字节传输完毕后才一次性 resolve,中间过程对 JavaScript 呈现为完全的黑盒状态。
实际上,Fetch API 的响应体 response.body 是一个标准的 ReadableStream(可读字节流)。通过获取其底层的 reader 锁(response.body.getReader()),我们可以在数据从 TCP 缓冲区推送到 JavaScript 运行时环境时,逐块(Chunk)拦截接收。累加已接收字节并结合精确的时间差分计算,就能以原生代码实现精确的进度监控、高稳定度的下载测速以及剩余时间预估。
一、Fetch API 流式读取模型与元数据机制
要实现下载进度监控,首要任务是明确“期望下载的总量是多少”以及“如何拦截分段数据”。这依赖于 HTTP 响应头的配合以及 Streams API 的流式消费能力。
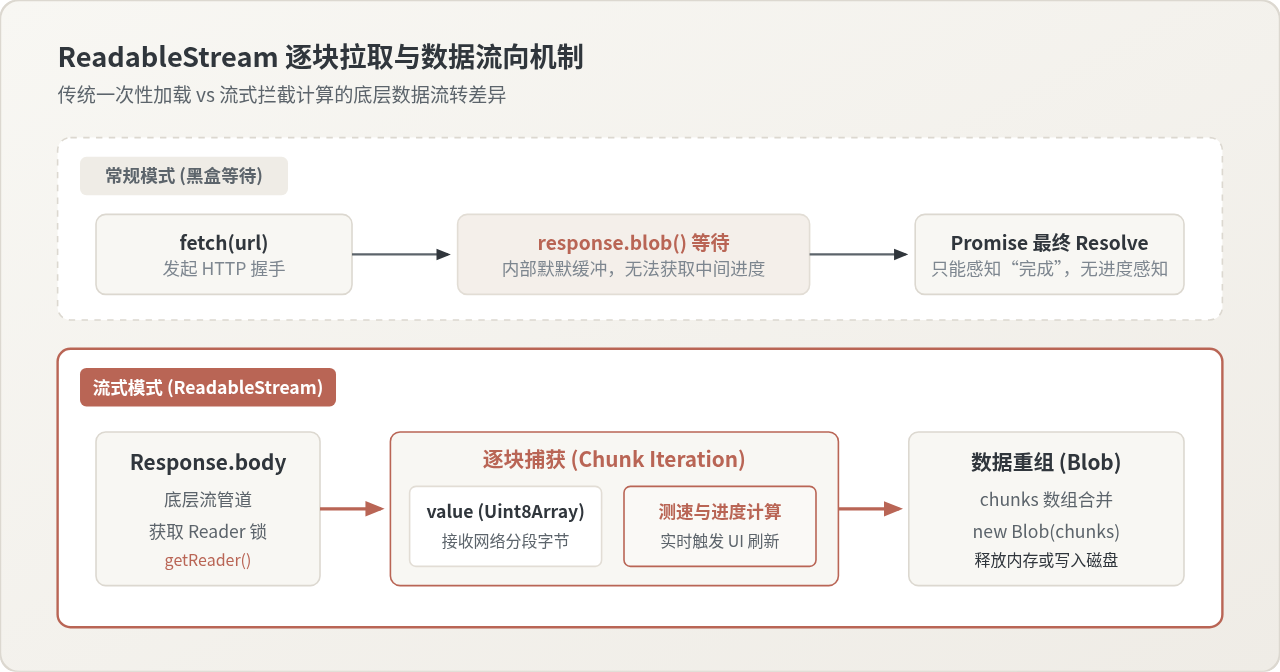
1. 获取文件总大小:Content-Length 的前置条件
在发起 fetch(url) 收到 Response 对象后,首先需要通过响应头 response.headers.get('content-length') 读取文件总字节数:
- 同源或正确配置 CORS:在跨域(CORS)下载场景下,浏览器的跨域安全策略默认只对 JavaScript 暴露六个基本响应标头(
Cache-Control、Content-Language、Content-Type、Expires、Last-Modified、Pragma)。若服务端未显式声明Access-Control-Expose-Headers: Content-Length,即便浏览器在 Network 选项卡能看到该标头,response.headers.get('content-length')返回的结果也依然是null。 - 分块传输编码(chunked transfer):如果服务端开启了
Transfer-Encoding: chunked或反向代理对响应进行了动态流式压缩且未计算预先长度,HTTP 协议将不包含Content-Length标头。此时无法预估具体百分比,程序需自动降级为“不定长流式下载”(即展示已下载体积与实时速度,进度条采用流光动画)。
2. 锁定并循环读取:ReadableStreamDefaultReader
通过调用 const reader = response.body.getReader(),我们获得了一个流锁,确保当前流排他性地被我们的代码消费。每次调用 await reader.read(),都会返回一个包含两项属性的 Promise 对象:
done(boolean):表示数据流是否已经到达尾部。为true时表示服务端已关闭输出流,数据传输完成。value(Uint8Array):包含当前网络包或缓冲区推送到内存的一个二进制数据块(Chunk)。其value.length即为该次接收到的字节长度。
二、实时测速与平滑降噪算法
很多开发者在初步实现流式监听时,会直接使用最朴素的公式:当前速度 = 当前分块字节数 / 距上次读取的时间间隔。但在实际网络传输中,这种方式会导致展示在 UI 上的速度数值出现疯狂抖动,甚至每秒跳动数十次,呈现极差的视觉体验。
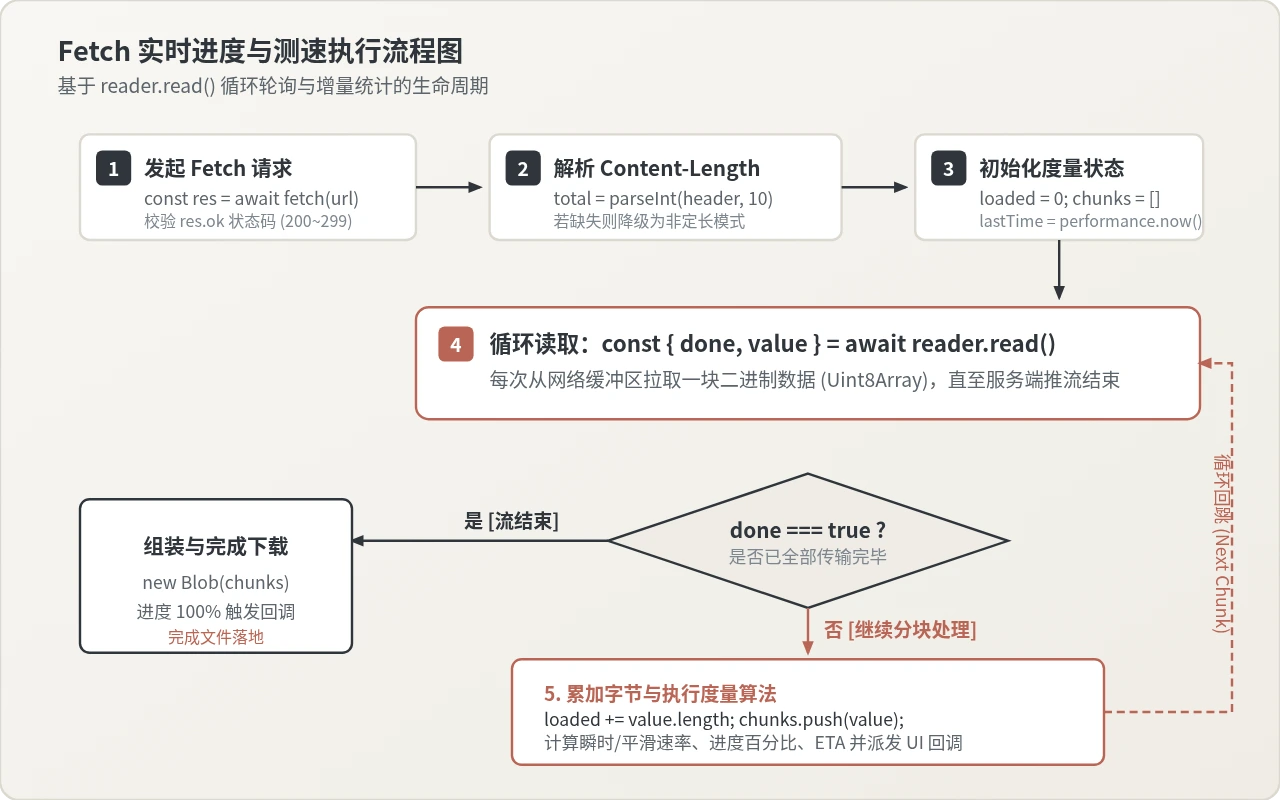
1. 为什么瞬时速度会出现剧烈跳变?
瞬时测速失真的根源在于网络传输协议与浏览器线程模型的协同机制:
- TCP 窗口与分段突发:底层 TCP 传输并不是连续均匀流动的,而是遵循滑动窗口与拥塞控制算法。网络包经常成批到达网卡缓存,随后被浏览器批量交织给 JavaScript 引擎,产生所谓的分包爆发(Packet Bursts)。
- 事件循环与微任务调度:JavaScript 处于单线程事件循环中,渲染帧更新、定时器回调和微任务队列会导致
await reader.read()恢复执行的间隔从不足 1 毫秒波动到 20~50 毫秒不等。 - 分母接近零导致数值尖峰:当相邻两个 chunk 到达时间间隔极短(如 Δt < 2ms)时,除法运算会得出极其夸张的峰值(例如数百 MB/s),紧随其后下一个微任务调度等待中又测出接近 0 的速率。
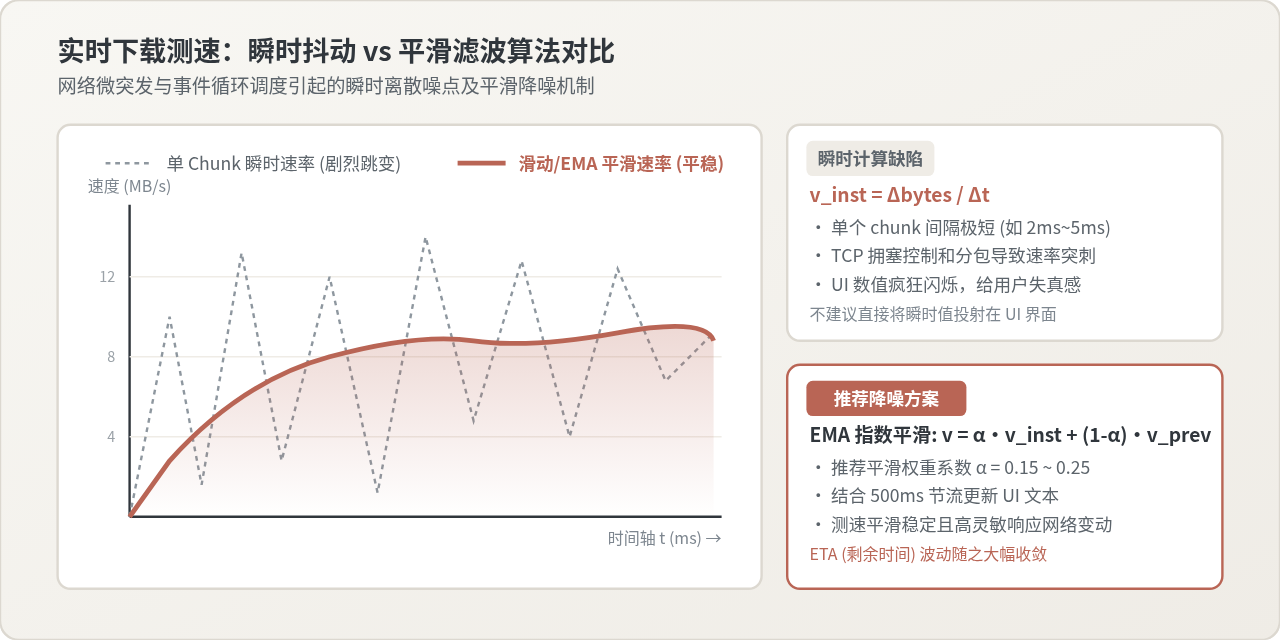
2. 平滑算法方案:滑动时间窗口与 EMA 指数加权
为了滤除微延迟毛刺,还原真实平稳的下载体验,通常采用两种工程降噪方法:
方案 A:滑动时间窗口统计(Sliding Time Window)
维护一个记录最近一段时间(如 1000 毫秒)内数据的队列。每次读取到 chunk 时,记录当前时间戳和累计接收字节。计算速度时,只用当前最新样本减去 1 秒前样本的差值:
速度 = (当前累计字节 - 1秒前累计字节) / (当前时间戳 - 1秒前时间戳)
该方案能天然消除突发峰值,且具有很强的物理直观性。
方案 B:指数加权移动平均(EMA,Exponential Moving Average,推荐)
如果希望节省数组维护开销与内存占用,可采用 EMA 算法。每次计算出当前周期的估算瞬时速率后,按权重衰减融合上一时刻的历史速度:
v_smooth = α · v_instant + (1 - α) · v_prev
其中平滑因子 α 取值建议在 0.15 ~ 0.25 之间。α 越小,曲线越平稳,对突发尖刺的免疫力越强;α 越大,对突发网络断速或加速的跟踪响应越迅捷。
3. 预估剩余时间(ETA)的边界防御
剩余时间公式为:ETA = (总字节数 - 已下载字节数) / 平滑速率。在实现时需加入两处关键防御:
- 非定长或起始阶段:总大小未知或平滑速度为 0 时,显示
--:--,防止出现Infinity或NaN。 - 速率骤降极值保护:当网络短时冻结时,ETA 可能瞬间预测为数小时,应设定显示上限或平滑过渡。
三、完整可运行代码实现
下面是一个经过模块化设计的完整原生 JavaScript 实现方案。包含结构化的 HTML 容器、单位格式化工具函数、流式循环读取核心逻辑以及任务取消控制器(AbortController)。
/**
 * 格式化字节体积为易读单位 (B, KB, MB, GB)
 */
function formatBytes(bytes, decimals = 2) {
  if (!bytes || bytes <= 0) return '0 B';
  const k = 1024;
  const dm = decimals < 0 ? 0 : decimals;
  const sizes = ['B', 'KB', 'MB', 'GB', 'TB'];
  const i = Math.floor(Math.log(bytes) / Math.log(k));
  return parseFloat((bytes / Math.pow(k, i)).toFixed(dm)) + ' ' + sizes[i];
}

/**
 * 格式化秒数为 mm:ss 或 hh:mm:ss
 */
function formatTime(seconds) {
  if (!isFinite(seconds) || seconds <= 0) return '--:--';
  const sec = Math.round(seconds);
  const h = Math.floor(sec / 3600);
  const m = Math.floor((sec % 3600) / 60);
  const s = sec % 60;
  if (h > 0) {
    return `${h}:${m.toString().padStart(2, '0')}:${s.toString().padStart(2, '0')}`;
  }
  return `${m.toString().padStart(2, '0')}:${s.toString().padStart(2, '0')}`;
}

/**
 * 基于 Fetch API 的带进度与平滑测速下载核心函数
 * @param {string} url 文件下载地址
 * @param {object} options 配置项,支持 onProgress 回调与 signal 中断信号
 * @returns {Promise<Blob>}
 */
async function downloadWithProgress(url, options = {}) {
  const { onProgress, signal } = options;

  // 1. 发起网络请求
  const response = await fetch(url, { signal });
  if (!response.ok) {
    throw new Error(`HTTP 异常: ${response.status} ${response.statusText}`);
  }
  if (!response.body) {
    throw new Error('当前浏览器或响应不支持 ReadableStream 传输流');
  }

  // 2. 提取文件预估总长度
  const contentLengthHeader = response.headers.get('content-length');
  const total = contentLengthHeader ? parseInt(contentLengthHeader, 10) : 0;
  const hasTotal = !isNaN(total) && total > 0;

  // 3. 准备底层流 Reader 与指标累加器
  const reader = response.body.getReader();
  const chunks = [];
  let loaded = 0;

  // 测速状态控制
  let smoothSpeed = 0;       // 平滑速度 (Bytes/sec)
  const alpha = 0.2;         // EMA 平滑衰减因子
  let lastTime = performance.now();
  let lastLoaded = 0;
  let lastUiUpdate = 0;      // UI 刷新节流计时器

  // 4. 逐块迭代流数据
  while (true) {
    const { done, value } = await reader.read();

    if (done) {
      // 流结束,推送最终 100% 状态
      if (typeof onProgress === 'function') {
        onProgress({
          loaded: total > 0 ? total : loaded,
          total: total > 0 ? total : loaded,
          percent: 100,
          speed: smoothSpeed,
          speedFormatted: formatBytes(smoothSpeed) + '/s',
          eta: 0,
          etaFormatted: '00:00',
          done: true
        });
      }
      break;
    }

    // 累积字节并存入数据缓冲区
    chunks.push(value);
    loaded += value.length;

    const now = performance.now();
    const deltaMs = now - lastTime;

    // 每间隔 100ms 以上更新一次平滑速度采样
    if (deltaMs >= 100) {
      const deltaBytes = loaded - lastLoaded;
      const currentInstantSpeed = (deltaBytes / deltaMs) * 1000; // 换算为 Bytes/s

      if (smoothSpeed === 0) {
        smoothSpeed = currentInstantSpeed; // 初值启动
      } else {
        smoothSpeed = alpha * currentInstantSpeed + (1 - alpha) * smoothSpeed;
      }

      lastTime = now;
      lastLoaded = loaded;
    }

    // 控制 UI 回调频率:节流在每 150ms 左右刷新一次,避免高频修改 DOM 造成掉帧
    if (now - lastUiUpdate >= 150 && typeof onProgress === 'function') {
      const percent = hasTotal ? Math.min(100, (loaded / total) * 100) : null;
      const remainingBytes = hasTotal ? Math.max(0, total - loaded) : 0;
      const etaSeconds = (hasTotal && smoothSpeed > 0) ? remainingBytes / smoothSpeed : 0;

      onProgress({
        loaded,
        total,
        percent,
        speed: smoothSpeed,
        speedFormatted: formatBytes(smoothSpeed) + '/s',
        eta: etaSeconds,
        etaFormatted: formatTime(etaSeconds),
        done: false
      });

      lastUiUpdate = now;
    }
  }

  // 5. 将所有数据碎片合并为最终二进制 Blob
  return new Blob(chunks);
}
代码关键设计要点解析
- 高精度计时(performance.now):不使用
Date.now(),因为performance.now()提供微秒级相对时间戳,且单调递增不受系统时间校准修改的影响,测速分母更为精确。 - 节流机制避免渲染瓶颈:网络传输极快时,1 秒内可能调用上百次
reader.read()。如果每次循环都无差别调用onProgress并直接操作 DOM 修改进度条,会导致浏览器主线程大量时间消耗在重排(Reflow)与重绘(Repaint)上,反而拖慢了下载吞吐。代码中通过lastUiUpdate保证每 150ms 触发一次界面更新。 - Blob 重组:当
done为true时,new Blob(chunks)接收一个Uint8Array数组。底层浏览器引擎会直接在内存中建立连续引用,避免多余的内存拷贝。随后即可通过URL.createObjectURL(blob)触发下载落盘或展示在页面上。
四、生产级边界条件与注意事项
在实际生产部署中,网络环境复杂多变,仅仅掌握基础 API 仍可能遭遇各种静默失效问题。以下是排查与工程落地的核心边界矩阵。
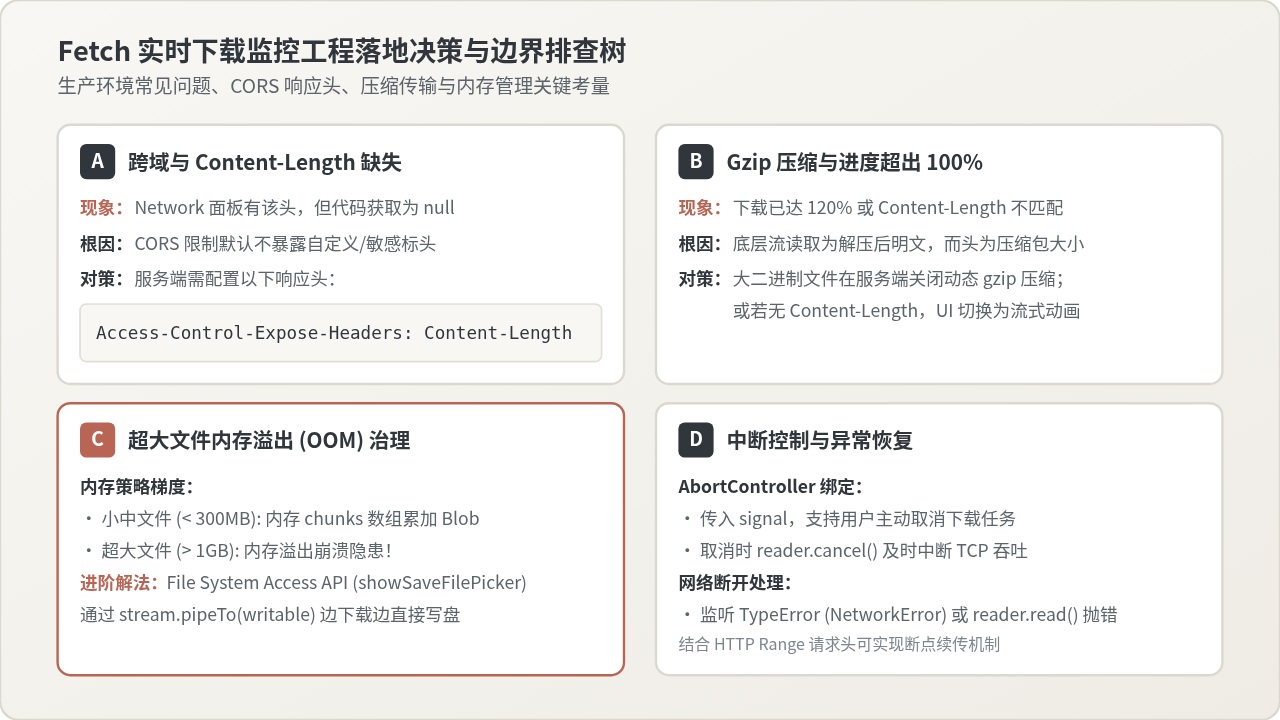
1. 响应头被浏览器屏蔽 (CORS Expose Headers)
当下游静态资源托管在云对象存储(如 OSS、S3、CDN)并与前端系统属于不同域名时,必须在对象存储的跨域规则中添加配置:
Access-Control-Expose-Headers: Content-Length如果忽略该配置,前端调用 headers.get('content-length') 会恒为 null,导致进度条永远处于 0% 或不定长状态。
2. Gzip / Brotli 动态压缩引起的“进度超出 100%”陷阱
这是一个经典的边缘案例:当服务端对文件开启了自动化 HTTP 压缩(如 Nginx 配置了 gzip on)时:
- 服务端返回的
Content-Length是压缩后的网络包体积(例如 3 MB)。 - 而浏览器的 Fetch API 底层网络栈会自动解压流,
reader.read()输出的value是解压后的真实文件体积(例如 10 MB)。 - 此时
loaded累加很快会突破 3 MB,导致计算出的(loaded / total) * 100%出现 150%、300% 甚至爆表,引发进度条错乱。
工程排查建议
对于视频(.mp4)、归档包(.zip、.tar.gz)、安装程序(.exe、.dmg)等原生已是高压缩格式的二进制大文件,务必在 Web 服务器(Nginx/Apache)中配置排除名单,对这些 MIME 类型关闭动态二次 gzip/brotli 压缩,保持 Content-Length 与实际传输体严格一致。
3. 超大文件(> 1GB)的内存溢出(OOM)风险
在本文上述示例中,我们使用了 chunks.push(value) 在 JavaScript 内存中存储分块。这在下载 100MB ~ 300MB 以内的常规文件时没有问题,但在处理数吉字节的超大视频或镜像时,会造成浏览器标签页内存急剧暴涨,甚至直接引发浏览器渲染进程崩溃(Crash)。
对于超大文件流式落地,推荐的技术方案演进为:
- 方案 A(现代浏览器推荐):结合
window.showSaveFilePicker()(File System Access API)。在用户选取本地目标文件后获取FileSystemWritableFileStream,在while循环中读取到value后直接await writable.write(value)写盘,无需在内存中维护chunks数组,内存占用恒定在数十 KB 级别。 - 方案 B:采用 Service Worker 配合 Streams API 拦截下载请求,实现端到端的透明流式下载落盘。
4. 任务取消与资源释放
网络任务应随时具备可取消能力。通过将 AbortController 的 signal 传递给 fetch:
const controller = new AbortController();

// 触发下载
downloadWithProgress('https://example.com/large-file.zip', {
  signal: controller.signal,
  onProgress: (metrics) => console.log(metrics)
}).catch(err => {
  if (err.name === 'AbortError') {
    console.log('用户已取消下载');
  } else {
    console.error('下载出错:', err);
  }
});

// 在需要中断时调用 (例如用户点击取消按钮或离开页面组件卸载)
controller.abort();
调用 abort() 后,浏览器会立即向底层发送 TCP FIN/RST 报文断开连接,同时 reader.read() 会抛出 AbortError 终止循环,防止后台无效消耗用户的网络带宽与电池电量。
五、技术总结与最佳选型建议
| 对比维度 | XMLHttpRequest (onprogress) | Fetch API + ReadableStream |
|---|---|---|
| 代码范式 | 事件驱动回调模型,语法偏传统 | 现代 Promise + async/await 异步流水线 |
| 进度感知能力 | 原生具备 event.loaded / event.total | 需通过 ReadableStreamDefaultReader 手动累加 |
| 实时测速扩展 | 需在 onprogress 事件中手动计算时间差 | 可自由挂接滑动窗口、EMA 或高级流式变换管道 |
| 大文件流式落盘 | 必须全量进入内存 responseBlob | 天然支持通过 ReadableStream 管道流向本地磁盘 |
| 架构适用性 | 老旧系统维护、简单脚本封装 | 现代前端框架、微前端工程、高性能流式传输平台 |
通过本文的解析可以看出,虽然 Fetch API 没有以单一事件的形式暴露进度接口,但其暴露的 ReadableStream 为开发者提供了更高层级、更具可控性的底层数据通道。配合清晰的响应头校验、基于 EMA 的平滑测速公式和节流渲染策略,不仅能够精准呈现文件下载的速率与预估时间,更能为构建工业级健壮的 Web 传输架构奠定扎实基础。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章