
本文详细讲解在不支持URLSearchParams的旧版浏览器中,如何利用JavaScript正则表达式高兼容、轻量级地解析URL查询参数,涵盖单参数提取、全量对象解析、特殊字符转义与防崩溃容错机制。

当前位置:首页 > JavaScript 基础 > 正文
JS怎么通过正则表达式兼容旧浏览器解析URL参数
作者:流萤
时间:2026-11-02
浏览:556
文章目录
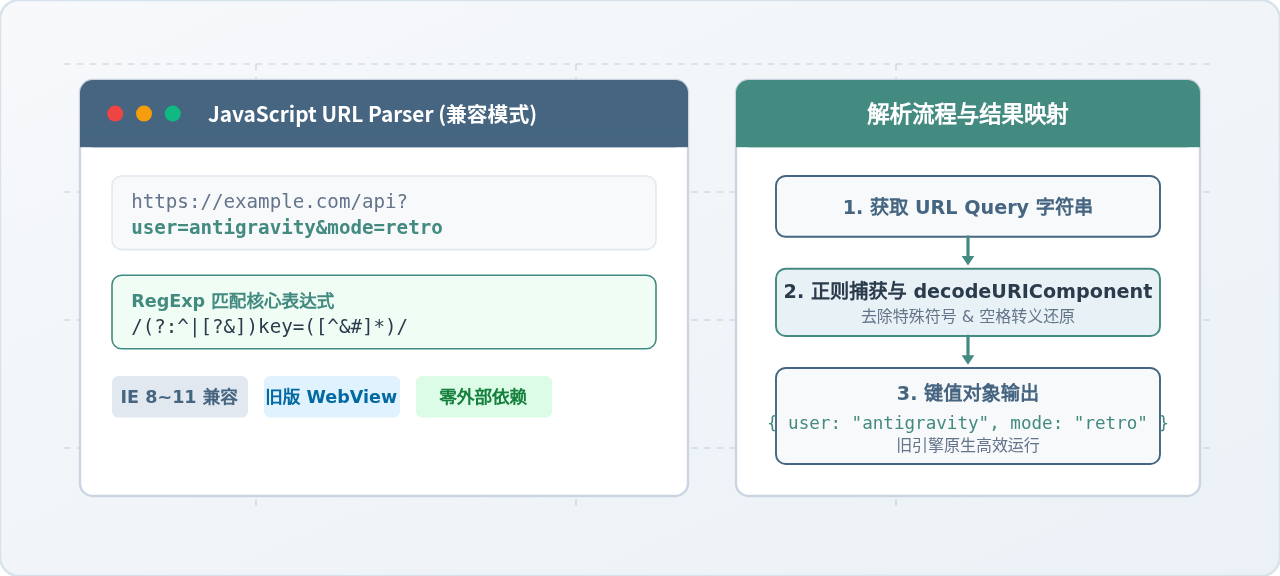
在 Internet Explorer 8~11、旧版 Android 内嵌系统 WebView 或各类早期渲染引擎中,现代 Web 标准提供的 URLSearchParams 和 URL 构造函数并不受支持。面对这些环境,直接引入重量级 Polyfill 补丁包会增加额外网络传输开销并拖慢旧终端的脚本解析速度。通过原生 JavaScript 的正则表达式配合 decodeURIComponent,只需十几行轻量代码即可实现零依赖、高容错、跨浏览器的 URL 查询参数解析方案。
一、为什么需要用正则表达式兼容旧浏览器
在现代前端开发中,获取地址栏参数通常只需调用 new URLSearchParams(location.search).get('key')。然而在实际工程维护中,许多企业内部系统、政企专网终端、银行自助终端以及运行在 Windows 7 甚至旧版嵌入式系统上的定制浏览器仍然广泛存在。这些环境对于现代标准的 API 支持为零。
如果引入第三方的 url-search-params-polyfill,通常会给项目打包结果增加数千字节的代码体积,且容易受到老旧引擎的原型链继承缺陷影响。而正则表达式(RegExp)作为 ECMAScript 3 的核心内置能力,从 JavaScript 诞生之初就被所有浏览器完整支持,具有执行效率高、无外部依赖、打包体积接近于零的显著优势。
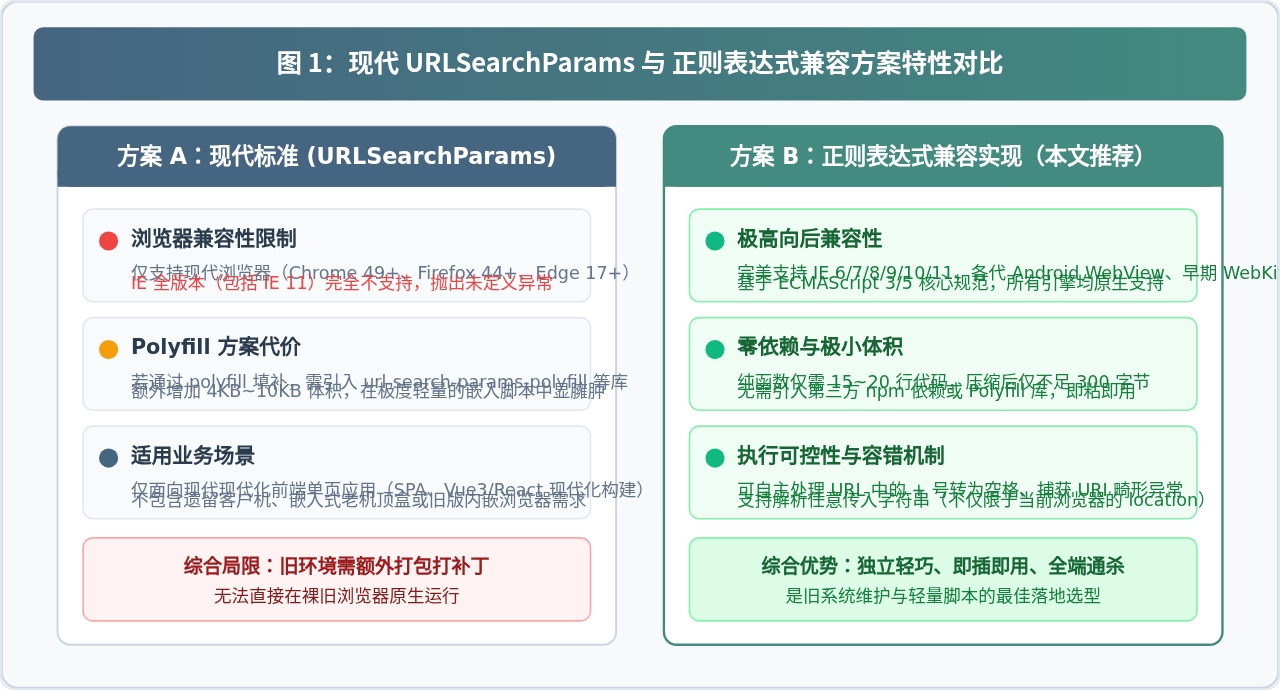
通过上图的对比可以看到,正则表达式方案既可以在现代浏览器中平滑运行,也可以在 IE 6~11 等所有遗留宿主环境中无缝执行。在轻量级 SDK 植入、数据埋点探针或老项目重构中,正则表达式是性价比最高的兼容解法。
二、提取单个参数的正则表达式实现与原理解析
针对“已知参数名,获取单个参数值”的高频需求,我们可以利用正则表达式的捕获分组机制来精确提取。
1. 核心正则表达式的构造
设目标参数名为 name,完整的匹配模式如下:
var reg = new RegExp('(?:^|[?&])' + safeName + '=([^&#]*)(?:[?&#]|$)');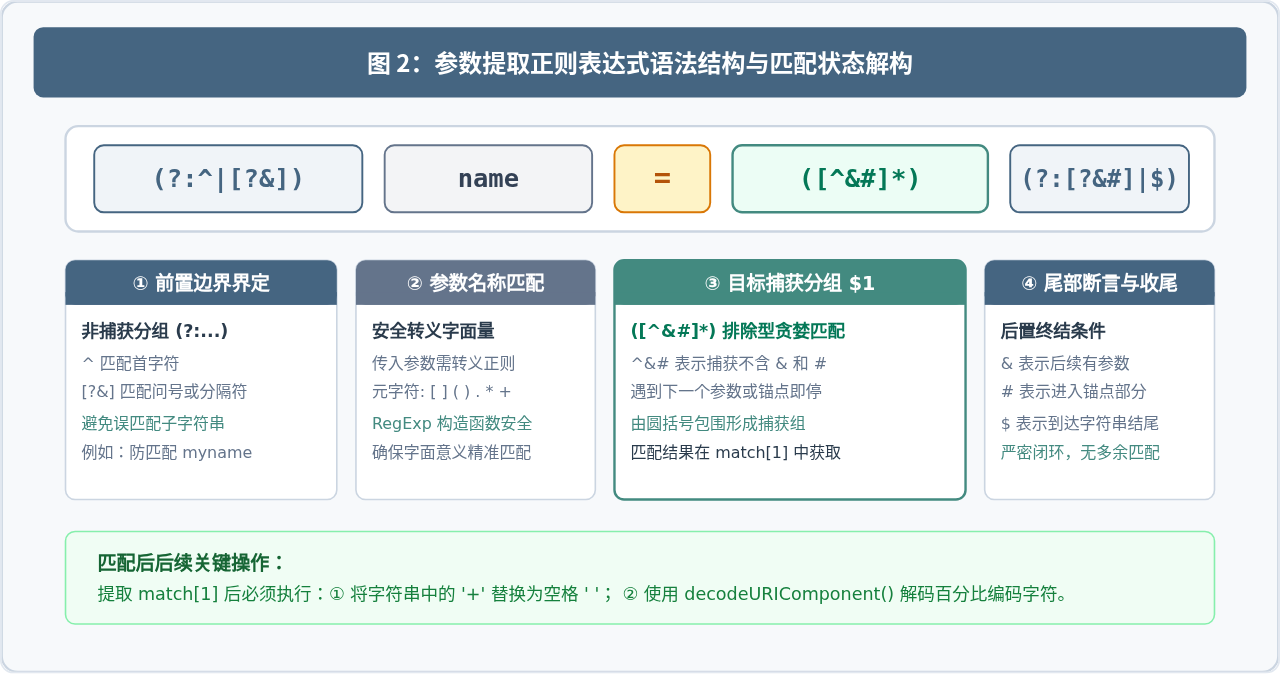
2. 正则关键分段原理解读
-
前置分界符
(?:^|[?&]):使用非捕获分组(由?:声明),表示匹配整个字符串的开头^,或者问号?,或者连接符&。这一步至关重要,它能防止名称部分重叠导致的误匹配。例如查询字符串为myname=123&name=456时,若没有前置分隔符界定,匹配name会错误地捕获到myname的后半截。 -
参数名转义
safeName:由于外部传入的键名可能包含正则元字符(例如[、]、$等),在动态拼入new RegExp()之前,必须先对其进行字符转义:name.replace(/[-[\]{}()*+?.,\^$|#\s]/g, '\$&')。 -
等号界定符
=:明确参数名与值之间的键值分隔符号。 -
目标值捕获分组
([^&#]*):使用小括号建立捕获组 1。内部的字符集排除声明[^&#]*会贪婪匹配所有不是&(下一个参数的分隔符)且不是#(页面锚点起始符)的字符。匹配到的实际内容会存放在结果数组的第 1 项(即match[1])。 -
后置终结断言
(?:[?&#]|$):确保该值在下一个参数、哈希片段或字符串尾部($)处自然终结。
3. 单参数获取函数的完整封装
在实际执行中,还需注意两点细节:一是 URL 规范中空格可能被编码为加号 +,需替换为空格字符;二是必须使用 decodeURIComponent 对百分比编码(如 %20、%E4%B8%AD%E6%96%87)进行解码,并用 try...catch 防范畸形编码引发的脚本中断。
/**
 * 获取指定 URL 查询参数的值(兼容旧版浏览器)
 * @param {string} name - 要获取的参数名称
 * @param {string} [url] - 待解析的 URL,缺省时取 window.location.href
 * @returns {string|null} 参数值,若未找到则返回 null
 */
function getQueryParam(name, url) {
  if (!name) return null;
  // 兼容无参传入,默认读取当前页面地址
  var targetUrl = url || (window.location ? window.location.href : '');

  // 对名称中的正则特殊字符进行转义
  var escapedName = name.replace(/[-[\]{}()*+?.,\^$|#\s]/g, '\$&');
  var pattern = '(?:^|[?&])' + escapedName + '=([^&#]*)(?:[?&#]|$)';
  var regex = new RegExp(pattern);
  var match = targetUrl.match(regex);

  if (!match) {
    return null;
  }

  var rawValue = match[1] || '';
  // 将加号还原为空格
  var normalizedValue = rawValue.replace(/\+/g, ' ');

  // 容错解码处理
  try {
    return decodeURIComponent(normalizedValue);
  } catch (err) {
    // 当 URL 包含非法编码字符时,降级返回未解码值,避免阻断程序执行
    return normalizedValue;
  }
}
调用示例与验证
例如当前 URL 为 http://example.com/index.html?from=wechat&user=%E6%9D%8E%E9%9B%B7&query=hello+world#section:
getQueryParam('from')输出:"wechat"getQueryParam('user')输出:"李雷"(中文正常还原)getQueryParam('query')输出:"hello world"(加号转为空格)getQueryParam('age')输出:null(未配置参数正常回退)
三、批量解析所有参数为对象的完整操作步骤
若需要将 URL 中携带的所有参数一次性解析为普通的 JavaScript 键值对象(Key-Value Object),可以通过全局匹配正则(/g 标志)配合循环遍历实现。
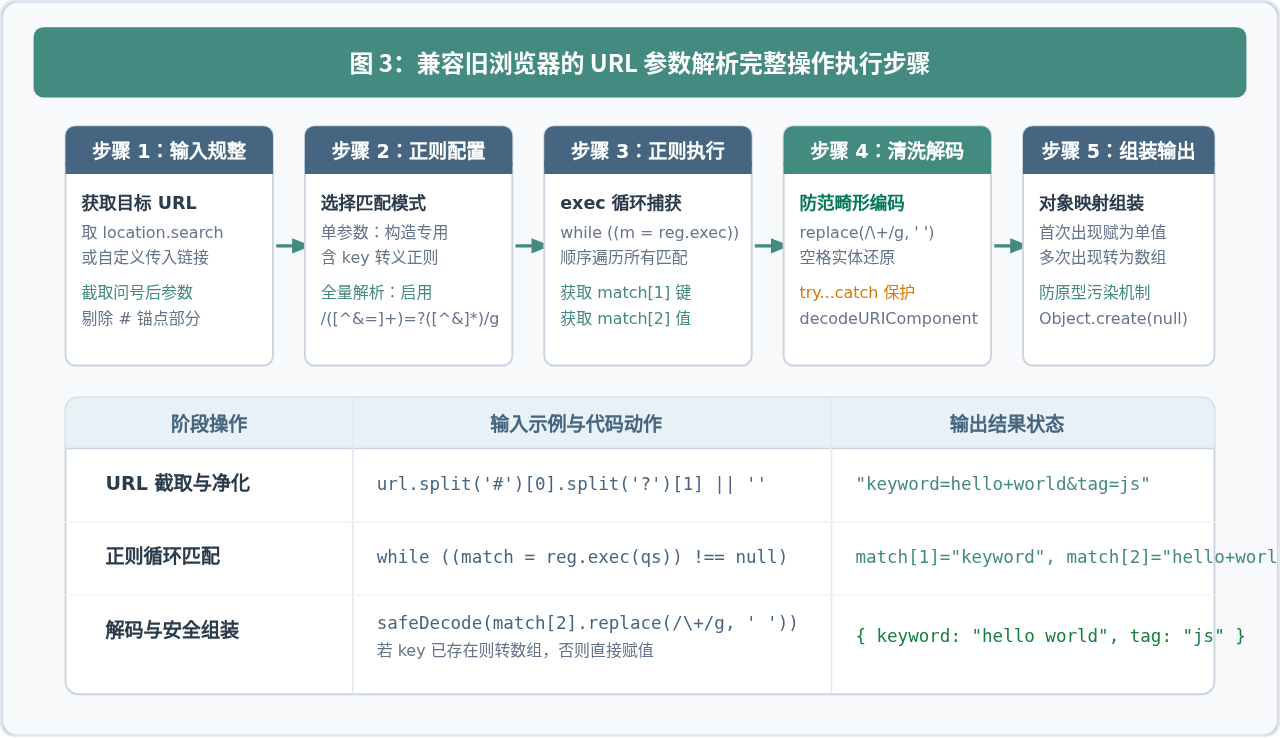
1. 操作步骤拆解
-
步骤 1:输入规整与锚点剥离。URL 中可能包含
#hash锚点片段,部分单页应用路由甚至存在/#/page?a=1这种特殊结构。标准做法是先提取问号?后面的查询段,并剔除#之后的内容,确保正则只作用于纯净的参数串。 -
步骤 2:定义通用键值对正则。使用
/([^&=]+)=?([^&]*)/g遍历每个参数项。第一个分组提取键名,第二个分组提取键值。 -
步骤 3:使用 RegExp.prototype.exec() 进行全局循环。在旧版 JS 引擎中,
exec是最可靠的带状态循环方式。每次匹配成功后,正则对象的lastIndex自动后移,直到遍历完毕返回null。 -
步骤 4:键与值的解码清洗。分别对提取出的键和值执行
replace(/\+/g, ' ')和decodeURIComponent。 -
步骤 5:同名参数合并与结果组装。若同一参数名出现多次(如
?tag=js&tag=css),应自动将已有值升级为数组;针对没有等号的标志性参数(如?debug),可以赋予布尔值true或空字符串。
2. 批量解析函数的完整代码实现
/**
 * 将 URL 查询字符串完整解析为键值对象(兼容旧版浏览器)
 * @param {string} [url] - 待解析的完整 URL 或查询字符串
 * @returns {Object} 参数字典映射对象
 */
function parseQueryParams(url) {
  // 使用 Object.create(null) 规避原型链污染;若环境极老不支持则降级为 {}
  var result = Object.create ? Object.create(null) : {};
  var targetUrl = url || (window.location ? window.location.href : '');
  if (!targetUrl || typeof targetUrl !== 'string') {
    return result;
  }

  // 提取问号之后的查询字符串,并剥离锚点
  var questionIdx = targetUrl.indexOf('?');
  if (questionIdx === -1) {
    return result;
  }

  var queryString = targetUrl.substring(questionIdx + 1);
  var hashIdx = queryString.indexOf('#');
  if (hashIdx !== -1) {
    queryString = queryString.substring(0, hashIdx);
  }

  if (!queryString) {
    return result;
  }

  // 核心正则:匹配 键名=键值,兼顾只有键名无等号的情况
  var reg = /([^&=]+)(?:=([^&]*))?/g;
  var match;

  while ((match = reg.exec(queryString)) !== null) {
    var rawKey = match[1];
    var rawVal = match[2];

    // 清洗与安全解码键名
    var key;
    try {
      key = decodeURIComponent(rawKey.replace(/\+/g, ' '));
    } catch (e) {
      key = rawKey;
    }

    // 清洗与安全解码键值(若无等号则默认赋值 true)
    var val;
    if (rawVal !== undefined) {
      try {
        val = decodeURIComponent(rawVal.replace(/\+/g, ' '));
      } catch (e) {
        val = rawVal;
      }
    } else {
      val = true;
    }

    // 过滤原型特殊属性,防范安全风险
    if (key === '__proto__' || key === 'constructor' || key === 'prototype') {
      continue;
    }

    // 处理同名键情况:若已存在则升级为数组
    if (result[key] !== undefined) {
      if (Object.prototype.toString.call(result[key]) === '[object Array]') {
        result[key].push(val);
      } else {
        result[key] = [result[key], val];
      }
    } else {
      result[key] = val;
    }
  }

  return result;
}
四、边界异常处理与兼容性注意事项
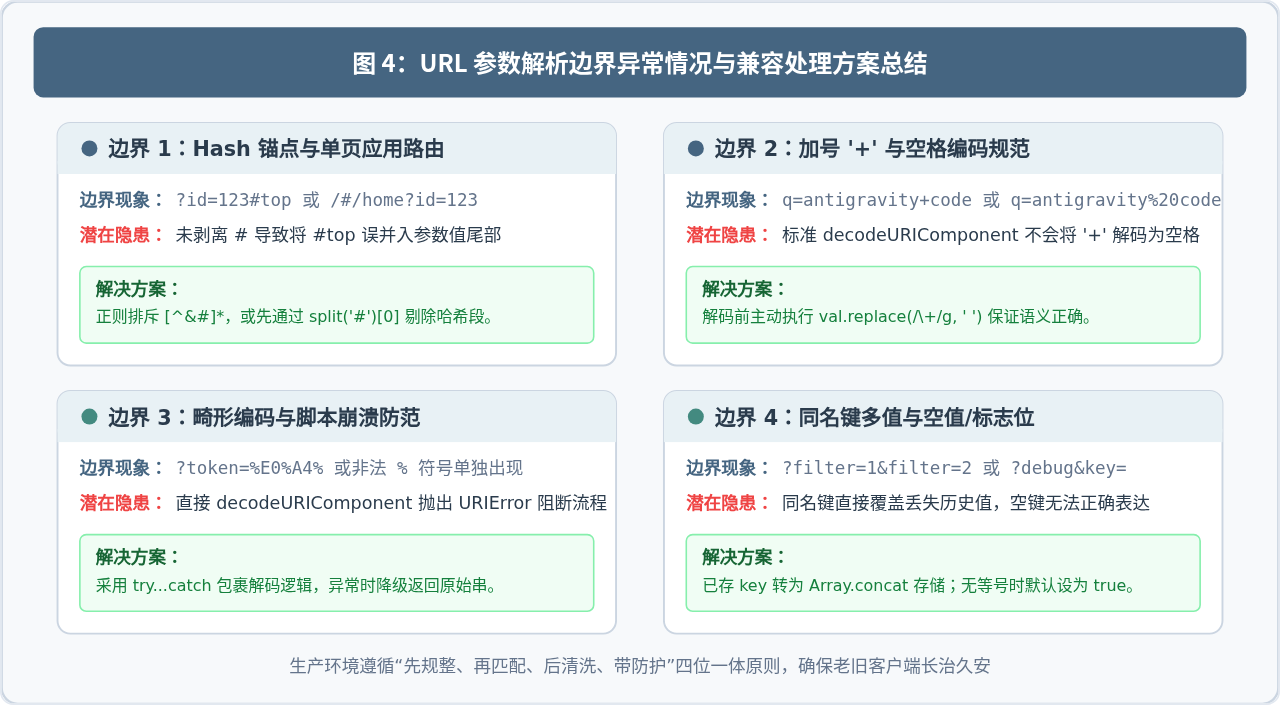
在老旧浏览器中运行 JavaScript 时,缺乏现代调试器完备的警告机制,极易因特殊输入造成静默失败或脚本抛错崩溃。以下四个边界细节需在实际业务中重点防御:
1. 空格与加号(+)的还原标准
根据 application/x-www-form-urlencoded 编码规范,表单在提交 GET 请求时会将空格转为 +。但在 JavaScript 标准的 decodeURIComponent 规范中,加号 + 是合法的 URI 字符,直接解码并不会转为空格。因此,在调用 decodeURIComponent 之前,必须主动执行 .replace(/\+/g, ' ')。
2. 非法 URI 编码防崩溃(URIError)
如果 URL 中存在由于剪贴板截断或错误拼接导致的畸形编码(例如 ?q=%E4%B8 后续字节缺失,或者仅包含单独的 %),调用 decodeURIComponent 时会直接抛出 URIError: URI malformed。在旧版 IE 中,该错误会导致页面后续脚本直接终止运行。务必使用 try...catch 包裹解码过程,在异常发生时退回到原始字符串。
3. 哈希锚点与单页路由(Hash History)
现代单页应用在兼容旧系统时,经常使用 Hash 路由机制(形如 http://example.com/#/list?category=1)。如果使用 window.location.search,旧浏览器中的 search 会是一个空字符串,因为 ?category=1 位于 # 后面。对于 Hash 路由,应传入完整的 window.location.href 进行解析,并在定位参数串时兼顾哈希内部的问号。
4. 原型污染(Prototype Pollution)防御
当解析结果直接挂载在普通对象 result = {} 上时,若恶意 URL 包含 ?__proto__[isAdmin]=true,在遍历赋值时可能篡改 Object.prototype。代码中主动排查 __proto__、constructor 和 prototype,或使用 Object.create(null) 作为字典容器,可以彻底杜绝此安全漏洞。
五、优雅降级:现代与旧环境协同的最佳实践
在实际项目封装通用工具函数时,最稳健的策略是“特性检测 + 优雅降级”:优先使用现代浏览器原生支持的高性能 URLSearchParams;当检测到当前运行环境处于旧版浏览器(如 IE 系列)缺少该构造函数时,自动无缝回退到本文编写的正则表达式解析器。
/**
 * 通用参数获取门面函数(现代优先,旧环境正则回退)
 */
function getParamCompat(name, url) {
  // 现代浏览器且无指定自定义 URL 时优先采用 URLSearchParams
  if (!url && typeof URLSearchParams !== 'undefined' && window.location) {
    var params = new URLSearchParams(window.location.search);
    return params.get(name);
  }
  // 旧版浏览器或自定义 URL 解析回退到轻量正则实现
  return getQueryParam(name, url);
}
通过这种模式,新浏览器能获得原生底层执行效率,老旧浏览器也能借助纯正 ECMAScript 原生特性稳定解析参数,兼具工程实现的现代化与向后兼容的完备性。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章