
深入讲解在JavaScript中校验中国大陆手机号时,如何优雅、健壮地清洗和处理用户输入中的半角/全角空格、连字符、不可见字符以及国际区号,并实现高可用、高容错的表单验证方案。

当前位置:首页 > JavaScript 基础 > 正文
JS校验手机号时怎么处理输入中的空格和特殊字符
作者:阿沐
时间:2026-10-30
浏览:208
文章目录
分类:前端开发工程与数据表单
运行环境:ECMAScript 5+ / 现代浏览器 / Node.js
适用范围:中国大陆11位手机号输入验证与清洗
在 JavaScript 中校验手机号时,最稳健的做法是将“数据清洗(Sanitization)”与“格式断言(Validation)”解耦为两步流水线:先在校验前主动剥除半角空格、全角空格、短横线、制表符及中国大陆国际长途区号(如
+86),提纯出11位纯数字字符串,再使用标准正则表达式 /^1[3-9]\d{9}$/ 进行规则匹配。千万不要试图编写一个能够兼容任意空格和特殊字符的复杂正则表达式,否则不仅容易引发性能问题与漏洞,更会严重降低代码的可维护性。
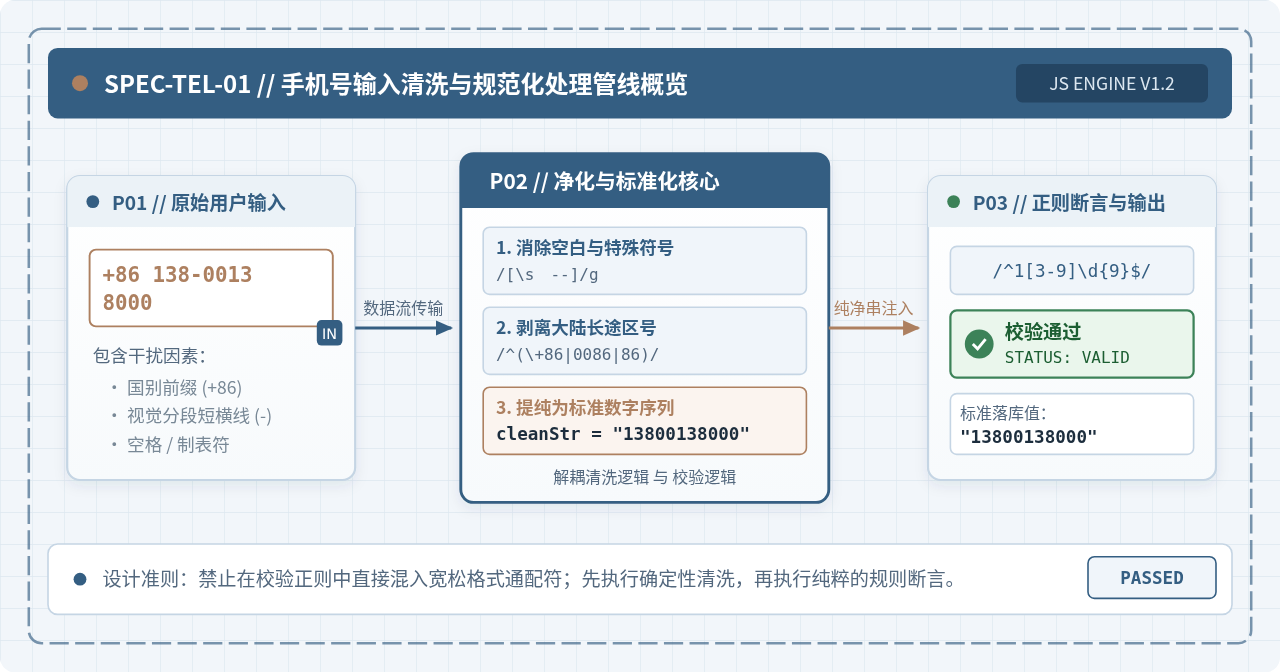
为什么不能直接在正则表达式中放宽特殊字符匹配?
很多初学者在遇到用户输入带空格(如 138 0000 0000)或短横线(如 138-0000-0000)时,第一反应往往是修改现有的正则表达式,例如写成:
// 典型脆弱反例:试图通过正则一次性兼容各种空格与符号
const fragileRegex = /^(\+86\s?)?1[3-9][\d\s-](9, 15)$/;
这种做法会带来三大工程隐患:
- 无法严格约束数字长度:由于混入了不定长度的空格或横杠,量词区间(如
{9,15})会导致10位数字加多个空格、或者12位非法数字被误判为合法。 - 漏网隐形字符:移动端剪贴板常常附带全角空格(
~)或制表符(\s难以完全涵盖所有极端边缘情况。 - 脏数据直接流入业务:即使正则校验通过,表单收集到的值仍然夹带杂质,若直接送往后端短信接口或数据库,会导致短信号码解析失败,或因字符串不一致导致重复注册。
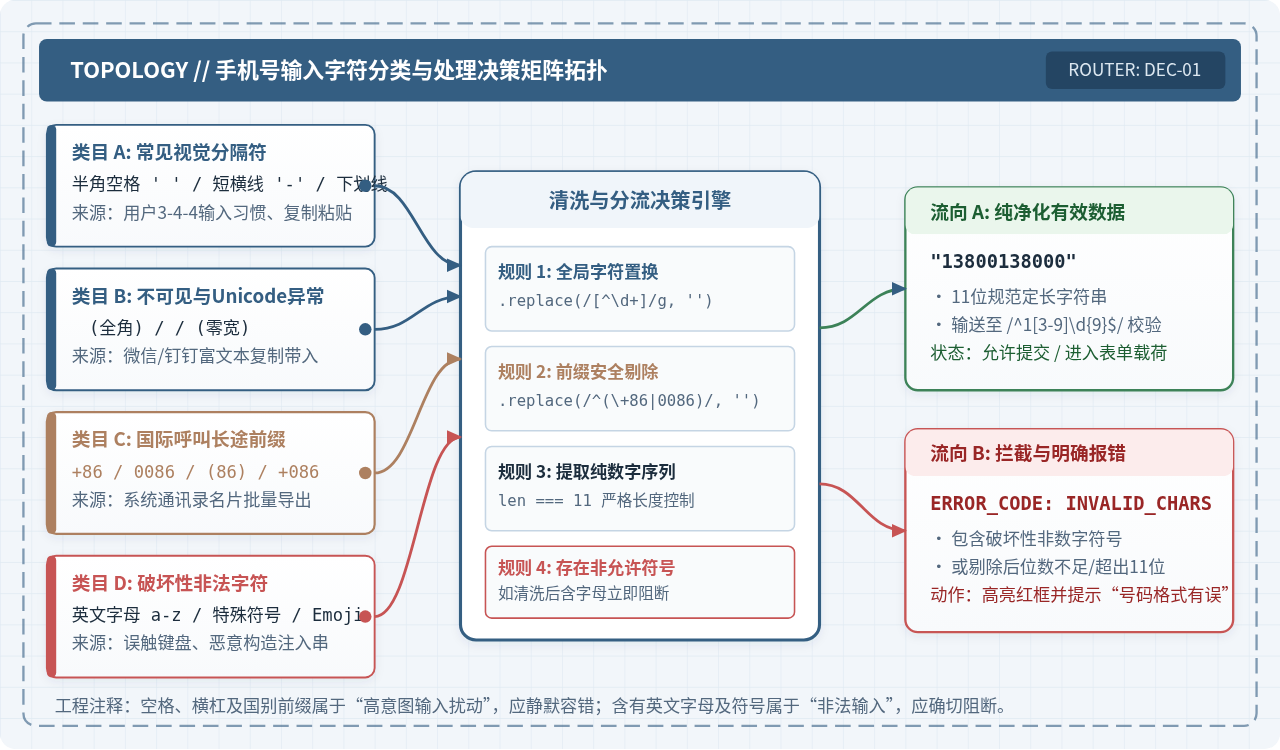
输入中的空格与特殊字符分类决策
用户的输入来源极为多样:键盘手动敲击习惯(习惯3-4-4分段)、移动端输入法自动联想、微信或通讯录名片批量复制。在进入校验流程前,系统需要对输入流中的字符进行明确的分类决策。
| 字符类别 | 常见表现形式 | 典型产生场景 | 系统处理策略 |
|---|---|---|---|
| 视觉分隔符 | 半角空格 ' '、连字符 '-'、下划线 '_' |
用户按 3-4-4 习惯分段,或通讯录名片默认格式 | 静默剥除 纳入纯数字流 |
| 不可见字符 | 全角空格 、制表符 、零宽字符 |
从网页富文本、邮件或微信聊天记录中复制 | 强制过滤 全局清除不可见码点 |
| 国际呼叫前缀 | +86、0086、(86)、+086 |
手机系统通讯录导出、国际格式电话簿 | 识别并剥离 收敛为国内11位主叫号 |
| 破坏性非法字符 | 英文字母、标点符号 @#$%^&*、Emoji |
错误输入、输错键盘、恶意构造探针数据 | 拦截阻断 提示格式不正确 |
标准化清洗与校验的五步执行流程
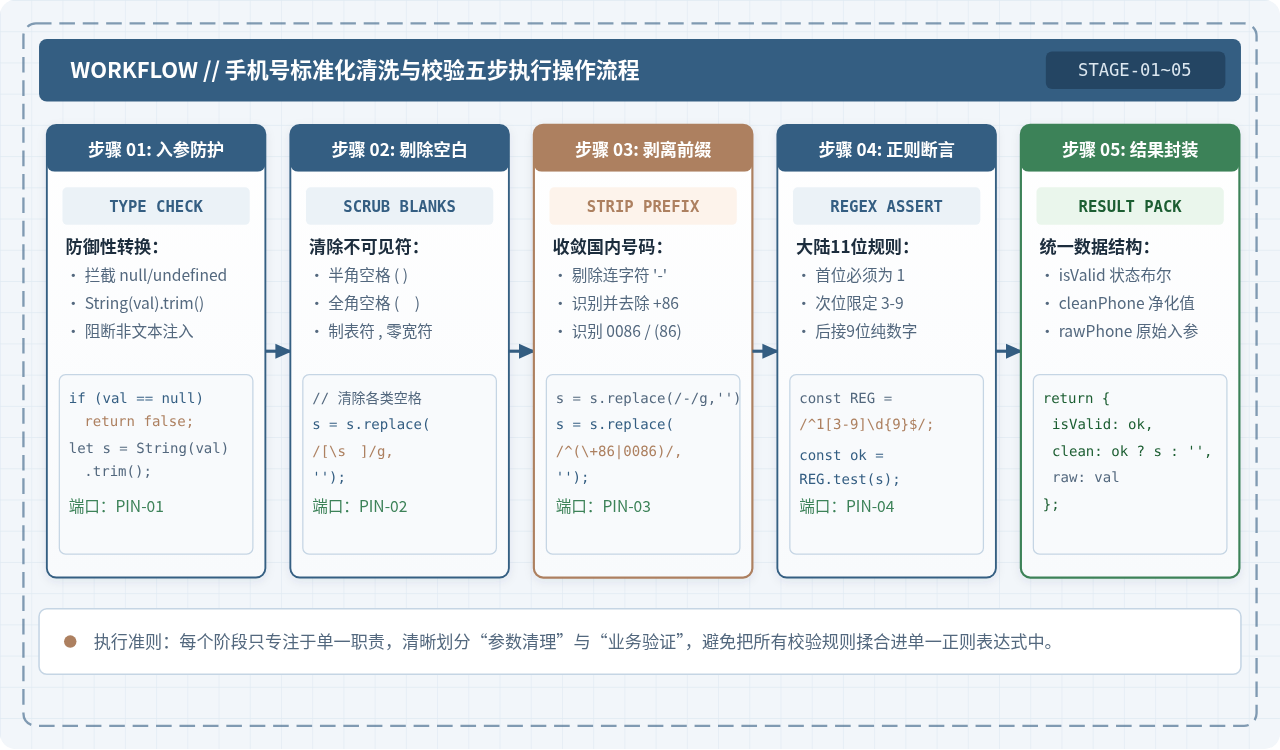
为了保证代码在前端或 Node.js 环境中具备生产级稳定性,应将整个处理过程划分为五个清晰的阶段:
- 步骤一:入参类型安全检查与初步裁剪
拦截null、undefined或数值类型,将其防御性转换为原生字符串,并调用原生trim()消除首尾空白。 - 步骤二:深度清洗不可见字符与空格
利用正则表达式全局匹配清除半角空格、全角空格( - 步骤三:剥离合法分隔符与国别前缀
移除连接符短横线-,并识别以+86、0086或86开头且后续跟随合法手机号的头部,将其统一裁剪为标准11位形式。 - 步骤四:执行精准正则表达式断言
基于工信部最新号段分配规则,中国大陆手机号均为11位纯数字,首位固定为1,第二位通常为3至9。使用严格锚定的正则/^1[3-9]\d{9}$/进行最终核验。 - 步骤五:打包结构化返回值
不仅仅返回布尔值,同时返回净化后的标准纯数字字符串和原始入参,方便表单提交逻辑直接取用净化值。
工业级通用校验函数实现代码
以下是具备强健容错能力的标准工具函数实现:
/** * 校验并清洗中国大陆手机号 * @param {any} input - 用户输入的原始数据(支持字符串或数字) * @returns {{ isValid: boolean, cleanPhone: string, rawPhone: string, error?: string }} */ function validateAndSanitizePhone(input) { // 步骤 1: 边界参数防御 if (input === null || input === undefined) { return { isValid: false, cleanPhone: '', rawPhone: String(input), error: 'EMPTY_INPUT' }; } const raw = String(input).trim(); if (!raw) { return { isValid: false, cleanPhone: '', rawPhone: raw, error: 'EMPTY_STRING' }; } // 步骤 2: 消除各类空格与不可见 Unicode 字符 ( 全角空格, - 零宽字符, BOM) let text = raw.replace(/[\s -]/g, ''); // 步骤 3: 消除合法视觉短横线及括号 (如 010-XXXX, 138-XXXX-XXXX) text = text.replace(/[-_()()]/g, ''); // 步骤 4: 识别并剥离中国大陆长途前缀 (+86 / 0086 / 86) // 仅当前缀剥离后剩余刚好为11位且以1开头时才安全剥离,防止误伤 86138... 等罕见自定义输入 if (/^(\+86|0086)/.test(text)) { text = text.replace(/^(\+86|0086)/, ''); } else if (/^861[3-9]\d{9}$/.test(text)) { text = text.slice(2); } // 步骤 5: 正则表达式严格断言(11位纯数字,1开头,次位3~9) const CHINA_PHONE_REGEX = /^1[3-9]\d{9}$/; const isValid = CHINA_PHONE_REGEX.test(text); return { isValid: isValid, cleanPhone: isValid ? text : '', rawPhone: raw, error: isValid ? undefined : 'INVALID_PHONE_FORMAT' }; }
测试用例覆盖与执行验证
为验证各种边界输入的处理表现,执行以下典型用例:
// 1. 常见分段空格与短横线输入
console.log(validateAndSanitizePhone("138 1234 5678"));
// 输出: { isValid: true, cleanPhone: "13812345678", rawPhone: "138 1234 5678" }

console.log(validateAndSanitizePhone("139-0011-2233"));
// 输出: { isValid: true, cleanPhone: "13900112233", rawPhone: "139-0011-2233" }

// 2. 全角空格与国际区号前缀
console.log(validateAndSanitizePhone("+86 186 8888 9999"));
// 输出: { isValid: true, cleanPhone: "18688889999", rawPhone: "+86 186 8888 9999" }

// 3. 夹带破坏性非法字符(拦截)
console.log(validateAndSanitizePhone("138-0013-800a"));
// 输出: { isValid: false, cleanPhone: "", rawPhone: "138-0013-800a", error: "INVALID_PHONE_FORMAT" }

// 4. 号码长度溢出或不足(拦截)
console.log(validateAndSanitizePhone("138 0000 0000 123"));
// 输出: { isValid: false, cleanPhone: "", rawPhone: "...", error: "INVALID_PHONE_FORMAT" }
前端交互模式的选择与权衡
在前端界面(UI)设计中,面对用户的输入习惯,通常有三种主流的工程处理策略:
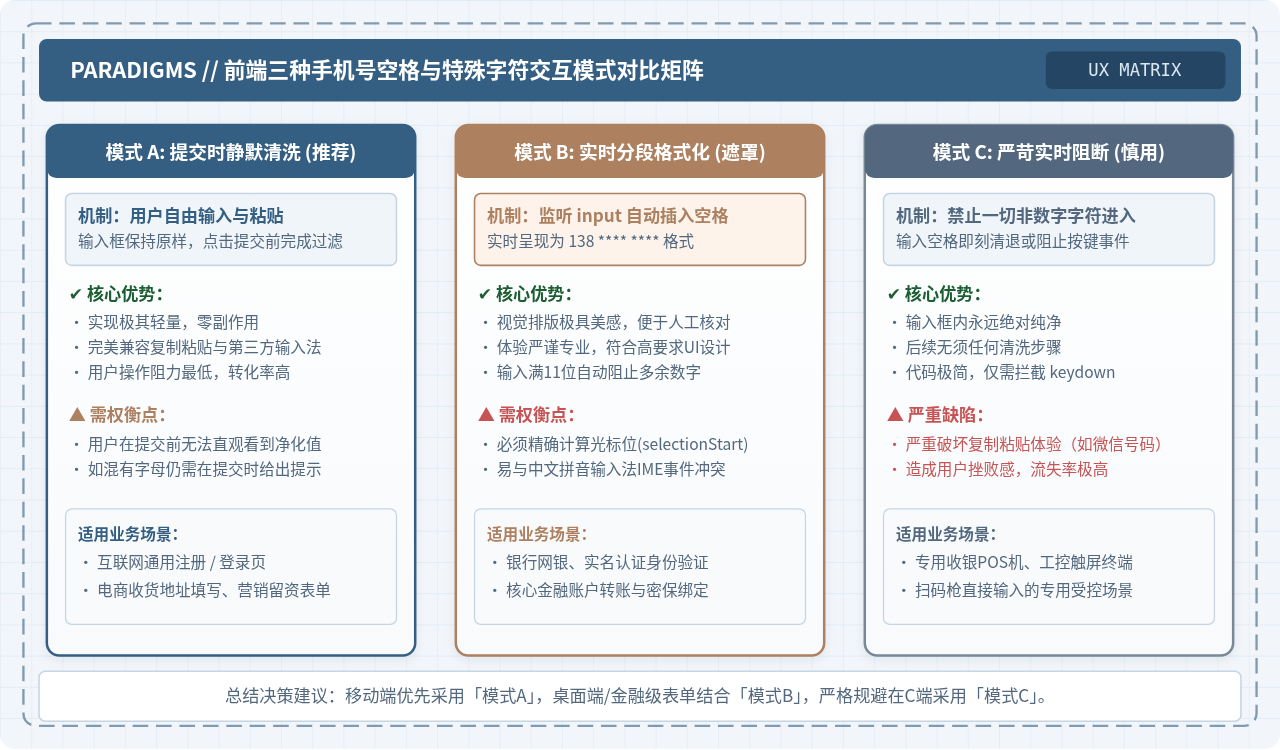
模式 A:提交时静默清洗(强烈推荐)
在该模式下,输入框不对用户的输入行为做任何强行阻断。用户无论是手动输入带有空格的文本,还是直接复制通讯录格式,输入框都忠实显示用户的输入。当用户点击“获取验证码”或“提交表单”时,前端在后台调用清洗函数提纯出11位纯数字,校验合法后将清洗后的净值打包发送给服务器。
最佳实践建议:在通用表单场景下,模式A的用户阻力最小,完全规避了各种移动端软键盘的兼容性问题,是推荐的默认方案。
模式 B:实时输入遮罩(3-4-4 格式化)
如果产品或设计规范要求输入框在用户键入时自动呈现 138 0000 0000 分段格式,则需要监听 input 事件进行实时格式化。需要注意的是,直接重设 input.value 会导致光标瞬间跳至文本末尾,影响用户在中间修改数字的体验。必须在重置值后通过 setSelectionRange 恢复光标位置:
function bindPhoneFormatter(inputElement) {
  inputElement.addEventListener('input', (e) => {
    const input = e.target;
    const rawCursor = input.selectionEnd;
    const rawValue = input.value;

    // 1. 仅提取纯数字,且最多保留 11 位
    const digits = rawValue.replace(/\D/g, '').slice(0, 11);

    // 2. 重组为 3-4-4 结构
    let formatted = '';
    if (digits.length > 0) formatted += digits.slice(0, 3);
    if (digits.length > 3) formatted += ' ' + digits.slice(3, 7);
    if (digits.length > 7) formatted += ' ' + digits.slice(7, 11);

    // 3. 计算格式化后的光标合理偏置
    const spacesBeforeCursor = (formatted.slice(0, rawCursor).match(/ /g) || []).length;
    const oldSpacesBeforeCursor = (rawValue.slice(0, rawCursor).match(/ /g) || []).length;
    const newCursor = rawCursor + (spacesBeforeCursor - oldSpacesBeforeCursor);

    input.value = formatted;
    input.setSelectionRange(newCursor, newCursor);
  });
}
生产环境常见踩坑与注意事项
- 输入法拼音组合(IME Composition)陷阱:在移动端浏览器或部分中文输入法中,输入拼音字母时会触发
compositionstart与compositionend事件。如果在拼音未确认时强行过滤字符,会导致输入法选词异常中断。因此在实时遮罩逻辑中,应当在确认合成结束后再执行替换。 - 浏览器自动填充(Autofill)的兼容:密码管理器或系统自动填充可能一次性填入带有国际区号(如
+8613800000000)的值,且不会触发普通的按键事件。因此,所有提交校验逻辑必须以当前 DOM 的真实值进行完整管道清洗,不得假设输入框里的内容一定是用户按键输入的。 - 国际化业务边界:本文的清洗逻辑针对的是中国大陆(+86)手机号。若业务未来需要支持海外手机号(如中国香港 +852、美国 +1 等),则不能粗暴固定剥离为11位纯数字,而应引入支持国际电联 E.164 规范的国际手机号解析方案(例如结合独立的国家代码选择器)。
总结:构建全链路防御闭环
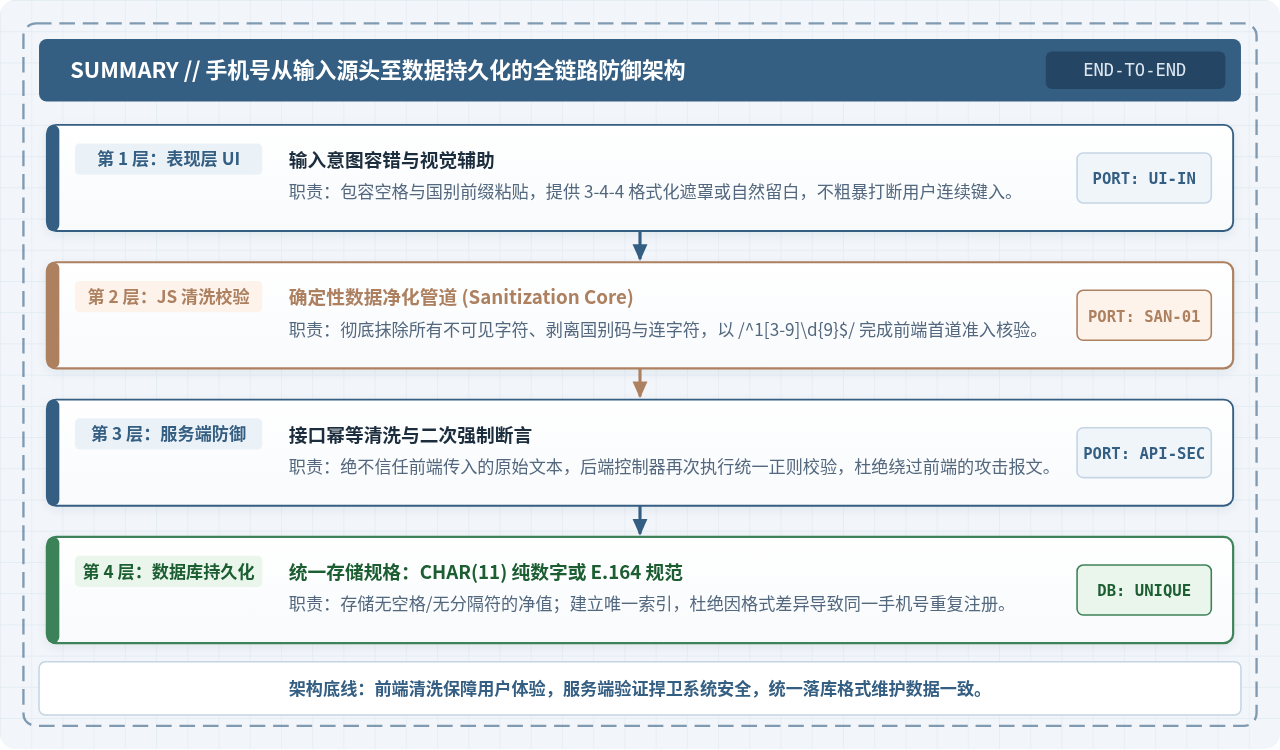
处理手机号中的空格与特殊字符,本质上是一项兼顾用户体验与数据质量的基础工程。通过前端清洗降低用户操作门槛,通过服务端再次验证防御绕过攻击,并在数据库中统一以11位纯数字定长字符串落库,才能构建起严密可靠的手机号处理管线。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章