
深入讲解在JavaScript中创建和处理每行长度不同的锯齿状二维数组(Jagged Array)的核心机制、四种实用创建方案、引用共享避坑要点与安全遍历实践。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JavaScript创建每行长度不同的锯齿状二维数组
作者:半夏
时间:2026-10-30
浏览:431
文章目录
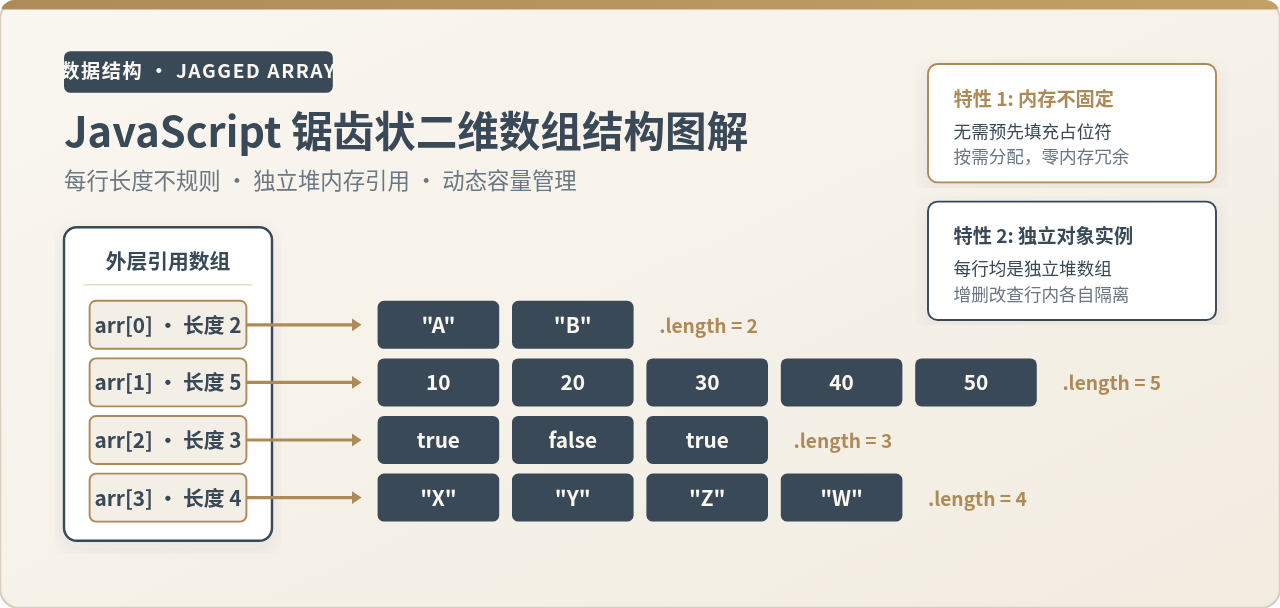
在 JavaScript 中创建每行长度不同的锯齿状二维数组(Jagged Array),核心在于利用其“数组的数组”(Array of Arrays)机制——外层数组并不维护固定长宽的物理矩阵,而是保存一组独立的对象引用。只要为外层数组的每个位置分别实例化具有不同长度的内层数组,即可自然构建出不规则的二维数据结构。
一、认识锯齿状二维数组与 JavaScript 的存储特性
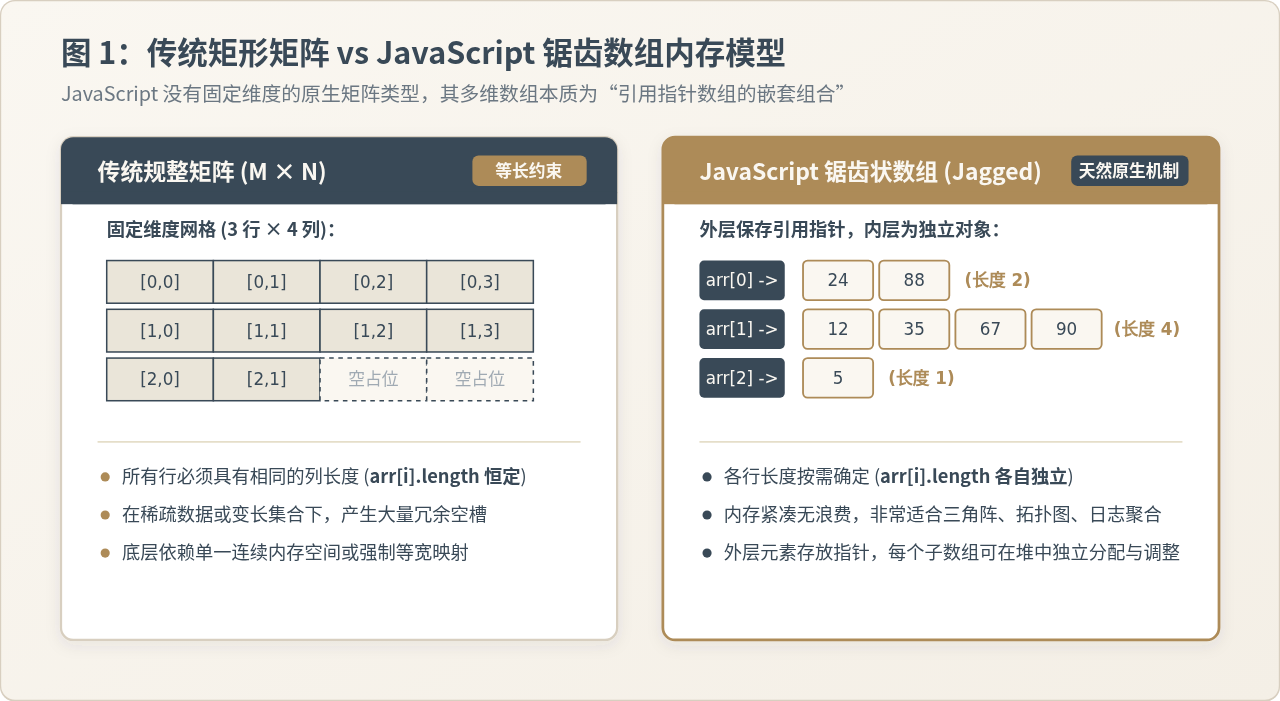
在很多静态编译语言(如 C 或早期 Fortran)中,二维数组通常要求在声明时指定固定的行数和列数(例如 int matrix[3][4]),并在内存中分配一块严格连续且规整的矩形存储区。如果数据行长不一,开发者往往需要分配最大可能列宽,并通过特殊标记符占位,这会产生不必要的内存冗余。
而锯齿状二维数组(Jagged Array,又称交错数组或不规则二维数组)则是指:外层数组的每个元素都是一个独立的子数组,且各个子数组的元素个数(即行长度)允许互不相同。
JavaScript 语言层面并没有原生的“多维数组”独立类型。在 JavaScript 中,任何所谓的二维数组本质上都是一维数组的嵌套组合。外层数组的槽位中存储的是指向各个内层数组实例的引用指针,每个内层数组在 V8 引擎等运行时的堆内存中都是完全独立的对象,各自拥有专属的 length 属性与原型链。这种存储模型赋予了 JavaScript 天然支持锯齿状结构的优势。
二、构建锯齿状二维数组的核心操作流程
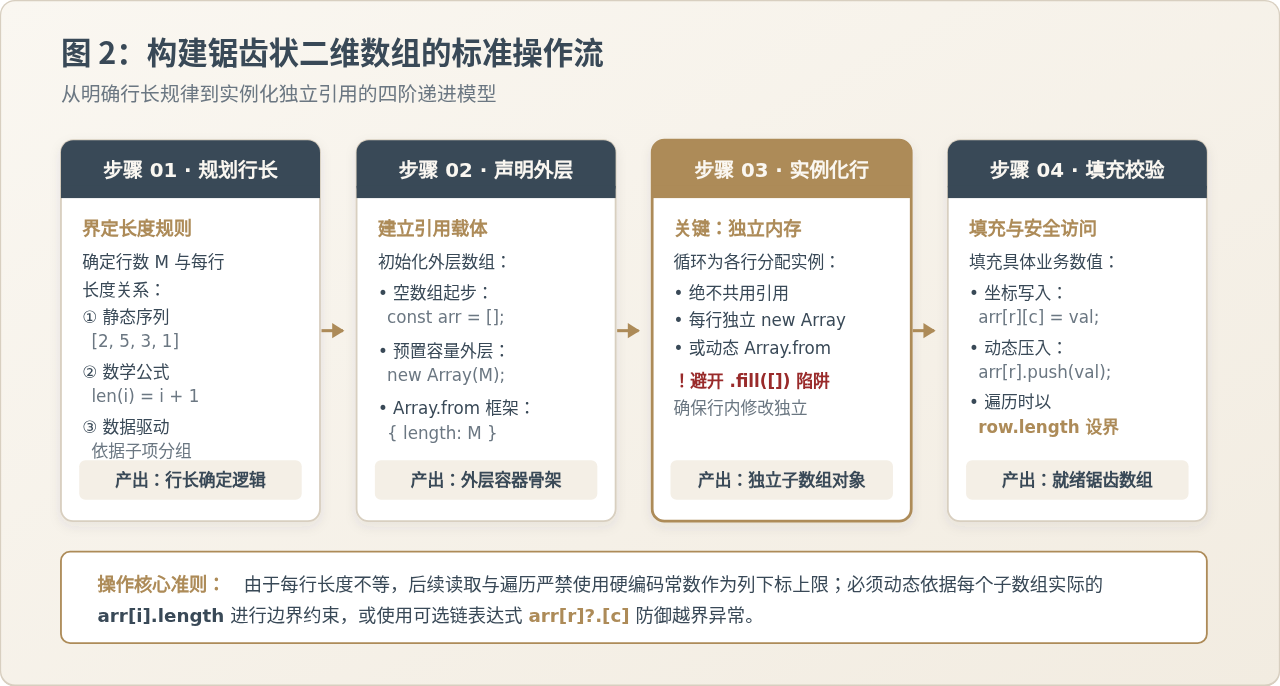
无论业务场景如何变化,动态构建一个可靠的锯齿状二维数组通常遵循统一的递进顺序。明确操作步骤有助于在编写复杂数据转换时不遗漏关键细节。
- 确定行长规格与映射逻辑:明确整个数组的总行数 M,以及每行长度是如何决定的。行长可以是静态已知的(如配置文件给定的序列),也可以是由数学公式推导的(如杨辉三角第 i 行有 i+1 个元素),或是由流式数据实时计算得出的。
- 声明外层容器载体:定义最外层的容器变量,可以声明为空数组
[],也可以借助new Array(rowCount)预留槽位。 - 逐行实例化独立子数组:这是最关键的环节。必须在每次迭代中通过构造器、高阶回调或字面量生成全新且独立的子数组实例并挂载到外层,绝对不能让多个外层槽位共享同一个子数组引用。
- 填充数据与边界确认:向各行具体槽位写入业务数值。在后续访问与遍历时,必须依据各行自有的
length边界进行操作,避免因列宽假设不当引发越界。
三、常用的四种创建实现方式与代码示例
在实际项目开发中,可以根据数据的来源形式、预知程度以及编码规范,从以下四种常见实现方式中选择最合适的一种。
1. 数组字面量直接定义(适合静态与小规模数据)
如果各行的长度与初始元素在编码阶段就已经完全固定,使用数组字面量 [] 是最简单直观的做法。代码没有任何抽象包装,可读性极高。
// 静态字面量声明锯齿状二维数组
const jaggedStatic = [
  [10, 20],               // 第 0 行:长度 2
  [30, 40, 50, 60],       // 第 1 行:长度 4
  [70],                   // 第 2 行:长度 1
  [80, 90, 100]           // 第 3 行:长度 3
];

console.log(jaggedStatic.map(row => row.length));
// 示例输出: [2, 4, 1, 3]
示例输出:各行长度分别为 2, 4, 1, 3,各自保持独立。
2. 使用 Array.from 动态构建(现代函数式、语义清晰)
现代 JavaScript 提供了强大的 Array.from() 静态方法。通过传递包含 length 属性的对象作为第一个参数,并在第二个参数映射回调函数中为每一行返回独立生成的新数组,可以一行代码优雅生成结构清晰的锯齿数组。
// 已知各行的目标长度序列
const rowLengths = [3, 1, 5, 2];

// 使用 Array.from 嵌套生成具有对应长度且填充初始默认值的锯齿数组
const jaggedFrom = Array.from({ length: rowLengths.length }, (_, rowIndex) => {
  const currentLen = rowLengths[rowIndex];
  // 每行创建独立数组并填充默认值
  return Array.from({ length: currentLen }, (_, colIndex) => `r${rowIndex}c${colIndex}`);
});

console.log(jaggedFrom);
示例输出:
[
["r0c0", "r0c1", "r0c2"],
["r1c0"],
["r2c0", "r2c1", "r2c2", "r2c3", "r2c4"],
["r3c0", "r3c1"]
]
此方式的优势在于没有任何全局或局部状态泄漏,映射函数每次都会返回全新的引用,天然免疫浅拷贝共享引用的隐患。
3. 经典 for 循环逐行构建(适合递推关系与算法推导)
当二维数组各行的元素不是简单的初始常量,而是依赖复杂的数学计算或前后递推关系时,经典的 for 循环是控制力最强的实现手段。以著名的杨辉三角(Pascal's Triangle)为例,第 i 行恰好包含 i + 1 个数字,且当前单元格数值由上一行相邻两数相加得出。
// 算法实例:生成指定行数的杨辉三角(每行递增长度的锯齿数组)
function generatePascalTriangle(numRows) {
  const triangle = [];

  for (let i = 0; i < numRows; i++) {
    // 步骤 1:第 i 行分配 i + 1 长度的独立新数组
    const row = new Array(i + 1);

    // 步骤 2:两端固定为 1
    row[0] = 1;
    row[i] = 1;

    // 步骤 3:中间元素由上一行的相邻两个数累加得到
    for (let j = 1; j < i; j++) {
      row[j] = triangle[i - 1][j - 1] + triangle[i - 1][j];
    }

    // 步骤 4:将填充完毕的独立子数组挂载至外层
    triangle.push(row);
  }

  return triangle;
}

const pascal5 = generatePascalTriangle(5);
console.log(pascal5);
示例输出:
[
[1],
[1, 1],
[1, 2, 1],
[1, 3, 3, 1],
[1, 4, 6, 4, 1]
]
在该示例中,外层 triangle 容纳了 5 行,各行长度从 1 逐渐扩展至 5,每个位置的计算精准依赖先前的行数据,结构清晰且易于调试。
4. 动态 push 分组构建(适合流式输入与稀疏图表)
在许多工程业务中,行数和每行的具体长度在开始时无法预估,数据是以离散流或键值对列表的形式陆续到达的。例如在图结构中构建邻接表(Adjacency List),每个顶点的出度不固定,此时可以按需动态初始化空数组并随时 push 元素。
// 业务场景:无向图边集输入,动态生成各顶点的邻接表锯齿数组
const edges = [
  [0, 1], [0, 2],
  [1, 2], [1, 3], [1, 4],
  [2, 3]
];

function buildAdjacencyList(edgeList, totalVertices) {
  // 初始化一个包含指定顶点数的外层数组,每个位置暂时为空数组
  const adj = [];
  for (let i = 0; i < totalVertices; i++) {
    adj[i] = [];
  }

  // 遍历所有边,动态追加邻接点
  for (const [u, v] of edgeList) {
    adj[u].push(v);
    adj[v].push(u); // 无向边双向追加
  }

  return adj;
}

const graphAdj = buildAdjacencyList(edges, 5);
console.log(graphAdj);
示例输出:
[
[1, 2], // 顶点 0 的邻接点(长度 2)
[0, 2, 3, 4], // 顶点 1 的邻接点(长度 4)
[0, 1, 3], // 顶点 2 的邻接点(长度 3)
[1, 2], // 顶点 3 的邻接点(长度 2)
[1] // 顶点 4 的邻接点(长度 1)
]
四、必须避开的关键陷阱:浅引用共享灾难
在初学 JavaScript 数组时,很多开发者为了追求代码简短,容易写出类似 new Array(3).fill([]) 这样的代码。这段代码在语法上完全有效,但却潜藏着严重的浅引用共享 Bug。
⚠️ 危险代码示范:严禁在 fill() 中直接传递引用类型
// 错误写法:所有行共享同一个数组实例
const buggyMatrix = new Array(3).fill([]);

// 期望只修改第 0 行第 0 列:
buggyMatrix[0].push(99);

// 真实结果:全部 3 行都变成了 [99]!
console.log(buggyMatrix[1]); // 输出: [99]
console.log(buggyMatrix[2]); // 输出: [99]
原因剖析:Array.prototype.fill(value) 方法在执行时,仅仅把参数 value 的字面值/指针值复制到每一个槽位。当传入 [] 时,JavaScript 只在堆内存中创建了一个空数组对象,随后将该对象的同一个内存地址(指针)分发给了 buggyMatrix[0]、buggyMatrix[1] 和 buggyMatrix[2]。因此,无论通过哪个下标修改数组,修改的都是同一块物理内存。
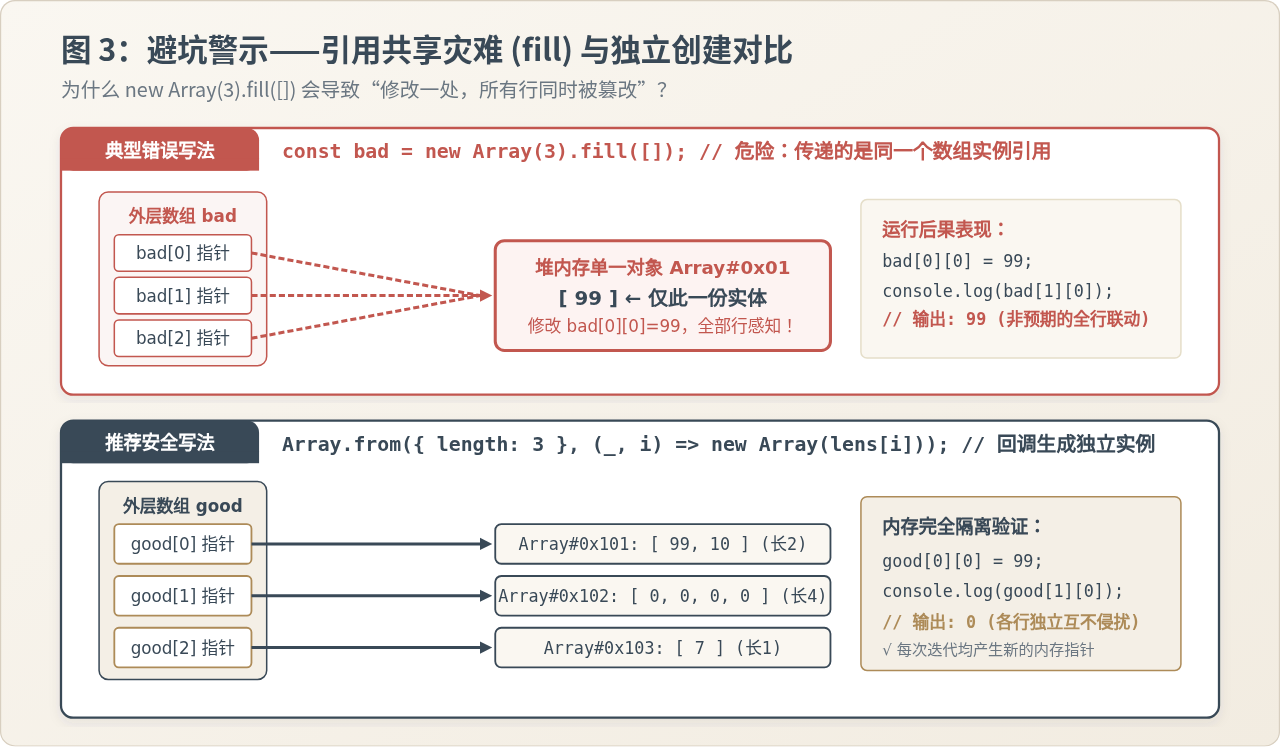
正确改法:如果想利用预分配语法,必须使用能在每次迭代中执行回调的函数(如 Array.from() 或显式 for 循环),确保每次迭代均由代码执行一次新的数组初始化操作。
// 正确解法:每次映射回调均由解释器实例化独立的新数组
const safeMatrix = Array.from({ length: 3 }, () => []);

safeMatrix[0].push(99);
console.log(safeMatrix[0]); // [99]
console.log(safeMatrix[1]); // [] (完全独立,不受任何影响)
五、安全遍历与访问边界处理
由于锯齿状二维数组每行的列数不统一,我们在对其进行访问、迭代和统计时,不能直接套用常规矩阵的“双重定长循环”,否则极易导致越界读取得到 undefined,甚至在尝试读取其属性时抛出 TypeError: Cannot read properties of undefined。
1. 正确的嵌套循环方式
在双重循环中,内层循环的终止条件必须动态绑定为当前行的实际长度 jagged[i].length,或者直接使用现代的 for...of 语法,无需手动管理索引计数器。
const sampleJagged = [[1, 2], [3, 4, 5, 6], [7]];

// 推荐方式 A:for...of 语法糖(简洁直观)
for (const [rowIndex, row] of sampleJagged.entries()) {
  console.log(`第 ${rowIndex} 行共有 ${row.length} 个元素:`);
  for (const item of row) {
    // 安全操作 item
  }
}

// 推荐方式 B:传统双重 for 循环(需注意以 row.length 约束)
for (let r = 0; r < sampleJagged.length; r++) {
  for (let c = 0; c < sampleJagged[r].length; c++) {
    const value = sampleJagged[r][c];
    // 安全使用 value
  }
}
2. 随机坐标访问时的防御式编程
当业务逻辑需要通过随机给定的坐标 (row, col) 查询数据时,由于锯齿数组中某些行可能较短甚至为空,访问 arr[row][col] 很容易越界。
建议使用现代 JavaScript 的可选链操作符(Optional Chaining ?.)搭配空值合并操作符(Nullish Coalescing ??):
function getSafeValue(matrix, r, c, defaultValue = 0) {
  // matrix[r]?.[c] 会在 matrix[r] 为 undefined 时立即安全短路返回 undefined
  // 不会触发 "Cannot read properties of undefined" 致命运行时错误
  return matrix[r]?.[c] ?? defaultValue;
}

const data = [[10, 20], [30]];

console.log(getSafeValue(data, 0, 1)); // 20 (正常命中)
console.log(getSafeValue(data, 1, 2)); // 0 (第 1 行仅 1 个元素,安全回退至默认值)
console.log(getSafeValue(data, 5, 0)); // 0 (第 5 行不存在,安全回退至默认值)
六、技术选型与实践总结
创建每行长度不同的锯齿状二维数组在 JavaScript 中不仅没有任何语法阻碍,反而是其原生嵌套数组设计的自然体现。在技术选型与日常编码中,可以参考如下决策全景图:
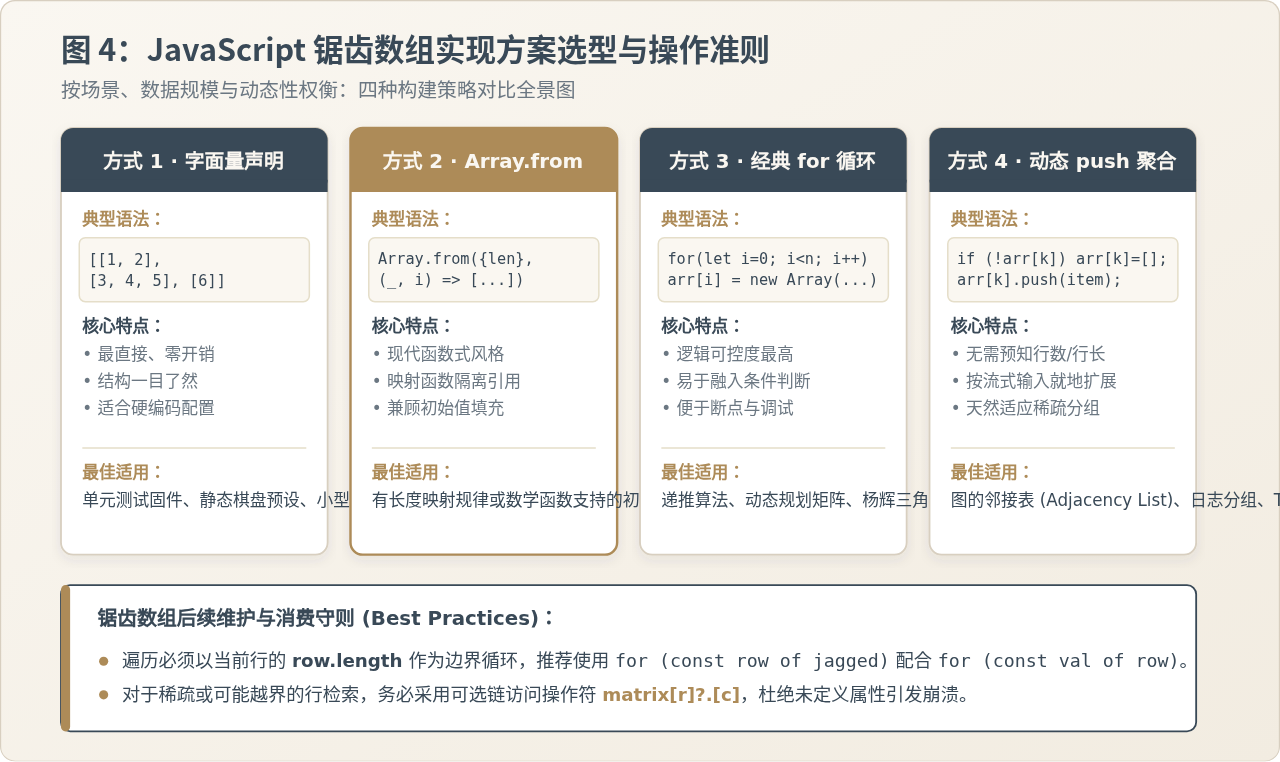
核心要点清单
- 模型本质:JavaScript 没有原生刚性矩阵,多维数组一律为对象引用集合,锯齿数组与常规二维数组在底层无性能劣势。
- 构建首选:已知生成规则或长度映射表时,优先选用
Array.from({ length }, (_, i) => Array.from({ length: len(i) }));算法递推场景选用经典for循环。 - 警惕引用共享:牢记
new Array().fill([])传参陷阱,永远在循环或工厂回调中实例化新的内层数组对象。 - 边界安全:始终以
row.length限制内层遍历;坐标读取使用可选链arr[r]?.[c]筑牢容错防线。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章