

详细讲解在JavaScript中批量删除满足条件的多个数组元素的实用方法。对比生成新数组的filter纯函数方式与原地修改的倒序splice、快慢双指针覆盖法,深入分析内存引用、连续项漏删陷阱与性能差异。
JS数组怎么批量删除满足条件的多个元素
作者:寒星
时间:2026-10-30
浏览:103
文章目录
在 JavaScript 开发中,批量剔除数组中满足特定条件的元素主要分为两类处理思路:一类是非破坏性的纯函数过滤(使用
filter() 提取反向条件生成新数组),另一类是原地修改数组本身(使用倒序循环配合 splice(),或通过快慢双指针覆盖并截断)。选择哪种方案取决于业务中是否需要保持原数组的内存引用。
一、最常用方案:使用 filter() 提取剩余元素生成新数组
在不要求保留原数组对象内存引用的场景下,最标准、简洁的做法是调用数组原生的 filter() 方法。需要注意的是,filter() 接收的谓词函数(Predicate)返回的是“需要保留的元素”,因此批量删除某个条件时,谓词函数中应当编写该条件的反向逻辑。
const list = [
  { id: 1, name: '文档A', isDeleted: false },
  { id: 2, name: '文档B', isDeleted: true },
  { id: 3, name: '文档C', isDeleted: true },
  { id: 4, name: '文档D', isDeleted: false }
];

// 需求:批量删除已标记删除(isDeleted 为 true)的所有文档
// 做法:在 filter 中保留 isDeleted 为 false 的项目
const activeList = list.filter(item => !item.isDeleted);

console.log(activeList);
// 输出示例:
// [
//   { id: 1, name: '文档A', isDeleted: false },
//   { id: 4, name: '文档D', isDeleted: false }
// ]
console.log(list.length); // 原数组仍为 4,未被更改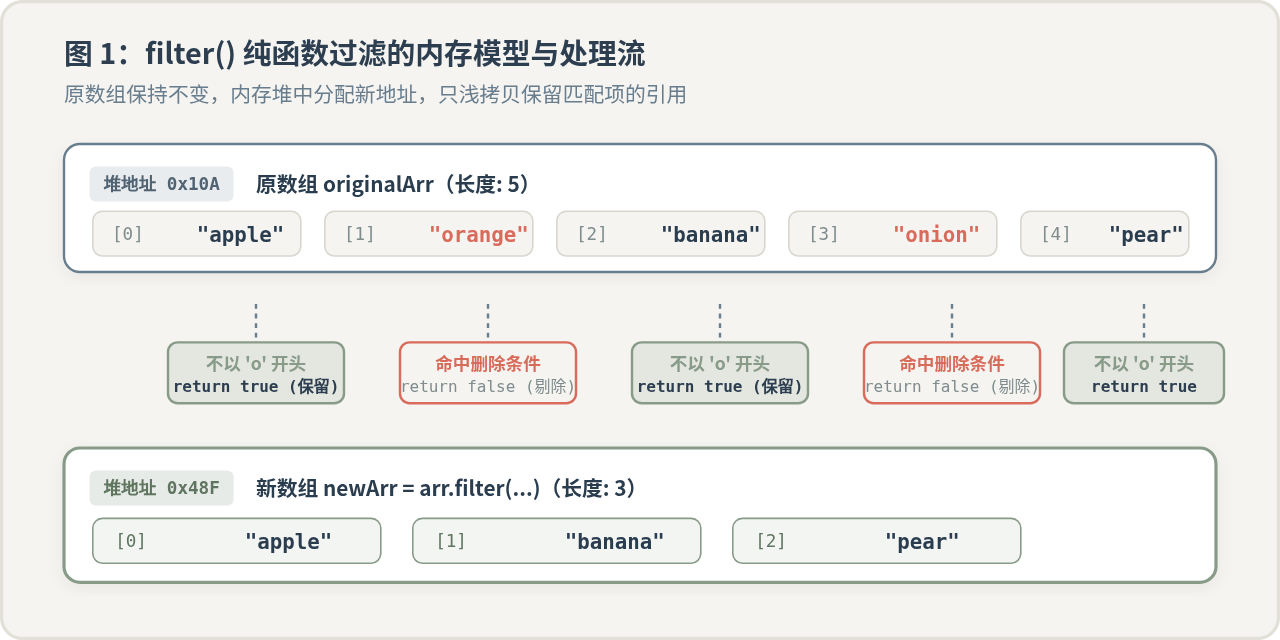
图 1:Array.prototype.filter() 过滤机制与内存对象示意
filter() 方法不会对原数组产生副作用,它在内存堆中申请了一块全新的数组空间,仅将符合条件的元素引用放入新数组。现代前端框架(如 React 的 useState、Redux 以及各类响应式单向数据流架构)普遍遵循不可变数据(Immutability)原则,通过产生新引用触发视图重新渲染,因此 filter() 是绝大多数日常业务开发的首选。
二、原地修改方案一:从后向前遍历配合 splice()
有时原数组对象被函数外部的作用域共享引用,或者作为组件 Props 传入,此时如果直接使用 filter() 赋值为新数组,外部持有的引用将无法感知到变更。这就需要对原数组进行原地修改(In-place mutation)。
1. 正序遍历的“跳跃漏删”陷阱
初学者最容易犯的错误是直接使用普通的正序 for 循环,遇到匹配项就调用 splice(i, 1)。这种做法在遇到两个或多个连续满足条件的元素时,必定会发生漏删。
原因在于:splice() 执行后,被删除项之后的所有元素都会立即向前挪移一位(即后面的元素索引自动减 1)。此时 for 循环执行 i++,导致原本紧随其后的那个元素直接被跳过,无法接受条件判断。
注意:虽然正序循环中可以在
splice() 后手动追加 i-- 来抵消索引前进,但这种写法破坏了循环步进器的确定性,容易在多人维护时被误改或遗漏。更推荐且规范的做法是倒序遍历。
2. 倒序遍历的标准实现
从数组末尾向前遍历(i = arr.length - 1; i >= 0; i--)。由于删除操作只影响当前索引后面的元素排列,而当前索引前面的所有未遍历元素其索引完全保持不变,因此每一次 splice() 都绝不会干扰尚未检查的项。
const scores = [45, 88, 52, 58, 92, 30];

// 需求:批量删除所有不及格分数(小于 60 分)
// 倒序遍历原地删除
for (let i = scores.length - 1; i >= 0; i--) {
  if (scores[i] < 60) {
    scores.splice(i, 1);
  }
}

console.log(scores);
// 输出示例: [ 88, 92 ]
// scores 原始数组被直接修改,连续的 52 与 58 均被安全删除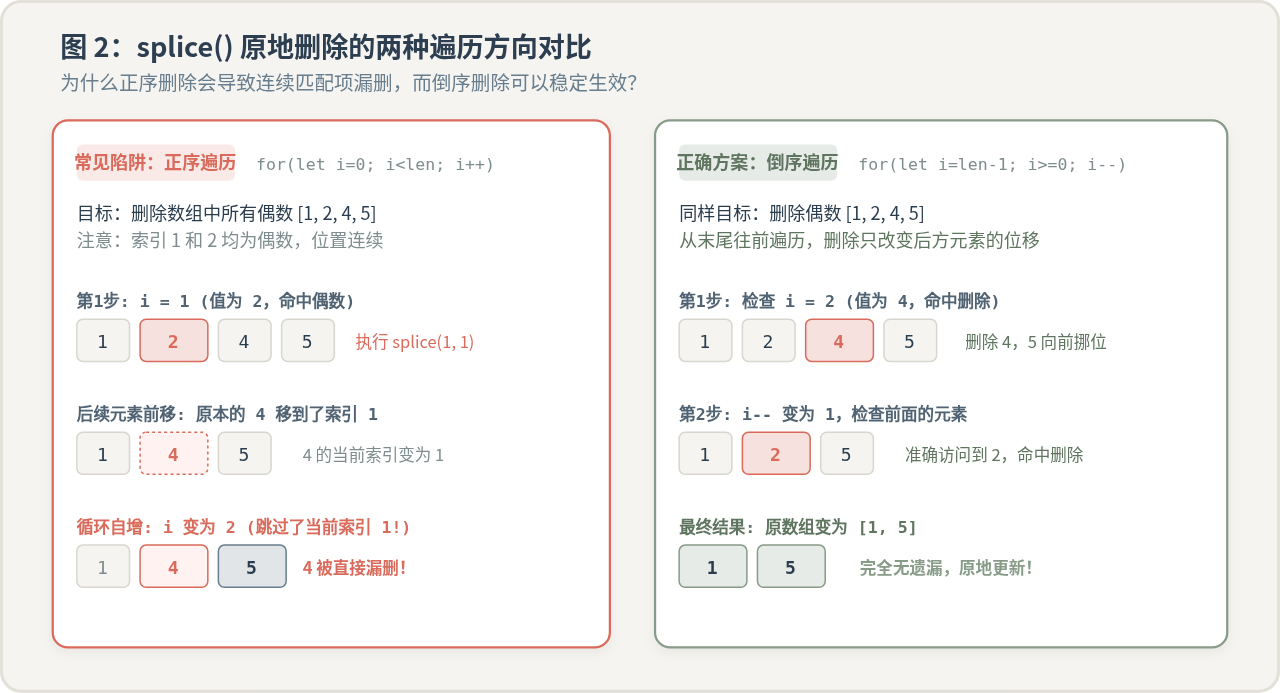
图 2:splice() 原地删除时正序漏删陷阱与倒序安全遍历的执行过程对比
三、原地修改方案二:快慢双指针元素覆盖法(应对大数据量)
倒序 splice() 逻辑清晰,但在数组元素较多(如上万项)且需要删除的项数量庞大时,会产生明显的性能损耗。因为 JavaScript 数组在底层是连续或分块存储的,每一次调用 splice() 剔除中间元素,引擎都要将后续所有元素在内存中向前复制移动一次。若有 \(k\) 个被删项,整体时间复杂度为 \(O(n imes k)\),最坏可达 \(O(n^2)\)。
如果需要高性能的原地批量删除,最优解法是借鉴算法中的快慢双指针(Fast-Slow Pointers)模式:
- 维护慢指针
slow = 0,代表有效元素的写入位置; - 快指针
fast正常从头到尾扫描数组; - 当遇到需要保留的元素时,将其直接复制到
arr[slow],并将slow加 1;遇到要删除的元素则直接跳过; - 遍历结束后,将数组的
length属性直接重置为slow。多余的尾部空间由 JS 引擎自动截断并回收内存。
/**
 * 原地批量删除满足条件的数组元素(双指针覆写法)
 * @param {Array} arr 目标数组
 * @param {Function} shouldRemove 判定是否需要删除的回调函数
 */
function batchRemoveInPlace(arr, shouldRemove) {
  let slow = 0;

  for (let fast = 0; fast < arr.length; fast++) {
    // 如果当前项不满足删除条件(即保留项)
    if (!shouldRemove(arr[fast], fast, arr)) {
      // 仅在指针不重合时覆写,避免自身无谓赋值
      if (slow !== fast) {
        arr[slow] = arr[fast];
      }
      slow++;
    }
  }

  // 一次性截断尾部已失效元素,时间复杂度 O(1)
  arr.length = slow;
  return arr;
}

// 使用示例:批量删除负数
const data = [10, -5, -8, 20, -3, 40];
batchRemoveInPlace(data, num => num < 0);

console.log(data);
// 输出示例: [ 10, 20, 40 ]
// 原数组被原地更新,全局时间复杂度仅为 O(n)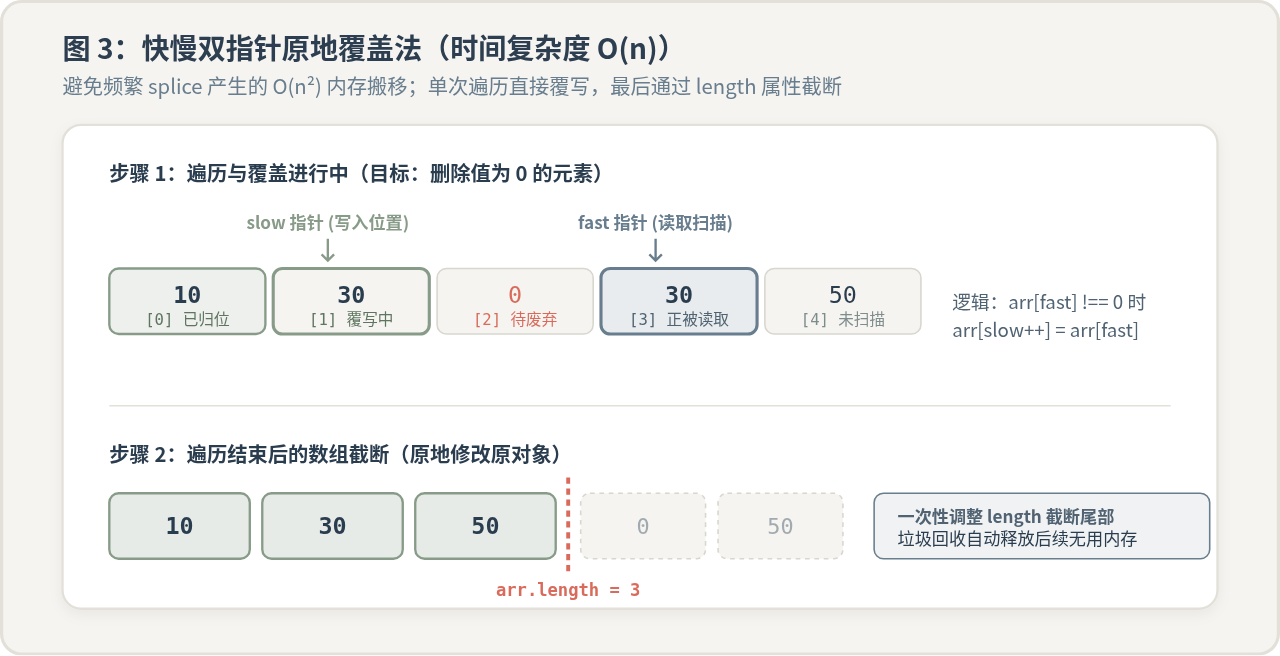
图 3:快慢双指针原地元素覆盖与数组长度截断流程
性能优势:该方法对整个数组仅执行单次线性遍历,所有元素最多只被赋值覆盖一次,完全消除了多次
splice() 带来的内存碎片与大面积挪移,是大规模数据批处理下的最优选择。
四、关键差异与技术选型对照
为了直观理解不同做法的本质差异,下表汇总了三种方式的核心指标对比:
| 对比维度 | Array.prototype.filter() | 倒序 for 循环 + splice() | 快慢双指针原地覆盖法 |
|---|---|---|---|
| 修改方式 | 生成新数组对象,原数组完全不变 | 直接原地修改原数组对象 | 直接原地修改原数组对象 |
| 原对象引用 | 引用改变(产生新地址) | 引用保持不变 | 引用保持不变 |
| 时间复杂度 | \(O(n)\) | \(O(n^2)\)(受多次位移影响) | \(O(n)\) |
| 额外内存消耗 | 需要创建新数组存储结果(\(O(n)\)) | \(O(1)\) 纯就地操作 | \(O(1)\) 纯就地操作 |
| 框架适配 | 极佳(契合 React/Vue 响应式与不可变数据) | 需注意是否破坏响应式依赖追踪 | 需注意是否破坏响应式依赖追踪 |
| 编码复杂度 | 一行代码,声明式且直观 | 简单,但必须注意方向必须为逆向 | 需封装辅助函数,需要理解指针概念 |
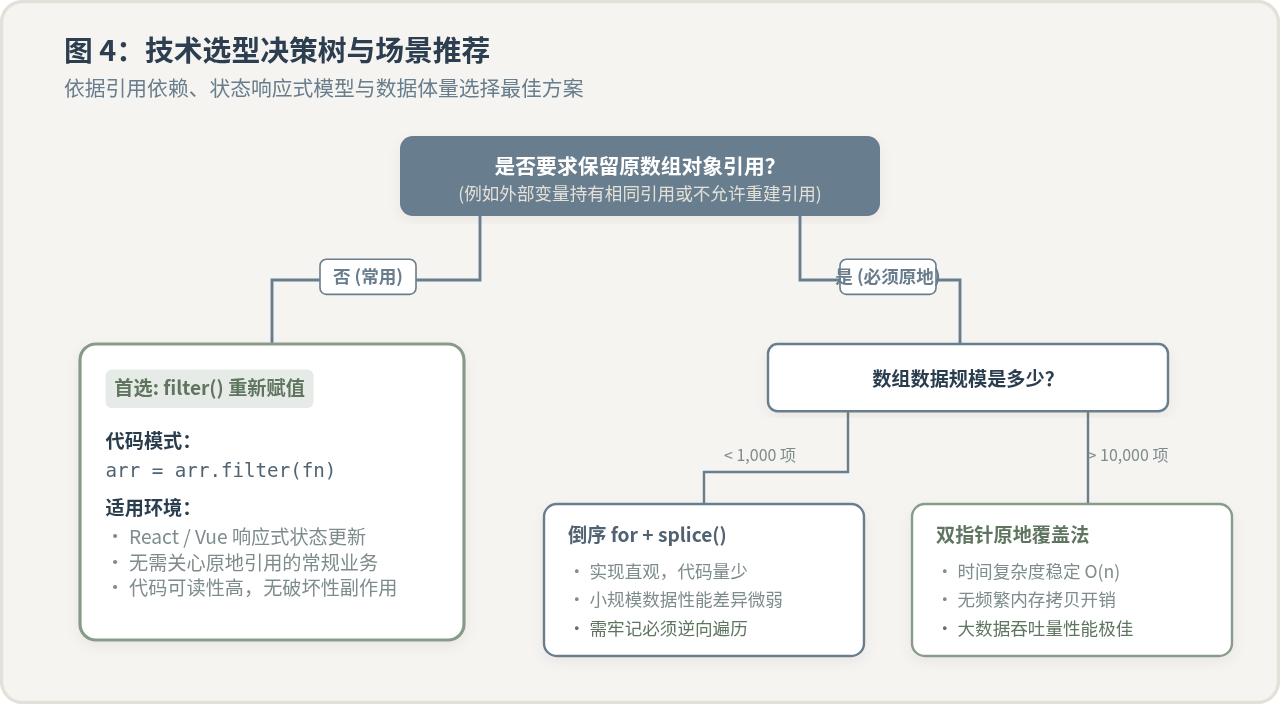
图 4:JS 批量删除满足条件数组元素的技术决策树
五、总结与编码建议
针对“JS数组怎么批量删除满足条件的多个元素”这一问题,实践中的选取策略如下:
- 默认优先考虑
filter():日常业务开发、现代前端框架状态管理、无特殊内存限制的场景下,使用arr = arr.filter(item => !condition(item))是最不容易出错且代码可读性最高的方式。 - 常规原地修改选用倒序
splice():如果必须维持外部引用一致且数组项在千级以内,使用for (let i = arr.length - 1; i >= 0; i--)能够兼顾可读性与功能正确性,切记避免正向遍历。 - 高频、大数据量原地操作选用双指针法:对于游戏循环、数据可视化处理或万级以上数据的高性能批处理,采用快慢双指针就地覆盖并重设
arr.length能将耗时降至理论极限。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章