

深入解析在前端JavaScript中基于axios实现大文件分片下载与断点续传的完整方案,涵盖HTTP Range协议协商、并发分片下载、IndexedDB持久化缓存与Blob组装落盘。
JS怎么实现大文件断点续传?基于axios的分片下载方案
作者:半夏
时间:2026-10-30
浏览:99
文章目录
前端处理数百兆甚至数吉字节(GB)的大文件下载时,传统的单次请求容易因网络波动中断而导致前功尽弃。解决这一问题的关键在于利用 HTTP 协议规范中的范围请求机制(Range 请求),由客户端使用 axios 将大文件切分为若干固定大小的数据块并发请求,并将下载完成的二进制分片缓存到本地浏览器数据库 IndexedDB 中。当网络中断或用户主动暂停时,只需查询本地已完成的分片记录,恢复时仅请求尚未获取的分片,最后按顺序组装为完整文件落盘保存。
一、核心原理:HTTP Range 与分片下载协商机制
实现断点续传下载的前提是 Web 服务器支持范围请求。客户端在发起正式的分片下载前,首先需要通过轻量请求获知文件的总尺寸以及服务端是否支持区间请求能力。
整个协议交互过程遵循明确的标准 HTTP 头部协商:
- 探针请求(HEAD):客户端向目标 URL 发送
HEAD请求,服务端返回响应头而不传输文件实体。客户端通过检查响应头中是否存在Accept-Ranges: bytes来确认分片支持,同时提取Content-Length得到文件总字节数。 - 分片请求(GET Range):客户端将总大小切分为若干区间,例如每次请求 5MB,发送带有
Range: bytes=0-5242879的 GET 请求。 - 服务端响应(206 Partial Content):支持分片的服务器会返回
206 Partial Content状态码,并在Content-Range响应头中告知当前返回的字节范围及总大小(如bytes 0-5242879/104857600)。
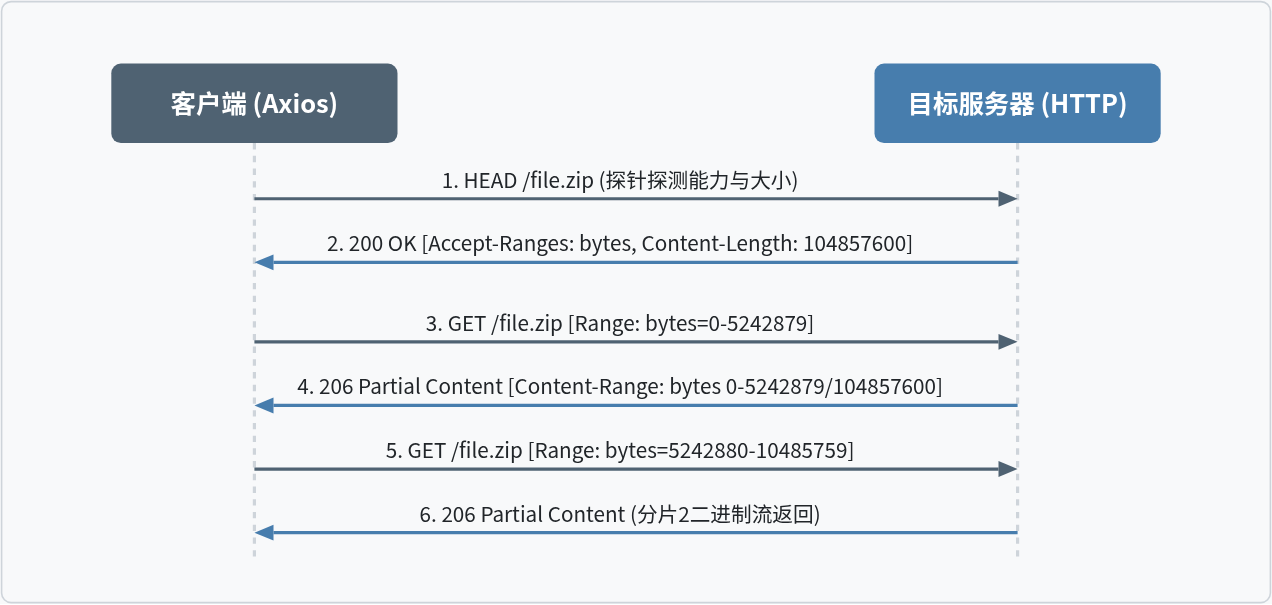
图1:基于 HTTP 协议 Range 请求与 206 Partial Content 协商交互流程
注意跨域响应头暴露:若前端与下载服务器不同源,服务端在响应头中必须配置 Access-Control-Expose-Headers: Content-Range, Content-Length, Accept-Ranges,否则浏览器中的 axios 将无法从 response.headers 中读取到对应的范围信息。
二、分片下载与续传状态控制流程
构建断点续传系统不能把分片仅仅存放在 JavaScript 变量内存中,因为页面刷新或浏览器崩溃会导致内存丢失。完整且健壮的断点续传流程需要分为 6 个步骤执行:
- 本地校验与恢复:以文件唯一标识(URL 或哈希)为键,在浏览器本地 IndexedDB 中查询是否存在未完成的下载任务及已存分片列表。
- 任务计划与切片:结合文件总大小与分片规格(例如每片 5MB),生成完整分片区间队列,剔除 IndexedDB 中已经下载成功的分片。
- 并发池调度:使用滑动窗口或并发队列限制同时下载的任务数量(建议 3-6 个),防止大量并发连接堵塞浏览器通道。
- 分片持久化与进度统计:每个分片在 axios 获取到
ArrayBuffer后,立即存入 IndexedDB 并更新进度状态。 - 取消与中断控制:通过
AbortController实现随时暂停;发生网络异常时保留已落库分片并标记任务状态。 - 重组导出:当所有分片均下载完毕,从 IndexedDB 按分片序号依次取出并构造成
Blob,生成 ObjectURL 完成最终下载。
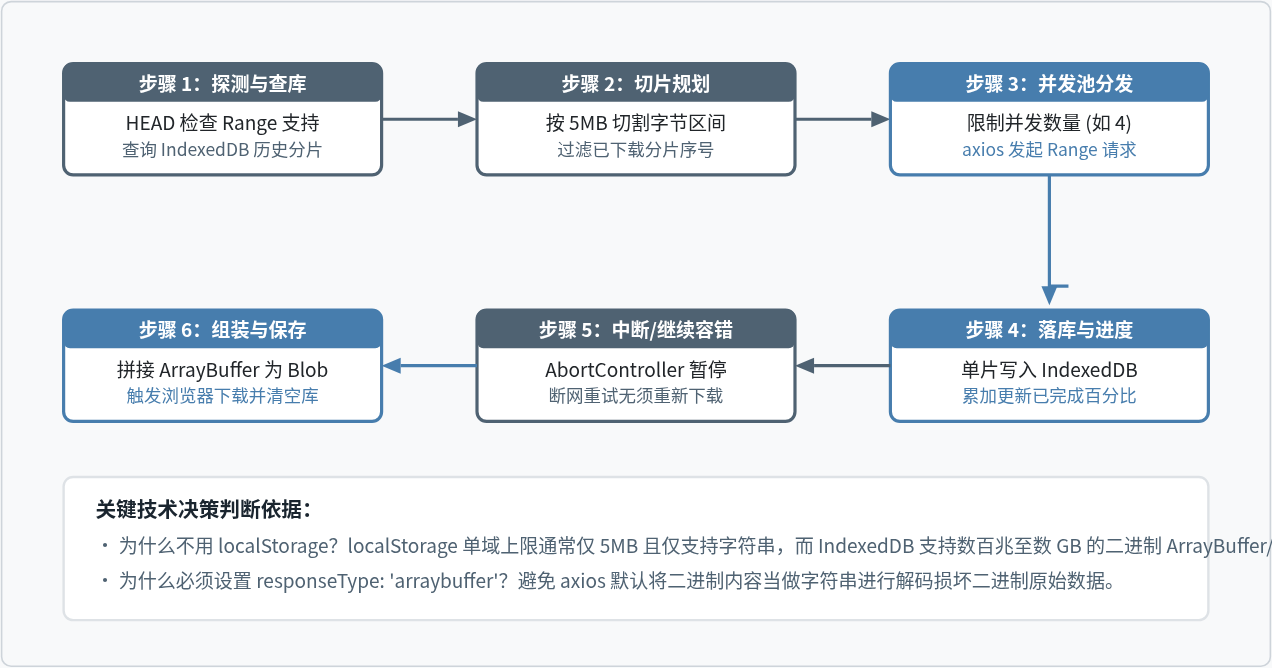
图2:分片下载与断点续传执行步骤与状态控制流
三、基于 Axios 的分片下载核心代码实现
以下代码提供完整的断点续传下载控制器。代码划分为两个主要模块:IndexedDB 分片存储引擎与基于 Axios 的并发分片调度器。
1. 本地分片存储引擎(IndexedDB 封装)
为了支持断点恢复,使用简洁的 IndexedDB 工具函数完成分片存储与提取:
class ChunkStorage {
  constructor(dbName = 'FileDownloadDB', storeName = 'chunks') {
    this.dbName = dbName;
    this.storeName = storeName;
    this.db = null;
  }

  async init() {
    if (this.db) return this.db;
    return new Promise((resolve, reject) => {
      const request = indexedDB.open(this.dbName, 1);
      request.onupgradeneeded = (e) => {
        const db = e.target.result;
        if (!db.objectStoreNames.contains(this.storeName)) {
          // 以 taskKey 和 chunkIndex 联合作为存储主键
          db.createObjectStore(this.storeName, { keyPath: ['fileId', 'index'] });
        }
      };
      request.onsuccess = (e) => {
        this.db = e.target.result;
        resolve(this.db);
      };
      request.onerror = () => reject(request.error);
    });
  }

  // 保存单个分片数据
  async saveChunk(fileId, index, data) {
    await this.init();
    return new Promise((resolve, reject) => {
      const tx = this.db.transaction(this.storeName, 'readwrite');
      const store = tx.objectStore(this.storeName);
      store.put({ fileId, index, data });
      tx.oncomplete = () => resolve();
      tx.onerror = () => reject(tx.error);
    });
  }

  // 获取该文件已经完成的所有分片记录
  async getDownloadedChunks(fileId) {
    await this.init();
    return new Promise((resolve, reject) => {
      const tx = this.db.transaction(this.storeName, 'readonly');
      const store = tx.objectStore(this.storeName);
      const request = store.getAll();
      request.onsuccess = () => {
        const results = request.result.filter(item => item.fileId === fileId);
        // 按分片索引排序
        results.sort((a, b) => a.index - b.index);
        resolve(results);
      };
      request.onerror = () => reject(request.error);
    });
  }

  // 下载合并完成后清空缓存
  async clearFile(fileId) {
    await this.init();
    const chunks = await this.getDownloadedChunks(fileId);
    return new Promise((resolve, reject) => {
      const tx = this.db.transaction(this.storeName, 'readwrite');
      const store = tx.objectStore(this.storeName);
      chunks.forEach(c => store.delete([c.fileId, c.index]));
      tx.oncomplete = () => resolve();
      tx.onerror = () => reject(tx.error);
    });
  }
}
2. 断点续传调度器与 Axios 请求控制
调度器负责 HEAD 握手、并发窗口控制、分片请求以及暂停控制:
class ChunkDownloader {
  constructor(url, options = {}) {
    this.url = url;
    this.fileId = options.fileId || encodeURIComponent(url);
    this.chunkSize = options.chunkSize || 5 * 1024 * 1024; // 默认 5MB 一片
    this.concurrency = options.concurrency || 3;           // 默认 3 个并发
    this.storage = new ChunkStorage();
    this.abortController = null;
    this.isPaused = false;
    this.totalSize = 0;
    this.totalChunks = 0;
    this.onProgress = options.onProgress || (() => {});
  }

  // 1. 获取文件大小并检查 Range 支持
  async probe() {
    const res = await axios.head(this.url);
    const acceptRanges = res.headers['accept-ranges'];
    const contentLength = res.headers['content-length'];

    if (!contentLength) {
      throw new Error('无法通过 HEAD 请求获知文件大小');
    }
    if (acceptRanges !== 'bytes') {
      console.warn('服务端未显式声明 Accept-Ranges: bytes,可能不支持分片断点续传');
    }

    this.totalSize = parseInt(contentLength, 10);
    this.totalChunks = Math.ceil(this.totalSize / this.chunkSize);
    return { totalSize: this.totalSize, totalChunks: this.totalChunks };
  }

  // 2. 启动或恢复下载
  async start() {
    this.isPaused = false;
    this.abortController = new AbortController();

    if (!this.totalSize) {
      await this.probe();
    }

    // 查询 IndexedDB 中已下载的分片索引
    const savedChunks = await this.storage.getDownloadedChunks(this.fileId);
    const finishedIndices = new Set(savedChunks.map(c => c.index));

    // 生成未下载的分片任务列表
    const pendingTasks = [];
    for (let i = 0; i < this.totalChunks; i++) {
      if (!finishedIndices.has(i)) {
        const start = i * this.chunkSize;
        const end = Math.min(start + this.chunkSize - 1, this.totalSize - 1);
        pendingTasks.push({ index: i, start, end });
      }
    }

    // 初始进度通知
    this.notifyProgress(finishedIndices.size);

    // 调度并发下载队列
    await this.runPool(pendingTasks, finishedIndices);

    // 全部下载完成后拼装文件并下载
    if (!this.isPaused) {
      return await this.assembleFile();
    }
  }

  // 3. 并发工作池调度
  async runPool(tasks, finishedIndices) {
    let poolIndex = 0;
    const executing = new Set();

    while (poolIndex < tasks.length && !this.isPaused) {
      const task = tasks[poolIndex++];
      const p = this.downloadChunk(task).then(() => {
        executing.delete(p);
        finishedIndices.add(task.index);
        this.notifyProgress(finishedIndices.size);
      });
      executing.add(p);

      if (executing.size >= this.concurrency) {
        await Promise.race(executing);
      }
    }

    await Promise.all(executing);
  }

  // 4. 单片下载请求与落库
  async downloadChunk(task) {
    if (this.isPaused) return;

    const response = await axios.get(this.url, {
      headers: {
        Range: `bytes=${task.start}-${task.end}`
      },
      responseType: 'arraybuffer',
      signal: this.abortController.signal
    });

    // 写入 IndexedDB 本地持久化
    await this.storage.saveChunk(this.fileId, task.index, response.data);
  }

  // 5. 暂停下载
  pause() {
    this.isPaused = true;
    if (this.abortController) {
      this.abortController.abort();
    }
  }

  // 6. 进度计算与回调
  notifyProgress(completedCount) {
    const percent = ((completedCount / this.totalChunks) * 100).toFixed(2);
    this.onProgress({
      completedChunks: completedCount,
      totalChunks: this.totalChunks,
      percent: Number(percent)
    });
  }

  // 7. 组装所有分片为 Blob 并触发浏览器下载
  async assembleFile(fileName = 'download.zip') {
    const allChunks = await this.storage.getDownloadedChunks(this.fileId);
    if (allChunks.length !== this.totalChunks) {
      throw new Error('分片数量不完整,无法组装文件');
    }

    const buffers = allChunks.map(c => c.data);
    const blob = new Blob(buffers);

    const blobUrl = URL.createObjectURL(blob);
    const link = document.createElement('a');
    link.href = blobUrl;
    link.download = fileName;
    document.body.appendChild(link);
    link.click();
    document.body.removeChild(link);
    URL.revokeObjectURL(blobUrl);

    // 清理 IndexedDB 释放磁盘空间
    await this.storage.clearFile(this.fileId);
  }
}
四、内存架构与大文件分片组装机制
在前端处理上百兆的大文件时,内存溢出(OOM)是开发者最常踩的坑。理解数据在网络、数据库与内存之间的流转非常关键。
如果使用全局数组把所有下载到的 ArrayBuffer 驻留在内存变量中,当并发分片和文件总大小增加时,极易造成浏览器标签页崩溃。稳妥的架构是将网络获取到的二进制数据立即写入 IndexedDB,并由垃圾回收器(GC)及时回收该次请求的内存占用。直到所有分片就绪,再一次性以流式或有序数组的方式送入 Blob 构造函数中。
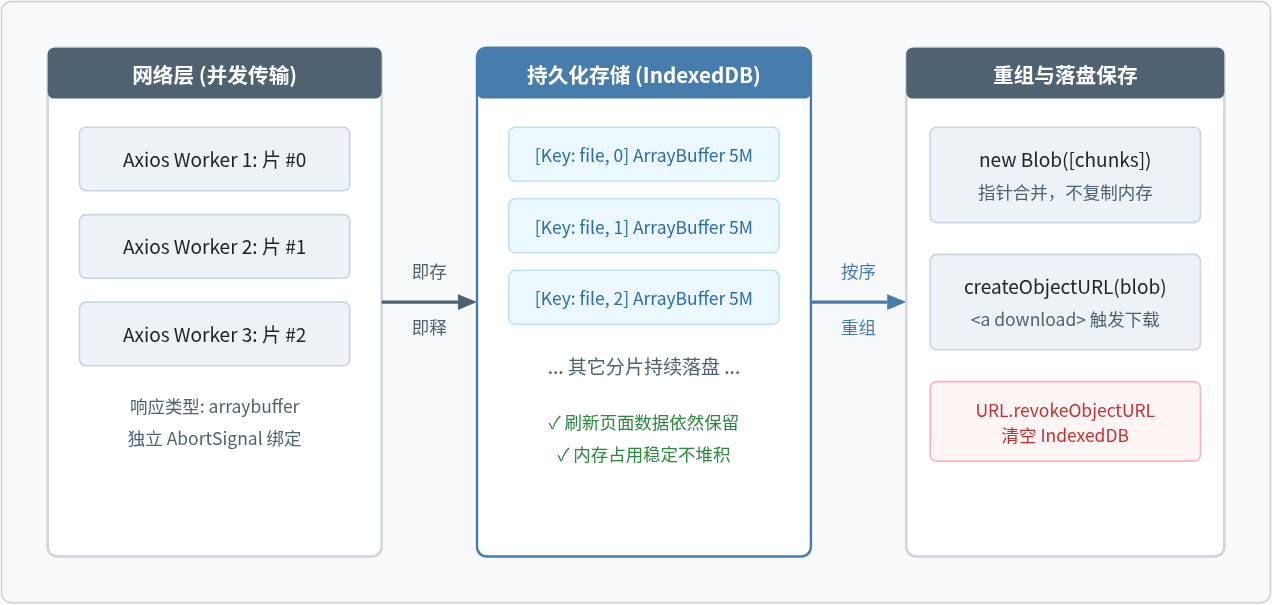
图3:网络分片传输、IndexedDB 持久化与内存组装流转架构
五、工程实践避坑与核心总结
在实际生产部署基于 axios 的断点续传方案时,还需要防范以下几个典型边界问题:
- 分片大小权衡:分片太小(例如小于 1MB)会导致高频的 HTTP 请求开销与 TCP 握手损耗;分片太大(如超过 20MB)则单次失败重试的代价过高。通常在公网环境中推荐 2MB ~ 5MB 作为分片步长。
- 文件变更一致性(ETag 校验):如果远端文件在下载过程中被重新发布,直接续传旧分片将拼装出损坏文件。正确的做法是在
HEAD探测时记录服务端返回的ETag或Last-Modified,后续每个分片请求均校验该标识;若发生改变则清空本地旧分片重新开始。 - 超大文件(超 2GB)的浏览器限制:32 位浏览器环境或部分移动端对单个 Blob 大小限制在 2GB 以内。若需下载 4GB 以上的超大文件,推荐结合现代浏览器的
showSaveFilePicker()与WritableStream,将下载完成的分片直接以流的形式写入本地磁盘,规避内存拼接。
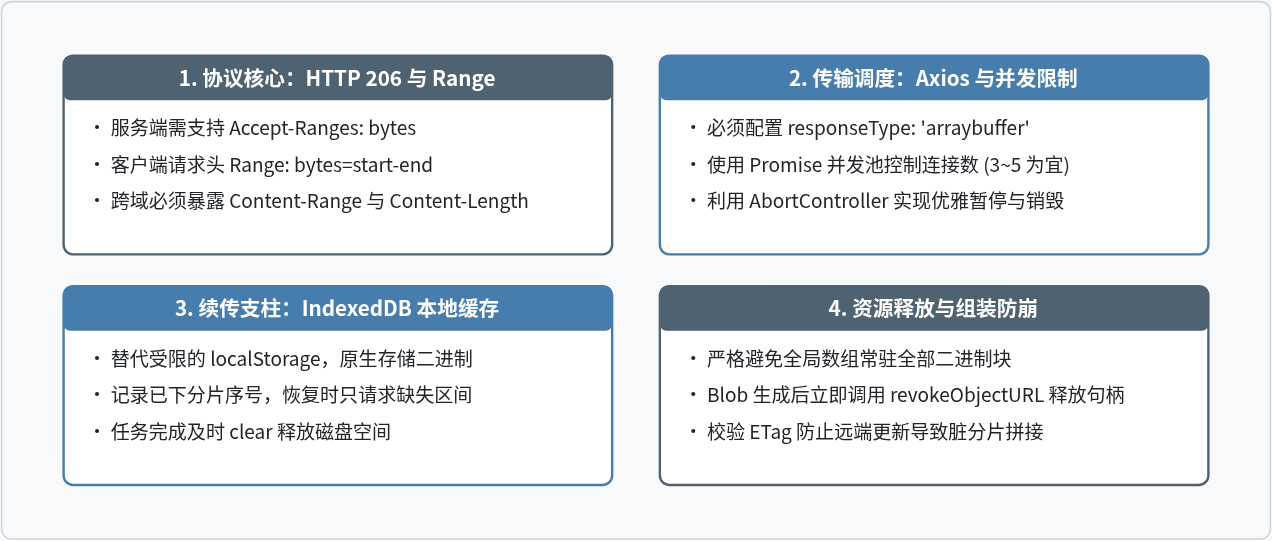
图4:基于 Axios 的分片下载与断点续传方案四维全景总结
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章