
详解在Node.js中如何利用got、axios以及stream流式处理模块高效下载文件,避免内存溢出,掌握背压控制与生产级健壮下载方案。

当前位置:首页 > Node.js 基础 > 正文
Node.js高效下载文件:got、axios与stream流处理模块推荐
作者:服务小站
时间:2026-10-30
浏览:662
文章目录
在 Node.js 服务端应用中,下载文件是高频出现的任务,例如同步外部静态资源、导出批量报表以及转存媒体文件等。许多初学者最初会直接通过 HTTP 请求获取完整的响应体,随后一次性写入本地磁盘。当文件较小(如数百 KB)时,这种方式不易察觉问题;但在面对数十 MB 乃至数 GB 的大文件,或者高并发场景时,将整个文件载入内存极易触发 V8 引擎堆内存溢出(OOM,Out of Memory)导致进程崩溃。实现高吞吐、低内存占用的高效下载,关键在于采用“流式处理(Stream)”模式,并配合设计严谨的 HTTP 客户端工具与管道流转机制。
一、内存缓冲与流式处理的核心差异
要理解高效下载的本质,首先需要对比两种截然不同的数据流转模型:
- 全量内存缓冲(Buffer 模式):HTTP 客户端将服务器下发的所有分片全部存入内存缓冲区中,直至整个传输完成,再由
fs.writeFile整体落盘。在传输过程中,Node.js 进程占用的内存随文件体积线性飙升。若同时有 5 个并发任务下载 500MB 文件,内存消耗将轻易突破 2.5GB。 - 流式管道写入(Stream 模式):网络底层接收到数据块(Chunk,通常为 16KB~64KB)后,立即通过管道推送到本地文件写入流(
fs.createWriteStream)进行消费,内存中始终只维护一个极小的工作窗口。无论目标文件是 100MB 还是 10GB,进程的内存驻留几乎保持平缓恒定。
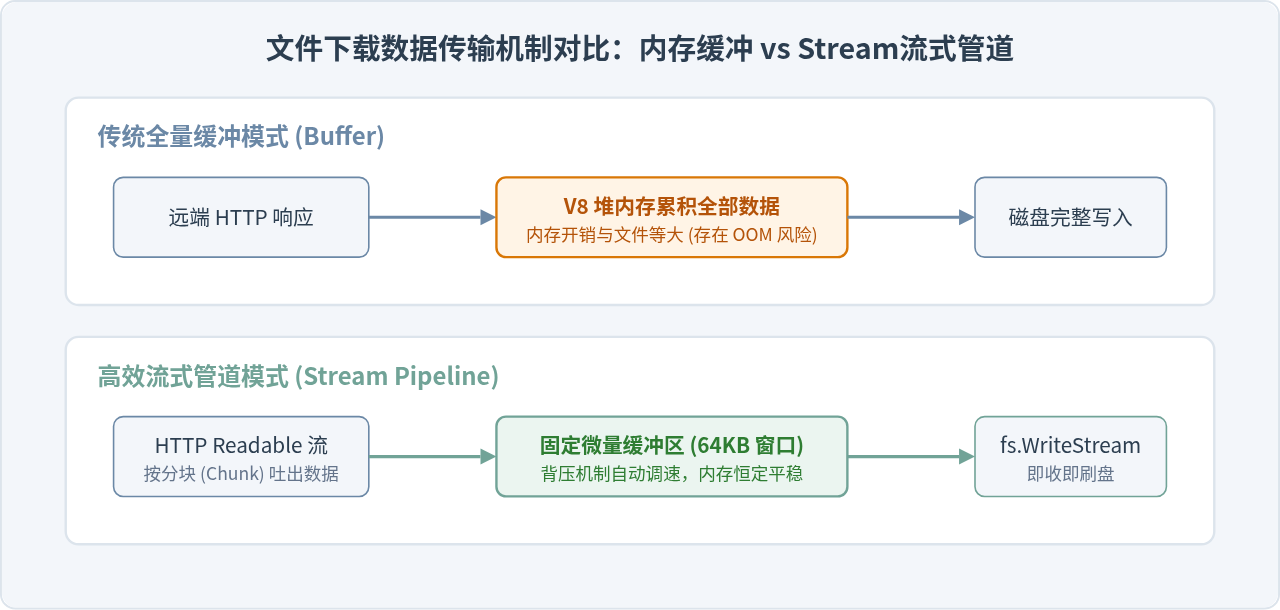
图 1:传统全量内存缓冲模式与 Stream 流式管道模式数据流向与资源占用对比
二、主流请求库实现方案
在 Node.js 生态中,got 与 axios 是目前最成熟、使用最广泛的两个网络请求库。它们均提供了良好的流式传输接口,但在设计理念和调用方式上存在明显区别。
1. got:专为 Node.js 定制的流优先客户端
got 是专门针对 Node.js 运行时打造的现代 HTTP 客户端,原生支持 Promise 与 Stream。它直接暴露了 got.stream(url) 接口,调用时不会缓存响应内容,而是立即返回一个标准的 Readable Stream,与 Node.js 原生流完美契合。
除了流式接口直观外,got 还内置了传输进度事件 downloadProgress,无需第三方模块即可精确获取下载百分比、已传输字节与总字节数。
import fs from 'node:fs';
import { pipeline } from 'node:stream/promises';
import got from 'got';

async function downloadWithGot(url, targetPath) {
  const downloadStream = got.stream(url);
  const fileWriter = fs.createWriteStream(targetPath);

  // 监听内置的下载进度事件
  downloadStream.on('downloadProgress', (progress) => {
    const percent = Math.round(progress.percent * 100);
    console.log(`[Got 下载中] 进度: ${percent}% (${progress.transferred} / ${progress.total} 字节)`);
  });

  // 使用 stream/promises 的 pipeline 串联流并自动处理异常
  await pipeline(downloadStream, fileWriter);
  console.log('[Got] 文件已成功下载到:', targetPath);
}注意:got 从 v12 开始转为纯 ESM 模块(Pure ESM)。如果您的项目依然使用传统的 CommonJS(require 语法),可以选用 got@11.8.5,或者在动态执行时使用 await import('got')。
2. axios:全栈通用的流式配置方案
axios 广泛应用于前端与 Node.js 全栈项目。默认情况下,axios 会尝试解析响应体。在 Node.js 环境中下载文件时,必须显式配置 responseType: 'stream',否则它依然会将整个响应体读入 Buffer 中,丧失流式处理的优势。
import fs from 'node:fs';
import { pipeline } from 'node:stream/promises';
import axios from 'axios';

async function downloadWithAxios(url, targetPath) {
  const response = await axios({
    method: 'GET',
    url: url,
    responseType: 'stream', // 关键配置:指定以流的方式返回响应
    timeout: 30000 // 配置超时时间,防止连接无限挂起
  });

  const totalLength = parseInt(response.headers['content-length'] || '0', 10);
  let downloadedBytes = 0;

  // 通过监听 data 分片手动计算下载进度
  response.data.on('data', (chunk) => {
    downloadedBytes += chunk.length;
    if (totalLength > 0) {
      const percent = Math.round((downloadedBytes / totalLength) * 100);
      console.log(`[Axios 下载中] 进度: ${percent}%`);
    }
  });

  const fileWriter = fs.createWriteStream(targetPath);
  await pipeline(response.data, fileWriter);
  console.log('[Axios] 文件已成功下载到:', targetPath);
}
三、构建生产级健壮下载器
仅用管道将网络流导向文件还不足以达到生产环境的标准。网络抖动、进程异常中断或服务器提前断开连接时,若直接写入目标路径,磁盘中往往会残留一个“大小不完整却已存在”的损坏文件。后续业务逻辑若通过 fs.existsSync 检查,就会误认为该文件已可用。
生产环境的可靠下载流程应遵循“写入临时文件 -> 校验完成 -> 原子重命名”的标准操作链条:
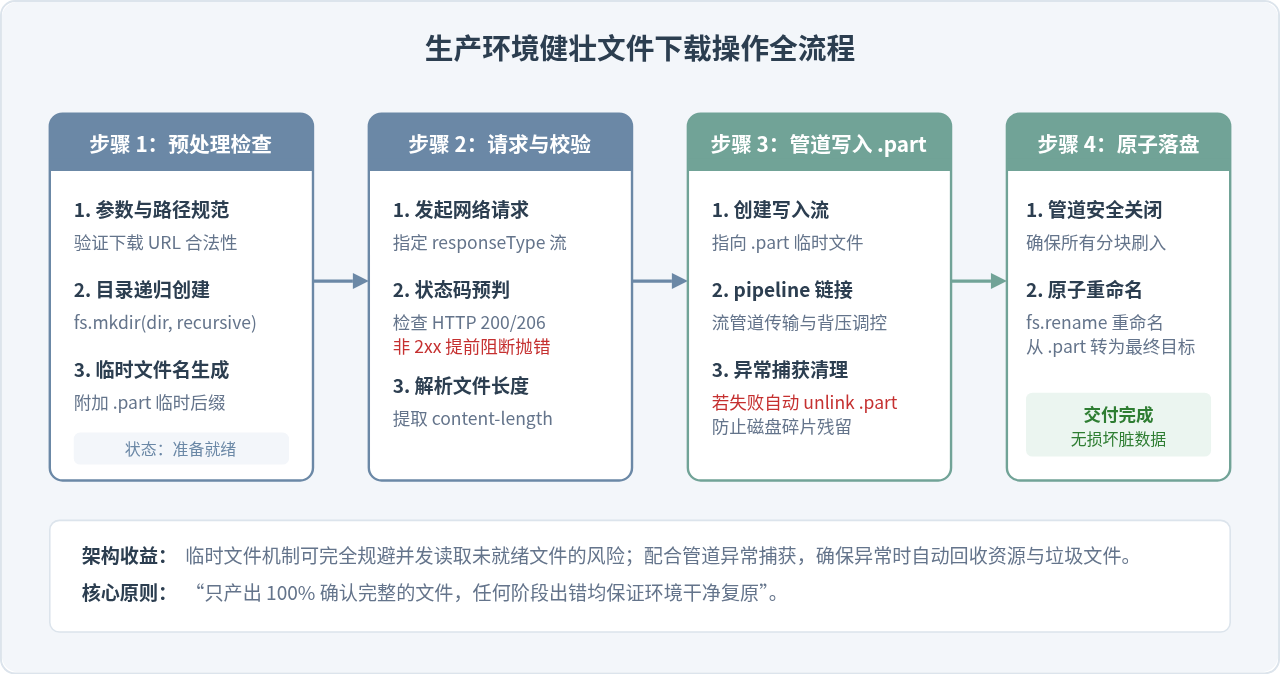
图 2:生产环境健壮下载操作全流程时序与状态变迁
下面是一个封装完备、开箱即用的下载函数实现,整合了目录准备、临时后缀与异常清理:
import fs from 'node:fs';
import path from 'node:path';
import { pipeline } from 'node:stream/promises';
import got from 'got';

async function safeDownloadFile(fileUrl, destinationPath) {
  const destDir = path.dirname(destinationPath);
  // 1. 确保目标目录存在
  await fs.promises.mkdir(destDir, { recursive: true });

  // 2. 构造临时写入路径,防止未下完的文件被提前使用
  const tempPath = `${destinationPath}.${Date.now()}.part`;

  const readStream = got.stream(fileUrl);
  const writeStream = fs.createWriteStream(tempPath);

  try {
    // 3. 执行管道流转
    await pipeline(readStream, writeStream);

    // 4. 下载完成,原子替换为最终文件名
    await fs.promises.rename(tempPath, destinationPath);
    console.log(`[成功] 文件已就绪: ${destinationPath}`);
  } catch (error) {
    // 5. 异常发生时,及时清理未完成的临时文件,防止磁盘垃圾堆积
    try {
      await fs.promises.unlink(tempPath);
    } catch {
      // 忽略临时文件不存在的静默错误
    }
    throw new Error(`文件下载失败: ${error.message}`);
  }
}
四、深入理解背压(Backpressure)机制
许多开发者在早期代码中习惯使用 readable.pipe(writable),但在现代 Node.js 异步流编程中,官方强烈推荐使用 stream.pipeline 或 node:stream/promises 中的 pipeline。这两者背后的关键机制就是背压(Backpressure)与异常闭环。
1. 什么是背压?
在网络下载场景中,网络接收速率与本地磁盘写入速率通常是不对称的。在千兆宽带或高速内网下,网卡每秒可能接收 80MB 数据,而本地机械硬盘或高负载 SSD 的突发写入速度可能暂时下降至 30MB/s。此时如果不加节制地接收数据,流入速度大于流出速度,多余的数据就会不断堆积在内存队列中,导致内存再度膨胀。
Node.js 的 Stream 机制通过内部水位线(highWaterMark)来维护平衡:
- 当写入流的内部缓冲区达到
highWaterMark(默认 16KB 或 64KB)时,write()方法会返回false。 - 此时上游读取流会自动收到暂停信号,暂时停止从网络底层读取新数据。
- 当磁盘将积压的数据完全刷盘并触发
drain事件后,上游读取流才会自动恢复供数。
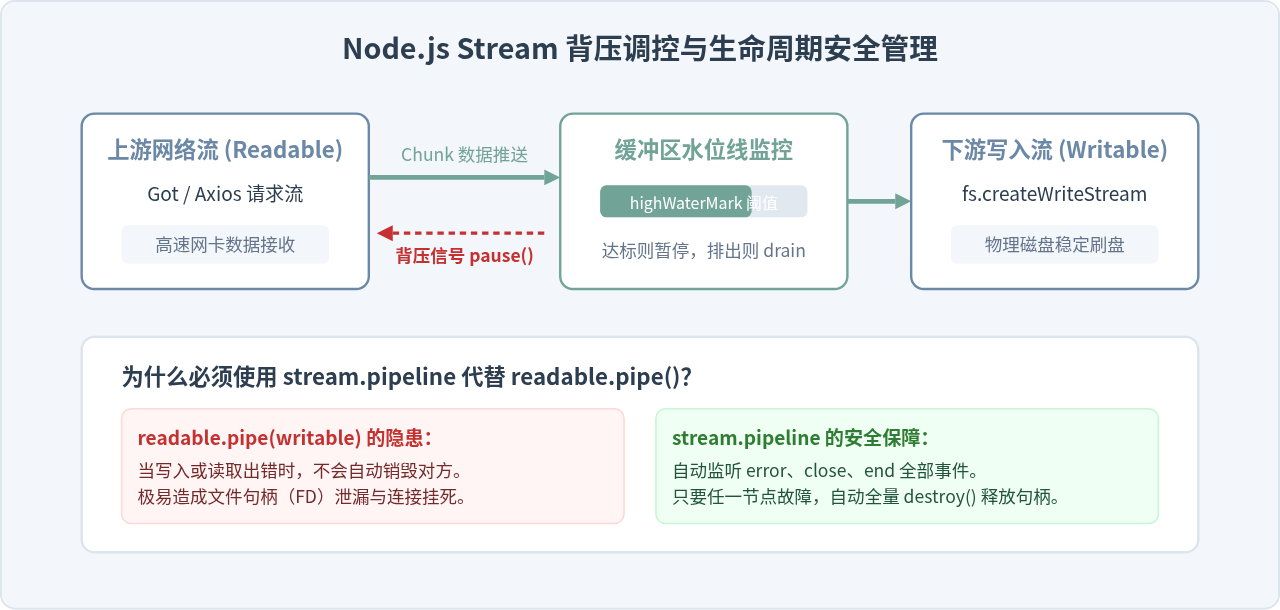
图 3:Node.js Stream 背压流速调控机制与 pipeline 句柄释放保障
五、模块选型与技术决策指南
面对不同的业务场景与技术架构,合理选择下载模块能够有效降低开发与运维成本。以下是 got、axios 以及 Node.js 原生 fetch 的关键维度对比:
| 对比维度 | got | axios | 原生 fetch (Node.js 18+) |
|---|---|---|---|
| 流处理集成度 | 极佳(专为 Node 流优化,got.stream() 直出) |
良好(需配置 responseType: 'stream') |
需适配(基于 Web Stream,需通过 Readable.fromWeb 转换) |
| 进度监听 | 内置(监听 downloadProgress 事件) |
需手动计算(监听 data chunk 累加) |
需通过 TransformStream 拦截处理 |
| 模块规范支持 | Pure ESM(v12+),老版本支持 CJS | ESM 与 CommonJS 双向完美兼容 | 内置全局变量,原生支持 |
| 同构兼容性 | 仅限 Node.js 服务端 | 前端与 Node.js 双端通用 | 现代浏览器与 Node.js 均内置标准实现 |
| 自动重试机制 | 内置成熟重试策略(支持网络波动退避) | 需借助 axios-retry 等第三方插件 |
需自行编写循环重试逻辑 |
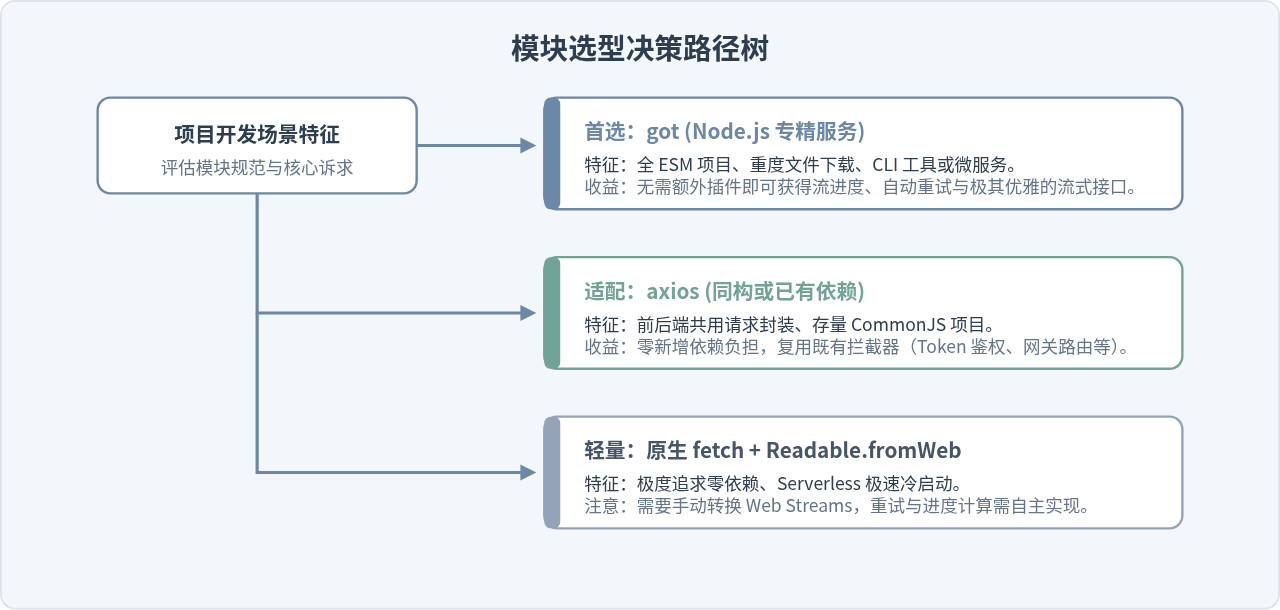
图 4:Node.js 文件下载模块选型决策路径与考量要点
六、常见边界问题与实践注意事项
- 非 200 响应体被当作文件写入:当远端返回 404 或 500 页面时,HTTP 响应体通常是 HTML 或 JSON 错误提示。如果不加检查直接导流,本地就会保存一份内容为错误信息的文件。务必在建立管道前检查
statusCode,遇到非 2xx 响应直接中断。 - HTTP 301/302 重定向:大文件下载往往部署在 CDN 或对象存储(OSS/S3)签名地址上,经常触发重定向。
got默认支持跟随重定向,而axios在 Node.js 端由follow-redirects驱动;配置自定义代理或请求头时,需确保鉴权头不会在跨域重定向时意外泄露。 - 超时时间必须明确设定:网络下载可能因中间路由器断开而长时间卡在无响应状态。必须在请求选项中明确设置合理超时(如连接超时与读取超时),防止下载任务耗尽系统连接池。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章