

深入解析在前端使用JavaScript处理数百兆至数吉字节超大音频文件下载时的内存溢出问题,详解ReadableStream流式读取、File System Access API直接落盘与Service Worker降级方案。
JavaScript处理大体积音频下载的内存优化与流式方案
作者:白帽猫
时间:2026-10-30
浏览:371
文章目录
在前端应用中下载高保真无损音频、多轨混音工程或大型播客归档文件时,文件体积常达到数百兆字节甚至数吉字节(GB)。若沿用常规的 fetch() 全量缓冲后生成 Blob 的下载方式,整个音频会全部滞留在浏览器的 JavaScript 堆内存中,触发垃圾回收停顿,甚至直接导致浏览器标签页发生内存溢出崩溃(OOM)。要彻底解决这一问题,核心思路是打破“先全部装入内存再保存”的链路,转为依托 ReadableStream 与 File System Access API(或降级方案)的管道式流式落盘,让内存始终只维持恒定的小缓冲区(如 64KB)。
一、传统 Blob 下载大音频时的内存瓶颈分析
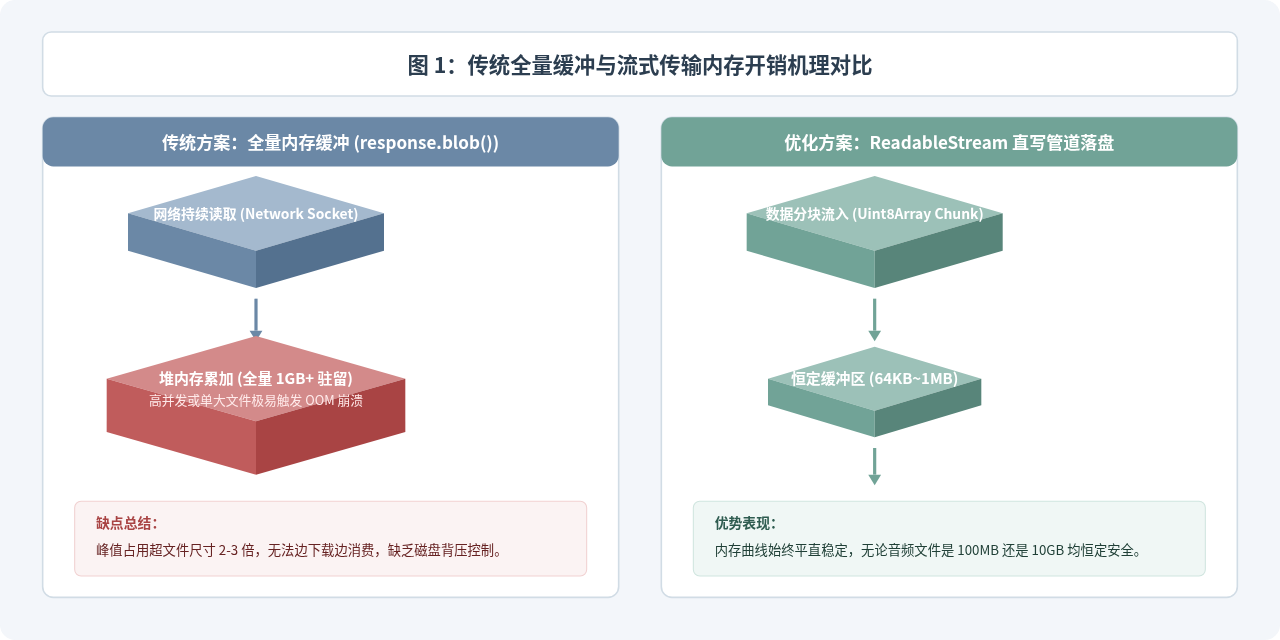
前端开发者最常用的客户端下载模式通常由三步构成:通过 fetch 发起请求、调用 response.blob() 获取完整二进制对象、生成 URL.createObjectURL(blob) 并触发虚拟 <a> 标签的点击下载。这种模式在处理几十千字节或数兆字节的文件时简单高效,但在面对大体积音频时会引发严重的内存连锁反应。
具体而言,瓶颈体现在三个阶段:
- 堆内存双倍占用: 当调用
response.blob()时,网络底层拉取的所有数据块必须在内存中拼接成完整的连续缓冲区。当后续触发浏览器下载模块时,内核往往还会发生内存副本复制,导致内存峰值达到文件体积的 2 倍到 3 倍。 - 移动端与低配设备堆上限受限: 现代桌面端 64 位浏览器单标签页的堆上限约为 2GB 到 4GB,而移动端或特定嵌入式 WebView 的上限往往低至 512MB 到 1GB。一个 800MB 的无损音频母带下载几乎必然导致移动端页面闪退。
- V8 垃圾回收严重停顿: 超大连续对象的分配与回收会给 V8 引擎的垃圾回收器带来巨大压力,导致页面发生长达数秒的掉帧与卡死,用户无法进行任何交互。
二、现代流式落盘核心方案:File System Access API
在 Chromium 内核(Chrome、Edge 等)中,W3C 标准的 File System Access API 提供了直接向本地磁盘写入数据的能力。结合 fetch 返回的 ReadableStream,我们可以构建一条完整的零冗余流水线:网络套接字接收数据块 -> 写入磁盘文件流 -> 立即交还内存,确保 JavaScript 堆中只有当前正在写入的微小分块。
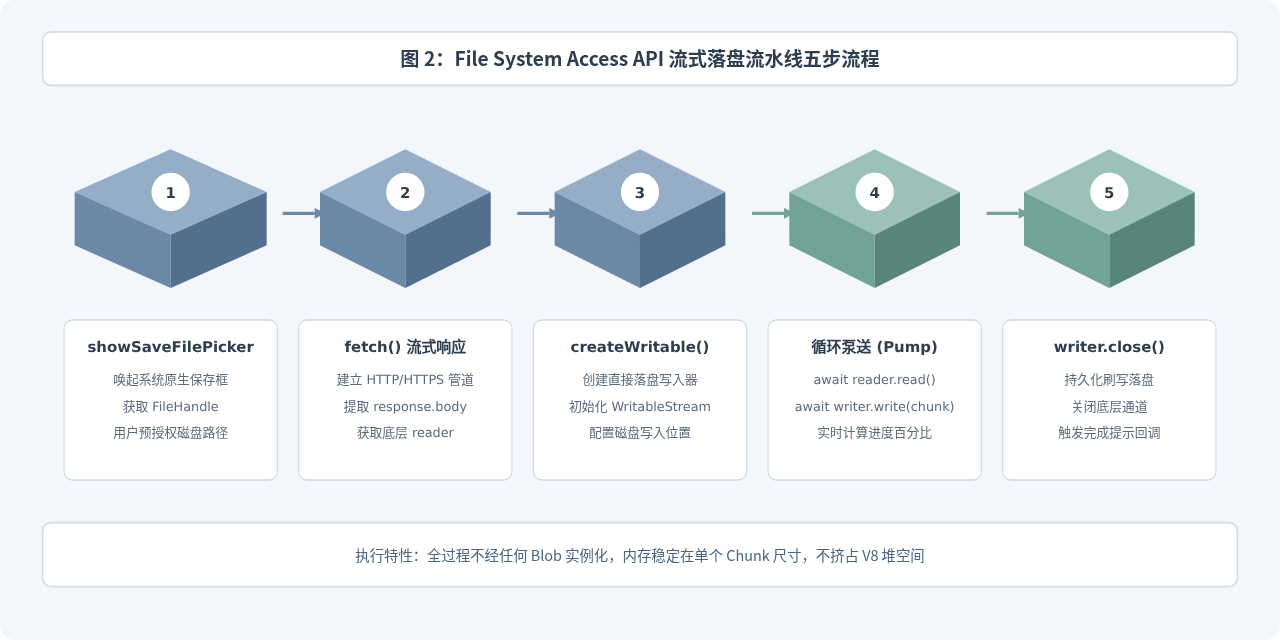
1. 完整落地实现步骤
- 调用
showSaveFilePicker: 弹出原生系统保存对话框,由用户预先确认目标路径并创建文件句柄(FileSystemFileHandle)。 - 获取可写流
FileSystemWritableFileStream: 调用fileHandle.createWritable()建立磁盘文件写入通道。 - 发起网络流式请求: 借助
fetch()获取响应体,通过response.body.getReader()拿到底层可读流读取器。 - 循环读取与背压写入: 通过
reader.read()循环获取value(类型为Uint8Array),并调用await writer.write(value)。在此过程中,await确保了写入背压:只有当上一批数据成功排队或写入磁盘后,才会拉取下一个网络包。 - 关闭流与释放句柄: 在循环结束后调用
writer.close(),确保系统将写缓冲区完全刷入持久化介质。
2. 生产级直接落盘实现代码
以下代码提供了完整的下载与错误恢复机制,包含下载取消(AbortController)、进度回调计算以及异常时自动关闭句柄:
/**
 * 流式下载超大音频文件并直接写入本地磁盘
 * @param {string} audioUrl - 音频文件的远程地址
 * @param {string} suggestedName - 建议保存的文件名(如 master_track.flac)
 * @param {function} onProgress - 进度回调 (loaded, total, percent)
 * @param {AbortSignal} signal - 外部取消信号
 */
async function downloadLargeAudioStream(audioUrl, suggestedName, onProgress, signal) {
  // 1. 检查浏览器 API 支持性
  if (!('showSaveFilePicker' in window)) {
    throw new Error('当前浏览器不支持 File System Access API,需走降级通道');
  }

  // 2. 唤起保存对话框,获取文件句柄
  const fileHandle = await window.showSaveFilePicker({
    suggestedName: suggestedName || 'audio_track.flac',
    types: [{
      description: 'Audio File',
      accept: {
        'audio/flac': ['.flac'],
        'audio/wav': ['.wav'],
        'audio/mpeg': ['.mp3'],
        'audio/aac': ['.aac'],
        'application/octet-stream': ['.bin']
      }
    }]
  });

  // 3. 创建磁盘可写流
  const writableStream = await fileHandle.createWritable();
  let reader = null;

  try {
    // 4. 发起网络请求获取可读流
    const response = await fetch(audioUrl, {
      method: 'GET',
      signal: signal
    });

    if (!response.ok) {
      throw new Error(`网络响应错误,HTTP 状态码: ${response.status}`);
    }

    const contentLength = response.headers.get('Content-Length');
    const totalBytes = contentLength ? parseInt(contentLength, 10) : 0;
    let receivedBytes = 0;

    reader = response.body.getReader();

    // 5. 循环读取并逐块写入磁盘
    while (true) {
      const { done, value } = await reader.read();
      if (done) {
        break;
      }

      // 写入当前分块(自带背压控制,写完当前块才继续读取)
      await writableStream.write(value);

      receivedBytes += value.length;
      if (onProgress && totalBytes > 0) {
        const percent = ((receivedBytes / totalBytes) * 100).toFixed(2);
        onProgress(receivedBytes, totalBytes, percent);
      }
    }

    // 6. 正常关闭写入流完成落盘
    await writableStream.close();
  } catch (error) {
    // 发生异常或用户中止时,确保安全释放写入锁与文件
    try {
      await writableStream.abort(error.message);
    } catch (abortErr) {
      // 忽略重复关闭异常
    }
    if (reader) {
      try {
        await reader.cancel();
      } catch (cancelErr) {}
    }
    throw error;
  }
}
三、多浏览器兼容与渐进降级方案
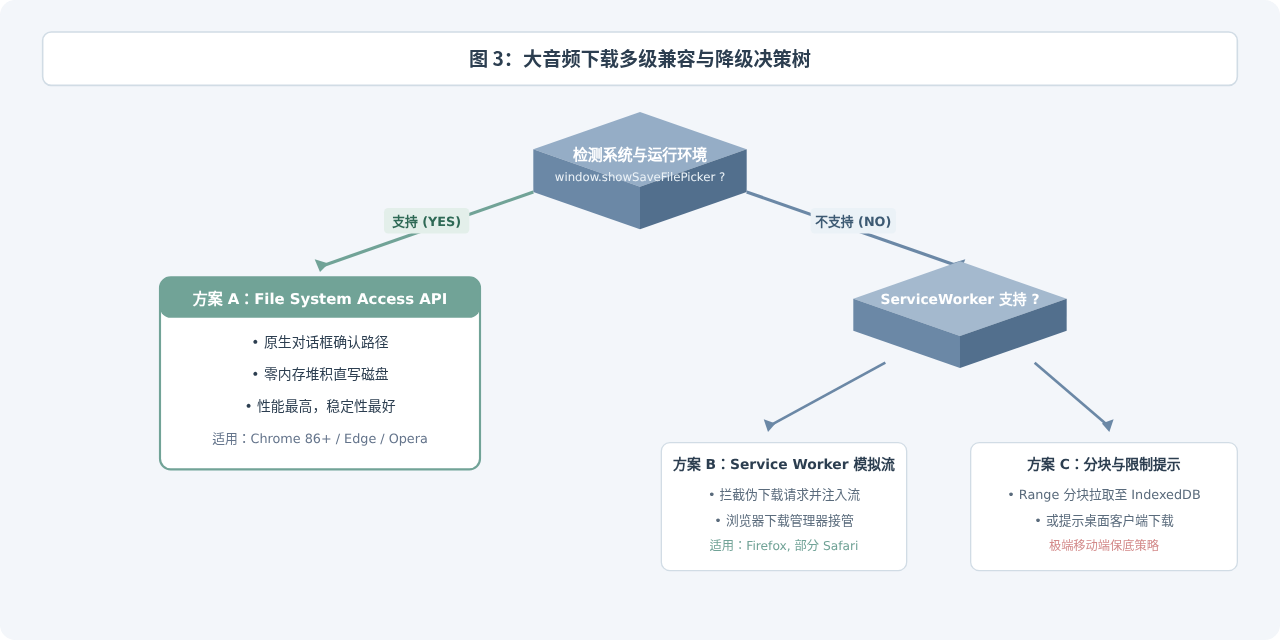
虽然 showSaveFilePicker 在基于 Chromium 的桌面浏览器中运行优异,但在 Firefox、Safari 以及移动端浏览器中存在兼容性差异。为了保证生产系统在所有终端均可正常工作,必须建立多层决策与降级机制。
1. Service Worker 模拟流式下载(StreamSaver 机制)
在不支持 showSaveFilePicker 但支持 Service Worker 的浏览器(如 Firefox 或特定版本的 Safari)中,可以使用 Service Worker 拦截机制:
- 主线程向 Service Worker 注册一条带有特定标识的虚假下载请求(如
/download-stream?id=xxx)。 - Service Worker 拦截该 GET 请求,并向浏览器返回一个带有
Content-Disposition: attachment; filename="xxx.flac"响应头的Response对象,其数据体直接挂接在由主线程通过MessageChannel转移过来的ReadableStream上。 - 浏览器下载管理器识别到附件下载头,便会自动将网络流入的数据写向用户的“下载”目录,而不会在主线程内存中驻留大文件。
2. 断点续传与 Range 分块拉取
大体积音频在网络不稳定时容易发生传输中断。为了避免从头重新下载,服务端需开启 HTTP Accept-Ranges: bytes 支持。前端在流式管道中可以记录当前已经成功持久化的字节数,若发生网络重连,通过在请求头中指定已下载区间继续拉取:
// 断点续传请求头构造
const headers = new Headers();
if (alreadyDownloadedBytes > 0) {
  headers.set('Range', `bytes=${alreadyDownloadedBytes}-`);
}

const response = await fetch(audioUrl, {
  method: 'GET',
  headers: headers
});

// 服务端返回 206 Partial Content 表示支持分段续传
if (response.status === 206) {
  // 从断点位置继续向可写流追加数据
}
四、关键细节与内存回收注意事项
避坑提醒:
在流式处理过程中,即使使用了流式 API,若代码编写不当依然容易引发内存泄漏。以下三个细节必须重点把控:
- 严禁在循环内做闭包数据缓存: 部分开发者为了计算波形图或校验哈希,会在循环
reader.read()时顺手将每个valuepush 到一个外部数组中(例如chunks.push(value))。这会完全抵消流式优化的效果,使得内存依然随时间线性暴增。正确的做法是:如果需要计算哈希或渲染波形,必须使用增量算法(如 Web Crypto API 的流式哈希,或边读取边降采样为微小的声波振幅点阵)。 - 及时解除引用与显式释放: 如果在降级方案中不得不使用小块 Blob,务必在使用完毕后立即调用
URL.revokeObjectURL(url)。浏览器只有在显式调用 revoke 或页面卸载时才会清理对象 URL 映射表。 - 服务端 CORS 暴露标头配置: 很多流式下载进度条无法显示总大小,原因在于服务端开启了 CORS 但没有配置
Access-Control-Expose-Headers。若未显式暴露Content-Length和Content-Range,前端在跨域模式下无法通过response.headers.get('Content-Length')获取总字节数,导致进度百分比计算失效。
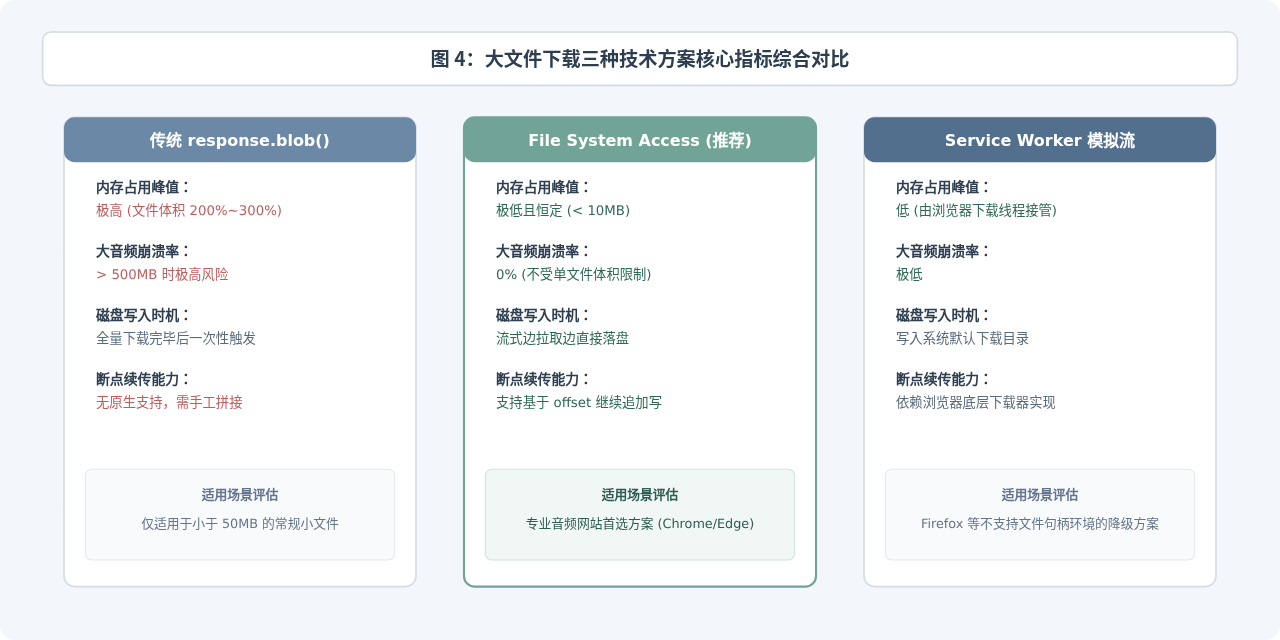
五、各方案全生命周期特性总结
六、总结与落地建议
在 JavaScript 中处理大体积音频下载的核心原则是“流式贯通、避免全量滞留”。传统的 response.blob() 在音频文件体积攀升至百兆乃至吉字节级别时已不再适用。
建议在工程实施中采用以下分层落地策略:
- 优先使用 File System Access API: 通过
showSaveFilePicker()与createWritable(),配合response.body.getReader()建立网络到磁盘的零内存积压通道,将内存开销彻底压制在几兆字节的恒定窗口。 - 针对不支持的浏览器启用 Service Worker 管道或提示: 在不支持原生文件写入的端(如移动端 Safari),结合 Service Worker 拦截转发模拟流式下载;对于硬件受限极其严重的移动端场景,可主动提示用户复制链接在桌面端完成下载。
- 服务端配合输出标准标头: 务必配置
Accept-Ranges: bytes并通过 CORS 显式暴露Content-Length与Content-Range,确保前端能够精确渲染下载进度并支撑中断续传。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章