

深入解析前端JavaScript下载MP3文件出现无法播放、文件损坏或0字节的根本原因,从文本转码、HTTP错误拦截、Base64转换到对象URL生命周期,提供系统排查步骤与完整可运行的高可用代码。
为什么JS下载的MP3文件无法播放或数据损坏
作者:代码拾荒
时间:2026-10-30
浏览:322
文章目录
在前端开发中,使用 JavaScript 动态下载 MP3 音频文件是一项常见需求。然而,许多开发者会遇到类似的问题:浏览器成功触发了文件下载,保存到本地的文件名也是 music.mp3,但使用系统播放器打开时却提示“文件已损坏”、“无法识别格式”,或者音频文件大小只有几百字节甚至 0 字节。本文将系统分析导致这一现象的四个底层技术原因,并提供切实可行的排查路径与标准实现方案。
一、核心根源:把二进制流当做普通文本读取
MP3 是一种高度压缩的二进制多媒体格式。它的底层由若干个紧凑排列的音频帧(Audio Frames)以及开头的 ID3 元数据标签组成。每一个 MP3 帧都必须以严格的 11 位同步字(Syncword,通常是 0xFFE 或 0xFFF)起始,随后紧跟采样率、声道模式和比特率等核心控制字节。
前端最普遍的失误,是在使用 fetch() 请求音频文件时,错误地调用了 response.text():
// 错误示例:将二进制音频当做 UTF-8 文本解析
fetch('https://example.com/audio.mp3')
  .then(res => res.text()) // 致命错误:触发 UTF-8 字符解码
  .then(textData => {
    // 再次将字符串封入 Blob,导致数据不可逆损坏
    const blob = new Blob([textData], { type: 'audio/mp3' });
    const url = URL.createObjectURL(blob);
    const a = document.createElement('a');
    a.href = url;
    a.download = 'song.mp3';
    a.click();
  });
response.text() 内部会假定响应流是某种文本编码(默认为 UTF-8),并尝试将字节流转换为 JavaScript 的 UTF-16 内存字符串。当遇到 MP3 原始字节中不符合 UTF-8 编码规则的非 ASCII 字节序列时,解码器会自动用 Unicode 替换字符 U+FFFD(即十六进制 0xEF 0xBF 0xBD)替换无效字节。这一过程是单向且不可逆的,它直接撕裂了原本紧密衔接的音频帧同步字与控制头。当播放器尝试读取该文件时,由于找不到合法的帧头,便会直接抛出“文件损坏”错误。
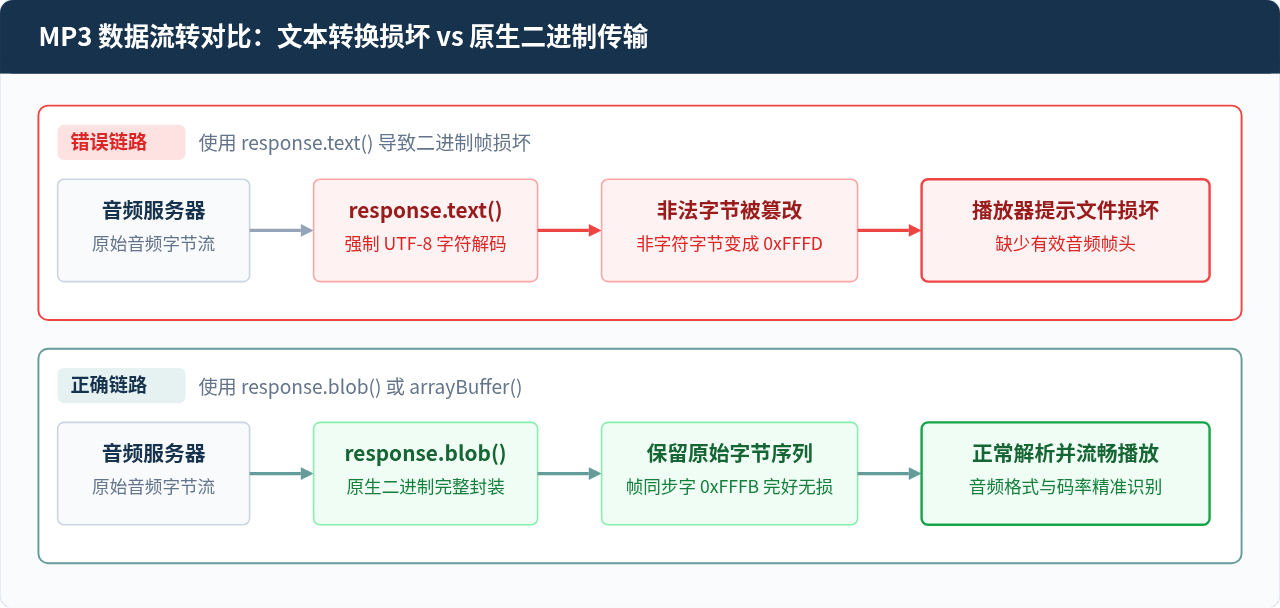
图 1:文本解析与二进制直接接收的底层流转差异
二、“伪装文件”陷阱:下载的是服务器报错页面
另一个极其高频但常被忽略的现象是:下载下来的文件只有 1KB 到 4KB,或者用系统记事本打开后,赫然看到 <!DOCTYPE html> 或 {"code": 403, "msg": "Token expired"}。
这是因为原生 fetch() 的设计机制中,只有网络断开、DNS解析失败或跨域被完全拦截时才会进入 catch 块。如果服务端返回了 401 Unauthorized、403 Forbidden、404 Not Found 或 500 Internal Error,fetch() 依然会成功返回一个 Promise。如果前端没有主动检查 response.ok,就会把错误返回的 HTML 报错页面或 JSON 结果直接打包成 Blob,并给它冠以 .mp3 的后缀名保存。这本质上是一个文本文件,播放器自然无法解码。
排查技巧:遇到无法播放的 MP3 时,先查看文件属性。常规 MP3 码率(128kbps~320kbps)下一分钟音频体积约为 1MB~2.5MB。如果下载的音频文件只有几 KB,立即用文本编辑器(如 VS Code 或记事本)打开该文件,如果能看到清晰的 HTML 标签或 JSON 错误提示,说明是服务端鉴权或防盗链拦截失败,而非前端下载代码本身的二进制处理问题。
三、Base64 与二进制流拼接中的转换偏差
在某些业务场景中,音频数据可能来自 WebSocket、本地录音转换或接口返回的 Base64 编码字符串。在这里,开发者极容易犯下两个低级但隐蔽的语法错误:
1. 直接将 atob() 解码后的字符串传入 Blob
// 错误示例:atob 字符串直接包装为 Blob
const base64Str = "SUQzBAAAAAAAI1RTU0U..."; // 包含 MP3 数据的 Base64
const binaryString = atob(base64Str);
// 错误:binaryString 虽包含单字节字符,但直接作为入参传入 Blob 会按 UTF-8 处理
const blob = new Blob([binaryString], { type: 'audio/mp3' });
window.atob() 返回的是一个“二进制字符串”(Binary String),其内部字符的 Unicode 编码值位于 0 到 255 之间。直接将该字符串放入 new Blob([binaryString]),浏览器的 Blob 构造器仍然会对其进行 UTF-8 编码打包,导致大于 0x7F 的字节被再次转义为多字节序列。正确做法是必须通过 Uint8Array 进行显式字节映射:
// 正确做法:通过类型化数组映射二进制字节
function base64ToAudioBlob(base64Data, mimeType = 'audio/mp3') {
  const binaryString = atob(base64Data);
  const len = binaryString.length;
  const bytes = new Uint8Array(len);
  for (let i = 0; i < len; i++) {
    bytes[i] = binaryString.charCodeAt(i);
  }
  return new Blob([bytes], { type: mimeType });
}
2. ReadableStream 块拼接长度错位
当使用 response.body.getReader() 分块读取大音频文件时,如果错误地将每个分块转为字符串进行 chunk1 + chunk2 的字符串相加,或者动态扩容 Uint8Array 时偏移量计算错误,都会破坏切片边界上的音频帧。必须准确记录总字节数,并使用单个大 Uint8Array 依次拷贝,或者将所有分块收集到数组中,直接一次性传给 new Blob(chunksArray)。
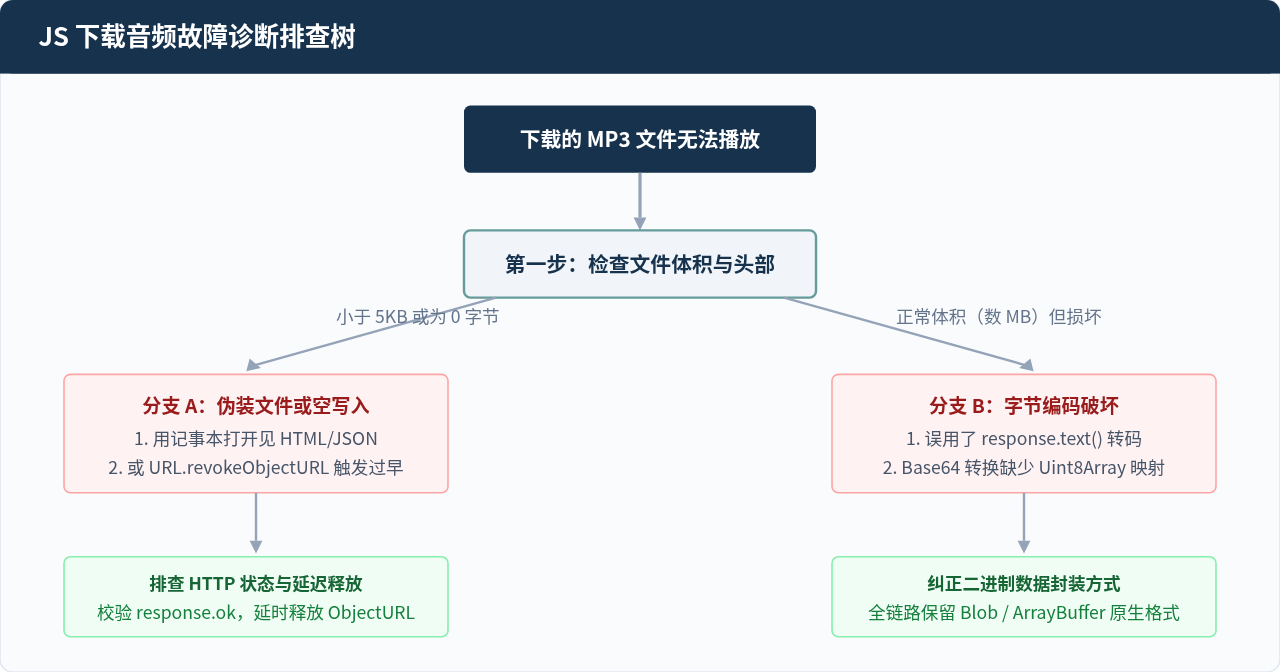
图 2:排查 MP3 下载失效的关键分支判定路径
四、浏览器内存与下载触发机制:URL.revokeObjectURL 的过早释放
前端通过构造虚拟 <a> 标签触发下载时,通常会搭配 URL.createObjectURL(blob) 与 URL.revokeObjectURL(url) 使用。很多开发者为了避免内存泄漏,写出如下代码:
// 存在时序竞态的危险代码
const blobUrl = URL.createObjectURL(blob);
const a = document.createElement('a');
a.href = blobUrl;
a.download = 'music.mp3';
document.body.appendChild(a);
a.click();
document.body.removeChild(a);
URL.revokeObjectURL(blobUrl); // 危险:立即释放内存引用!
a.click() 触发下载后,浏览器的底层文件写入机制是异步进行的。在 Firefox、Safari 以及部分基于 Chromium 的移动端浏览器中,如果紧接着同步调用 URL.revokeObjectURL(blobUrl),该 Blob URL 会在浏览器底层真正完成数据拉取与磁盘落盘之前被销毁。其结果就是下载被强行截断,生成一个 0 字节或者仅写入了头部几百字节的半截 MP3 文件,同样会导致播放器无法打开。
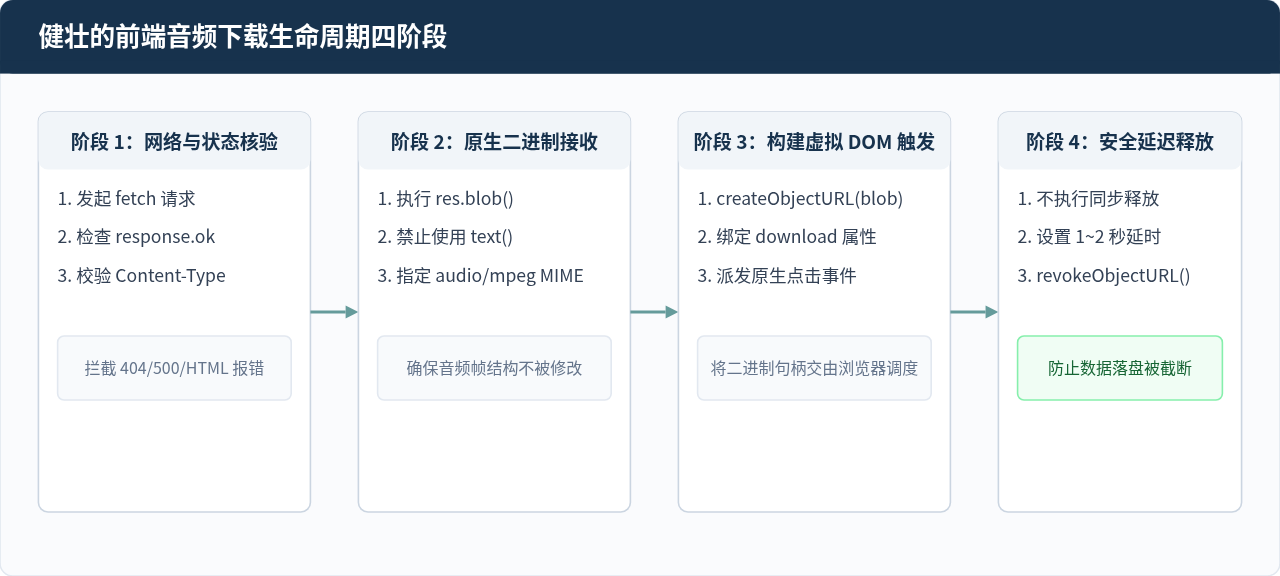
图 3:严谨的音频文件下载四大执行步骤
五、生产环境高可靠实现方案
为了彻底杜绝“文件无法播放”和“数据损坏”,推荐封装一个通用的音频下载函数。该函数涵盖前置校验、跨域配置、二进制保持与安全释放机制:
/**
 * 安全下载远程 MP3 音频文件
 * @param {string} audioUrl 音频资源远程地址
 * @param {string} filename 保存到本地的文件名
 */
async function downloadMp3Securely(audioUrl, filename = 'download.mp3') {
  try {
    const response = await fetch(audioUrl, {
      method: 'GET',
      mode: 'cors',
      cache: 'no-cache'
    });

    // 1. 严格校验 HTTP 响应状态码,阻止 404/403/500 等错误内容被下载
    if (!response.ok) {
      throw new Error(`音频拉取失败: HTTP 状态码 ${response.status} (${response.statusText})`);
    }

    // 2. 验证响应类型,防止将 HTML/JSON 等报错文本重命名为 MP3
    const contentType = response.headers.get('content-type') || '';
    if (contentType.includes('text/html') || contentType.includes('application/json')) {
      throw new Error(`服务返回非音频内容: Content-Type 为 ${contentType}`);
    }

    // 3. 必须采用 response.blob() 获取纯净的二进制数据
    const audioBlob = await response.blob();

    // 4. 生成内存对象 URL 并绑定至虚拟链接
    const objectUrl = URL.createObjectURL(audioBlob);
    const link = document.createElement('a');
    link.style.display = 'none';
    link.href = objectUrl;
    link.download = filename.endsWith('.mp3') ? filename : `${filename}.mp3`;

    document.body.appendChild(link);
    link.click();
    document.body.removeChild(link);

    // 5. 延迟 1.5 秒释放 ObjectURL,给浏览器留出充足的落盘写入时间
    setTimeout(() => {
      URL.revokeObjectURL(objectUrl);
    }, 1500);

  } catch (error) {
    console.error('MP3 下载终止:', error.message);
    alert(`下载失败: ${error.message}`);
  }
}
跨域(CORS)与防盗链注意事项:如果音频资源部署在第三方 CDN(如七牛云、阿里云 OSS 或 AWS S3),必须确保 CDN 节点配置了
Access-Control-Allow-Origin 响应头。如果缺少 CORS 权限,fetch() 会在握手阶段报错;即使通过 <a href="..." download> 标签直接下载,跨域情况下 download 属性也会失效,导致浏览器直接在标签页内打开播放而非保存文件。
六、排查与解决矩阵总结
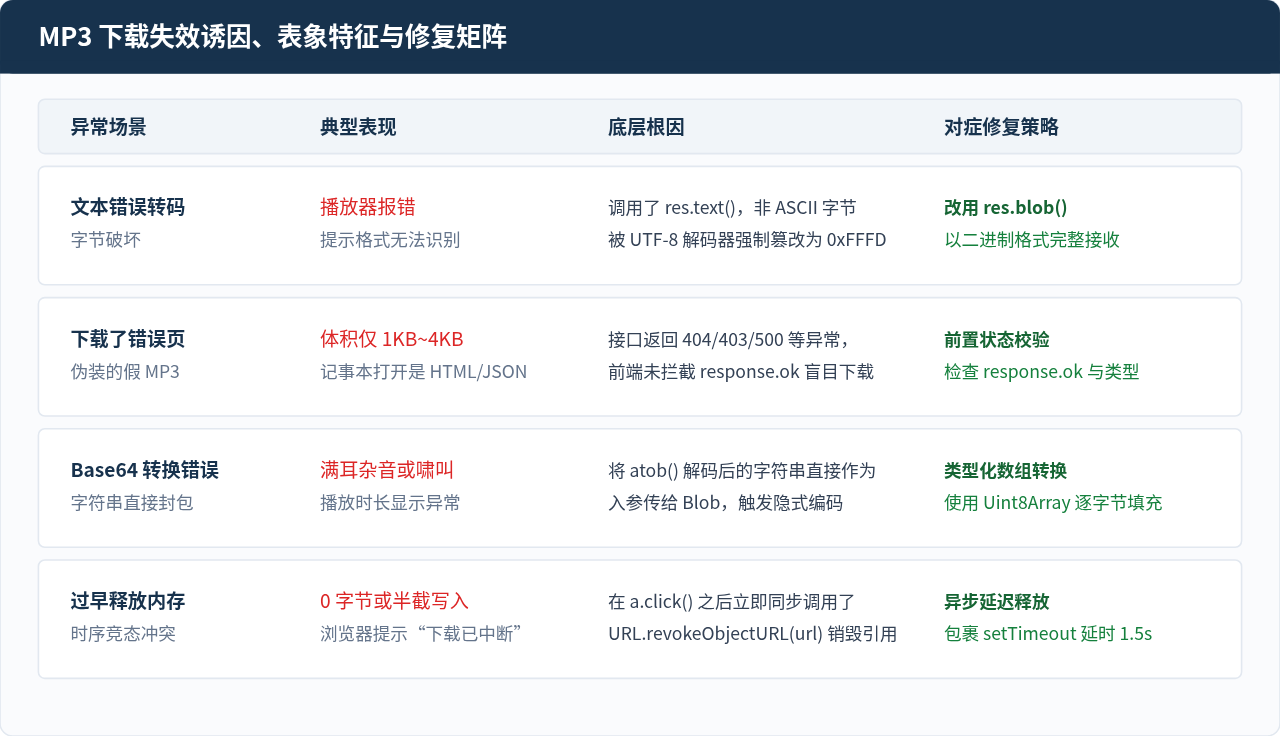
图 4:常见故障核心诱因、表现与修复措施全景速查
排查前端 MP3 下载故障的核心原则可以归结为一句话:“在网络层验证有效性,在传输层保留二进制,在触发层避免时序截断”。只要遵循上述标准开发流程,就能彻底解决各类由于前端数据转换与下载调度带来的音频损坏问题。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章