

深入剖析JavaScript在前端下载大文件时页面卡死、内存溢出(OOM)及下载失败的根本原因,详细讲解Fetch与Axios的响应类型配置、流式下载分块处理、进度监听与内存释放最佳实践。
JavaScript下载大文件失败或卡死,怎么配置Fetch与Axios响应类型
作者:代码拾荒
时间:2026-10-30
浏览:634
文章目录
在前端使用 JavaScript 通过 HTTP 请求下载几百兆甚至数吉字节(GB)的大文件时,开发者常遇到浏览器标签页无响应、CPU 飙升乃至直接报“Out of Memory”白屏崩溃的问题。其核心原因在于默认的网络请求处理会把数据以字符串形式全部写入 JavaScript 引擎的堆内存中。解决该问题的关键是显式配置底层响应类型为二进制对象(Blob)或采用流式读取(ReadableStream),并在文件成功触发落盘后及时释放对象 URL 内存。
一、为什么前端下载大文件会卡死甚至崩溃
很多开发者在实现前端文件下载时,习惯性沿用常规接口的数据消费逻辑,或者直接通过 fetch(url).then(res => res.text())、axios.get(url) 接收数据。对于小型的 JSON 数据或几百 KB 的图片,这种做法完全没有问题;但在处理几百 MB 到数 GB 的大文件时,该逻辑会直接触碰浏览器的系统底层限制。
具体而言,主要瓶颈体现在以下几个物理层面:
- V8 引擎字符串长度与堆内存限制:在 64 位 Chrome/Node 环境中,JavaScript 的单个字符串最大长度约有 512MB 到 1GB 的硬性上限。如果尝试将一个 1.5GB 的二进制文件读入字符串,程序会直接抛出
RangeError: Invalid string length异常。 - 全量缓冲带来的主线程阻塞与高频 GC:当海量数据块涌入内存时,JavaScript 垃圾回收器(Garbage Collector)会被迫频繁执行 Full GC 操作。由于 GC 会暂停主事件循环(Stop-The-World),此时用户无法滚动页面、无法点击按钮,直观感受就是页面彻底“卡死”。
- Blob 驻留内存未释放导致 OOM:即使将数据接收为 Blob,如果不控制并发或没有执行
URL.revokeObjectURL(),已经生成的对象 URL 会持续占用浏览器堆外虚拟内存,最终导致浏览器标签页直接崩溃。
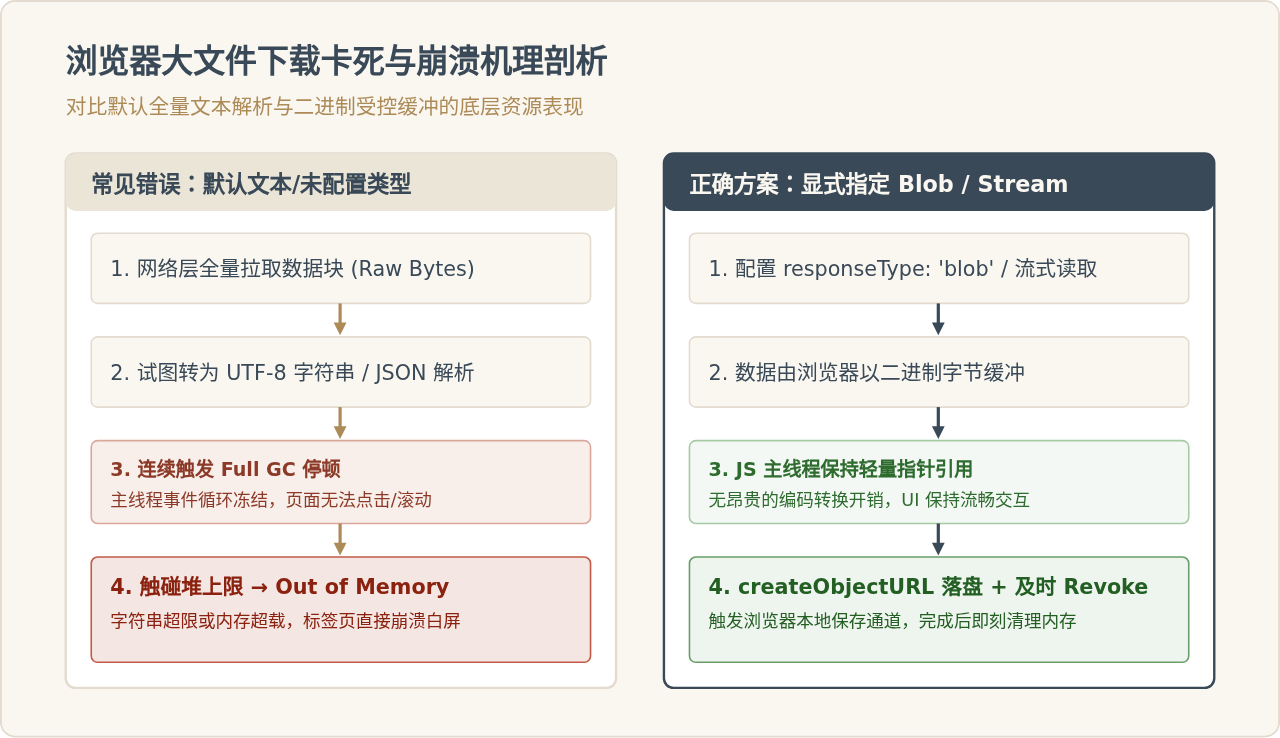
图 1:大文件在浏览器主线程中的内存流转机理对比
二、Axios 的正确响应类型配置与完整代码
在使用 Axios 下载文件时,默认的 responseType 是 'json'。如果后端返回的是二进制流(例如 application/octet-stream、application/pdf),Axios 会试图将其按文本和 JSON 规则转换,引发严重的性能损耗与乱码。
处理大文件时,必须显式传入配置参数 responseType: 'blob'。同时,还可以结合 onDownloadProgress 钩子实现精准的百分比下载进度计算。
import axios from 'axios';

/**
 * 使用 Axios 安全下载大文件并监听进度
 * @param {string} url 下载地址
 * @param {string} defaultFilename 备用文件名
 * @param {Function} onProgress 进度回调函数 (percent) => void
 */
export async function downloadLargeFileWithAxios(url, defaultFilename, onProgress) {
  try {
    const response = await axios({
      method: 'GET',
      url: url,
      // 核心配置:必须显式指定为 blob
      responseType: 'blob',
      // 支持中断控制
      timeout: 120000,
      onDownloadProgress: (progressEvent) => {
        if (progressEvent.total) {
          // progressEvent.loaded 与 total 单位均为字节 (Bytes)
          const percent = Math.round((progressEvent.loaded * 100) / progressEvent.total);
          if (onProgress) onProgress(percent);
        }
      }
    });

    // 从响应头的 Content-Disposition 中提取服务端推荐的文件名
    let filename = defaultFilename;
    const disposition = response.headers['content-disposition'];
    if (disposition && disposition.includes('filename=')) {
      const match = disposition.match(/filename[^;=\n]*=((['"]).*?\2|[^;\n]*)/);
      if (match && match[1]) {
        filename = decodeURIComponent(match[1].replace(/['"]/g, ''));
      }
    }

    // 将二进制响应构建为 Blob 对象并触发本地落盘
    const blob = new Blob([response.data], {
      type: response.headers['content-type'] || 'application/octet-stream'
    });
    const blobUrl = window.URL.createObjectURL(blob);

    const anchor = document.createElement('a');
    anchor.style.display = 'none';
    anchor.href = blobUrl;
    anchor.download = filename;
    document.body.appendChild(anchor);
    anchor.click();

    // 关键步骤:延迟注销对象 URL,释放虚拟内存
    setTimeout(() => {
      document.body.removeChild(anchor);
      window.URL.revokeObjectURL(blobUrl);
    }, 1000);

    return true;
  } catch (error) {
    // 踩坑点:当设置 responseType: 'blob' 时,如果接口报错(如 401、500),
    // error.response.data 也会是一个 Blob,不能直接读取其中的 message!
    if (error.response && error.response.data instanceof Blob) {
      const errorText = await error.response.data.text();
      try {
        const errorJson = JSON.parse(errorText);
        console.error('下载接口业务报错:', errorJson);
      } catch {
        console.error('下载接口响应异常文本:', errorText);
      }
    } else {
      console.error('网络或未知异常:', error.message);
    }
    throw error;
  }
}
⚠️ Axios 响应类型为 Blob 时的异常捕获陷阱
很多开发者发现,当服务端由于权限不足返回 403 或业务报错返回 500 JSON 时,前端的错误处理逻辑打印出来的居然是 [object Blob]。这是因为 Axios 严格按照请求配置将报错返回体的二进制流也包装成了 Blob。此时必须通过 await error.response.data.text() 将 Blob 反向读取为纯文本,再通过 JSON.parse 解析出真实报错原因。
三、Fetch API 的响应处理:Blob 与 ReadableStream 流式消费
原生 fetch 请求与 Axios 略有不同。fetch() 返回的 Response 对象本身就是一个数据流载体。我们不能在获取到响应后调用 response.text() 或 response.json(),而应该调用 response.blob()。
对于特大文件(如超过 500MB),直接调用 response.blob() 仍会要求浏览器在内存中等待整段数据缓冲完毕。如果需要更细粒度的内存控制和实时进度监听,应该使用 response.body.getReader() 对可读流进行分块读取。
/**
 * 使用 Fetch API 流式下载超大文件并监听进度
 */
export async function downloadLargeFileWithFetch(url, filename, onProgress) {
  const response = await fetch(url, {
    method: 'GET',
    headers: {
      'Accept': 'application/octet-stream'
    }
  });

  if (!response.ok) {
    throw new Error(`请求失败,状态码: ${response.status}`);
  }

  // 读取总大小计算进度
  const contentLength = response.headers.get('content-length');
  const total = contentLength ? parseInt(contentLength, 10) : 0;
  let loaded = 0;

  // 获取可读流的 Reader 对象
  const reader = response.body.getReader();
  const chunks = [];

  while (true) {
    const { done, value } = await reader.read();
    if (done) break;

    // value 为 Uint8Array 类型的二进制数据块
    chunks.push(value);
    loaded += value.length;

    if (total > 0 && onProgress) {
      onProgress(Math.round((loaded * 100) / total));
    }
  }

  // 将分块组装为最终 Blob
  const blob = new Blob(chunks, {
    type: response.headers.get('content-type') || 'application/octet-stream'
  });
  const downloadUrl = window.URL.createObjectURL(blob);

  const link = document.createElement('a');
  link.href = downloadUrl;
  link.download = filename;
  document.body.appendChild(link);
  link.click();

  // 释放资源
  setTimeout(() => {
    document.body.removeChild(link);
    window.URL.revokeObjectURL(downloadUrl);
  }, 1000);
}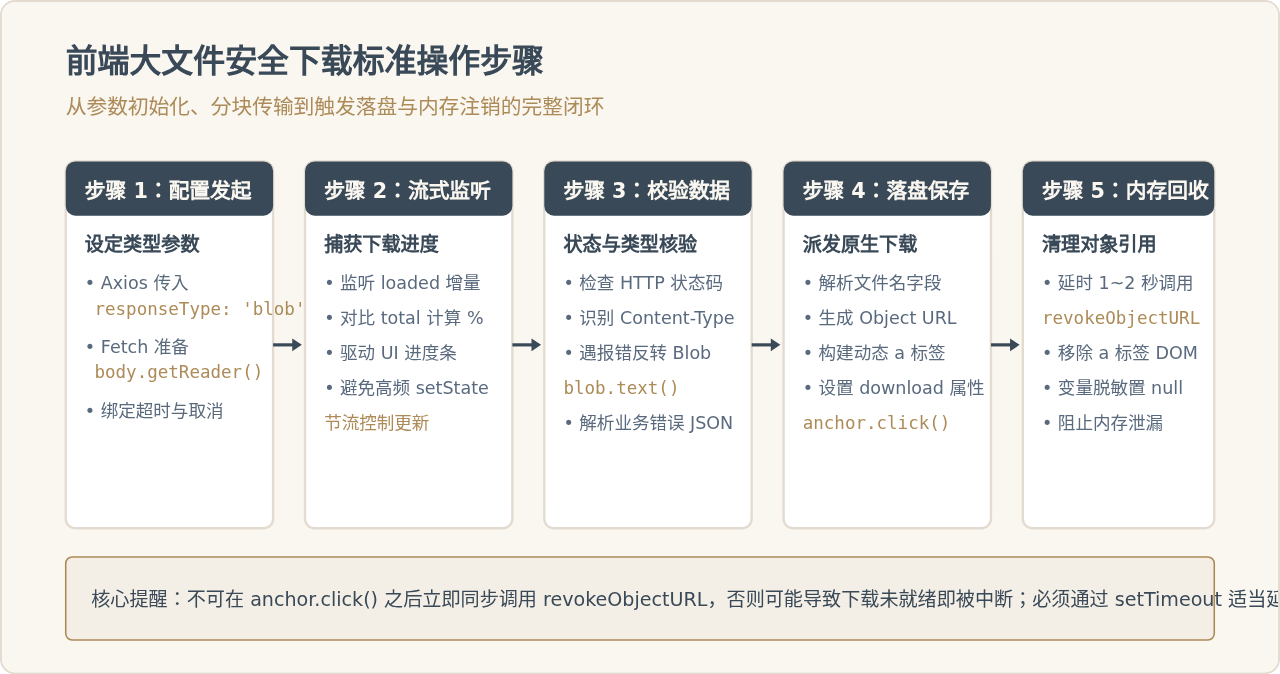
图 2:Fetch 与 Axios 大文件下载的标准闭环执行步骤
四、Fetch 与 Axios 核心能力与选型对比
在面对大文件下载需求时,Fetch 和 Axios 在参数语法、进度监控能力以及流式支持深度上存在明显差异。下表清晰罗列了它们的核心指标:
| 评估维度 | Fetch API | Axios |
|---|---|---|
| 响应类型配置 | 在链式调用阶段指定:res.blob() 或 res.arrayBuffer() |
在发起请求配置对象中指定:responseType: 'blob' |
| 下载进度监听 | 无内置参数,必须使用 res.body.getReader() 循环累加分块 |
原生内置 onDownloadProgress 回调,直接提供 loaded 与 total |
| 超大文件流式管道 | 原生支持 ReadableStream,可配合 Streams API 流式传输 |
浏览器端底层仍由 XHR 缓冲为全量 Blob,无法真正避免内存堆积 |
| 请求取消支持 | 使用现代标准的 AbortController 触发信号中断 |
早期使用 CancelToken,新版均统一支持 AbortController |
| HTTP 错误状态响应 | 状态码为 4xx/5xx 时不进入 catch,需自行检查 res.ok |
自动进入 reject/catch,但在 blob 配置下错误响应也是 Blob |
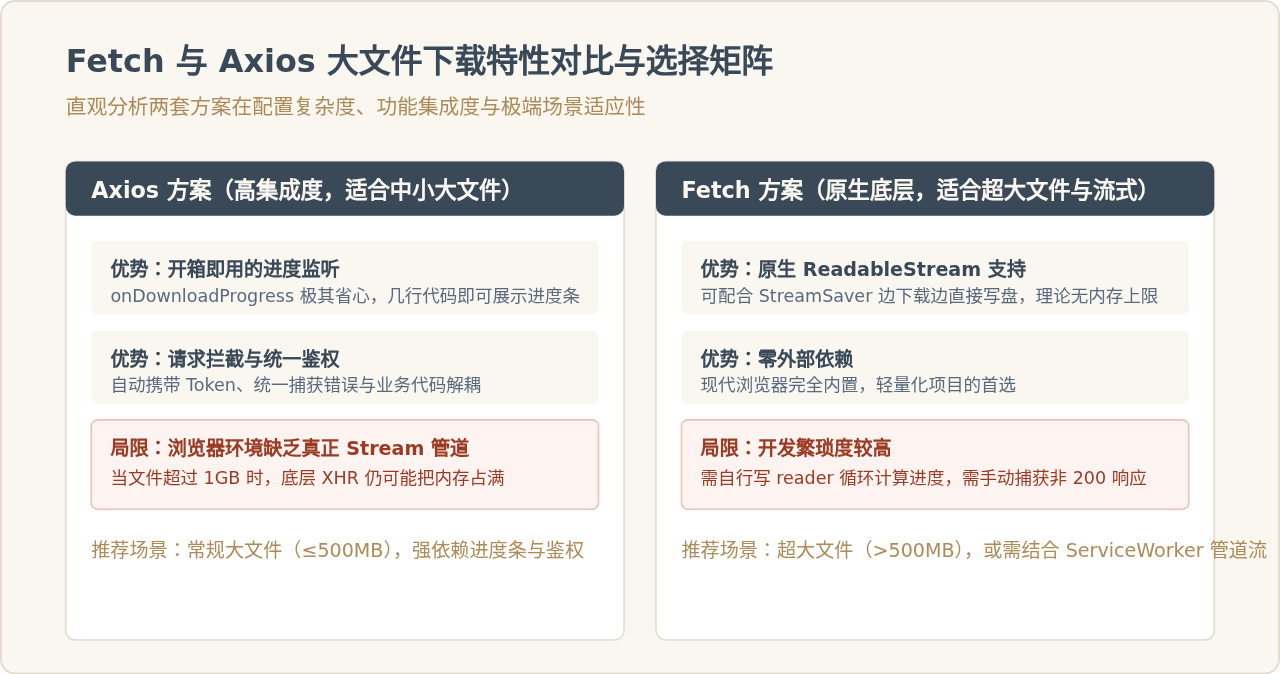
图 3:Fetch 与 Axios 在处理大文件场景下的特性与选型矩阵
五、大文件避坑指南与终极解决方案
即使正确配置了 responseType: 'blob' 或使用了 fetch(),在实际生产环境中依然可能遇到以下两项棘手的限制:
1. 为什么下载超过 2GB 的文件依然会失败?
这是因为由 JavaScript 构建的 Blob 对象必须在操作系统的虚拟内存或浏览器沙箱临时空间中聚合。在 32 位浏览器或部分移动端环境中,单次分配 Blob 的上限通常在 500MB 到 2GB 之间。一旦超过该物理限制,调用 URL.createObjectURL(blob) 就会直接抛出 ERR_OUT_OF_MEMORY 或网络错误。
2. 超大文件(>2GB)的终极处理方案:原生下载与临时签名 URL
如果不需要通过请求头传递自定义认证信息(如 Authorization: Bearer xxx),最好的大文件下载方案永远是不经过前端 JavaScript 内存。直接通过 <a href="url" download> 或 window.location.href = url 触发。
在有权限验证的业务场景下,推荐的工业界标准做法是:
- 前端先通过常规的 JSON 接口向后端申请下载凭证(如携带 Token 发起请求)。
- 后端鉴权通过后,生成一个带有时效性的短链接或临时签名 URL(例如使用云存储 S3/OSS 的预签名 URL,有效期 5 分钟)。
- 后端将该签名 URL 返回给前端。
- 前端通过动态创建
<a href="signedUrl" download>派发点击,将实际的文件下载交由浏览器的原生下载管理器执行。
这样不仅完全规避了 JavaScript 堆内存与主线程的任何压力,还能自动获得浏览器的断点续传、后台下载与下载管理面板能力。
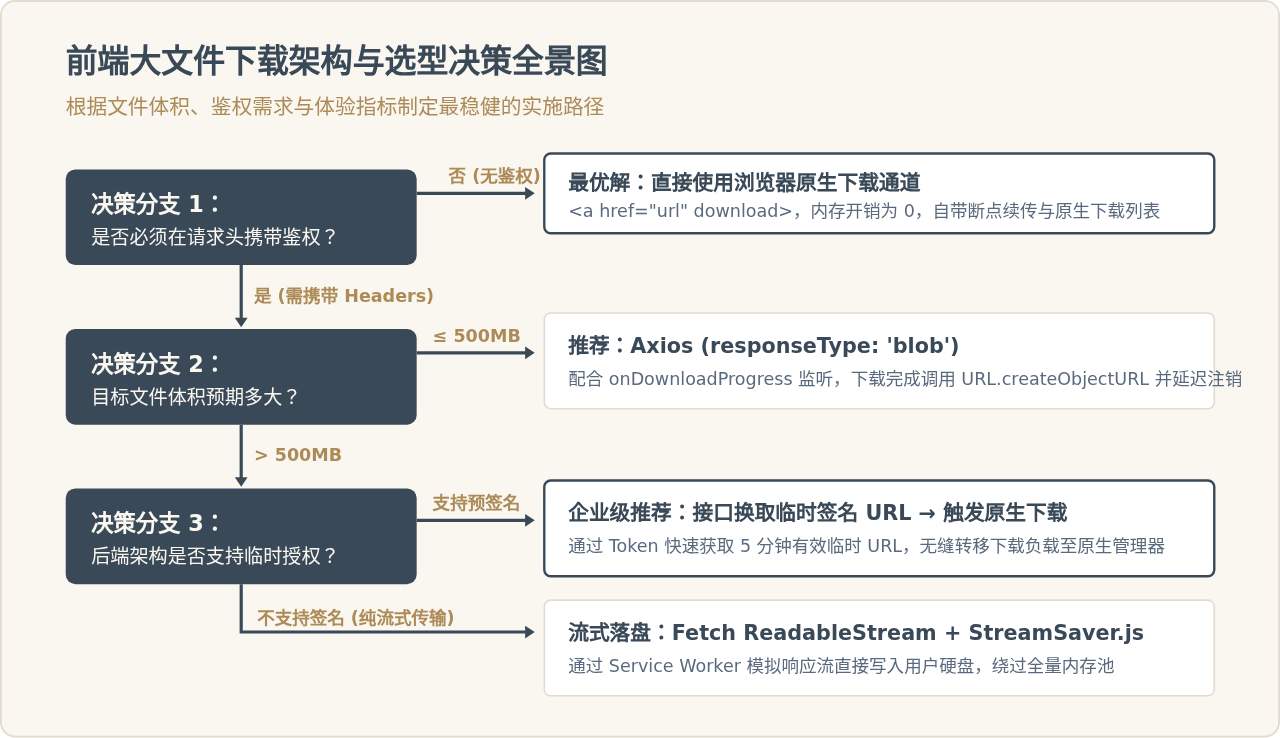
图 4:大文件下载的技术选型与最佳实践决策树
六、核心排查与自检清单
当项目出现下载大文件异常、卡顿或浏览器报错时,可按以下次序逐一排查:
- 检查请求配置:Axios 是否明确配置了
responseType: 'blob'?没有配置时默认会当做 JSON/字符串处理。 - 检查服务端响应头:后端是否配置了正确的
Content-Type(如application/octet-stream)以及Content-Length?若缺少Content-Length,进度计算将无法得出总进度。 - 检查跨域暴露头(CORS):前端若需要从响应头获取文件名或真实大小,后端的
Access-Control-Expose-Headers必须显式声明Content-Disposition和Content-Length。 - 检查对象 URL 释放:在
anchor.click()执行后,是否通过setTimeout触发了URL.revokeObjectURL(url)?严禁过早释放,但也绝不可遗漏。 - 检查错误状态类型转换:在
catch块中,是否对error.response.data进行了针对 Blob 类型的识别与文本解构,防止错误信息无法被正常捕获。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章