
深入解析JavaScript中BigInt大整数无法直接通过JSON.stringify序列化的原因,并系统介绍Replacer替换函数、扩展toJSON原型方法、Reviver还原以及第三方无损解析库等多种格式化与传输方案。

当前位置:首页 > JavaScript 基础 > 正文
JavaScript中大整数(BigInt)的JSON格式化方案
作者:资源驿站
时间:2026-10-30
浏览:317
文章目录
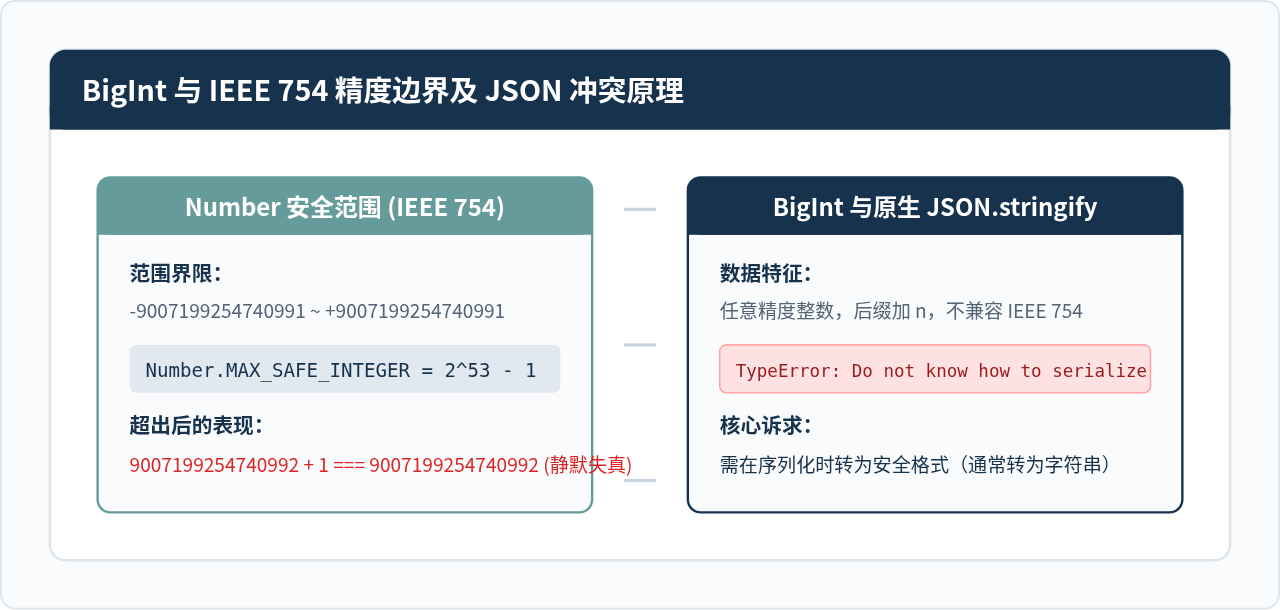
在现代JavaScript应用中,当处理分布式数据库ID(如雪花算法Snowflake ID)、高精度金融金额或加密货币哈希值时,原生BigInt已成为不可或缺的数据类型。然而直接执行JSON.stringify({ id: 9007199254740993n })会立即抛出运行时错误TypeError: Do not know how to serialize a BigInt。本文将明确解释该限制的根本原理,并系统介绍四种实用格式化方案、反序列化时的精度陷阱及生产环境中的技术选型依据。
一、BigInt 序列化失败的根本原因与精度边界
ECMAScript规范在引入BigInt时,并未为原生JSON.stringify定义大整数的默认序列化规则。这不是规范实现的遗漏,而是一项有意为之的架构防护设计:
- JSON规范中无数字类型分级: RFC 8259规范中定义的JSON只包含通用的
number类型,没有区分32位整型、64位浮点型或任意精度整型。 - IEEE 754双精度浮点数限制: JavaScript传统的
Number采用双精度浮点格式,其最大安全整数为Number.MAX_SAFE_INTEGER(即 253 - 1 = 9007199254740991)。一旦数值超过此界限,在数字解析过程中就会出现静默截断和进位丢失。 - 防止静默数据损毁: 如果引擎盲目将
BigInt按无引号数字输出到JSON文本中,下游系统如果同样采用标准JavaScript解释器解析该JSON,就会在毫无告警的情况下丢失精度。因此,规范要求直接抛出类型错误,强制开发者根据具体传输协议做出显式设计。
二、方案一:使用 JSON.stringify 的 Replacer 替换函数
JSON.stringify的第二个参数允许传入一个转换函数(Replacer)。在该函数中检测属性值的类型,遇到bigint时将其转换为字符串。这是标准库原生支持、零副作用且最为推荐的局部解决方式。
1. 基础实现代码
// 针对大整数的序列化转换函数
function bigintReplacer(key, value) {
  return typeof value === 'bigint' ? value.toString() : value;
}

// 测试数据
const orderData = {
  orderId: 9007199254740993n,
  amount: 1250n,
  status: 'PAID',
  createdAt: '2026-10-22T10:00:00Z'
};

const jsonString = JSON.stringify(orderData, bigintReplacer, 2);
console.log(jsonString);
/* 输出示例:
{
  "orderId": "9007199254740993",
  "amount": "1250",
  "status": "PAID",
  "createdAt": "2026-10-22T10:00:00Z"
}
*/
2. 封装高阶通用格式化工具
在企业级模块中,为了避免在每个调用点重复书写Replacer,可以封装一个健壮的序列化工具函数:
/**
 * 安全的 JSON 字符串化工具,无缝支持 BigInt
 * @param {any} data 待序列化数据
 * @param {number|string} space 缩进空格
 * @returns {string}
 */
export function stringifyWithBigInt(data, space) {
  return JSON.stringify(data, (key, value) => {
    if (typeof value === 'bigint') {
      return value.toString();
    }
    return value;
  }, space);
}
注意:Replacer 函数的执行上下文与空键
Replacer 首次被调用时,传入的 key 为空字符串 "",value 为整个待序列化的顶层对象或顶层大整数。因此必须严格判断 typeof value === 'bigint',不要对 key 进行非空前置断言。
三、方案二:扩展 BigInt 原型链的 toJSON 方法
JSON.stringify在序列化每个对象时,会优先检查该对象上是否存在toJSON方法。如果存在,则直接取toJSON()的返回值参与序列化。虽然BigInt.prototype默认没有该方法,但开发者可以直接挂载。
1. 原型扩展实现
// 全局扩展 BigInt 原型
if (typeof BigInt.prototype.toJSON !== 'function') {
  BigInt.prototype.toJSON = function () {
    return this.toString();
  };
}

// 扩展生效后,直接使用标准原生调用
const payload = {
  id: 18446744073709551615n,
  remark: "系统根节点"
};

console.log(JSON.stringify(payload));
// 输出: {"id":"18446744073709551615","remark":"系统根节点"}
2. 原型扩展方案的利弊权衡
- 优点: 侵入性集中在入口文件处配置一次,全局所有深层嵌套对象、第三方库内部触发的
JSON.stringify均可自动生效,调用体验完全透明。 - 潜在风险与工程陷阱: 修改语言原生类型的原型链(Monkey Patching)违背纯函数原则。如果项目中引入的多个微前端应用或第三方库分别定义了不同的
toJSON行为(例如有的转为带类型标识的对象{ $type: "BigInt", val: "..." }),就会引发全局原型污染与冲突。因此更建议在独立业务模块或独立应用顶层入口使用,不推荐在公开可复用npm包中执行该操作。
四、反序列化处理与关键精度陷阱
在网络通信或存储读取时,不仅需要将BigInt格式化为JSON,还需要从JSON文本恢复为JavaScript对象。很多开发者尝试通过JSON.parse的Reviver参数来解析大整数,但这存在一个严重的执行时序陷阱。
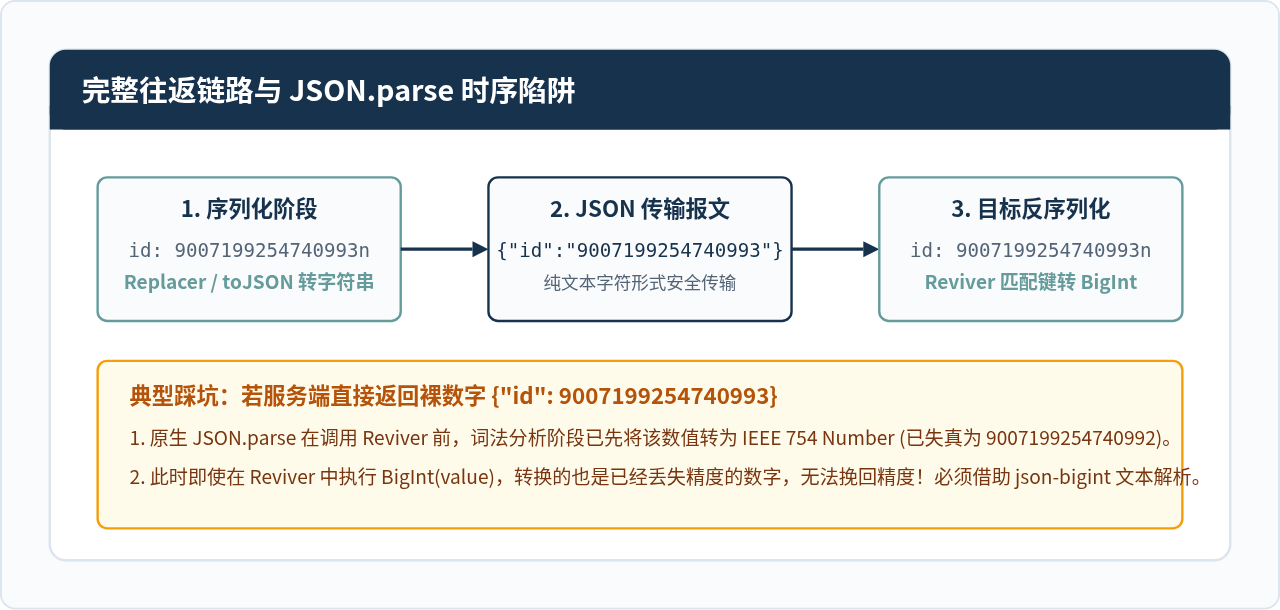
1. 安全反序列化(配合字符串传输)
在前后端约定将大整数格式化为字符串的前提下,前端可以通过Reviver根据字段名还原为BigInt:
// 指定字段还原为 BigInt
const rawJson = '{"orderId":"9007199254740993","amount":"1250","status":"PAID"}';

const bigIntFields = new Set(['orderId', 'amount']);

const parsed = JSON.parse(rawJson, (key, value) => {
  if (bigIntFields.has(key) && typeof value === 'string') {
    return BigInt(value);
  }
  return value;
});

console.log(typeof parsed.orderId); // "bigint"
console.log(parsed.orderId);        // 9007199254740993n
2. 第三方库:处理已存在无引号数字JSON(如后端直接输出裸数字)
如果后端服务(如Java Jackson使用默认设置或Go服务)直接输出了不带双引号的超长数字{"id": 9007199254740993},原生JSON.parse在执行前就已经丢失精度。此时必须使用字符级重写词法分析器的第三方库,如json-bigint:
import JSONBig from 'json-bigint';

// 配置 storeAsString: false 保持原生 BigInt,或者 true 保持为字符串
const JSONBigNative = JSONBig({ useNativeBigInt: true });

const rawJsonWithBareNumbers = '{"largeId": 9007199254740993, "status": "OK"}';

// 解析:不会经过 IEEE 754 阶段,直接解析为原生 BigInt
const result = JSONBigNative.parse(rawJsonWithBareNumbers);
console.log(typeof result.largeId); // "bigint"
console.log(result.largeId);        // 9007199254740993n

// 格式化输出:自动将大整数安全输出为数字或字符串
const serialized = JSONBigNative.stringify(result);
console.log(serialized);            // '{"largeId":9007199254740993,"status":"OK"}'
五、四种格式化方案全方位对比与技术选型
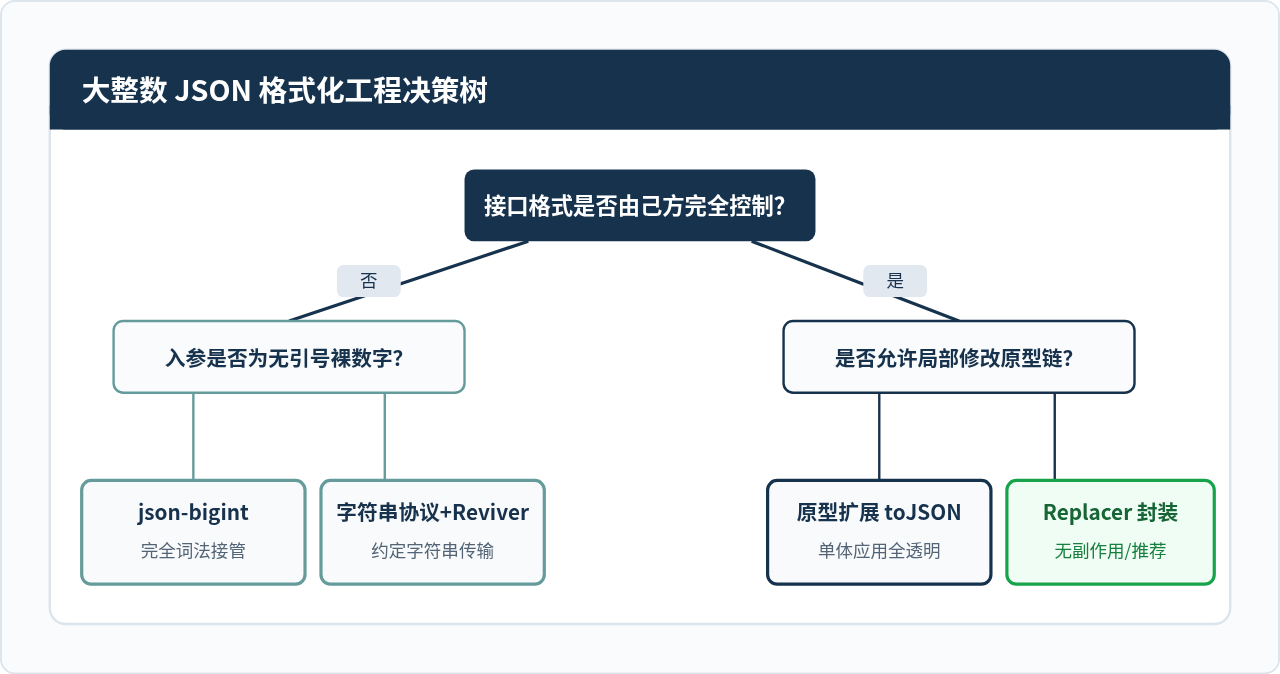
为了在架构设计和编码实现中做出最优权衡,我们将上述方案的核心指标汇总对比:
| 方案名称 | 侵入性 / 作用域 | 兼容性与标准性 | 反序列化复杂度 | 推荐使用场景 |
|---|---|---|---|---|
| Replacer 替换函数 | 局部无侵入,按需传入 | 遵循 ECMAScript 标准,零依赖 | 需根据键名显式还原 | 绝大多数中大型项目首选,公共工具函数封装 |
| 扩展 BigInt 原型 | 全局侵入,修改 Prototype | 依赖运行环境,微前端/组件库有冲突风险 | 需根据键名显式还原 | 独立闭环业务系统、脚本工具、单体前后端应用 |
| 自定义结构对象 | 局部控制,转换为包装对象 | 跨平台语义清晰,明确标识数据类型 | 可通过统一类型标识自动还原 | 复杂分布式系统、跨语言RPC数据交换(如 gRPC-Web) |
| json-bigint 库 | 引入第三方依赖(约 15KB) | 完全接管词法解析,无损支持裸大数字 | 自动直接映射为 BigInt | 无法修改后端接口、第三方系统直接返回裸长数字场景 |
六、生产环境端到端最佳实践方案
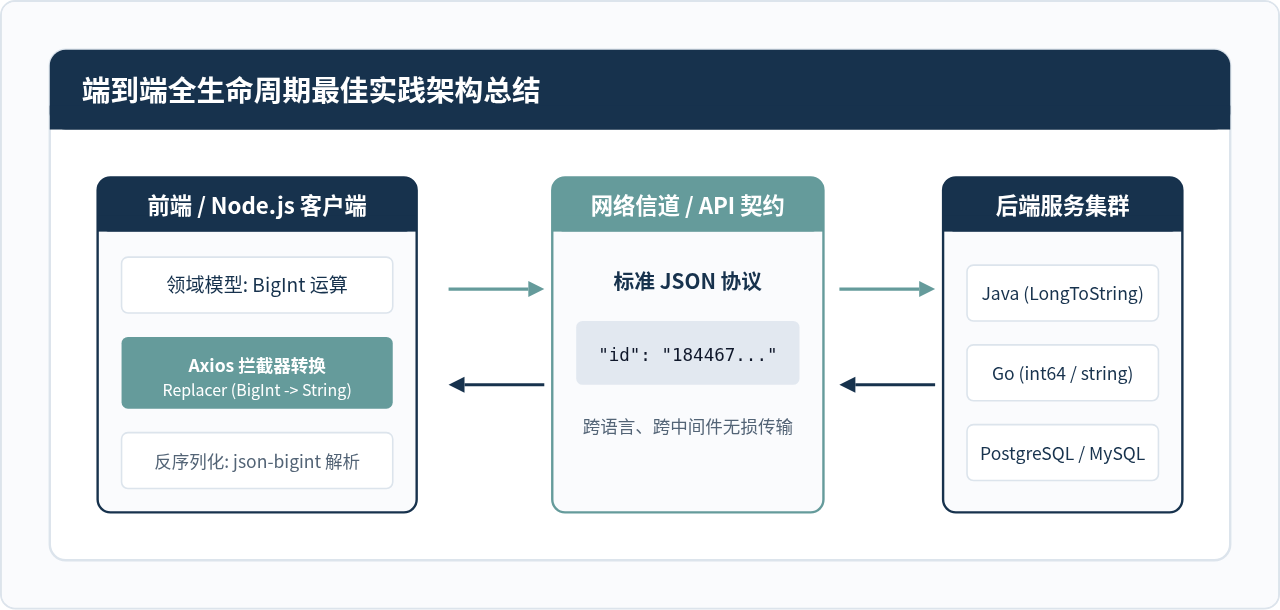
在企业级全栈开发中,最佳的架构原则是:将长整型大数作为字符串在网络信道上表达,在运行时环境内显式按需转为 BigInt。这样既满足标准 JSON 规范,也能天然兼容 Python、Java、Go 以及各类网关中间件。
1. HTTP 请求拦截器统一注入(以 Axios 为例)
import axios from 'axios';
import JSONBig from 'json-bigint';

const JSONBigNative = JSONBig({ useNativeBigInt: true });

export const apiClient = axios.create({
  baseURL: '/api/v1',
  // 覆盖默认的请求体序列化:遇到 BigInt 自动转为字符串
  transformRequest: [
    (data, headers) => {
      headers['Content-Type'] = 'application/json;charset=utf-8';
      return JSON.stringify(data, (key, value) => {
        return typeof value === 'bigint' ? value.toString() : value;
      });
    }
  ],
  // 覆盖默认的响应文本反序列化:防止网关返回裸数字导致精度截断
  transformResponse: [
    (data) => {
      if (typeof data === 'string') {
        try {
          return JSONBigNative.parse(data);
        } catch {
          return data;
        }
      }
      return data;
    }
  ]
});
2. TypeScript 类型契约规范
在前后端交互接口(DTO)声明时,建议将传输层字段类型标注为 string,业务实体转换层再映射为 bigint,避免因误用隐式转换产生不可控漏洞:
// 传输层 DTO(保证 JSON 兼容)
interface UserOrderDTO {
  orderId: string; // "1720839218392019842"
  payAmount: string;
}

// 领域实体(保证高精度数学运算)
interface UserOrderEntity {
  orderId: bigint; // 1720839218392019842n
  payAmount: bigint;
}
七、核心总结
在面对JavaScript中大整数(BigInt)的JSON格式化问题时,开发者应建立清晰的处理心智:
- 定位问题本质:
TypeError不是缺陷,而是规范在抵御 IEEE 754 精度静默丢失时的保护壁垒。 - 序列化首选: 在业务工具库中使用
JSON.stringify(data, (_, v) => typeof v === 'bigint' ? v.toString() : v),避免随意污染全局原型。 - 规避反序列化陷阱: 严禁将超长数字以无引号裸数值的形式在 JSON 中传递;一旦接收到裸数字,必须使用
json-bigint在字符流阶段介入解析。 - 建立工程契约: 前后端在接口规范中明确大数字段为
string,实现跨系统、跨语言的完全安全通信。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章