
本文详细介绍在前端使用JavaScript实现批量下载多个文件的完整方案,包括动态创建a标签触发下载、控制时间间隔规避浏览器拦截,以及利用JSZip打包压缩后单文件下载的实践与原理。

当前位置:首页 > JavaScript DOM 与事件 > 正文
怎么使用JavaScript批量下载多个文件?
作者:像素漫游
时间:2026-10-30
浏览:132
文章目录
在前端网页开发中,批量下载多个文件主要有两种可靠的实现思路:一种是通过动态创建 <a> 标签并结合适当的延时循环触发下载,让浏览器逐个拉取文件;另一种是使用前端压缩库(例如 JSZip)将多个文件打包成一个 .zip 压缩包,再以单个文件的形式触发下载。本文将详细讲解这两种方案的具体代码实现、执行逻辑、适用场景以及浏览器限制的应对方法。
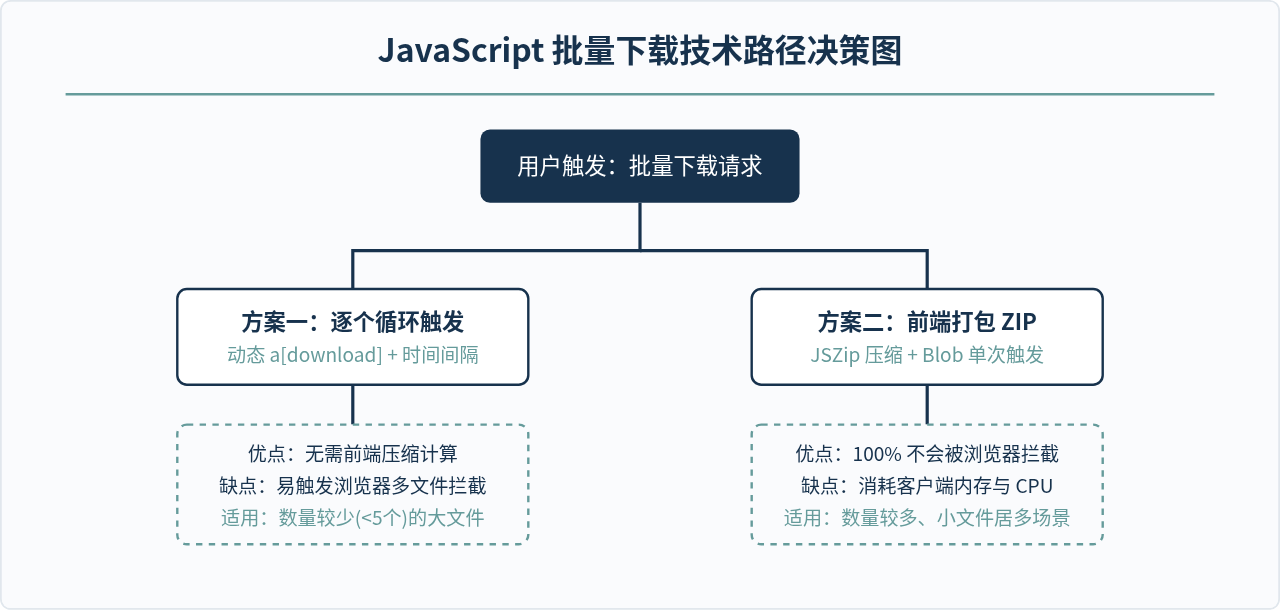
图 1:前端批量下载方案的技术路径与选型决策
方案一:通过动态 a 标签逐个触发下载
HTML5 为 <a> 标签增加了 download 属性。只要给标签指定该属性并触发点击事件,浏览器便会将目标链接保存为本地文件,而不是在当前窗口或新标签页中打开它。
1. 为什么不能直接用同步循环
如果直接在 forEach 循环中连续调用 click(),现代浏览器(如 Chrome、Edge 等)会认为这是一个恶意弹窗行为,通常仅允许第一个文件成功下载,后续下载任务会被静默拦截或弹出“是否允许该网站下载多个文件”的警告弹窗。若用户未留意,其他文件就会直接丢失。
解决该问题的关键是在每次下载触发之间加入一定的时间间隔(建议 300ms 到 800ms),让浏览器有充足的时间建立下载管道,降低被判定为恶意请求的概率。
2. 完整实现代码
// 模拟文件列表(同源路径或服务端已允许跨域资源)
const fileList = [
  { url: '/files/report-2026-01.pdf', filename: '1月份报告.pdf' },
  { url: '/files/report-2026-02.pdf', filename: '2月份报告.pdf' },
  { url: '/files/report-2026-03.pdf', filename: '3月份报告.pdf' }
];

// 单个文件触发下载辅助函数
function triggerDownload(url, filename) {
  const anchor = document.createElement('a');
  anchor.href = url;
  anchor.download = filename;
  anchor.style.display = 'none';
  document.body.appendChild(anchor);
  anchor.click();
  document.body.removeChild(anchor);
}

// 延迟函数
const delay = (ms) => new Promise(resolve => setTimeout(resolve, ms));

// 批量逐个下载主函数
async function downloadFilesSequentially(list, interval = 500) {
  for (let i = 0; i < list.length; i++) {
    const file = list[i];
    triggerDownload(file.url, file.filename);
    // 最后一个文件触发后无需再等待
    if (i < list.length - 1) {
      await delay(interval);
    }
  }
}

// 调用执行
downloadFilesSequentially(fileList);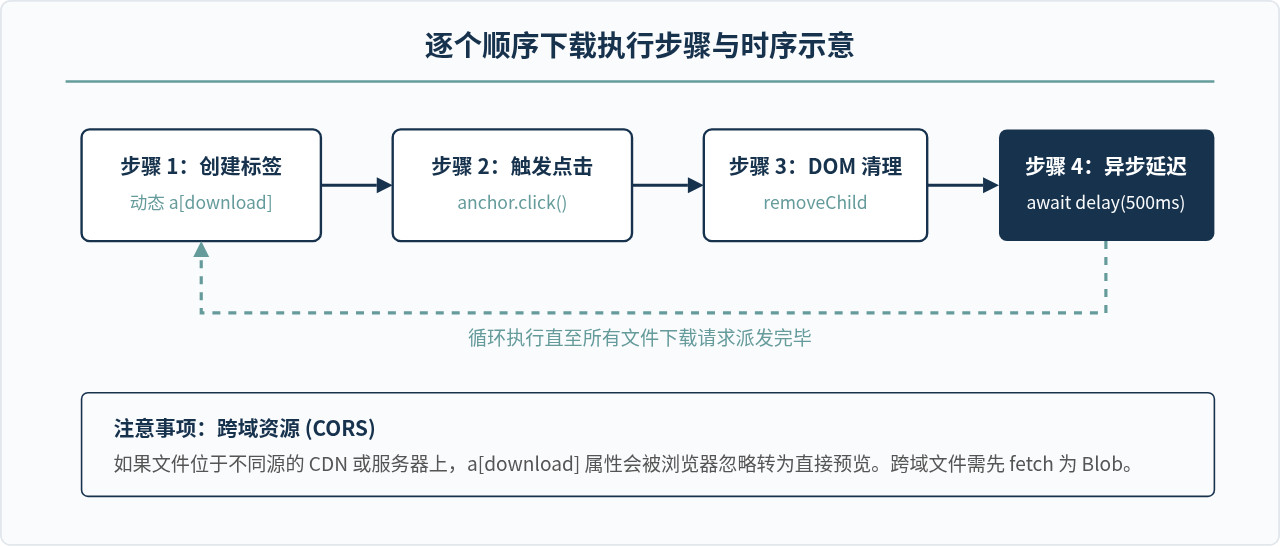
图 2:逐个下载的具体处理流程与延时规避机制
方案二:前端打包 ZIP 批量下载(推荐)
当文件数量较多(例如 10 个以上)时,给用户连续弹出十多次保存提示或生成十多个分散文件,用户体验极差。更优雅的做法是在客户端通过 JSZip 库将全部文件打包压缩,最终只触发一次单文件下载。
1. 打包下载的核心原理
- 网络请求(Fetch):使用
fetch()并发或分批请求各个文件的二进制数据(response.blob()或response.arrayBuffer())。 - 装载到 Zip 实例:调用
zip.file(filename, data)将抓取到的文件写入虚拟目录。 - 生成压缩包:调用
zip.generateAsync({ type: 'blob' })导出整包的Blob对象。 - 触发下载:利用
URL.createObjectURL(blob)生成临时内存 URL 并由单个 a 标签下载。
2. 完整实现代码
// 引入 JSZip 库(可通过 npm 安装或 script 标签引入)
// <script src="https://cdn.jsdelivr.net/npm/jszip@3.10.1/dist/jszip.min.js"></script>

async function downloadAsZip(fileList, zipFilename = 'package.zip') {
  const zip = new JSZip();

  // 1. 并发获取所有文件的 Blob 数据
  const downloadPromises = fileList.map(async (file) => {
    const response = await fetch(file.url);
    if (!response.ok) {
      throw new Error(`文件获取失败: ${file.url}`);
    }
    const blob = await response.blob();
    // 写入 zip 包内
    zip.file(file.filename, blob);
  });

  // 等待所有文件拉取完毕
  await Promise.all(downloadPromises);

  // 2. 压缩生成整个 zip 的 Blob
  const zipBlob = await zip.generateAsync({
    type: 'blob',
    compression: 'DEFLATE',
    compressionOptions: { level: 6 } // 压缩等级 1-9
  });

  // 3. 触发单个压缩包的下载
  const downloadUrl = URL.createObjectURL(zipBlob);
  const anchor = document.createElement('a');
  anchor.href = downloadUrl;
  anchor.download = zipFilename;
  anchor.style.display = 'none';
  document.body.appendChild(anchor);
  anchor.click();

  // 4. 清理内存占用
  document.body.removeChild(anchor);
  URL.revokeObjectURL(downloadUrl);
}

// 示例调用
const files = [
  { url: '/images/chart1.png', filename: '图表1.png' },
  { url: '/images/chart2.png', filename: '图表2.png' },
  { url: '/docs/summary.txt', filename: '汇总说明.txt' }
];

downloadAsZip(files, '批量数据包.zip').catch(err => console.error(err));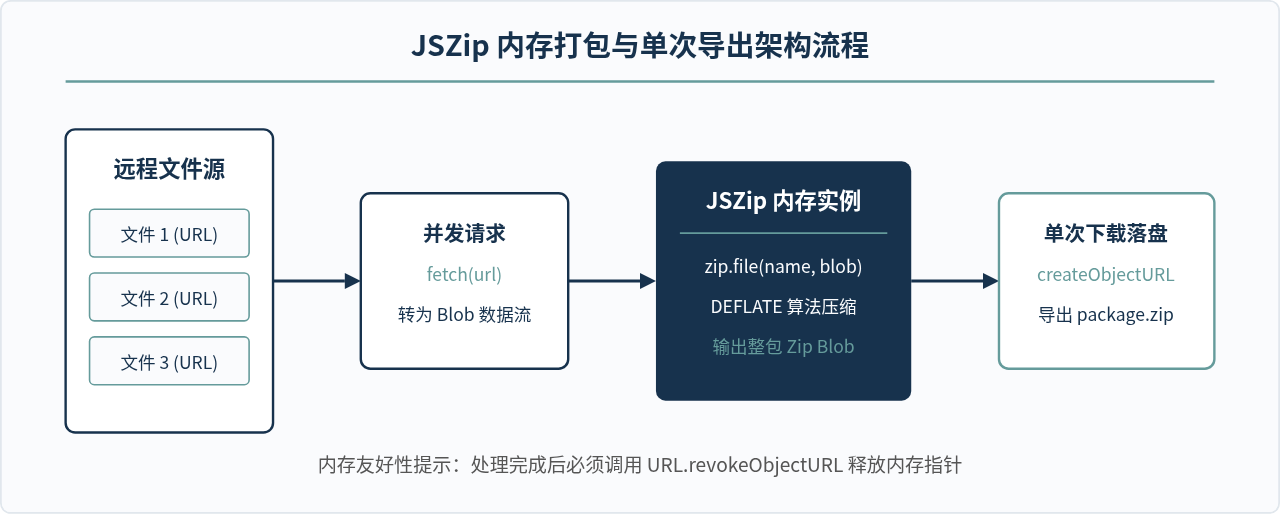
图 3:客户端内存打包并生成单一压缩包的数据流动过程
关键难点与避坑指南
1. 跨域(CORS)限制
如果文件存储在独立的 CDN 或 OSS 存储桶上,直接通过 <a href="..." download> 跨域下载时,现代浏览器的安全策略会强制忽略 download 属性,直接尝试在浏览器中打开文件(例如 PDF 或图片)。对于打包方案,fetch 跨域资源时若服务端未配置 Access-Control-Allow-Origin: *,则无法读取二进制数据。
解决方案: 确保服务端在资源响应头中正确下发 CORS 允许头。如果是跨域且无法配置 CORS,常规方案只能借助后端接口进行代理或由后端打包。
2. 大文件导致的浏览器内存溢出
JSZip 是完全在客户端浏览器内存(RAM)中解压和构建 ZIP 文件的。如果待下载的文件总量超过 500MB,或者单个文件体积极大,将可能直接导致移动端或低内存电脑的标签页崩溃(Out of Memory)。
对于特大文件批量下载,建议优先选择后端提供打包好的归档接口,或者结合 StreamSaver.js 等基于 ServiceWorker 的流式落盘方案,避免将所有数据堆积在 JS 运行时内存中。
方案对比与场景选型总结
为了帮助您在实际开发中做出最合适的架构选择,下表对两种主要方案的关键维度进行了总结对比:
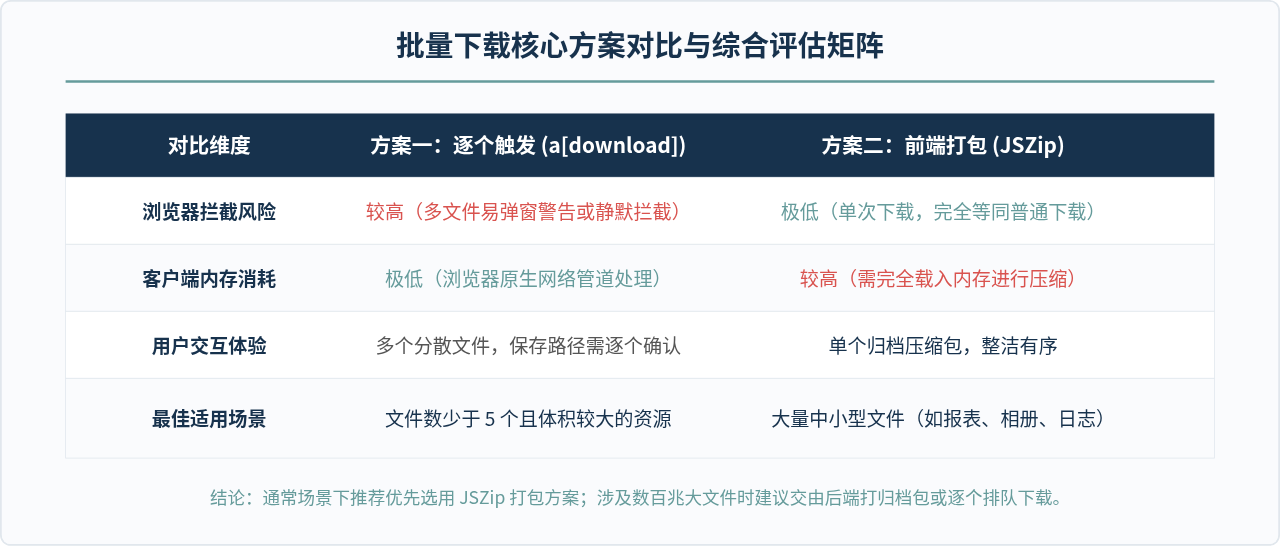
图 4:技术选型总结矩阵
结语
使用 JavaScript 批量下载文件并无唯一解法。当文件数量少且体量大时,为 a 标签设置 download 属性并配置异步时间间隔是最轻量的选择;而面对日常业务中的批量报表导出、图片包下载等常见需求,通过 JSZip 在浏览器端直接打包为单个 ZIP 文件是阻力最小、用户体验最优的标准实践。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章