

本文通过JavaScript代码实例,详细解析了Hash、Content Hash与Chunk Hash的计算原理及区别。结合Webpack配置场景,分析了三种哈希值在模块标识、内容完整性校验及代码分割中的应用。重点探讨了它们对浏览器缓存策略的影响,帮助开发者优化构建配置,提升资源加载效率。
一、使用JS验证Hash、Content Hash与Chunk Hash的区别
1、计算普通的Hash(以简单字符串为例)
使用crypto-js库进行哈希计算,需提前引入npm install crypto-js库。
crypto-js是一个JavaScript加密算法库,用于实现各种加密算法和哈希函数。它提供了一种简单而强大的方式来执行加密操作,包括对称加密算法、非对称加密算法和哈希函数等。
- 实现:这里以一个简单字符串来验证,使用
CryptoJS.SHA256进行加密。当字符串改变时,生成的加密值必然不同。 - 应用:一般开发登录模块时会用到,服务端存储的是这个哈希值。当用户再次登录输入密码时,系统会再次计算密码的哈希值,并与存储的哈希值进行比较。
const CryptoJS = require("crypto-js");
// Hash
const password = "this is my passward 1234";
const hash = CryptoJS.SHA256(password).toString();
console.log("Hash:", hash);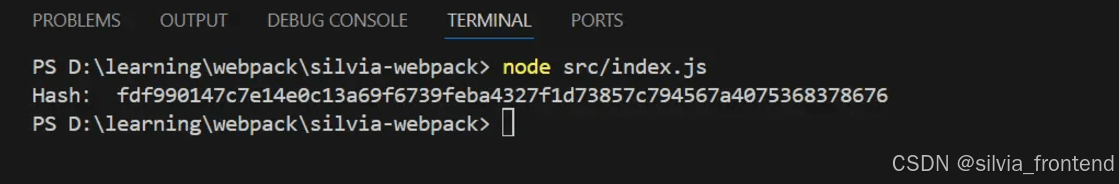
2、计算Content Hash(基于文本内容整体的哈希)
首先准备一个txt文件,然后通过fs读取文件内容。
text.txt: 这是一段测试的文本!!! 11111111111111111 222222222 3333333333 44444444
fs模块:Node.js提供的对系统文件及目录进行读写操作的模块。
fs.readFile(filename,[option],callback)方法读取文件。
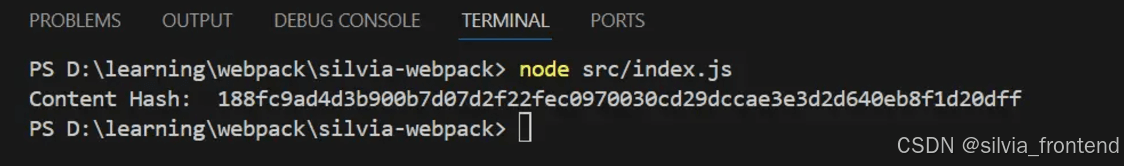
- 实现:加密方法还是和上面的一样,只不过是通过
fs获取的文件内容。可以看到,内容哈希关注的是文件内容本身的完整性。如果文件内容发生变化,内容哈希值也会随之改变。 - 场景:在内容分发网络(CDN)中判断资源是否更新等场景,只要内容没变化,内容哈希值就不会变。
const CryptoJS = require("crypto-js");
const fs = require("fs");
// Content Hash
fs.readFile("src/test.txt", "utf-8", (err, data) => {
    if (err) {
        console.error("Error reading file:", err);
        return;
    }
    const contentHash = CryptoJS.SHA256(data).toString();
    console.log("Content Hash: ", contentHash);
});
3、计算Chunk Hash(将内容分块后计算哈希)
和上面内容哈希的获取方式一样,只不过需要将获取到的文件划分成多个chunk,然后对每个chunk进行加密。
const CryptoJS = require("crypto-js");
const fs = require("fs");
// Chunk Hash
const CHUNK_SIZE = 10; // 每个块的大小(字节)
fs.readFile("src/test.txt", "utf-8", (err, data) => {
    if (err) {
        console.log("err", err);
        return;
    }
    const chunkHashes = []; // 块hash值数组
    for (let i = 0; i < data.length; i += CHUNK_SIZE) {
        const chunkContent = data.slice(i, i + CHUNK_SIZE);
        const chunkHash = CryptoJS.SHA256(chunkContent).toString();
        chunkHashes.push(chunkHash);
    }
    console.log("Chunk Hashes", chunkHashes);
});
slice()方法:是JavaScript中用于提取字符串或数组部分内容的方法。它返回一个新的字符串或数组,包含从原字符串或数组中提取的部分元素,原字符串或数组本身不会被修改。
语法:
string.slice(startIndex[, endIndex])。其中startIndex是提取的起始位置(索引从0开始),endIndex是提取的结束位置(不包括该位置的字符)。如果省略endIndex,则提取从startIndex到字符串末尾的部分。
改变txt文件中的后面一点内容,然后观察到前面的chunk的hash都没变,只有后面的两个hash改变了。
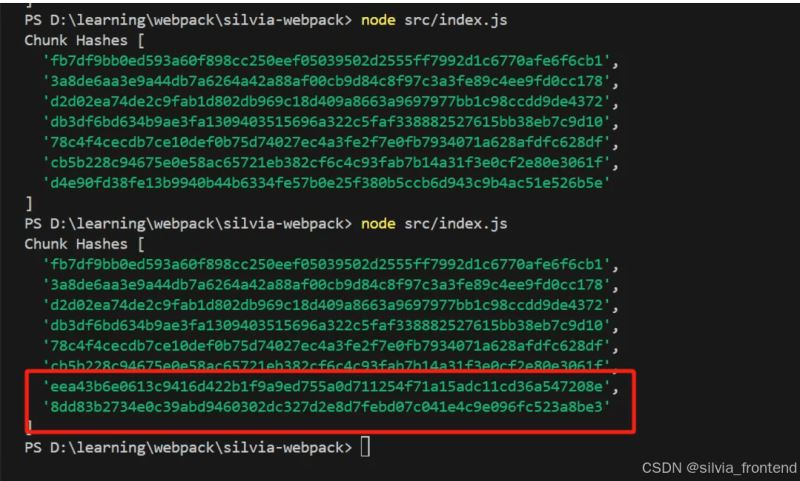
场景:这种块哈希的计算方式常用于大型文件传输等场景,在传输或存储过程中可以分别验证每个块的完整性,通过对比每个块的哈希值与原始的块哈希是否一致来判断块数据是否准确。
二、Webpack配置中这三种Hash的作用分析
1、Hash(模块标识符哈希)
在webpack中,hash是基于整个构建内容(包括所有模块、资源等)生成的一个哈希值,每次构建时,只要一个文件改变,这个哈希值就会改变。
module.exports = {
    //...其他配置
    output: { filename: '[name].[hash:8].js' }  //:8就是指定生成的hash值是8位的
};- 优点:简单直接,可以用于版本控制和缓存清除。当新的构建发生时,由于
hash值改变,浏览器会重新下载新的资源文件,保证用户获取到最新的内容。 - 缺点:比如即使一个css文件一个小改动,重新构建时哈希值都会改变,可能导致不必要的缓存失效,影响性能。
2、Content Hash(内容哈希)
在webpack中,content-hash是根据文件内容(具体模块或资源的内容)生成的哈希值。它只和文件自身的内容有关,与其他文件或构建过程中的其他因素无关。
module.exports = {
    //...其他配置
    output: { filename: '[name].[contenthash].js' }
};
优点:精确地基于内容进行哈希计算,使得只有内容发生变化的文件,其文件名才会改变。这对于缓存管理非常有利。缺点:计算成本相对较高,因为需要对每个文件内容进行单独的哈希计算。不过,在现代构建工具和硬件条件下,这个缺点通常可以接受。
3、Chunk Hash(块哈希)
在webpack中,chunk-hash是基于Webpack打包后的代码块(chunk)生成的哈希值。Webpack在打包过程中会将相关的模块组合成代码块,chunk-hash就是针对这些代码块进行计算的。
module.exports = {
    //...其他配置
    output: { filename: '[name].[chunkhash].js' }
};- 优点:可用于代码分割(
code-splitting)场景。如:一个Web应用有多个入口点(如main.js和vendor.js),通过chunk-hash可以为每个入口点对应的代码块生成独立的哈希值。这样,当一个代码块(如vendor.js包含第三方库)的内容没有变化时,其对应的文件名不会因为其他代码块(如main.js)的变化而改变,有利于浏览器缓存的有效利用。 - 缺点:如果代码块的划分发生变化(例如,调整了Webpack的代码分割策略),即使模块内容没有改变,
chunk-hash值也可能会改变,从而影响缓存。
这篇文章我们通过JS验证了一下Hash、Content Hash与Chunk Hash的区别,并对比了一下Webpack中的使用场景,希望对Webpack这里配置有疑惑的伙伴有帮助。
到此这篇关于使用JS验证Hash、Content Hash与Chunk Hash的区别的文章就介绍到这了,更多相关JS验证Hash、Content Hash与Chunk Hash内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!