
本文深入讲解在JavaScript中利用Set优化大数组交集计算性能的方法。从O(M*N)到O(M+N)的算法复杂度演进、小数组优先构建Set的内存优化策略、去重语义与对象键索引,提供完整的实战代码与避坑指南。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
怎么利用Set优化JS大数组交集计算性能
作者:霁月
时间:2026-11-22
浏览:616
文章目录
算法优化
核心机制:哈希分桶检索
时间复杂度:从 O(M×N) 到 O(M+N)
在 JavaScript 中计算两个大数组的交集时,若直接使用
arrA.filter(x => arrB.includes(x)),底层会陷入平方级的时间开销,一旦数据量达到数万或数十万级别便会造成明显的界面卡死。解决此问题的标准核心途径是利用 ES6 Set 内部基于哈希表实现的 $O(1)$ 查找能力,先将参照数组转换为 Set 实例,再配合 Set.prototype.has() 进行流式过滤,从而将总体时间复杂度直接降至线性的 $O(M + N)$。
一、朴素实现的性能瓶颈:为什么双重遍历会拖垮浏览器
日常开发中,许多开发者在处理包含数千项的列表时习惯写出如下两行代码来取交集:
// 朴素但极其耗时的全量比对方式
function naiveIntersection(arrA, arrB) {
  return arrA.filter(item => arrB.includes(item));
}
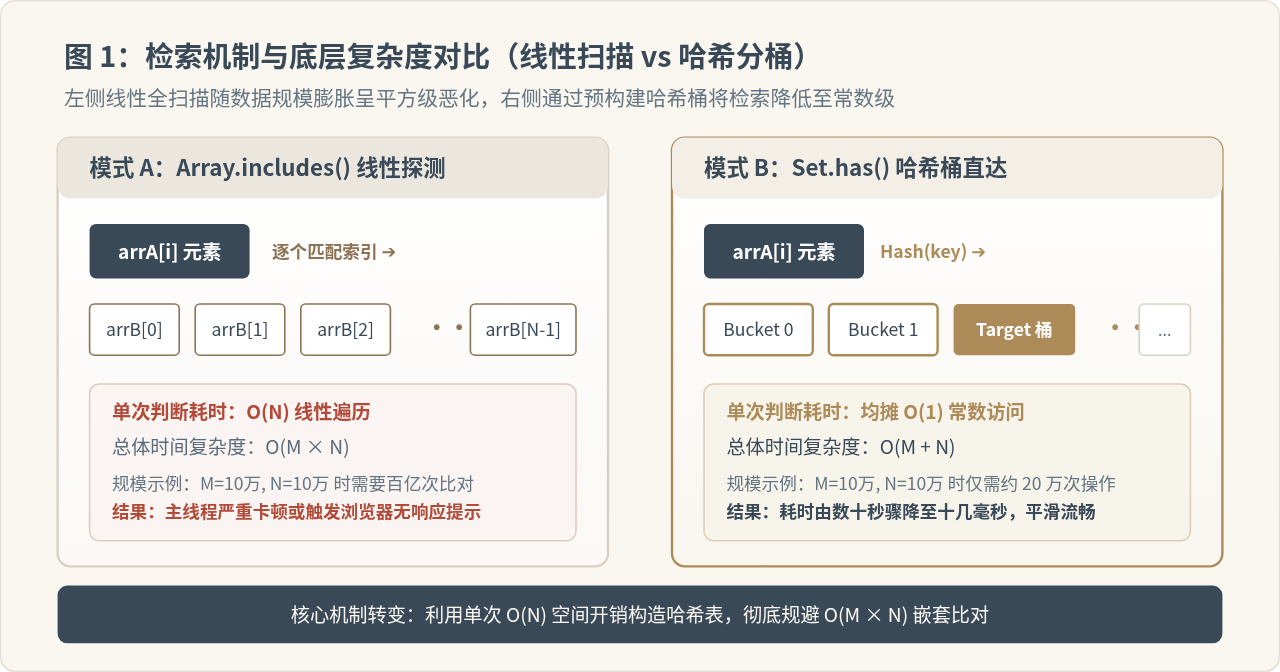
这种写法在小规模数据(如元素少于 1,000 个)时不易察觉延迟,但面对业务日志、批量用户 ID 或报表数据等大数组时,性能会迅速崩溃。其底层瓶颈根植于数据结构与算法复杂度:
- 全量线性扫描:
Array.prototype.includes在 V8 引擎底层是顺序遍历数组。在最坏和平均情况下,每在arrB中检索一次元素,都需要遍历 $N$ 次比较($N$ 为arrB.length)。 - 嵌套开销相乘:外层
filter遍历arrA共 $M$ 次,导致总比对次数达到 $M imes N$。 - 计算量爆炸:假设 $M = 100,000$ 且 $N = 100,000$,比对操作将高达 100 亿次。由于 JavaScript 在浏览器主线程以单线程事件循环执行,这会导致主线程完全被密集 CPU 运算霸占,页面失去响应,触发卡死提示。
二、利用 Set 优化交集的基础实现与核心细节
与平铺存储的普通数组不同,JavaScript 的 Set 集合底层基于哈希表(Hash Table)结构存储值。当调用 Set.prototype.has(val) 时,引擎通过哈希函数直接计算内存桶(Bucket)的位置,其平均检索时间复杂度为常数级 $O(1)$。
将其中一个数组转换为 Set 后,整体计算仅需两次线性过程:构造集合需要 $O(N)$,遍历外层数组需要 $O(M)$,因此整体时间复杂度骤降为 $O(M + N)$。以下为标准的通用实现:
// 基础 Set 优化版交集计算
function getIntersectionWithSet(arrA, arrB) {
  // 1. 先将基准数组转为 Set,构建哈希索引
  const setB = new Set(arrB);

  // 2. 使用 has() 实现 O(1) 瞬时判断
  return arrA.filter(item => setB.has(item));
}

// 示例验证
const listA = [1, 2, 3, 4, 5];
const listB = [3, 4, 5, 6, 7];
console.log(getIntersectionWithSet(listA, listB));
// 示例输出: [3, 4, 5]
注意细节:去重语义与值比对规则
在使用 filter + Set.has 时需要注意两个关键事实:
- 左侧重复项保留:若
arrA本身包含重复元素(例如[2, 2, 3]与[2]),单纯的filter会返回[2, 2]。若业务要求符合数学集合意义上的唯一交集,需在外部对arrA或结果二次去重。 - 比较算法:
Set内部使用SameValueZero比较机制。与严格相等(===)相比,它认为NaN等于NaN,+0等于-0,这有效避免了原生indexOf无法识别NaN的历史缺陷。
三、面向百万级规模的 4 步执行管线与内存自适应优化
当数组规模达到数十万甚至百万时,除了 CPU 时间,内存占用与垃圾回收(GC)频率同样是关键制约因素。如果 arrA 有 100 万项,而 arrB 仅有 200 项,将 arrA 转换成 Set 会在堆内存中开辟巨大的哈希结构,触发长时间的垃圾回收停顿;反之,将 arrB 构建为 Set 仅需极小的内存代价。
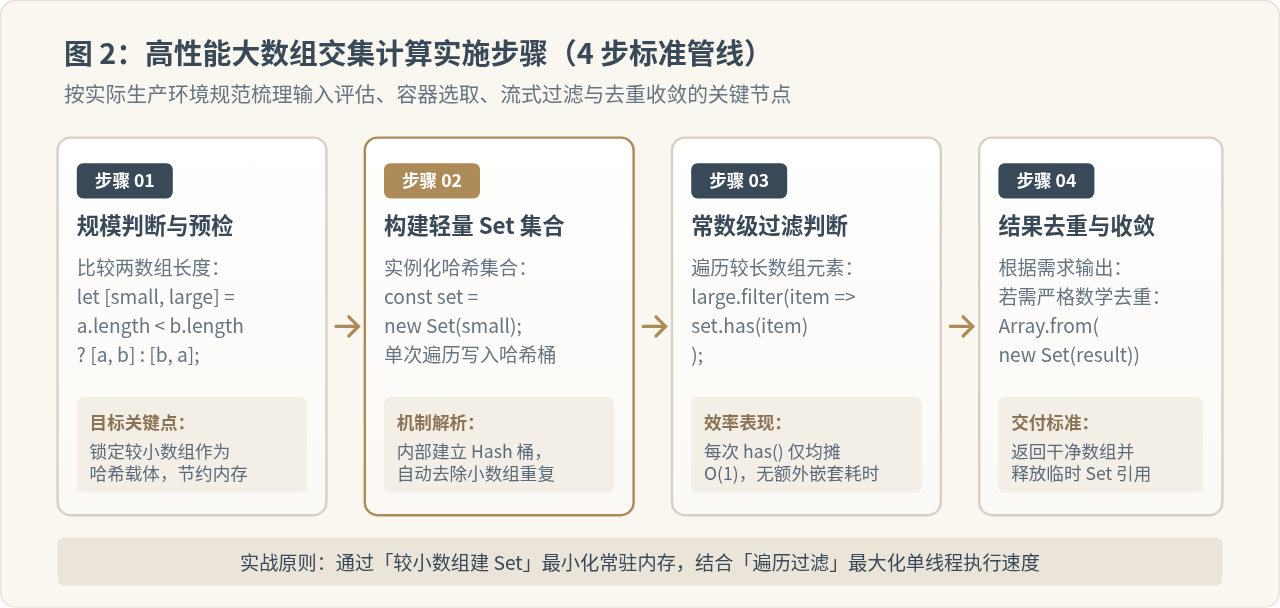
根据这一内存考量,生产级别的健壮交集函数应当遵循以下 4 步管线执行:
步骤 1:规模判定与轻量化选型
在开始计算前,先判断两个数组的长度。始终挑选长度较短的数组作为 Set 的载体,以确保分配的哈希存储空间最小化:
const [smaller, larger] = arrA.length < arrB.length ? [arrA, arrB] : [arrB, arrA];步骤 2:对较小数组执行哈希集合构建
将较小的数组实例化为 Set。此步骤的时间复杂度为 $O(\min(M, N))$,空间复杂度仅为 $O(\min(M, N))$:
const smallSet = new Set(smaller);步骤 3:遍历较大数组或过滤去重
在较长数组中执行常数级匹配。为了保证最终结果严格去重且不创建额外冗余数组,可以使用 Set 容器收集匹配项:
// 生产环境自适应高性能交集函数
function optimizedIntersection(arrA, arrB) {
  if (!arrA || !arrB || arrA.length === 0 || arrB.length === 0) {
    return [];
  }

  // 步骤 1:自适应确定较小和较大数组
  const [smaller, larger] = arrA.length < arrB.length ? [arrA, arrB] : [arrB, arrA];

  // 步骤 2:将较小数组建立为 Set,最小化堆内存
  const smallSet = new Set(smaller);
  const resultSet = new Set();

  // 步骤 3:遍历较大数组,匹配项放入 resultSet 自动完成结果去重
  for (let i = 0; i < larger.length; i++) {
    const item = larger[i];
    if (smallSet.has(item)) {
      resultSet.add(item);
    }
  }

  // 步骤 4:收敛为目标原生数组输出
  return Array.from(resultSet);
}
步骤 4:收敛输出与垃圾回收准备
通过 Array.from(resultSet) 将结果收敛为普通数组供外部逻辑调用。函数作用域结束后,局部变量 smallSet 和 resultSet 的引用随之释放,V8 引擎可以在微任务周期内迅速清理临时内存,有效避免内存泄漏与内存抖动。
四、业务场景策略选择:对象数组与现代原生 API
在工程实战中,交集需求并非总是面对基础数值,往往伴随着复杂对象以及不同的 ECMAScript 运行版本。此时需要根据场景合理选型:
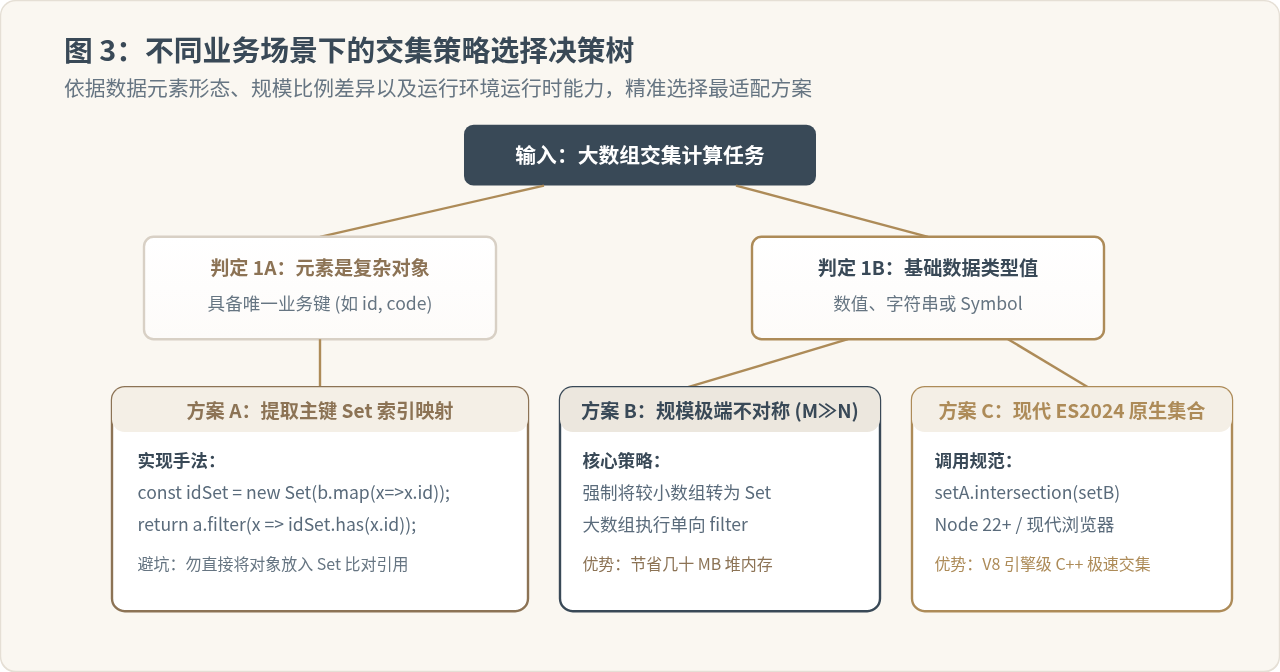
1. 复杂对象数组交集:按唯一主键构建索引
在 JavaScript 中,对象的相等性是按引用内存地址判定的,即使两个对象内容完全一样(如 {id: 1} !== {id: 1}),Set.has() 也会返回 false。处理对象数组时,应提取其业务主键(例如 id 或 uuid):
function objectIntersectionById(usersA, usersB) {
  // 提取 usersB 的 id 集合
  const bIdSet = new Set(usersB.map(u => u.id));

  // 基于 ID 进行 O(1) 过滤,返回保留完整对象引用的交集
  return usersA.filter(u => bIdSet.has(u.id));
}
2. ECMAScript 2024 原生集合操作:Set.prototype.intersection()
在最新的 ECMAScript 规范中,官方正式引入了原生集合操作方法。在 Node.js 22+、Chrome 122+ 及 Safari 17+ 等现代环境中,可以直接使用内置的 C++ 引擎级实现:
// 现代浏览器与 Node.js 22+ 原生交集支持
const setA = new Set(arrA);
const setB = new Set(arrB);

// 直接调用引擎内置交集计算
const commonSet = setA.intersection(setB);
const result = Array.from(commonSet);
原生 intersection 方法在底层的 C++ 层面针对迭代器进行了汇编级内联优化,但如果运行在旧版 Node.js 或低版本移动端 WebView 中,依然推荐使用基于 has() 的降级兼容方案。
五、技术方案全维度对比与关键避坑清单
为了帮助读者根据实际项目指标做出清晰选择,下表对主流交集计算方案的指标进行了多维横向梳理:
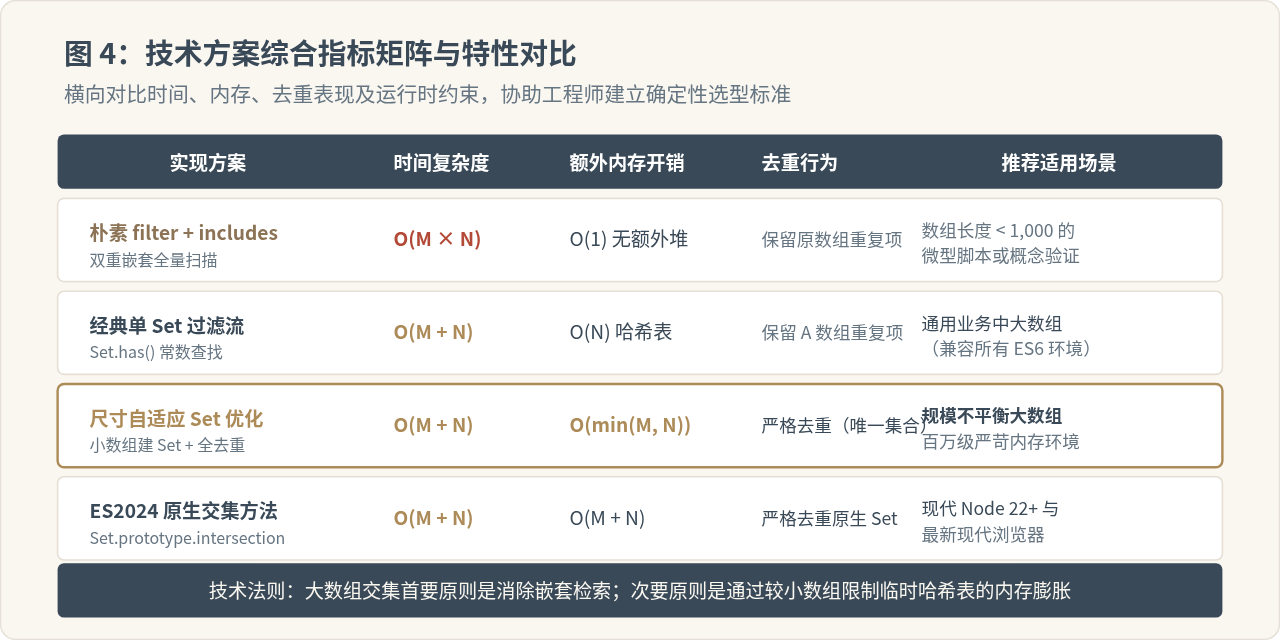
| 方案类型 | 时间复杂度 | 额外内存开销 | 去重语义 | 适用典型场景 |
|---|---|---|---|---|
| 朴素嵌套 includes | $O(M imes N)$ | $O(1)$ 无额外堆 | 保留原数组重复项 | 元素总数均小于 1,000 的轻量级脚本 |
| 经典单 Set 过滤流 | $O(M + N)$ | $O(N)$ 哈希表 | 保留 A 数组重复项 | 通用业务场景,保留左侧数组重复频率 |
| 尺寸自适应双 Set | $O(M + N)$ | $O(\min(M, N))$ | 严格数学唯一集合 | 百万级数据量,规模严重不对称场景 |
| ES2024 原生集合方法 | $O(M + N)$ | $O(M + N)$ | 严格数学唯一集合 | 现代运行时(Node 22+ / 现代浏览器) |
常见陷阱与排查要点
- 避免在循环内部重复创建 Set:切勿把
new Set(arrB)放在filter回调函数内部。如果在每次迭代都重新构建哈希表,不仅无法加速,还会因产生 $M$ 次内存分配使整体性能劣于朴素方案。 - 谨慎处理海量稀疏数组与内存阈值:若数组规模达到千万级别(超过 V8 单个堆上限限制,通常为 1.4GB-4GB),直接在单线程堆中构造庞大
Set可能触发JavaScript heap out of memory崩溃。此极端场景需配合 TypedArray、分块迭代(Chunking)或 Web Worker 异步处理。 - 保留重复项的场景适配:如果业务明确要求计算“多重集交集”(Multiset Intersection,即
[1, 1, 2]与[1, 2]取交集需输出[1, 2]),单纯依靠Set会丢失频次信息,此时应采用Map<item, count>记录各元素频次后递减消耗。
六、总结
优化 JavaScript 大数组交集计算的核心逻辑可以提炼为两句话:“哈希换时间,以小定容器”。通过引入 Set 结构,我们成功将时间消耗从平方阶的泥潭中抽离,实现了可预测的毫秒级线性运算;通过对比数组规模并将较小者载入哈希,进一步守住了大体量数据计算下的内存底线。在日常工程中,结合业务对去重、对象引用的具体要求选用适宜的管线结构,即可彻底消除大数组交集带来的性能顽疾。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章