
详细讲解在Node.js中使用cheerio高效解析HTML的方法,涵盖基础用法、选择器作用域收敛、片段与XML模式配置、内存释放策略以及常见排查边界。

当前位置:首页 > Node.js 基础 > 正文
Node.js中怎么使用cheerio高效解析HTML
作者:慢半拍
时间:2026-11-22
浏览:433
文章目录
Node.js HTML 解析实践
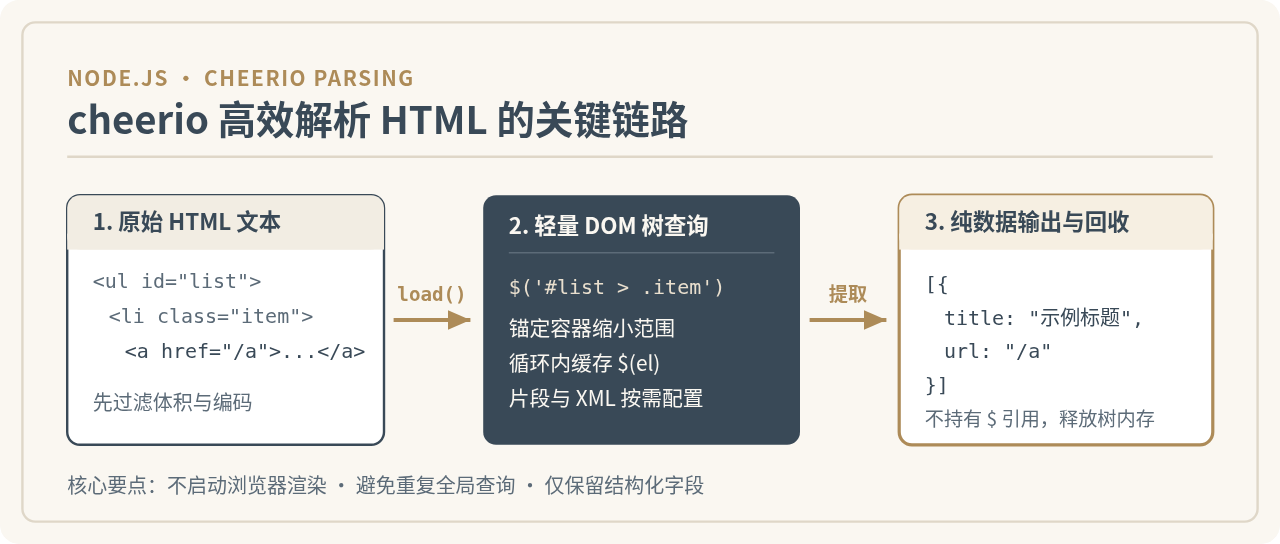
图 0:Node.js 中使用 cheerio 解析 HTML 并产出纯数据对象的整体路径
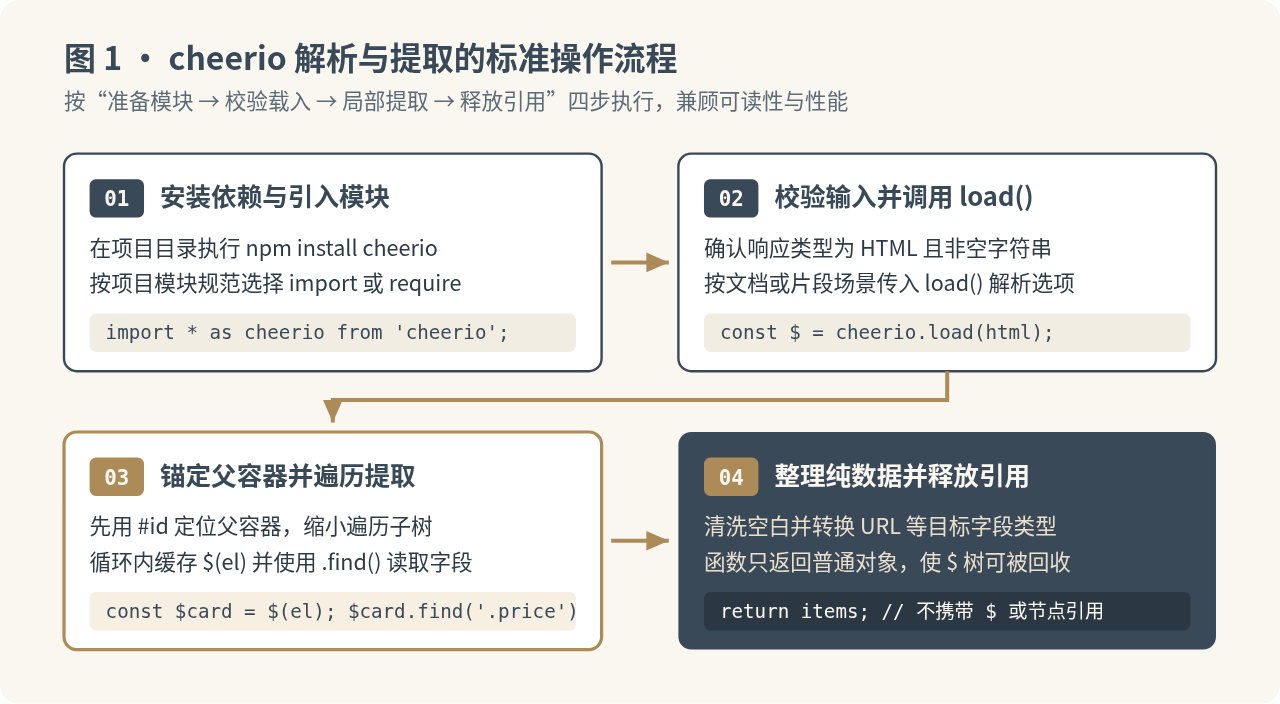
图 1:从初始化安装到释放内存引用的四步标准解析流程
1. 先锚定容器,再局部
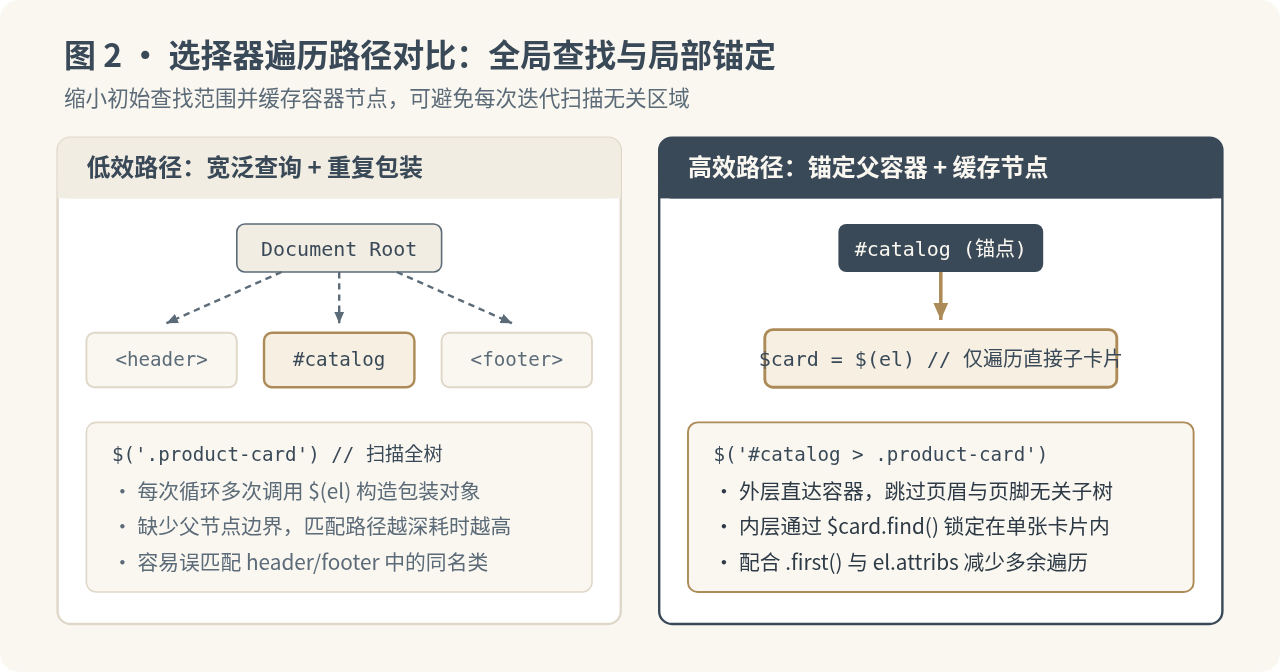
图 2:从全局重复遍历收敛为“容器锚点 + 缓存局部包装对象”的策略对比
2. 解析 XML、RSS 或 SVG 时开启
1. 只保留提取结果,不持有
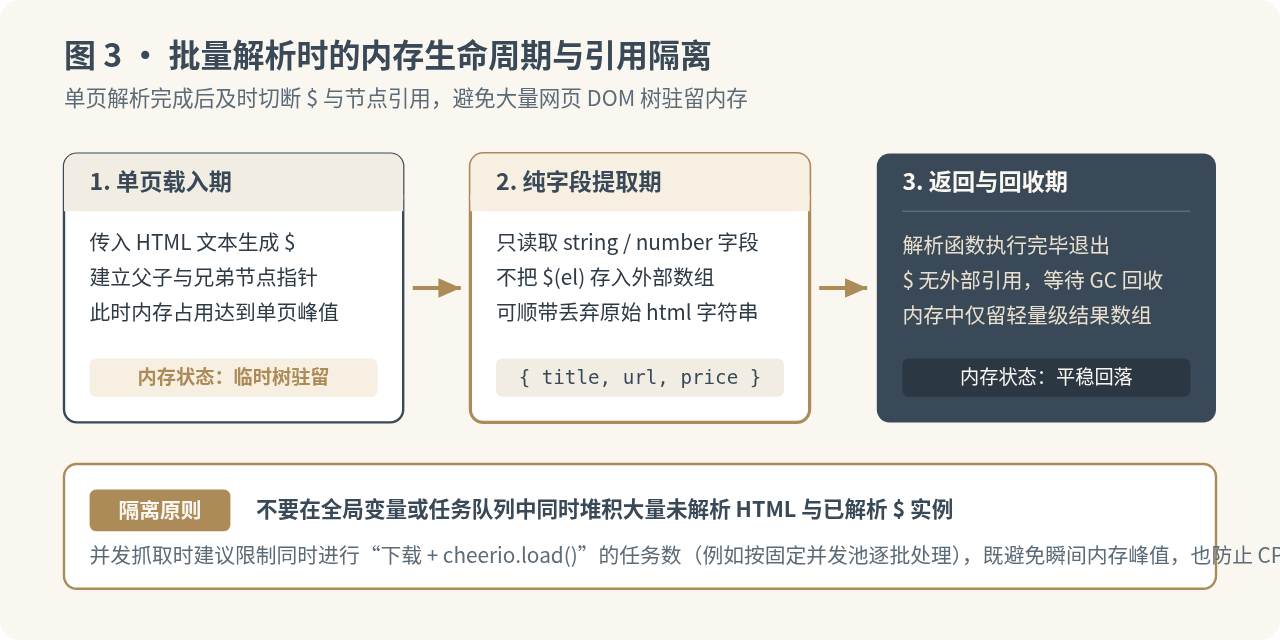
图 3:将 cheerio.load() 隔离在局部函数内以实现及时的内存回收
1. 浏览器里能看到元素,
2.
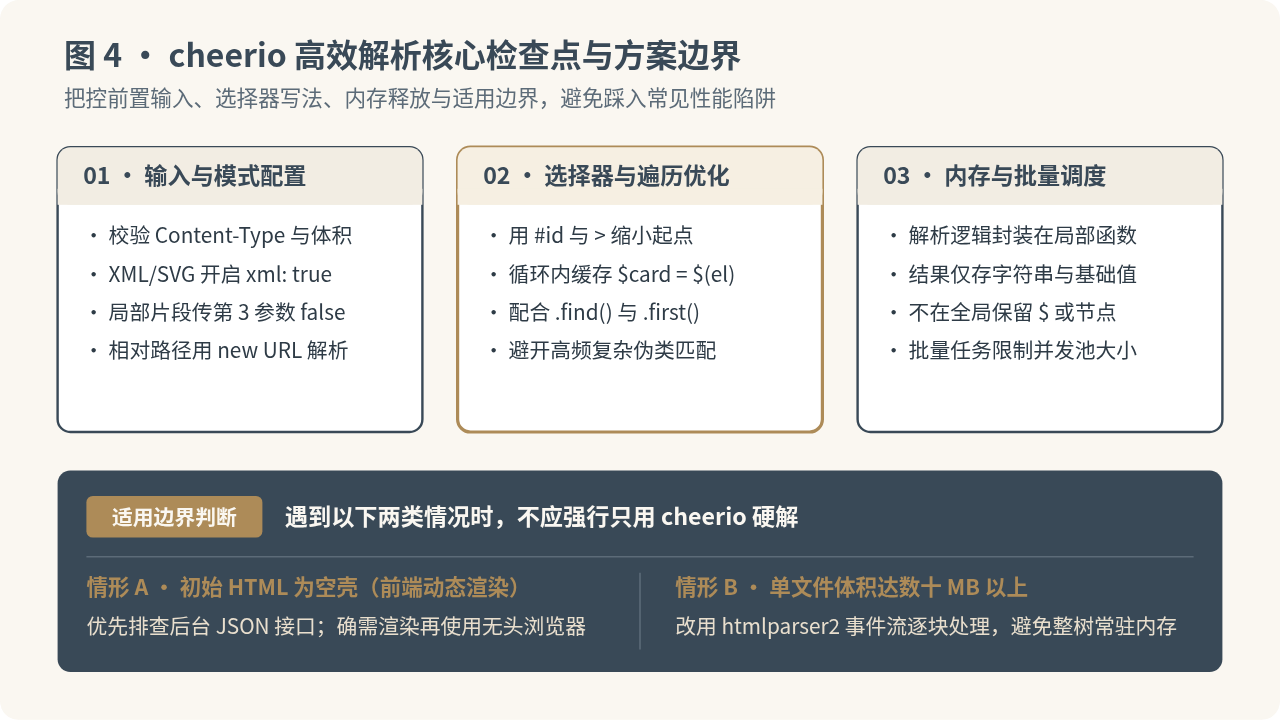
图 4:cheerio 解析的三个核心优化维度与两类替代边界
在 Node.js 中,cheerio 直接将 HTML 字符串解析为内存中的轻量节点树,并提供类似 jQuery 的选择器接口来读取文本、属性和结构。它不启动浏览器渲染引擎,也不执行页面里的 JavaScript,因此单页解析速度快、资源消耗低。要想在真实业务里把 cheerio 用得更高效,关键不在于堆砌复杂选择器,而在于控制输入文本体积、缩小选择器查找范围、按场景配置解析选项,并在提取完字段后及时释放整棵解析树。
一、准备环境并跑通基础解析
cheerio 适合处理已经拿到手的静态 HTML 字符串(例如本地模板文件、接口返回的 HTML 片段,或通过 fetch、axios 等 HTTP 客户端拉取的网页源码)。在项目目录中初始化并安装依赖即可开始使用。
1. 安装与导入方式
在项目根目录下打开终端,执行安装命令:
npm init -y
npm install cheerio
安装完成后,可以在 package.json 中确认已安装的版本。根据项目模块规范,导入方式分两种:
- ES Module(在
package.json中设置了"type": "module",或使用.mjs后缀):使用命名空间导入import * as cheerio from 'cheerio';。 - CommonJS(默认
.js或.cjs):使用const cheerio = require('cheerio');。
2. 基础解析与字段提取示例
调用 cheerio.load(html) 后会返回一个查询函数,通常命名为 $。下面的 parse-demo.mjs 演示了如何从一段商品列表 HTML 中提取名称、链接和价格,并将结果整理为普通数组。
import * as cheerio from 'cheerio';

// 示例 HTML 字符串,实际使用时通常来自文件读取或 HTTP 响应正文
const sampleHtml = `
<!DOCTYPE html>
<html lang="zh-CN">
<body>
  <section id="catalog">
    <article class="product-card" data-sku="A101">
      <h3 class="title"><a href="/items/a101">机械键盘 87 键</a></h3>
      <span class="price">299</span>
    </article>
    <article class="product-card" data-sku="A102">
      <h3 class="title"><a href="/items/a102">人体工学鼠标</a></h3>
      <span class="price">189</span>
    </article>
  </section>
</body>
</html>
`;

function extractProducts(html, baseUrl) {
  const $ = cheerio.load(html);
  const items = [];

  $('#catalog > .product-card').each((_, element) => {
    const $card = $(element);
    const $link = $card.find('.title > a').first();
    const rawHref = $link.attr('href') || '';

    items.push({
      sku: $card.attr('data-sku') || '',
      title: $link.text().trim(),
      url: rawHref ? new URL(rawHref, baseUrl).href : '',
      price: Number($card.find('.price').first().text().trim())
    });
  });

  return items;
}

const result = extractProducts(sampleHtml, 'https://example.com');
console.log(result);
示例输出(运行
node parse-demo.mjs 的预期输出格式)
[
  {
    sku: 'A101',
    title: '机械键盘 87 键',
    url: 'https://example.com/items/a101',
    price: 299
  },
  {
    sku: 'A102',
    title: '人体工学鼠标',
    url: 'https://example.com/items/a102',
    price: 189
  }
]
注意上面代码中的两个细节:第一,链接地址往往是相对路径(例如 /items/a101),直接配合标准 new URL(rawHref, baseUrl).href 即可转为完整地址,不需要自己写字符串拼接;第二,extractProducts 只返回包含字符串和数字的普通对象数组,没有把 $ 或 $card 带出函数。
二、缩小选择器范围,减少无效遍历
当一个页面里包含上千个 DOM 节点时,耗时往往不是花在一次 cheerio.load(),而是花在循环里反复执行宽泛的全局选择器查询。每调用一次 $('.item .title'),选择器引擎都要从文档根节点出发做大量匹配和上下文回溯。
1. 先锚定容器,再局部 .find()
对比以下两种常见写法,就能看出遍历范围的差异:
// 写法 A(低效):每次从整棵文档树出发,且重复包装 $(el)
const listA = [];
$('.product-card').each((_, el) => {
  listA.push({
    title: $(el).find('div > h3.title a').text().trim(),
    price: $(el).find('span.price').text().trim(),
    sku: $(el).attr('data-sku')
  });
});

// 写法 B(高效):先用 ID 与直接子元素缩小起点,再缓存局部节点
const listB = [];
const $cards = $('#catalog > .product-card');
$cards.each((_, el) => {
  const $card = $(el);
  const $link = $card.find('.title > a').first();
  listB.push({
    title: $link.text().trim(),
    price: $card.find('.price').first().text().trim(),
    sku: el.attribs['data-sku'] || ''
  });
});
写法 B 之所以更快、更稳定,原因有三点:
- 收敛起点:
#catalog > .product-card利用了页面中具有唯一性的#catalog作为入口,直接跳过页眉、侧边栏和页脚,再用直接子选择器>避免向更深层级无效下探。 - 缓存节点包装:在单次迭代中把
$(el)存到局部变量$card,避免对同一个底层节点多次构造 cheerio 包装对象。 - 直接读取原生属性或限定
.first():若只需判断元素自身属性,底层 DOM 节点的el.attribs['data-sku']比再经过一层方法调用更直接;查找唯一子元素时加上.first(),也能避免语义误读,防止后续多出同名节点时文本被拼在一起。
2. 避免在高频路径中使用复杂伪类
cheerio 底层使用的 CSS 选择器引擎支持如 :contains(...)、:has(...) 等扩展伪类,但它们往往需要先选出候选集再逐个检查子节点或文本内容,计算成本明显高于 #id、.class 和 >。
如果确实需要根据文本关键字筛选元素,更好的做法是先用普通类选择器把候选节点集缩小到几十个以内,再在 JavaScript 中用 .filter((_, el) => $(el).text().includes('目标词')) 完成判断,逻辑更清晰,也更容易控制性能开销。
三、合理配置解析选项与片段模式
cheerio.load() 不仅接收 HTML 字符串,还支持配置对象和第三参数来控制解析模式。在解析非完整网页或 XML 数据时,正确传入参数能减少无谓的树修复工作,也能避免标签被意外吞掉。
1. 解析 HTML 片段时关闭文档包裹
默认情况下,cheerio.load(html) 按完整 HTML 文档模式解析,会自动补全缺失的 <html>、<head> 和 <body> 标签。如果你的输入只是接口返回的一段局部列表(例如几十个 <li> 或几行 <tr>),可以把第三个参数 isDocument 设为 false:
import * as cheerio from 'cheerio';

const fragment = '<li class="row">条目一</li><li class="row">条目二</li>';

// 第三个参数设为 false:作为 HTML 片段解析,不自动包裹 html/head/body
const $ = cheerio.load(fragment, null, false);

const texts = $('li.row').map((_, el) => $(el).text().trim()).get();
console.log(texts);
提醒:遇到独立的
<tr>...</tr> 或 <td>...</td> 表格行片段时,HTML 解析规范会丢弃不在 <table> 上下文中的表格标签。如果解析结果为空,可以在解析前人为包一层 <table><tbody>...</tbody></table>,再按常规选择器提取。
2. 解析 XML、RSS 或 SVG 时开启 xml: true
当解析目标是 RSS 订阅源、Sitemap(<urlset>)或 SVG 文件时,标签名和属性大小写敏感,而且常出现自闭合标签(如 <link /> 或带命名空间的标签)。默认 HTML 模式会把标签名全部转为小写,并按 HTML5 规则修正闭合方式,容易导致取值异常。
const rssXml = `
<rss version="2.0">
  <channel>
    <item>
      <title>更新日志</title>
      <pubDate>2026-11-12</pubDate>
    </item>
  </channel>
</rss>
`;

const $xml = cheerio.load(rssXml, { xml: true });
const pubDate = $xml('item > pubDate').first().text().trim();
console.log(pubDate); // 输出: 2026-11-12
3. 常见解析配置对照
| 场景 | 推荐调用方式 | 主要作用 |
|---|---|---|
| 标准网页 HTML | cheerio.load(html) |
按 HTML 规范容错解析,适合绝大多数网页源码 |
| 局部 HTML 片段 | cheerio.load(fragment, null, false) |
跳过补全 <html>、<body> 外壳,结构更贴合原始片段 |
| XML / RSS / Sitemap | cheerio.load(xml, { xml: true }) |
保留标签大小写与自闭合语义,避免 HTML5 容错改写结构 |
| 需解析相对链接 | 结合 new URL(href, baseUrl) |
把提取出的相对路径稳定规范化为绝对地址 |
四、控制内存占用与批量解析策略
单个页面用 cheerio 解析通常只需要几毫秒,但如果在脚本里连续处理几百上千个页面,内存占用很容易成为瓶颈。真正影响内存稳定性的,往往不是解析本身,而是数据流转方式和并发控制。
1. 只保留提取结果,不持有 $ 或节点对象
cheerio 生成的每个节点对象都带有指向父节点、兄弟节点和子节点的双向指针。只要你把某一个 $(el) 或原始 DOM 节点存进了外层缓存数组,整棵页面的 DOM 树就可能因为引用链不断而无法被垃圾回收。
正确做法是将单页的加载与提取封装在一个独立函数内:在函数内部完成 cheerio.load() 和字段清洗,只向外返回字符串、数字、布尔值组成的纯 JSON 对象。
2. 解析前先做轻量检查,过滤无效输入
在把网络响应或文件交给 cheerio.load() 之前,增加两步轻量前置检查往往比优化选择器更有效:
- 检查响应类型:确认 HTTP 响应头的
Content-Type包含text/html或application/xhtml+xml(解析 XML 时对应xml类型),避免把误返回的二进制文件或几十兆的 JSON 当作 HTML 解析。 - 限制单页文本上限与并发度:如果脚本批量处理外部页面,先对明显异常的超大响应设一个保护上限(例如超过数 MB 时记录日志跳过或转交专门处理),并控制同时处于解析状态的任务数量,防止并发过高把 Node.js 进程内存顶满。
五、常见问题排查与适用边界
使用 cheerio 时遇到报错或取不到值,多数和解析原理或 HTML 结构本身有关。下面列出几类最常见的问题与对应处理方法。
1. 浏览器里能看到元素,cheerio 却选不到
最常见的原因不是选择器写错了,而是页面内容由前端 JavaScript 动态渲染。cheerio 只处理拿到的静态 HTML 文本,如果服务端最初返回的只是一个空的 <div id="app"></div>,选择器结果自然为空。
排查方式很简单:把传给 cheerio.load(html) 的原始 html 字符串打印或保存到本地文本文件查看。如果里面没有目标数据,先确认页面是否通过独立 JSON 接口加载数据(直接请求该接口往往比解析 HTML 更高效);若必须等前端脚本执行完才生成节点,则需要改用 Playwright 或 Puppeteer 等无头浏览器获取渲染后的 HTML。
2. .text() 提取结果夹杂换行或子元素文本
调用 $el.text() 会递归拼接该元素及其所有后代元素的文本。如果标题标签内部还嵌套了角标或标签(例如 <h3>商品名称 <span class="tag">新品</span></h3>),直接取 .text() 会把“新品”也拼进来,或者带入大量缩进空白。
处理方法分两种情况:若目标文本在更内层的固定标签里,直接定位到最内层(如 $card.find('.title > a'));若角标和主文本是兄弟节点,可以先用 $el.clone() 复制一份再 .find('.tag').remove(),或者遍历 el.children 只读取 type === 'text' 的直接文本节点,最后用 .replace(/\s+/g, ' ').trim() 折叠多余空白。
3. 需要解析几十 MB 以上超大文件时的边界
cheerio.load() 会一次性在内存中建立完整的 DOM 树。如果目标是一个体积达到数十 MB 甚至更大的单文件(例如全站导出 XML 或超长报表 HTML),整棵加载会带来显著的内存与 CPU 压力。这种场景下更适合直接使用事件驱动的流式解析器(如 cheerio 底层所依赖的 htmlparser2 提供的 WritableStream / Parser),边读取文件流边匹配目标标签并立即丢弃已读部分。
把上面几个环节落到实际代码里并不复杂:先确认拿到的 HTML 是否包含目标数据并控制输入规模,再按“外层锚点 + 缓存局部节点 + 精确配置选项”的方式完成提取,最后只留下纯数据对象退出解析函数。这样写出来的解析脚本既好维护,也能在批量处理场景下保持稳定的速度与内存表现。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章