
深入排查JavaScript时间排序结果混乱异常的原因:解析默认字典序弊端、NaN与Invalid Date破坏TimSort弱序传递性,以及不同字符串格式隐式时区解析偏差,并提供工业级稳健解决方案与排查流程。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS时间排序结果异常怎么办?时区与Invalid Date排查
作者:青柠
时间:2026-11-22
浏览:344
文章目录
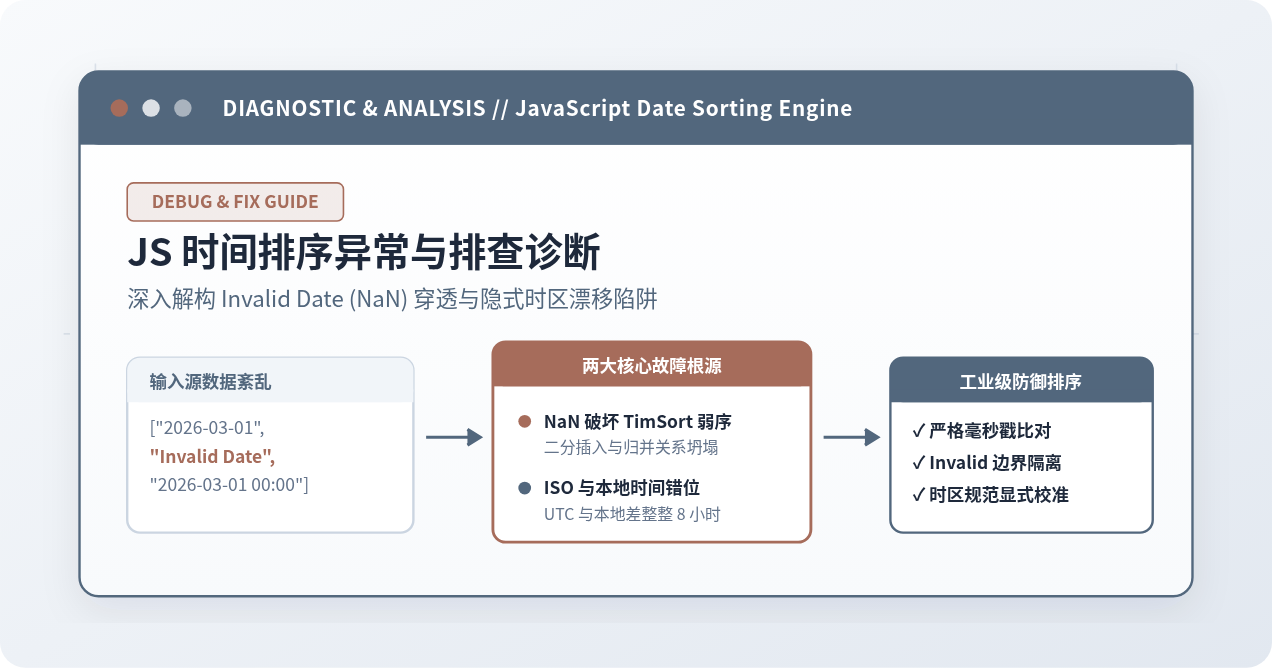
在 JavaScript 中对包含时间的数组执行排序时,如果你遇到“明明按先后排了序,结果却前后颠倒”、“部分数据排在完全匪夷所思的位置”,或者“只要列表里混入一条异常数据,整张表的排序直接崩塌”,这并非 JavaScript 引擎的底层 Bug,而是典型的三类实现陷阱:.sort() 默认字典序导致的时间倒流、Invalid Date 生成的 NaN 击穿排序算法(TimSort)的弱序传递性,以及不同字符串格式解析时隐式时区漂移(UTC 与本地时间错位)。解决该问题的核心路径是:建立显式的时间戳转换、隔离并安全兜底非法日期(使其返回确定性的边界值而非 NaN)、以及明确日期格式的时区归属。
一、故障初现:默认字典序与非安全比较器
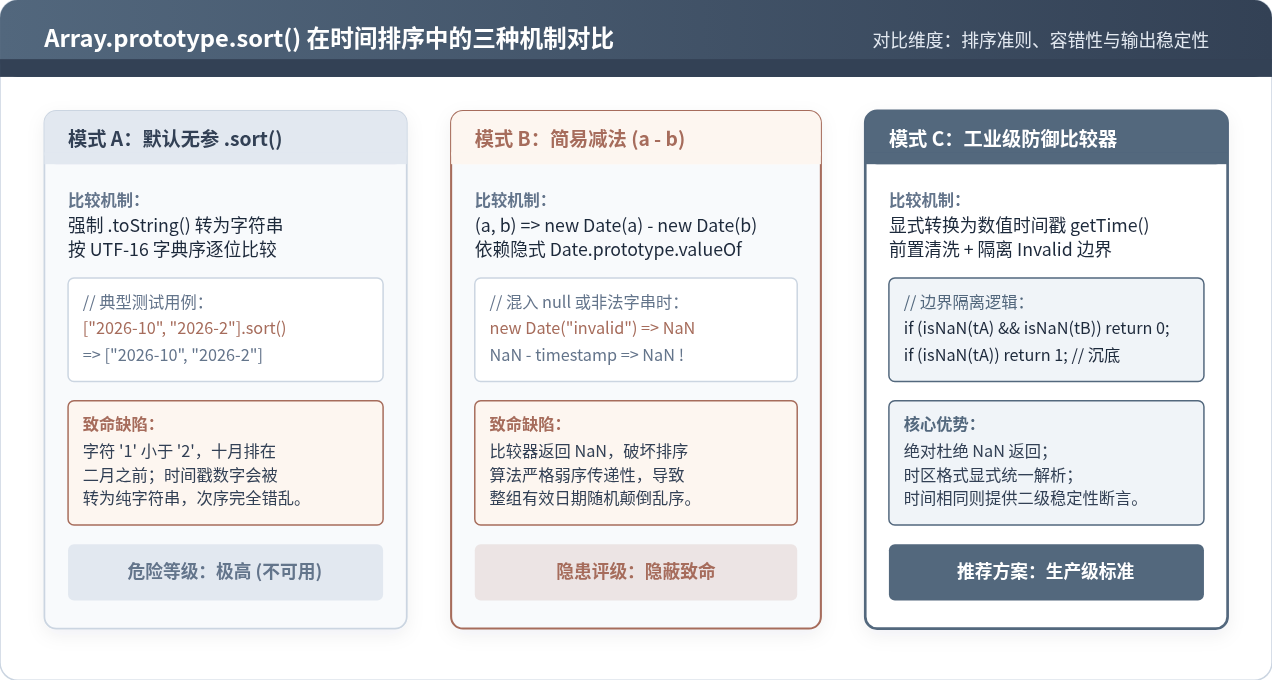
很多初学者甚至有一定经验的开发者,在对日期数组进行排序时会习惯性地直接调用无参的 array.sort()。在 JavaScript 标准中,如果不向 Array.prototype.sort() 传递自定义比较函数,引擎会将数组中的每个元素强制调用 .toString() 转换成字符串,并按照 UTF-16 代码单元的字典序升序排列。
这种默认行为在处理时间字符串时极易引发“时间倒流”的错觉。例如对于包含月份的字符串列表 ['2026-10-01', '2026-2-01'],字典序对比的是首位字符:因为 '1' 小于 '2',字符串 '2026-10-01' 会被排在 '2026-2-01' 之前,导致原本靠后的十月份反而出现在二月份前面。类似地,如果数组包含的是纯数字毫秒时间戳,[1772323200000, 946684800000].sort() 同样会先转成字符串比较,导致逻辑彻底错乱。
// 字典序排序缺陷示例
const dates = ['2026-10-01', '2026-2-01', '2026-03-15'];
dates.sort();
console.log(dates);
// 输出示例:['2026-10-01', '2026-2-01', '2026-03-15'] (10月排在2月前)

// 毫秒时间戳的字典序对比
const timestamps = [1700000000000, 200000000000];
timestamps.sort();
console.log(timestamps);
// 输出示例:[1700000000000, 200000000000] (因为 '1' < '2',十位数字更大的反而排在前面)
为了纠正字典序问题,常见做法是传入比较函数 (a, b) => new Date(a) - new Date(b)。这在全量干净、格式完全一致的小型测试数据中似乎能够正确工作。然而,一旦进入生产环境,当遇到空值、格式破损或包含时区偏差的混合数据时,这种简单减法就会演变成系统级隐患。
二、致命杀手:Invalid Date 与 NaN 破坏弱序传递性
在排查线上故障时,一个最令人费解的现象是:明明只有一条数据的日期字段是破损的(如 null 或非法格式),为什么连其他几十条原本正常、毫无关联的日期排序也全部乱成了一团?
这背后的根源是 Invalid Date 所衍生的 NaN 彻底瓦解了现代 JS 引擎(如 V8、SpiderMonkey、JavaScriptCore)中排序算法的数学前提。
1. NaN 在算术减法中的传染性
当通过 new Date("broken-date") 解析非法日期字符串,或传入 null、undefined 时,生成的 Date 对象其内部时间戳为 NaN。在 JavaScript 中,任何涉及 NaN 的减法操作,其结果均为 NaN:
const badDate = new Date("2026-02-31"); // 非法日期或格式
const validDate = new Date("2026-03-01");

console.log(badDate.getTime()); // 输出示例:NaN
console.log(badDate - validDate); // 输出示例:NaN
console.log(validDate - badDate); // 输出示例:NaN
2. 严格弱序(Strict Weak Ordering)公理的崩塌
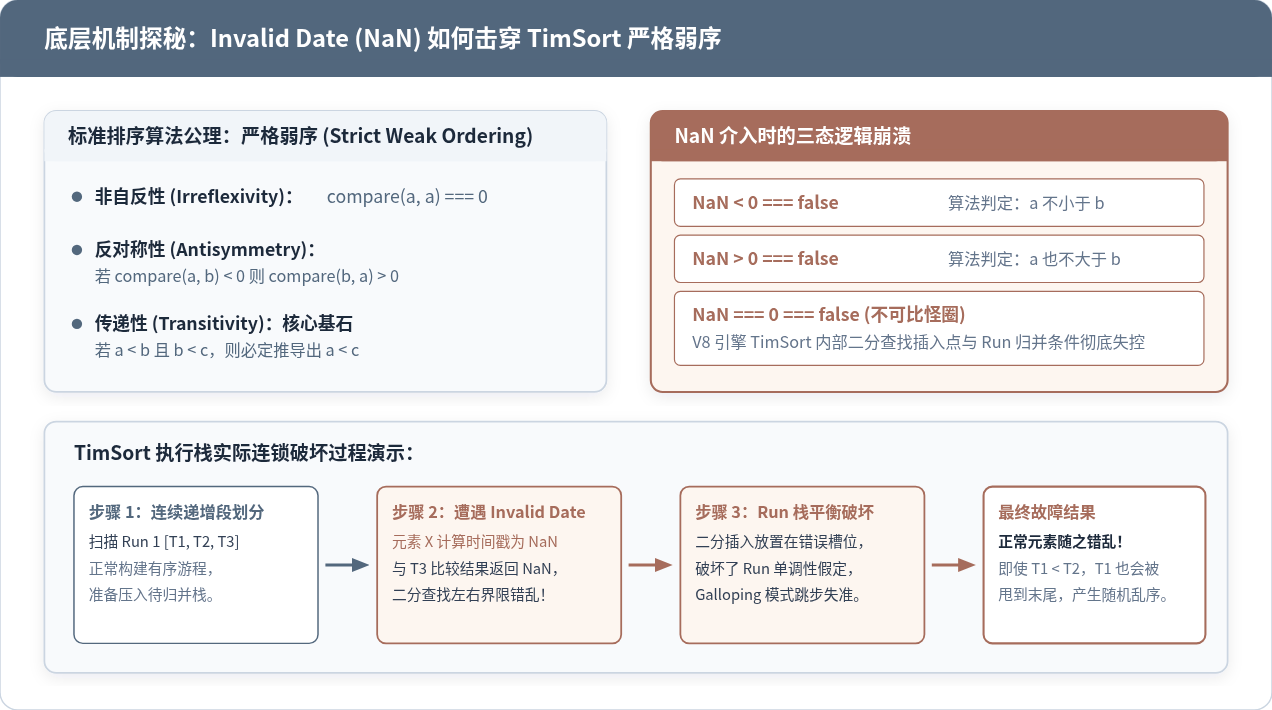
从 ECMAScript 规范到各大浏览器的具体实现(V8 引擎自 v7.0 起全面采用 TimSort 算法),排序算法能够正确运行的前提是:比较函数必须满足数学上的严格弱序。其包含三大核心公理:
- 非自反性:对于任意元素 a,比较自身时必须返回等价(0)。
- 反对称性:若
compare(a, b) < 0,则必须有compare(b, a) > 0。 - 传递性:若
compare(a, b) < 0且compare(b, c) < 0,则必然推导出compare(a, c) < 0。
然而,当比较器返回 NaN 时,在 IEEE 754 浮点数规范与 JS 逻辑中:
NaN < 0的求值结果是falseNaN > 0的求值结果也是falseNaN === 0的求值结果依然是false
这导致对于包含 NaN 的比较,算法既无法判定 a 在 b 前,也无法判定 a 在 b 后,更无法判定两者相等。TimSort 算法依赖二分查找来寻找插入位置,并依赖单调递增的 Run 游程进行高效归并。一旦遇到无法比较的 NaN,二分查找的上下边界指针计算失准,原本单调有序的游程被撕裂,甚至在后续的 Galloping 跳步合并阶段将已排序的正常数据移动到错误的分区中。
排查要点提醒
只要比较器函数中存在任何可能返回 NaN 的执行分支,整张数组的排序稳定性就完全无法保证。排查的第一步,就是通过断言检测比较函数是否输出过非数字或 NaN。
三、隐形陷阱:字符串解析与隐式时区漂移
除了报错与数据丢失外,另一种更隐蔽、更容易让人怀疑人生的异常是:所有日期格式看起来都完全合法,但排序结果却莫名其妙相差 8 个小时,导致跨天边界的数据前后倒置。
这种现象在混用不同接口返回的数据时尤为高发。例如:列表中的数据项 A 格式为 "2026-03-01",而数据项 B 格式为 "2026-03-01 00:00:00"。直观上看,两者都表示 2026 年 3 月 1 日的开端,但直接构造 Date 进行排序时,B 永远排在 A 前面整整 8 个小时!
// 在东八区(UTC+8,中国标准时间)环境下运行
const dateA = new Date("2026-03-01");
const dateB = new Date("2026-03-01 00:00:00");

console.log("A 毫秒时间戳:", dateA.getTime());
// 输出示例:1772323200000 (对应本地 08:00:00)

console.log("B 毫秒时间戳:", dateB.getTime());
// 输出示例:1772294400000 (对应本地 00:00:00)

console.log("时间差 (毫秒):", dateA - dateB);
// 输出示例:28800000 (正好相差 8 小时,即 8 * 3600 * 1000)
ECMA-262 规范中的时区解析断层
出现这种 8 小时断层的根本原因在于 ECMAScript 规范中对日期时间字符串格式的解析规则:
- 纯日期 ISO 格式(
YYYY-MM-DD):ECMA-262 规范明确规定,仅包含日期的 ISO 格式必须按照 UTC(世界协调时) 进行解释。因此"2026-03-01"被解释为2026-03-01T00:00:00.000Z。在东八区环境下,换算为本地时间就是当天上午 8 点整。 - 带时间的 ISO 格式(
YYYY-MM-DDTHH:mm:ss):如果末尾不带Z或偏移量,规范要求将其解析为本地时间(Local Time)。 - 非标准格式(如带空格的
YYYY-MM-DD HH:mm:ss或斜杠YYYY/MM/DD):不符合严格 ISO 8601 规范,现代浏览器引擎会回退到宿主环境的本地时间解释。因此"2026-03-01 00:00:00"被直接当成本地零点解析,换算为 UTC 实际上是前一天的 16:00:00。
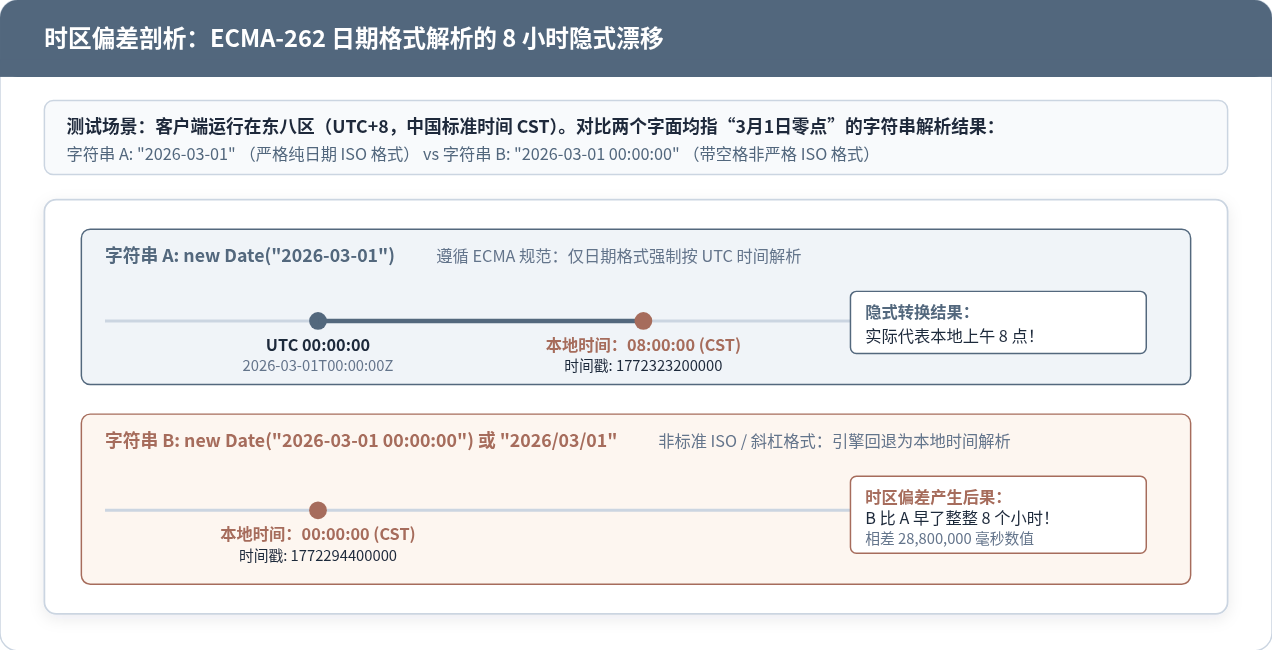
当数组中混杂了由后端不同微服务、或者数据库直接导出的不同格式日期字符串时,由于隐式时区解析基准的分裂,便会产生系统性的 8 小时(或对应本地时区偏移)乱序。排查此类问题时,不能仅肉眼观察字符串字面值,必须打印其毫秒时间戳 .getTime()。
四、四步系统排查与稳健修复方案
面对时间排序异常,建议按照“数据嗅探 → 格式归一 → 防御排序 → 单元断言”的标准化四个步骤进行工程化排查与修复。
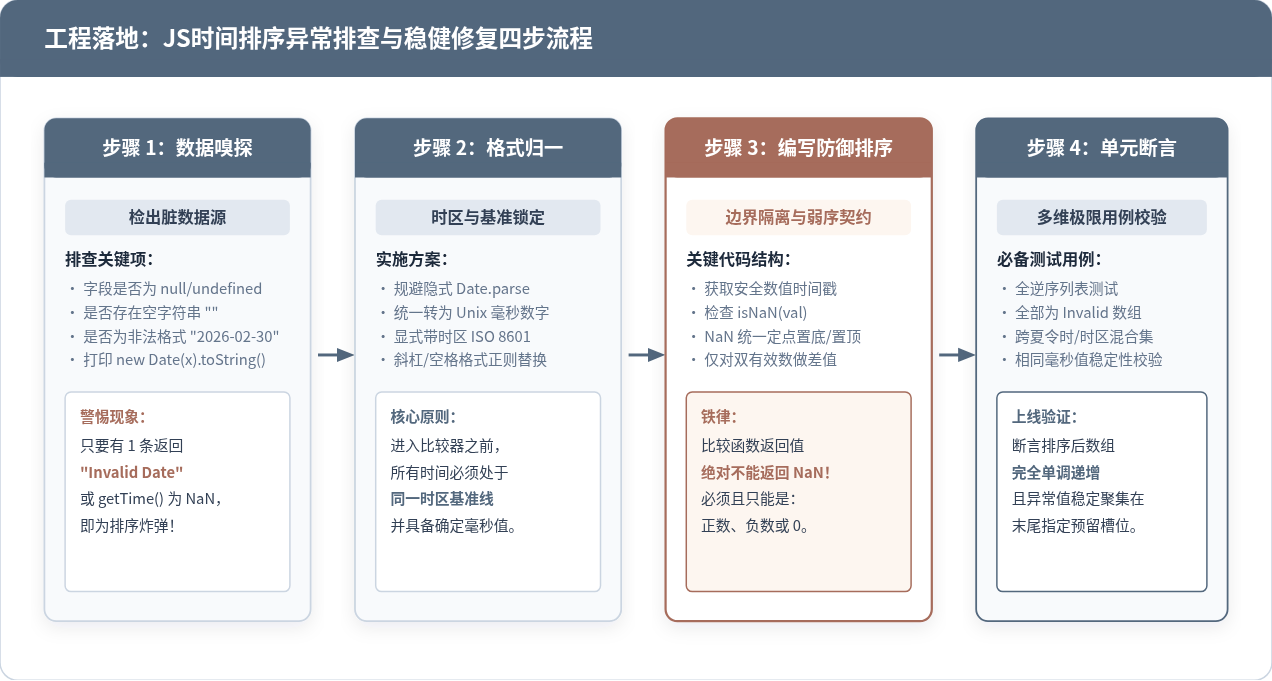
步骤一:数据源嗅探与脏数据检出
排查的第一步是脱离比较函数本身,单独遍历待排查数组,打印所有元素的解析结果。以下脚本可直接嵌入排查逻辑,定位是否存在引起崩溃的脏数据:
function inspectDateArray(items, keySelector = (x) => x) {
  console.group("=== 开始执行时间数据源体检 ===");
  items.forEach((item, index) => {
    const rawVal = keySelector(item);
    if (rawVal === null || rawVal === undefined || rawVal === "") {
      console.warn(`[索引 ${index}] 发现空值:`, rawVal, "完整对象:", item);
      return;
    }
    const d = new Date(rawVal);
    const ts = d.getTime();
    if (Number.isNaN(ts)) {
      console.error(`[索引 ${index}] 发现 Invalid Date! 原始字符串: "${rawVal}"`, item);
    }
  });
  console.groupEnd();
}
步骤二:格式归一化与时区锁定
如果数据源包含不同格式,或者跨浏览器兼容性至关重要(例如部分老旧 Safari 内核对 YYYY-MM-DD HH:mm:ss 直接返回 Invalid Date),应在排序前显式进行格式清洗:
- 将空格替换为标准的
T; - 将斜杠
/统一规范化; - 或者在解析时明确指定时区偏移量,例如追加
+08:00。
// 格式归一化函数示例
function normalizeDateStringToTimestamp(dateStr) {
  if (!dateStr || typeof dateStr !== "string") return NaN;

  // 处理斜杠格式 2026/03/01 => 2026-03-01
  let normalized = dateStr.trim().replace(/\//g, "-");

  // 处理纯日期格式与空格时间格式,显式锁定本地或指定时区
  if (/^\d{4}-\d{2}-\d{2}$/.test(normalized)) {
    // 若业务约定纯日期代表本地当天的开始零点,补充 T00:00:00 避免被当作 UTC 解析
    normalized = `${normalized}T00:00:00`;
  } else if (/^\d{4}-\d{2}-\d{2}\s+\d{2}:\d{2}(:\d{2})?$/.test(normalized)) {
    // 替换空格为 T
    normalized = normalized.replace(/\s+/, "T");
  }

  const parsed = new Date(normalized);
  return parsed.getTime();
}
步骤三:编写工业级防御比较器
防御性比较器的核心要求有三点:
- 永远只对纯数值进行算术比对:确保返回值为确切的正数、负数或 0,杜绝任何
NaN漏网。 - 明确界定非法值与空值的业务归宿:业务上需要明确空日期是置顶还是置底。通常情况下,空值或 Invalid Date 应统一沉底(置于列表末尾)。
- 同值稳定性与确定性仲裁(Tie-Breaker):若时间完全相同,通过二级唯一键(如 ID 或原始索引)进行仲裁,保证在任何引擎实现下的绝对幂等。
/**
 * 工业级时间比较器生成函数
 * @param {Function} keyExtractor 提取时间字段的回调
 * @param {Object} options 配置项
 * @param {boolean} [options.ascending=true] 是否升序(默认升序)
 * @param {boolean} [options.nullsLast=true] 无效/空时间是否沉底(默认置尾)
 * @param {Function} [options.tieBreaker] 辅助比较键提取器
 */
function createSafeDateComparator(keyExtractor, options = {}) {
  const {
    ascending = true,
    nullsLast = true,
    tieBreaker = null
  } = options;

  function toTimestamp(val) {
    if (val === null || val === undefined || val === "") return NaN;
    if (typeof val === "number") return Number.isFinite(val) ? val : NaN;
    if (val instanceof Date) return val.getTime();
    if (typeof val === "string") return normalizeDateStringToTimestamp(val);
    return NaN;
  }

  return function compare(itemA, itemB) {
    const rawA = keyExtractor(itemA);
    const rawB = keyExtractor(itemB);

    const tsA = toTimestamp(rawA);
    const tsB = toTimestamp(rawB);

    const isInvalidA = Number.isNaN(tsA);
    const isInvalidB = Number.isNaN(tsB);

    // 1. 处理边界情况:若两者均为无效时间,判定为等价
    if (isInvalidA && isInvalidB) {
      return 0;
    }

    // 2. 隔离无效时间,根据配置置底或置顶
    if (isInvalidA) return nullsLast ? 1 : -1;
    if (isInvalidB) return nullsLast ? -1 : 1;

    // 3. 正常有效时间戳纯数值比较(严格弱序)
    const diff = ascending ? tsA - tsB : tsB - tsA;

    // 4. 平局仲裁 (Tie-breaking),保障确定性
    if (diff === 0 && typeof tieBreaker === "function") {
      const tbA = tieBreaker(itemA);
      const tbB = tieBreaker(itemB);
      if (tbA < tbB) return -1;
      if (tbA > tbB) return 1;
      return 0;
    }

    return diff;
  };
}
步骤四:单元测试与边界断言
完成比较器重构后,应当使用包含边界情况的测试用例进行全面断言,验证其在极端输入下的抗风险能力:
// 完备测试用例集
const testData = [
  { id: 1, time: "2026-03-05 12:00:00" },
  { id: 2, time: null },
  { id: 3, time: "2026-03-01" },
  { id: 4, time: "invalid-date-string" },
  { id: 5, time: "2026-03-01 00:00:00" },
  { id: 6, time: 1772323200000 }, // 毫秒数值
  { id: 7, time: "" },
  { id: 8, time: "2026-02-28 23:59:59" }
];

// 使用防御比较器排序
const safeComparator = createSafeDateComparator(x => x.time, {
  ascending: true,
  nullsLast: true,
  tieBreaker: x => x.id
});

const sorted = [...testData].sort(safeComparator);

console.log("稳健排序执行结果:", sorted.map(x => (`[ID:${x.id}] ${x.time}`)));
// 结果表现:
// 所有有效日期按严格单调时间先后正确排布,
// 8小时时区偏差被抹平,
// null、空串、invalid-date 稳定且有序地聚集在数组最后!
五、防御性编程准则与架构建议
为了从根本上消除前端和全栈项目中的时间排序隐患,推荐在架构设计与开发规范中遵循以下四项防御准则:
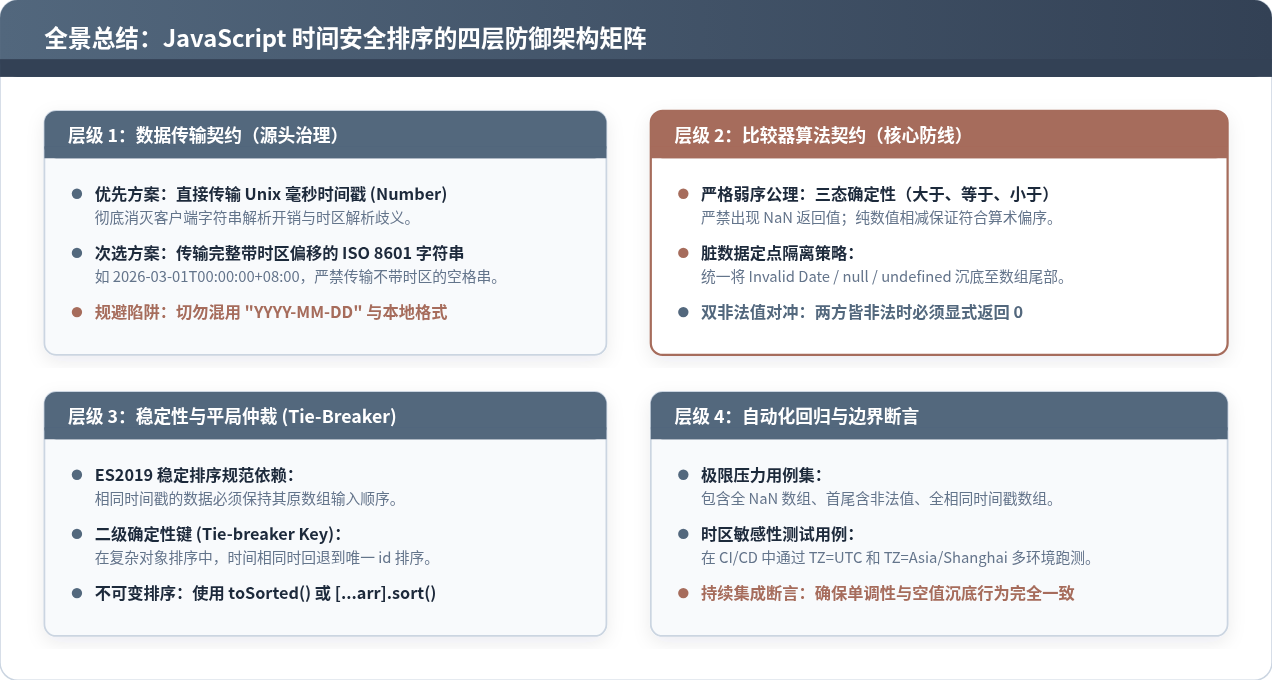
| 防御层级 | 常见风险点 | 工程化防御对策 | 收益 |
|---|---|---|---|
| 传输契约层 | 混用无时区纯字符串、各种自定义空格斜杠日期格式 | 前后端 API 契约首选 Unix 毫秒时间戳 (number) 或带完整时区偏移的 ISO 8601 (2026-03-01T00:00:00+08:00) |
从数据输入源杜绝时区漂移与浏览器解析方言差异 |
| 数据清洗层 | 直接调用 new Date(raw) 导致生成 Invalid Date |
构建统一的日期解析校验器,先行判定 Number.isNaN(d.getTime()) 并记录日志 |
及早发现业务脏数据,阻断异常穿透到下游组件 |
| 比较算法层 | 比较器直接相减返回 NaN,击穿 TimSort 算法公理 |
封装通用安全比较器,隔离非法值沉底,严格保证三态比较 | 保证任何情况下排序不崩溃、不乱序,维持严格弱序 |
| 状态安全层 | Array.prototype.sort 原地修改数组引发响应式或缓存竞态 |
采用纯函数不可变方式,使用 [...arr].sort() 或 ECMAScript 2023 新增的 arr.toSorted() |
避免副作用污染原始数据,提升函数式架构的可靠性 |
排查 JavaScript 时间排序异常的过程,本质上是对 JS 语言隐式类型转换、ECMAScript 标准规范时区细则以及现代排序算法底层数学模型的一次深入审视。在实际工程落地中,抛弃对默认行为和无参 API 的侥幸心理,建立显式、严密、防御性的数据解析与排序契约,才能真正构建出经得起生产考验的稳健应用。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章