
详细说明基于Node.js构建模块化汇编器的分层架构、目录组织、中间表示(IR)与诊断模型、两遍扫描机制、指令集插件契约及测试验证方法。

当前位置:首页 > Node.js 基础 > 正文
基于Node.js的模块化汇编器项目架构设计指南
作者:栖木
时间:2026-11-22
浏览:214
文章目录
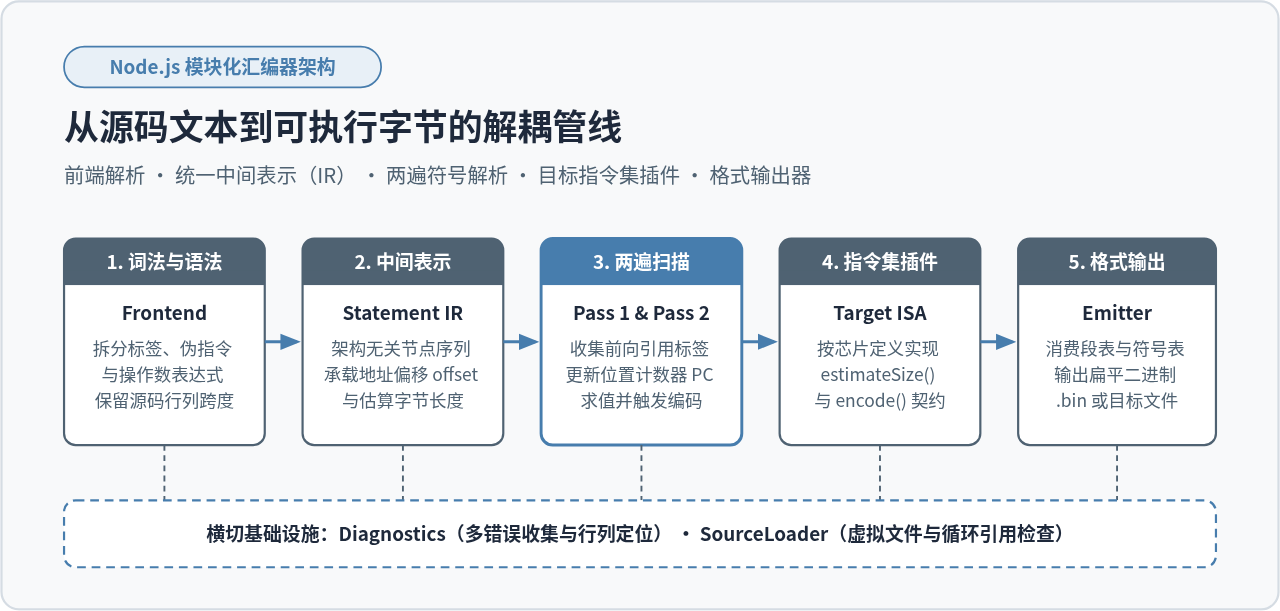
用 Node.js 编写汇编器时,如果把读取文件、拆分助记符、解析前向跳转标签和拼接机器码全部写在一个脚本里,只要新增一条伪指令、一个指令集或一种输出格式,代码就会迅速变得难以维护。解决这个问题的关键,是把汇编流程拆成前端解析、中间表示(IR)、多遍符号处理、目标指令集插件、格式输出器五个单向依赖的模块,并用统一的诊断系统贯穿全流程。
分层架构与单向依赖边界
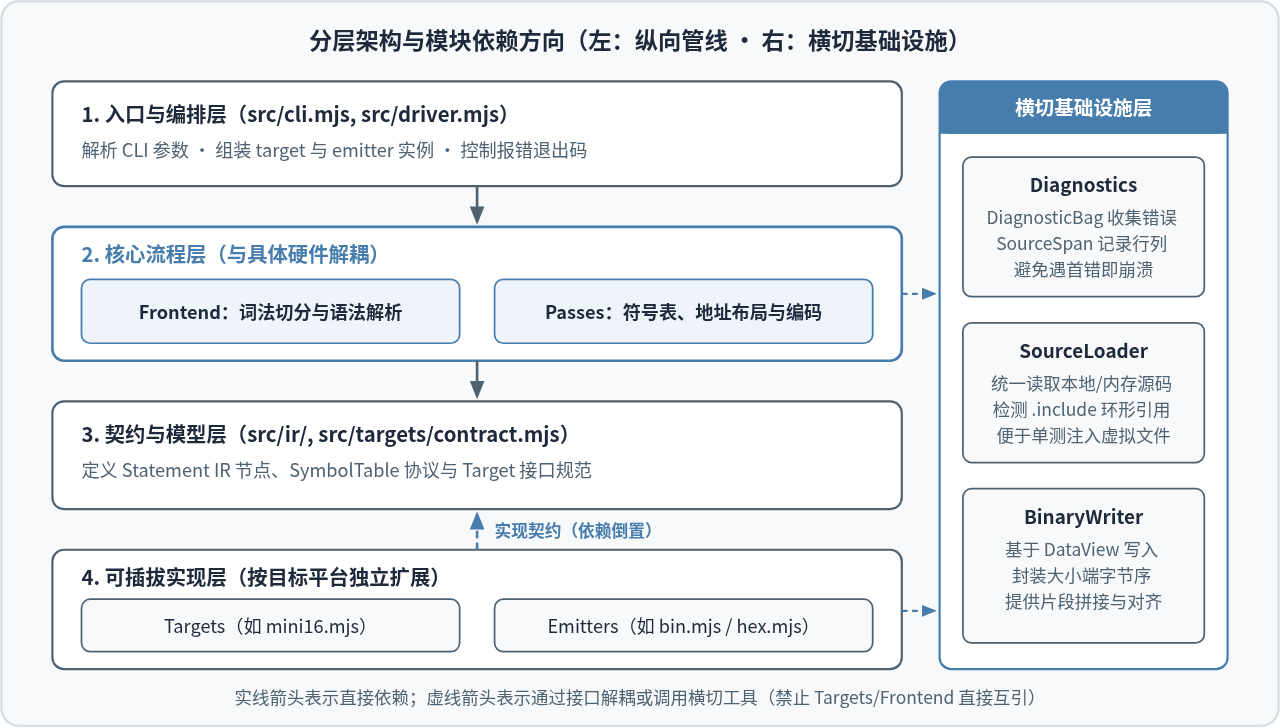
汇编器的本质是把带符号的文本指令翻译为定长或变长的字节序列,并在遇到语法错误时准确指明文件名和行列位置。为了避免模块之间互相引用导致牵一发而动全身,项目应遵循严格的单向依赖原则:上层流程编排下层组件,具体芯片编码逻辑不反向污染通用解析器。
整个项目可以划分为四个纵向层级与一个横向基础设施层:
- 入口与编排层(CLI / Driver):负责读取命令行参数、加载目标架构插件与输出器插件,并按固定顺序驱动前端、扫描遍和输出阶段。
- 核心流程层(Frontend 与 Passes):
Frontend将源文本转为结构化的 IR 节点列表;Passes遍历 IR 完成符号表构建、地址布局和机器码生成请求。 - 契约与数据结构层(IR 与 Target Contract):定义标签、伪指令、机器指令的数据结构,以及目标架构插件必须实现的方法签名,本身不包含任何具体芯片的操作码。
- 可插拔实现层(Targets 与 Emitters):
Targets负责特定指令集的尺寸估算与编码;Emitters负责把最终字节段输出为扁平二进制、十六进制文本或目标文件。
推荐项目目录结构
在 Node.js 中使用原生 ES Modules(在 package.json 中配置 "type": "module")可以省去额外的打包步骤,目录边界也更直观。建议按模块职责组织目录:
modular-assembler/
├── package.json
├── src/
│   ├── cli.mjs                  # 命令行入口,解析参数并打印诊断
│   ├── driver.mjs               # 编排 assembleSource / assembleFile
│   ├── diagnostics/
│   │   └── diagnostic.mjs       # SourceSpan、DiagnosticBag 与格式化输出
│   ├── ir/
│   │   └── nodes.mjs            # Label / Directive / Instruction 节点工厂
│   ├── frontend/
│   │   └── parser.mjs           # 行级词法切分与语法解析,生成 IR
│   ├── passes/
│   │   ├── symbol-table.mjs     # 符号定义、查表与重复定义检查
│   │   └── two-pass.mjs         # Pass 1 地址计算与 Pass 2 机器码生成
│   ├── targets/
│   │   └── mini16.mjs           # 示例目标架构插件(实现契约方法)
│   └── emitters/
│       └── bin.mjs              # 扁平二进制 Uint8Array 输出器
└── test/
    └── assembler.test.mjs       # 使用 node:test 编写的单元测试
这样划分后,如果要测试指令编码是否正确,只需要导入 src/targets/mini16.mjs 和 src/ir/nodes.mjs;如果要验证词法解析报错,只需要导入 src/frontend/parser.mjs 和 src/diagnostics/diagnostic.mjs,不需要启动整个 CLI。
中间表示(IR)与跨文件诊断模型
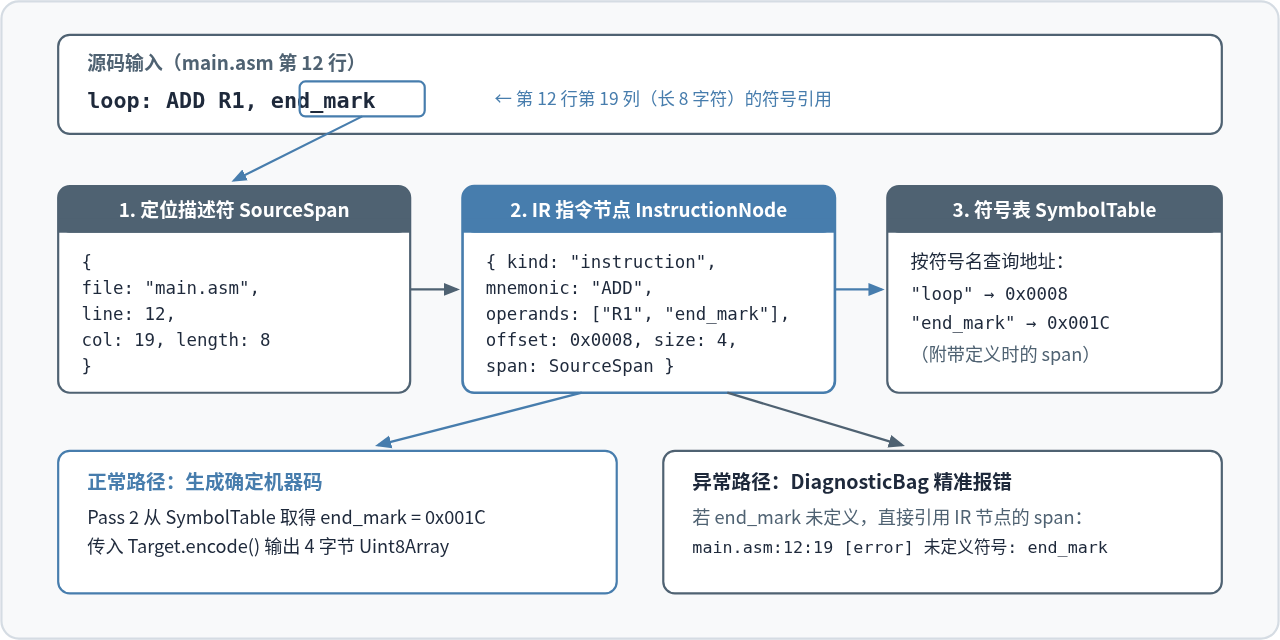
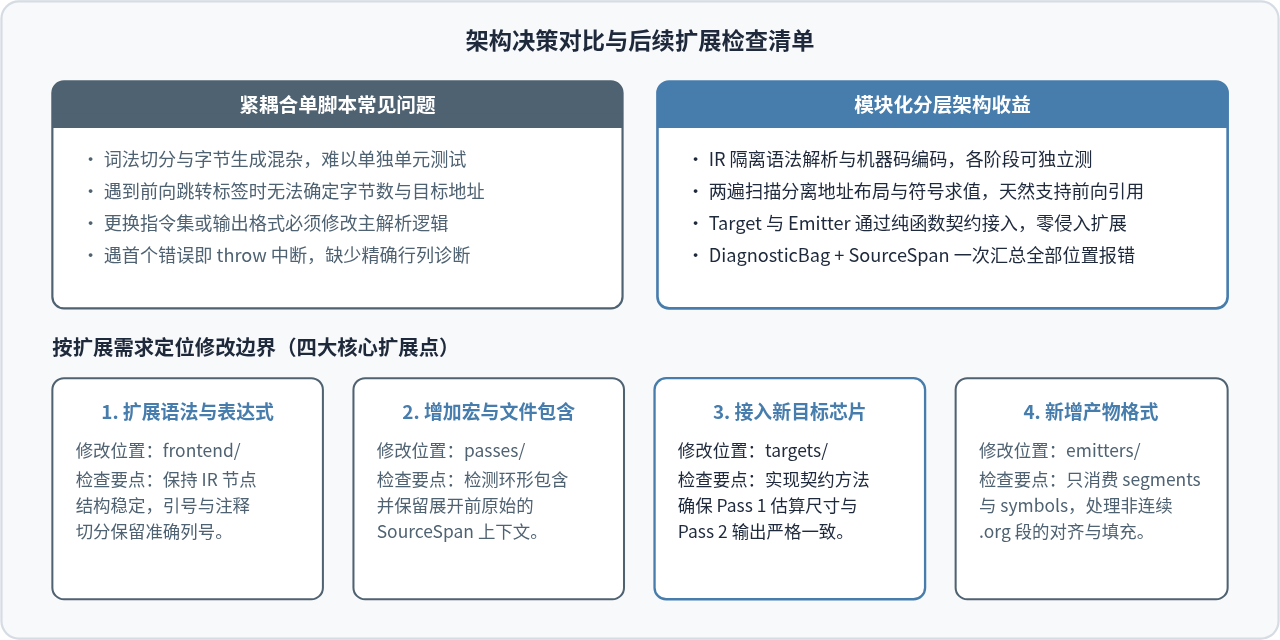
初学者编写汇编器时,常犯的一个错误是在解析文本的瞬间直接向输出缓冲区写入字节,并用 throw new Error(...) 报错。这种做法会带来两个直接问题:第一,遇到第一处拼写错误就中止,用户无法一次性看到文件中其余的语法错误;第二,一旦指令支持前向引用或宏展开,后续阶段无法得知某条错误字节原本对应哪个源码文件的第几行。
正确的做法是让每个 Token 和 IR 语句节点都携带不可变的 SourceSpan(包含文件路径、起始行号、列号与长度),并将错误统一写入 DiagnosticBag 收集器。
诊断模块与 IR 节点实现
下面的 src/diagnostics/diagnostic.mjs 定义了源码定位对象与错误收集袋,所有阶段共享这一格式,确保解析错误、重复标签错误和编码溢出错误都能统一输出:
// src/diagnostics/diagnostic.mjs
export function createSpan(file, line, col = 1, length = 1) {
  return Object.freeze({ file, line, col, length });
}

export class DiagnosticBag {
  constructor() {
    this.items = [];
  }

  add(severity, code, message, span) {
    this.items.push(Object.freeze({ severity, code, message, span }));
  }

  error(code, message, span) {
    this.add("error", code, message, span);
  }

  hasErrors() {
    return this.items.some((item) => item.severity === "error");
  }
}

export function formatDiagnostic(diag) {
  const loc = diag.span
    ? `${diag.span.file}:${diag.span.line}:${diag.span.col}`
    : "<unknown>";
  return `${loc} [${diag.severity} ${diag.code}] ${diag.message}`;
}
IR 节点不需要复杂的多态类继承,使用带 kind 字段的纯对象即可,这在 Node.js 中既容易序列化调试,也方便模式匹配。创建 src/ir/nodes.mjs:
// src/ir/nodes.mjs
export function createLabelNode(name, span) {
  return { kind: "label", name, span, offset: 0, size: 0 };
}

export function createDirectiveNode(name, args, span) {
  return { kind: "directive", name: name.toUpperCase(), args, span, offset: 0, size: 0 };
}

export function createInstructionNode(mnemonic, operands, span) {
  return {
    kind: "instruction",
    mnemonic: mnemonic.toUpperCase(),
    operands,
    span,
    offset: 0,
    size: 0,
  };
}
编写与指令集无关的轻量前端
为了让前端(src/frontend/parser.mjs)保持指令集无关,解析器只负责识别汇编语法的通用结构:以 ; 开头的注释、label: 形式的标签、以 . 开头的伪指令(例如 .org、.word),以及「助记符 + 逗号分隔操作数」的指令行。具体某个助记符是否合法、寄存器编号是否越界,留给后续阶段由 Target 插件校验。
// src/frontend/parser.mjs
import { createSpan } from "../diagnostics/diagnostic.mjs";
import {
  createDirectiveNode,
  createInstructionNode,
  createLabelNode,
} from "../ir/nodes.mjs";

function stripComment(lineText) {
  const idx = lineText.indexOf(";");
  return idx === -1 ? lineText : lineText.slice(0, idx);
}

export function parseSource(source, file, diagnostics) {
  const statements = [];
  const lines = source.split(/\r?\n/);

  lines.forEach((rawLine, index) => {
    const lineNo = index + 1;
    const withoutComment = stripComment(rawLine);
    let rest = withoutComment.trim();
    if (!rest) return;

    // 1. 提取行首标签(允许标签与指令写在同一行,如 "loop: ADD R1, 1")
    const labelMatch = /^([A-Za-z_.$][A-Za-z0-9_.$]*):(.*)$/.exec(rest);
    if (labelMatch) {
      const labelName = labelMatch[1];
      const col = rawLine.indexOf(labelName) + 1;
      statements.push(
        createLabelNode(labelName, createSpan(file, lineNo, col, labelName.length))
      );
      rest = labelMatch[2].trim();
      if (!rest) return;
    }

    // 2. 分离头部关键字与操作数列表
    const headMatch = /^(\.?[A-Za-z_][A-Za-z0-9_]*)(?:\s+(.*))?$/.exec(rest);
    if (!headMatch) {
      const col = rawLine.search(/\S/) + 1;
      diagnostics.error("E_SYNTAX", `无法识别的语句格式: ${rest}`, createSpan(file, lineNo, col, rest.length));
      return;
    }

    const head = headMatch[1];
    const argText = (headMatch[2] ?? "").trim();
    const args = argText ? argText.split(",").map((s) => s.trim()).filter(Boolean) : [];
    const headCol = rawLine.indexOf(head) + 1;
    const span = createSpan(file, lineNo, headCol, head.length);

    if (head.startsWith(".")) {
      statements.push(createDirectiveNode(head, args, span));
    } else {
      statements.push(createInstructionNode(head, args, span));
    }
  });

  return { statements };
}
注意拆行与空白处理:如果后续指令集支持字符串字面量(如
.ascii "a, b"),不能直接用 argText.split(","),而应写一个小型状态机扫描字符并忽略引号内的逗号。
两遍扫描、表达式求值与指令松弛流程
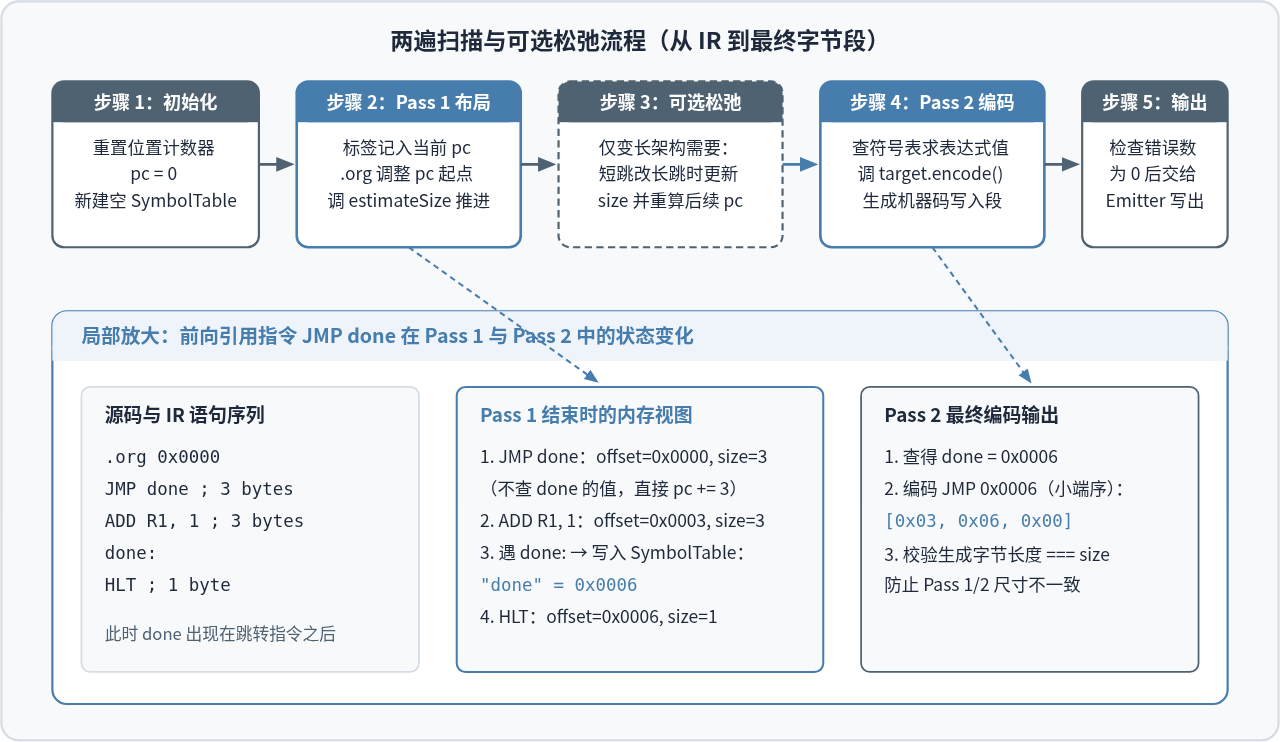
汇编代码普遍存在前向引用:程序开头跳转到文件末尾的标签(例如 JMP done)。在第一遍读取到 JMP done 时,done 的地址尚未确定,因此汇编器必须把「确定每条指令占据多少字节、记录所有标签地址」与「代入标签地址生成机器码」拆成两个步骤。
何时需要第三步“指令松弛”
如果目标指令集所有指令都是定长的(例如每条指令固定 2 字节或 4 字节),或者跳转指令固定占 3 字节,那么只需两遍扫描就够了。只有当指令集允许同一助记符根据目标距离自动选择“短跳转(2 字节)”或“长跳转(4 字节)”时,才需要在 Pass 1 和 Pass 2 之间加入一个循环迭代的松弛遍(Relaxation Pass):不断重新计算地址并调整跨度超限的跳转尺寸,直到连续两轮没有任何一条指令的 size 发生变化为止。
符号表与两遍扫描核心代码
先把符号表独立成 src/passes/symbol-table.mjs,负责记录符号地址、拦截重复定义,并提供安全的数值或符号求值方法(不要使用 JavaScript 的 eval 或 Function 来求值操作数表达式,否则容易引入注入风险和模糊错误):
// src/passes/symbol-table.mjs
export class SymbolTable {
  constructor() {
    this.entries = new Map();
  }

  define(name, value, span, diagnostics) {
    if (this.entries.has(name)) {
      const prev = this.entries.get(name);
      diagnostics.error(
        "E_DUP_SYMBOL",
        `符号 "${name}" 重复定义(首次定义于 ${prev.span.file}:${prev.span.line})`,
        span
      );
      return;
    }
    this.entries.set(name, { value, span });
  }

  resolve(name, span, diagnostics) {
    if (!this.entries.has(name)) {
      diagnostics.error("E_UNDEF_SYMBOL", `未定义符号: ${name}`, span);
      return null;
    }
    return this.entries.get(name).value;
  }

  evaluateExpr(exprText, span, diagnostics) {
    const raw = exprText.trim();
    if (/^0x[0-9a-fA-F]+$/.test(raw)) return Number.parseInt(raw, 16);
    if (/^-?\d+$/.test(raw)) return Number.parseInt(raw, 10);
    return this.resolve(raw, span, diagnostics);
  }
}
接下来在 src/passes/two-pass.mjs 中实现两遍扫描。注意每轮扫描都通过显式上下文对象传递 pc、symbols 和 diagnostics,不在模块顶层保存可变全局变量,这样同一进程内并发汇编多个文件时不会互相串扰:
// src/passes/two-pass.mjs
import { SymbolTable } from "./symbol-table.mjs";

function parseWordSize(stmt) {
  return stmt.args.length * 2;
}

export function runTwoPassAssembly(statements, target, diagnostics) {
  const symbols = new SymbolTable();
  let currentOrigin = 0;
  let pc = 0;

  // Pass 1:计算地址偏移、记录标签并估算每条指令字节数
  for (const stmt of statements) {
    if (stmt.kind === "label") {
      stmt.offset = pc;
      symbols.define(stmt.name, pc, stmt.span, diagnostics);
      continue;
    }

    if (stmt.kind === "directive") {
      if (stmt.name === ".ORG") {
        const nextAddr = symbols.evaluateExpr(stmt.args[0] ?? "", stmt.span, diagnostics);
        if (nextAddr !== null) {
          pc = nextAddr;
          if (currentOrigin === 0 && pc !== 0) currentOrigin = pc;
        }
        stmt.offset = pc;
        continue;
      }
      if (stmt.name === ".WORD") {
        stmt.offset = pc;
        stmt.size = parseWordSize(stmt);
        pc += stmt.size;
        continue;
      }
      diagnostics.error("E_DIRECTIVE", `不支持的伪指令: ${stmt.name}`, stmt.span);
      continue;
    }

    stmt.offset = pc;
    stmt.size = target.estimateSize(stmt, { pc, diagnostics });
    pc += stmt.size;
  }

  if (diagnostics.hasErrors()) {
    return { segments: [], symbols };
  }

  // Pass 2:带入完整符号表,编码每条语句并写入内存段
  const segments = [];
  let activeChunks = [];
  let segmentOrigin = currentOrigin;

  const flushSegment = () => {
    if (activeChunks.length === 0) return;
    const total = activeChunks.reduce((sum, buf) => sum + buf.length, 0);
    const merged = new Uint8Array(total);
    let cursor = 0;
    for (const chunk of activeChunks) {
      merged.set(chunk, cursor);
      cursor += chunk.length;
    }
    segments.push({ origin: segmentOrigin, bytes: merged });
    activeChunks = [];
  };

  for (const stmt of statements) {
    if (stmt.kind === "label") continue;

    if (stmt.kind === "directive") {
      if (stmt.name === ".ORG") {
        flushSegment();
        const nextAddr = symbols.evaluateExpr(stmt.args[0] ?? "", stmt.span, diagnostics);
        if (nextAddr !== null) segmentOrigin = nextAddr;
        continue;
      }
      if (stmt.name === ".WORD") {
        const buf = new Uint8Array(stmt.size);
        const view = new DataView(buf.buffer);
        stmt.args.forEach((arg, idx) => {
          const val = symbols.evaluateExpr(arg, stmt.span, diagnostics) ?? 0;
          view.setUint16(idx * 2, val & 0xffff, target.endianness === "little");
        });
        activeChunks.push(buf);
        continue;
      }
    }

    const bytes = target.encode(stmt, {
      pc: stmt.offset,
      symbols,
      diagnostics,
    });
    if (bytes.length !== stmt.size) {
      diagnostics.error(
        "E_SIZE_MISMATCH",
        `指令 ${stmt.mnemonic} Pass 1 估算 ${stmt.size} 字节,Pass 2 实际生成 ${bytes.length} 字节`,
        stmt.span
      );
      continue;
    }
    activeChunks.push(bytes);
  }

  flushSegment();
  return { segments, symbols };
}
留意 Pass 2 末尾的 bytes.length !== stmt.size 断言:这是捕获“Pass 1 尺寸估算和 Pass 2 编码逻辑不一致”最有效的保护网,可以避免静默生成错位的跳转地址。
通过插件契约隔离指令集与输出格式
在 Node.js 中实现插件化不需要引入复杂的依赖注入框架,只需约定工厂函数返回满足固定结构的纯对象即可。每个 Target 插件只需对外暴露四项成员:
| 契约成员 | 类型或签名 | 职责说明 |
|---|---|---|
name |
string |
目标架构标识,用于命令行参数选择与测试报告 |
endianness |
"little" | "big" |
告知核心层在编码 .word 等多字节数据时的字节序 |
estimateSize(stmt, ctx) |
number |
在 Pass 1 根据助记符与操作数形态返回精确字节长度,校验操作数个数 |
encode(stmt, ctx) |
Uint8Array |
在 Pass 2 求值符号与立即数,按位编码并返回机器码字节数组 |
示例指令集插件与输出器实现
下面构建一个用于教学演示的 16 位极简指令集插件 mini16(支持 MOV、ADD、JMP、HLT),用来演示如何把寄存器校验和位编码完全隔离在 src/targets/mini16.mjs 内部:
// src/targets/mini16.mjs
const REGISTERS = new Map([
  ["R0", 0],
  ["R1", 1],
  ["R2", 2],
  ["R3", 3],
]);

// 指令字节长度表:操作码 1 字节 + 寄存器/16位立即数
const INSN_SIZE = new Map([
  ["HLT", 1],
  ["MOV", 4], // [0x01, reg, immLo, immHi]
  ["ADD", 4], // [0x02, reg, immLo, immHi]
  ["JMP", 3], // [0x03, addrLo, addrHi]
]);

function expectReg(token, span, diagnostics) {
  const reg = REGISTERS.get(token?.toUpperCase());
  if (reg === undefined) {
    diagnostics.error("E_BAD_REG", `无效寄存器: ${token ?? ""}`, span);
    return 0;
  }
  return reg;
}

export function createMini16Target() {
  return {
    name: "mini16",
    endianness: "little",

    estimateSize(stmt, { diagnostics }) {
      const size = INSN_SIZE.get(stmt.mnemonic);
      if (size === undefined) {
        diagnostics.error("E_UNKNOWN_INSN", `未知指令: ${stmt.mnemonic}`, stmt.span);
        return 0;
      }
      return size;
    },

    encode(stmt, { symbols, diagnostics }) {
      const { mnemonic, operands, span } = stmt;

      if (mnemonic === "HLT") {
        if (operands.length !== 0) {
          diagnostics.error("E_ARITY", "HLT 不接受操作数", span);
        }
        return new Uint8Array([0x00]);
      }

      if (mnemonic === "MOV" || mnemonic === "ADD") {
        if (operands.length !== 2) {
          diagnostics.error("E_ARITY", `${mnemonic} 需要 2 个操作数`, span);
          return new Uint8Array(4);
        }
        const reg = expectReg(operands[0], span, diagnostics);
        const imm = symbols.evaluateExpr(operands[1], span, diagnostics) ?? 0;
        const buf = new Uint8Array(4);
        const view = new DataView(buf.buffer);
        buf[0] = mnemonic === "MOV" ? 0x01 : 0x02;
        buf[1] = reg;
        view.setUint16(2, imm & 0xffff, true);
        return buf;
      }

      if (mnemonic === "JMP") {
        if (operands.length !== 1) {
          diagnostics.error("E_ARITY", "JMP 需要 1 个目标地址操作数", span);
          return new Uint8Array(3);
        }
        const addr = symbols.evaluateExpr(operands[0], span, diagnostics) ?? 0;
        const buf = new Uint8Array(3);
        const view = new DataView(buf.buffer);
        buf[0] = 0x03;
        view.setUint16(1, addr & 0xffff, true);
        return buf;
      }

      return new Uint8Array(0);
    },
  };
}
输出器(Emitter)同样只需要消费 segments 数组。下面在 src/emitters/bin.mjs 中实现扁平二进制拼接器,并在 src/driver.mjs 中把整个汇编管线串联起来:
// src/emitters/bin.mjs
export function emitFlatBinary(segments) {
  if (segments.length === 0) return new Uint8Array(0);
  const sorted = [...segments].sort((a, b) => a.origin - b.origin);
  const base = sorted[0].origin;
  const last = sorted[sorted.length - 1];
  const totalSize = last.origin + last.bytes.length - base;

  const output = new Uint8Array(totalSize);
  for (const seg of sorted) {
    output.set(seg.bytes, seg.origin - base);
  }
  return output;
}
// src/driver.mjs
import { DiagnosticBag } from "./diagnostics/diagnostic.mjs";
import { parseSource } from "./frontend/parser.mjs";
import { runTwoPassAssembly } from "./passes/two-pass.mjs";
import { emitFlatBinary } from "./emitters/bin.mjs";
export function assembleSource({ source, file = "<input>", target, emitter = emitFlatBinary }) {
const diagnostics = new DiagnosticBag();
const { statements } = parseSource(source, file, diagnostics);
if (diagnostics.hasErrors()) {
return { ok: false, diagnostics, bytes: new Uint8Array(0), segments: [], symbols: null };
}
const { segments, symbols } = runTwoPassAssembly(statements, target, diagnostics);
if (diagnostics.hasErrors()) {
return { ok: false, diagnostics, bytes: new Uint8Array(0), segments, symbols };
}
const bytes = emitter(segments);
return { ok: true, diagnostics, bytes, segments, symbols };
}架构验证、分层测试与常见陷阱
模块化设计是否真正落地,可以通过编写不依赖磁盘 I/O 和命令行进程的测试来验证。使用 Node.js 内置的 node:test 与 node:assert/strict,可以直接在内存中验证前向引用解析、错误行列定位以及机器码输出:
// test/assembler.test.mjs
import test from "node:test";
import assert from "node:assert/strict";
import { assembleSource } from "../src/driver.mjs";
import { createMini16Target } from "../src/targets/mini16.mjs";
import { formatDiagnostic } from "../src/diagnostics/diagnostic.mjs";

test("正确解析前向引用标签并输出小端机器码", () => {
  const source = [
    ".org 0x0000",
    "JMP done",
    "MOV R1, 0x002A",
    "done:",
    "HLT",
  ].join("\n");

  const result = assembleSource({
    source,
    file: "forward.asm",
    target: createMini16Target(),
  });

  assert.equal(result.ok, true);
  // JMP(3) + MOV(4) => done 位于 0x0007
  assert.deepEqual(
    Array.from(result.bytes),
    [0x03, 0x07, 0x00, 0x01, 0x01, 0x2a, 0x00, 0x00]
  );
});

test("未定义符号返回准确的源码行列信息", () => {
  const source = "JMP missing_label\nHLT";
  const result = assembleSource({
    source,
    file: "err.asm",
    target: createMini16Target(),
  });

  assert.equal(result.ok, false);
  const text = formatDiagnostic(result.diagnostics.items[0]);
  assert.match(text, /^err\.asm:1:1 \[error E_UNDEF_SYMBOL\]/);
});
在项目根目录下运行内置测试命令:
node --test示例输出
✔ 正确解析前向引用标签并输出小端机器码
✔ 未定义符号返回准确的源码行列信息
ℹ tests 2
ℹ pass 2
ℹ fail 0
扩展项目时最容易踩中的三个架构陷阱
- 把宏展开或
.include当成纯字符串拼接:直接做字符串替换会破坏行号对应关系,报错行号会全部错位。正确方式是在前端或预处理器里为展开后的每条语句保留原始文件与调用栈SourceSpan。 - 在目标插件中硬编码寄存器词法规则:不同芯片的寄存器前缀(如
R0、x0、$t0)差异很大,通用词法器不应识别“寄存器 Token”,只应将其作为普通标识符传入 IR,由 Target 插件的encode()查表解释。 - 忽略内存段空洞:源码中如果出现两段不连续的
.org(例如.org 0x0000与.org 0x1000),扁平二进制输出器在拼接时必须按地址差填充零字节;如果要避免生成过大的空洞文件,则应改用记录段起始地址的 Intel HEX 或 ELF Emitter。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章