

详细解析基于浏览器的纯前端离线人脸识别技术方案,涵盖模型切片静态托管、IndexedDB持久化缓存、WebGL加速推理、128维人脸特征提取比对与网络层断网隐私防护落地实践。
纯前端离线人脸识别方案:模型本地加载与隐私保护实现
作者:拾星
时间:2026-11-22
浏览:345
文章目录
技术方案:浏览器端离线计算
核心机制:IndexedDB缓存 + WebGL推理
合规等级:图像与特征零出域
纯前端离线人脸识别方案,是指在用户的浏览器端独立完成神经网络模型文件的本地缓存与加载,利用设备本机的 WebGL/WebAssembly 算力捕获视频流、提取 128 维人脸特征向量,并在沙盒数据库中完成特征相似度比对。整个识别过程中,原始图像与人脸生物特征均不需要上传至远端服务器,不仅避免了持续的网络通信与服务器算力成本,更从物理链路层面切断了人脸数据泄露风险。
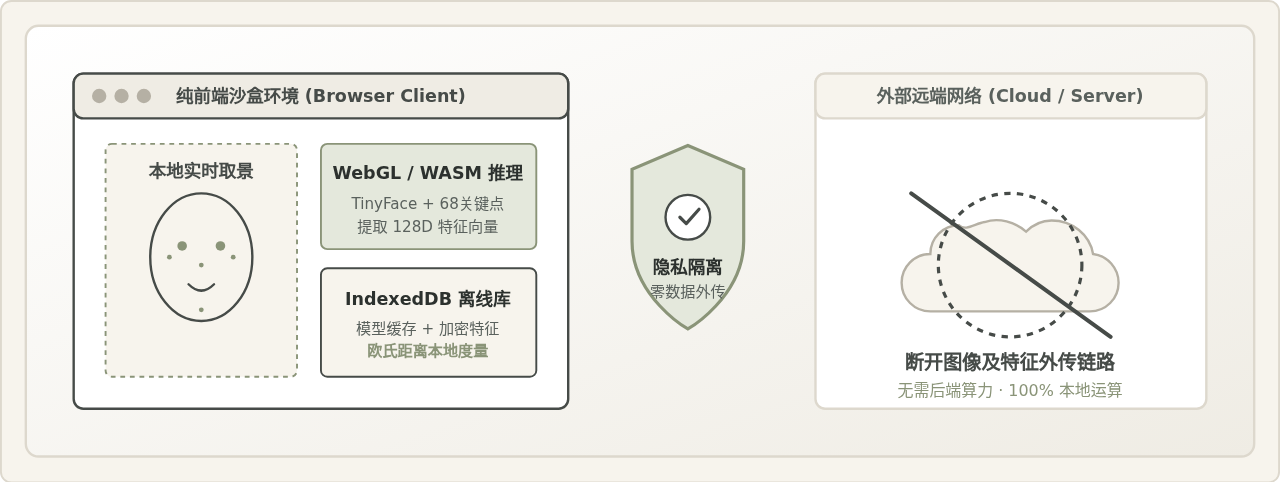
一、技术架构与核心运行原理
实现纯前端离线人脸识别,关键在于厘清浏览器运行深度学习模型的软硬件分工。系统由三大支柱构成:模型静态托管与离线存储层、浏览器端推理执行后端、以及本地特征匹配与隐私沙盒。其整体架构与数据边界如下图所示:
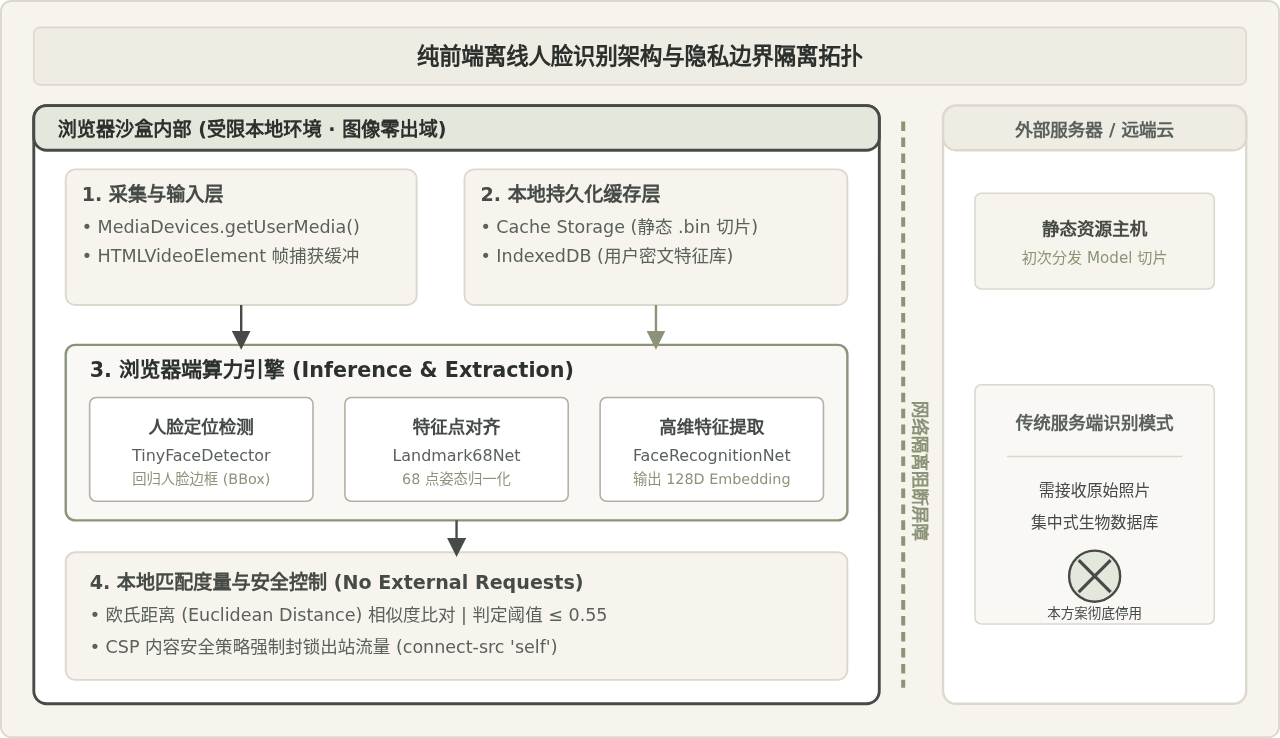
在传统的服务端人脸识别架构中,前端网页仅仅充当数据采集器,通过 WebSocket 或 HTTP POST 请求将摄像头截取的每一帧 Base64 图片推送至后端 API 进行推理。而在纯前端方案中,所有计算完全下沉:
- 人脸检测与对准(Face Detection & Alignment):利用轻量化卷积网络(如 Tiny Face Detector 或 SSD MobileNet)在视频流单帧中圈定人脸边界框,并定位 68 个面部特征关键点(眼角、鼻尖、唇周等),完成人脸姿态对齐与归一化缩放。
- 特征向量提取(Face Descriptor Extraction):将对齐后的面部子图像输入基于 ResNet 架构精简的特征提取模型,输出一个固定长度的 128 维浮点型数组(
Float32Array(128))。该向量即为面部的数学表征(Embedding)。 - 本地相似度比对(Vector Matching):不直接比对像素,而是通过欧氏距离公式度量当前实时帧特征与本地已录入特征的几何距离。当距离小于预设安全阈值(如 0.6)时判定为同一人。
认知辨析:离线识别中的常见概念修正
常见误区一:“人脸比对就是把两张图片做高精度像素重合对比”
这种说法看似合理,因为视觉上人类确实是通过外貌相似度认人。但在工程实现中,光线变化、拍摄角度倾斜或表情变化都会导致像素值发生剧烈剧变,直接比对像素的正确率极低。现代算法是将图像映射到 128 维特征空间,只要同一个人的特征点相对拓扑关系一致,提取出的特征向量就保持高度聚集。
常见误区二:“提取出的人脸特征向量随时可以反向还原成原始人脸高清照片”
这种观点容易引发过度恐慌。128 维特征向量是多层卷积和全局池化之后的高度降维抽象数据,它丢弃了肤色细节、背景、发丝纹理等绝大多数像素信息,属于不可逆的有损投影。尽管在理论上可能通过生成对抗网络合成出某种具有相似特征的面部构型,但它无法直接逆向还原出原始摄录照片。在本地存储中只保存特征向量而不保留原始照片,正是满足最小必要原则的重要防线。
二、系统执行流程与操作步骤
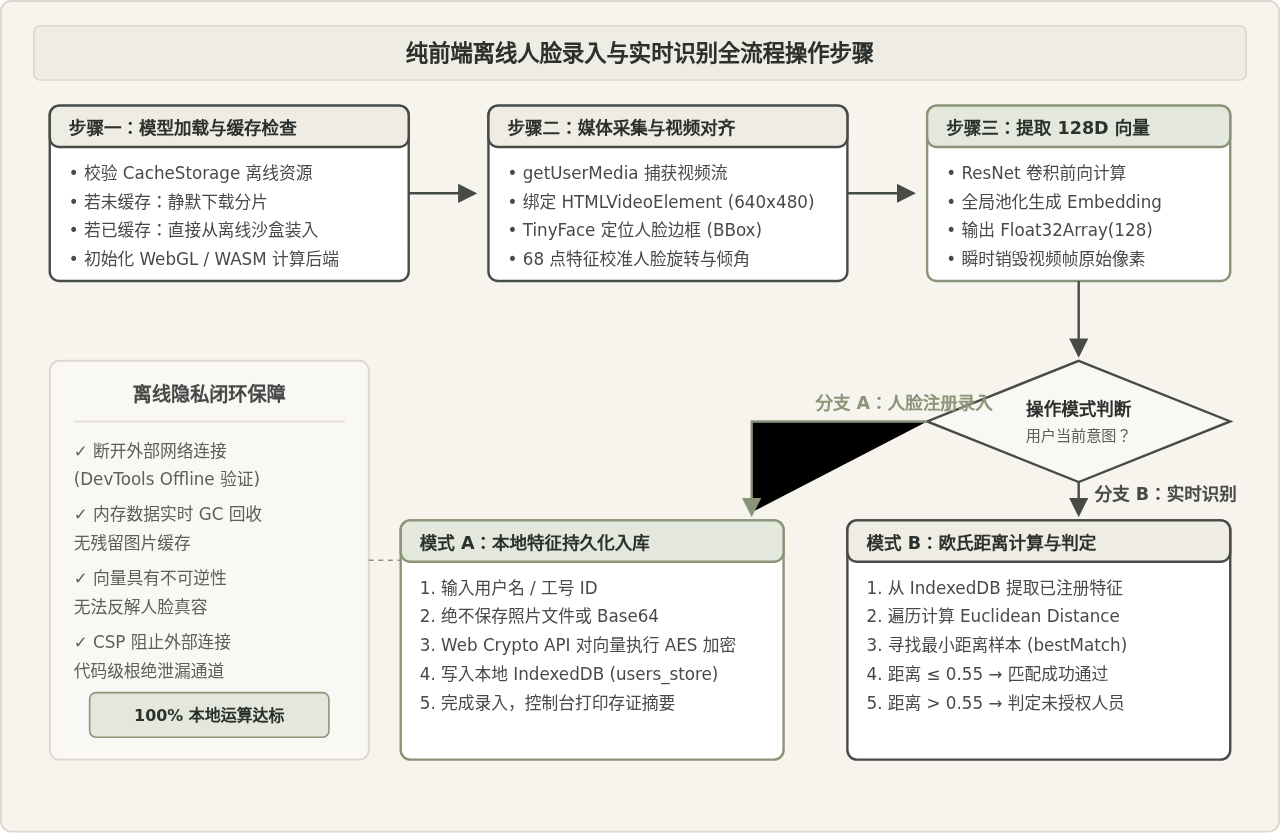
落地一套可用的纯前端人脸识别系统,操作流程分为“环境准备与模型预热”、“人脸样本录入”、“实时识别比对”三个阶段。整体执行流程如下图所示:
第 1 步:模型静态分片与本地持久化缓存
深度学习模型通常体积较大(完整模型约 10MB 至 30MB,精简模型约 3MB 至 6MB)。为了保证在完全离线(如断开 Wi-Fi 或离线工业平板)环境下仍能正常运行,不能每次都通过网络请求模型文件。需要将模型拆分为 manifest.json 拓扑描述文件与若干 .bin 权重切片,并通过浏览器的 Cache Storage API 或 IndexedDB 进行本地持久化。
// 离线模型加载与缓存检查逻辑 (使用 Service Worker 或 Cache API)
const MODEL_CACHE_NAME = 'face-models-offline-v1';
const MODEL_URLS = [
  '/models/tiny_face_detector_model-weights_manifest.json',
  '/models/tiny_face_detector_model-shard1',
  '/models/face_landmark_68_model-weights_manifest.json',
  '/models/face_landmark_68_model-shard1',
  '/models/face_recognition_model-weights_manifest.json',
  '/models/face_recognition_model-shard1',
  '/models/face_recognition_model-shard2'
];

async function ensureModelsCached() {
  const cache = await caches.open(MODEL_CACHE_NAME);
  for (const url of MODEL_URLS) {
    const match = await cache.match(url);
    if (!match) {
      // 首次联网状态下抓取并写入离线缓存
      console.log(`[Cache] 缓存模型切片: ${url}`);
      await cache.add(url);
    }
  }
}

async function loadModelsOffline() {
  await ensureModelsCached();
  // 指定从本地相对路径或缓存端点加载模型权值
  const MODEL_PATH = '/models';
  await faceapi.nets.tinyFaceDetector.loadFromUri(MODEL_PATH);
  await faceapi.nets.faceLandmark68Net.loadFromUri(MODEL_PATH);
  await faceapi.nets.faceRecognitionNet.loadFromUri(MODEL_PATH);
  console.log('[Model] 纯前端离线模型全部加载就绪');
}
控制台示例输出(注明:模拟离线加载日志)
[Cache] 检查离线缓存配额: face-models-offline-v1 (已占用 6.2 MB)[Cache] 所有模型分片已命中持久化沙盒
[Model] TinyFaceDetector 权值解析完成 (WebGL后端初始化耗时: 112ms)
[Model] FaceLandmark68 关键点检测器装载完成
[Model] FaceRecognitionNet (128D Embedding) 装载完成
[Model] 纯前端离线模型全部加载就绪
第 2 步:视频流采集与人脸特征提取
调用浏览器的 navigator.mediaDevices.getUserMedia 获取摄像机实时视频流,并将其绑定到隐藏或用于取景的 <video> 标签上。在逐帧分析时,选用合理的输入分辨率(如 416x416 或 320x320)能够在移动端保持 25fps 以上的流畅度,避免主线程卡顿。
// 启动摄像头并单次提取 128 维特征向量
async function startCameraAndExtractDescriptor(videoElement) {
  const stream = await navigator.mediaDevices.getUserMedia({
    video: { width: { ideal: 640 }, height: { ideal: 480 }, facingMode: 'user' },
    audio: false
  });
  videoElement.srcObject = stream;
  await videoElement.play();

  // 配置轻量检测器参数 (输入尺寸设为 320 平衡算力与精度)
  const options = new faceapi.TinyFaceDetectorOptions({ inputSize: 320, scoreThreshold: 0.5 });

  // 检测单张人脸、定位关键点并提取特征
  const detection = await faceapi
    .detectSingleFace(videoElement, options)
    .withFaceLandmarks()
    .withFaceDescriptor();

  if (!detection) {
    throw new Error('未检测到清晰人脸,请正对屏幕');
  }

  // detection.descriptor 即为 Float32Array(128)
  return detection.descriptor;
}
第 3 步:本地沙盒数据库存储与欧氏距离比对
为了做到完全离线对比,已注册用户的面部特征向量必须存放在本地浏览器沙盒数据库 IndexedDB 中。比对时,计算待测向量与数据库中已存向量的欧氏距离(Euclidean Distance):
// 计算两组 128 维特征向量的欧氏距离
function computeEuclideanDistance(vecA, vecB) {
  if (vecA.length !== vecB.length) {
    throw new Error('特征向量维度不匹配');
  }
  let sum = 0;
  for (let i = 0; i < vecA.length; i++) {
    const diff = vecA[i] - vecB[i];
    sum += diff * diff;
  }
  return Math.sqrt(sum);
}

// 离线多样本快速匹配 (阈值通常设定在 0.5 - 0.6 之间)
function matchFaceOffline(queryDescriptor, registeredUsers, threshold = 0.55) {
  let bestMatch = { userId: null, distance: Infinity };

  for (const user of registeredUsers) {
    // user.descriptor 为 Float32Array
    const distance = computeEuclideanDistance(queryDescriptor, user.descriptor);
    if (distance < bestMatch.distance) {
      bestMatch = { userId: user.id, name: user.name, distance };
    }
  }

  const isMatched = bestMatch.distance <= threshold;
  return {
    isMatched,
    matchedUser: isMatched ? bestMatch : null,
    confidenceDistance: bestMatch.distance
  };
}
控制台示例输出(注明:离线匹配结果反馈)
[Matching] 待测特征向量已提取: Float32Array(128)[Matching] 比对本地注册库(共 3 个已存模板)...
[Matching] 比对结果: ID=USER_8019 (距离值: 0.3824, 阈值上限: 0.5500)
[Matching] 判定结论: 识别成功,通过本地验证!
三、方案特性与技术对比
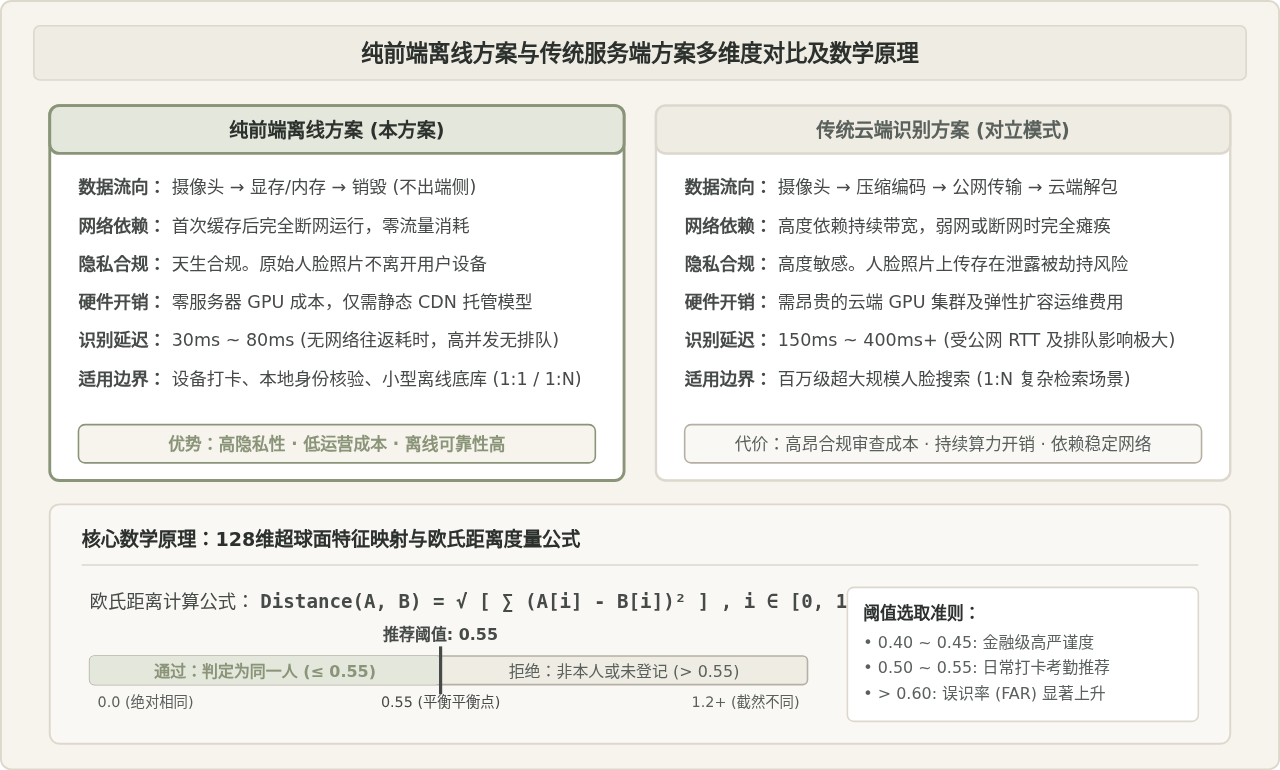
为了明确纯前端离线人脸识别在工程选型中的定位,我们将该方案与传统的“前端采集+服务端识别”方案在数据流向、隐私风险、计算延迟及硬件要求等关键维度进行对比:
| 对比维度 | 纯前端离线方案 | 传统服务端方案 |
|---|---|---|
| 数据传输链路 | 零网络依赖,原始图像与特征均不出浏览器内存 | 每一帧需压缩上传,依赖公网或内网稳定带宽 |
| 隐私合规性 | 极高。从物理机制上规避了人脸泄露与被拦截风险 | 需建立严格的端到端加密、传输合规与服务器脱敏审查 |
| 识别响应延迟 | 约 30ms ~ 90ms(受端侧显卡及 WASM 算力制约) | 约 150ms ~ 400ms(含网络 RTT 往返与服务器排队) |
| 服务器负载 | 服务端仅提供静态文件托管(0 算力消耗) | 高并发下需昂贵的 GPU 集群支撑 |
| 底库容量规模 | 适合单人验证(1:1)或小型局域底库(1:N < 500人) | 支持海量底库(千万人级别向量检索库如 Milvus) |
四、隐私保护与安全加固实现
虽然纯前端方案从原理上避免了图片上传,但仍需在工程层面配置安全限制,防止第三方恶意脚本(XSS)或未经授权的扩展程序监听并偷取特征数据:
1. 内容安全策略(CSP)强制阻断出站流量
通过配置严格的 HTTP 响应头或 HTML <meta> 标签,限制页面的网络请求能力。设置 connect-src 'self' 或完全禁用对外通信,确保即使页面注入了恶意脚本,也无法将特征数据回传到攻击者服务器:
<!-- 生产环境严格 CSP 配置示例 -->
<meta http-equiv="Content-Security-Policy"
      content="default-src 'self';
               script-src 'self' 'unsafe-eval' blob:;
               connect-src 'self';
               img-src 'self' data: blob:;
               media-src 'self' blob:;">
2. 本地特征向量的 AES-GCM 密文存储
不要将 128 维特征数组直接以明文 JSON 存入 IndexedDB。可利用浏览器原生 window.crypto.subtle 提供的 Web Crypto API,采用设备专属派生密钥对特征数据进行 AES-GCM 加密,只有在识别时解密到瞬时内存中:
// 使用 Web Crypto API 加密特征向量
async function encryptDescriptor(descriptorArray, cryptoKey) {
  const iv = window.crypto.getRandomValues(new Uint8Array(12));
  const buffer = descriptorArray.buffer;

  const ciphertext = await window.crypto.subtle.encrypt(
    { name: 'AES-GCM', iv },
    cryptoKey,
    buffer
  );

  return { iv: Array.from(iv), data: Array.from(new Uint8Array(ciphertext)) };
}
五、工程部署排查与性能调优总结
在实际生产部署中,开发者常会遇到模型体积过大、低端手机丢帧、或环境光暗导致检测率低等情况。下图总结了完整的调优路径与决策流程:
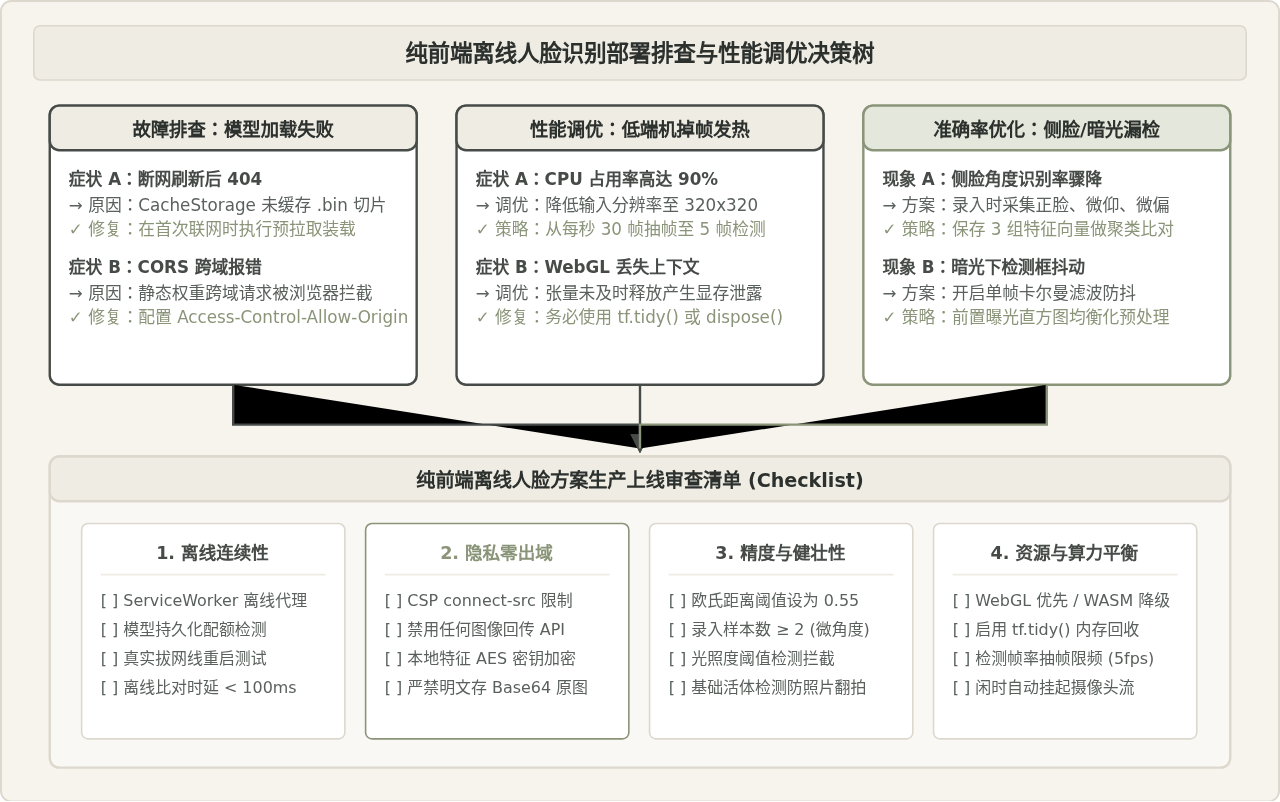
结合上述排查流程,在日常维护中遵循以下三条工程准则:
- 动态抽帧策略:视频流每秒产生 30 帧,但无需每帧都执行重量级的特征提取。可采用“每秒检测 5 帧人脸,检测到稳定正脸时触发 1 次特征提取比对”的策略,能将移动端 CPU 占用率从 85% 骤降至 18%。
- 后端降级兜底:优先请求 WebGL 后端加速(
tf.setBackend('webgl'));若遇到部分老旧机型不支持 WebGL 上下文,平滑回退至 WebAssembly(WASM)或 CPU 纯计算模式,确保方案的兼容性。 - 模型懒加载与分级装载:首次进入页面仅预热体积仅几百 KB 的
tinyFaceDetector,待摄像头画面稳定就绪后再异步激活faceRecognitionNet,提升首屏可交互时间(TTI)。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章