

本文深入解析AI音乐生成的底层技术逻辑,对比自回归Transformer与扩散模型两条主流算法路线。文章阐述了音频压缩表示的重要性,分析了提示词控制的局限性及长曲生成的结构挑战,旨在帮助读者建立准确的技术认知,避免对未公开产品架构的过度推断。
AI音乐生成原理:从Transformer到扩散模型的技术解析
作者:模型喵
时间:2026-11-07
浏览:409
文章目录
若将 AI 音乐生成简化为“模型听懂指令后直接作曲”,便难以解释其如何维持音色、节奏与段落的连贯性。更务实的理解路径是:系统首先将文本或旋律提示转化为条件信号,随后在适宜建模的音频表示空间中生成内容,最终通过解码还原为可播放的声波。
从 Transformer 到扩散模型,核心差异在于生成推进机制:前者如同逐个预测后续符号,后者则从噪声出发反复修正整体形态。厘清这两条技术路线,有助于理解提示词的控制边界、长曲目生成的难点,以及不同模型架构背后的权衡取舍。
音频先变成模型能处理的表示
数字音频本质上是高频采样值序列。若让模型直接逐点预测采样值,序列长度将极其庞大,导致计算成本高昂。因此,多数系统先利用音频编码器对声音进行压缩,将复杂波形转换为较短的离散 Token 序列或连续潜在表示;生成完成后,再由解码器将这些表示还原为波形。
这一过程类似于视频编码:模型学习压缩表示中的结构特征,而解码器负责恢复可听声音。更高的压缩率通常有助于减轻序列建模负担,但若表示层丢失细节,最终音质及细微演奏变化也会受损。因此,编码器与解码器并非外围组件,而是决定生成质量的关键环节。
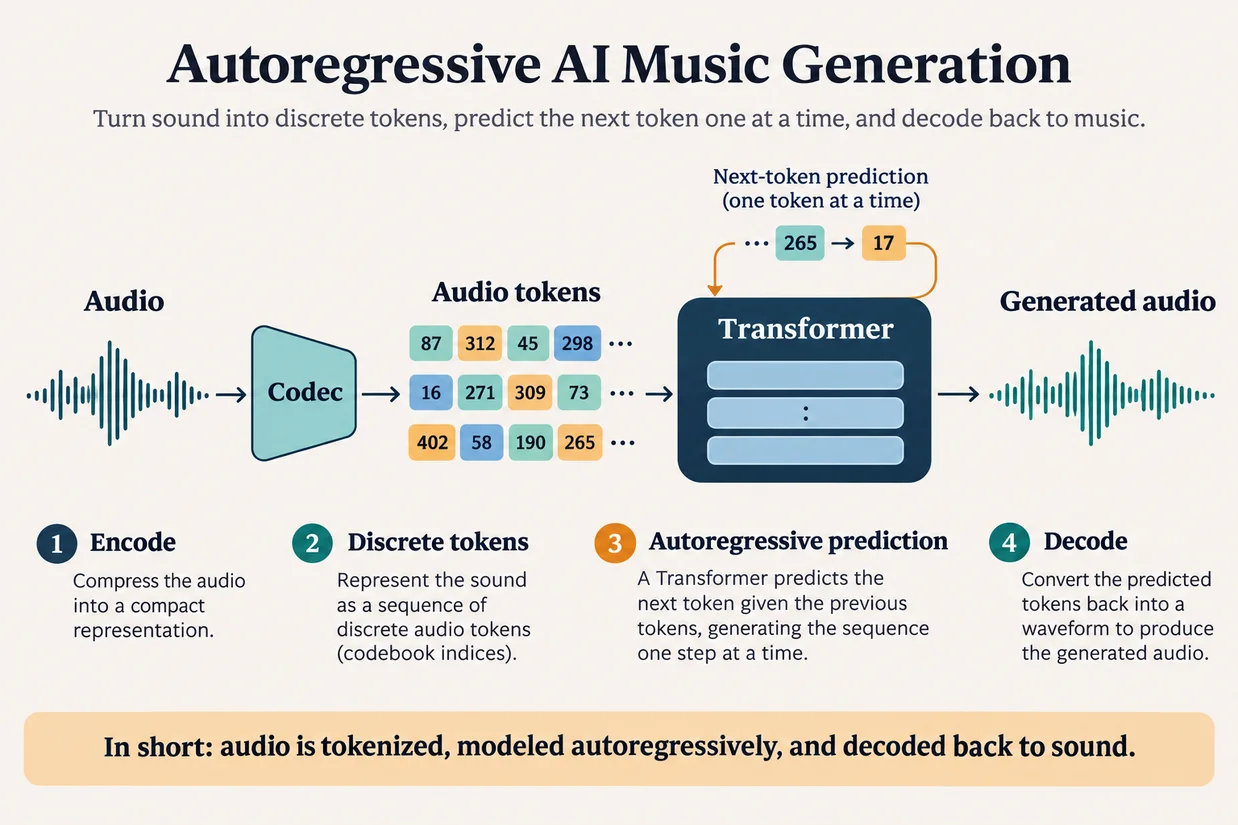
自回归音乐生成的压缩表示与逐步预测流程
Transformer 路线:逐步预测下一个 token
自回归 Transformer 将音乐 Token 视为有序序列。在给定文本条件及已生成 Token 的基础上,模型预测下一个 Token;新 Token 并入上下文后,继续预测后续内容。该过程与语言模型续写文本类似,区别在于预测单元是压缩后的音乐表示,而非汉字或单词。
例如,针对“轻快爵士钢琴伴柔和鼓点”的提示,文本编码器将其转化为条件向量。音乐模型据此逐步生成 Token 序列,再由音频解码器还原为声音。以 MusicGen 为例,其在 EnCodec 压缩出的多路离散音频 Token 流上应用单阶段语言模型,支持文本或旋律条件。需注意,“像续写”仅为生成机制的比喻,并非模型先谱写乐谱再演奏。
逐个预测的优势在于顺序明确,且便于融入既有旋律或条件信息;但其代价是生成长序列时,后续内容高度依赖前文,推理过程通常需串行执行。若早期生成的结构存在偏差,后续内容可能沿此错误方向延续。
扩散路线:从噪声逐轮形成声音结构
扩散模型采用不同的起点。训练阶段,模型学习如何将逐渐加噪的音频表示还原;生成阶段,则从随机噪声开始,在文本等条件引导下多次预测并去除噪声。每一轮迭代都使潜在表示更贴近目标声音,最后由解码器还原音频。AudioLDM 等研究已将潜在扩散框架应用于文本到音频及音乐生成任务。
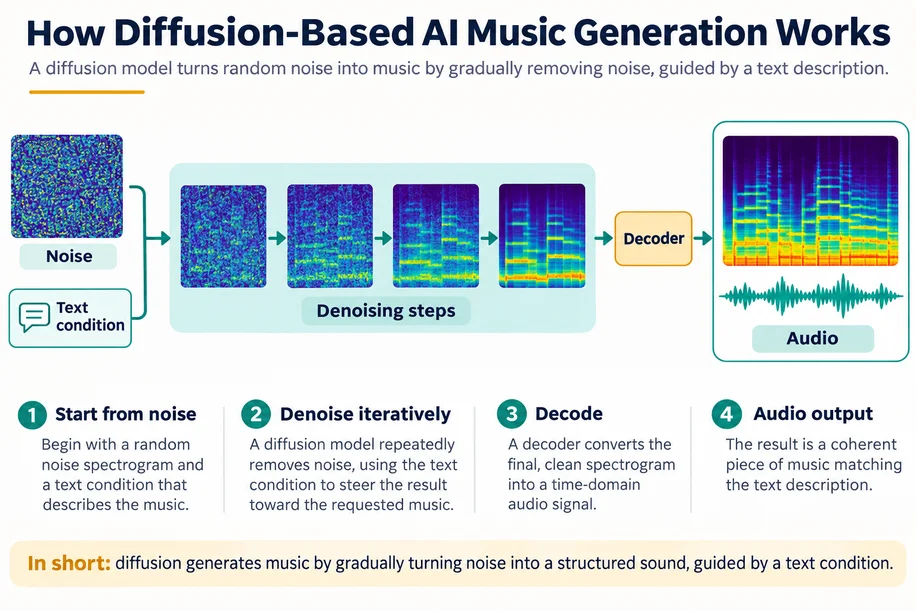
扩散模型逐轮去噪形成音频表示
可将此过程比喻为从模糊底稿中逐步修整出声音结构,但实际系统处理的是模型空间内的表示,而非视觉图像。由于每轮迭代均更新整体表示,扩散路线能在多步中逐步构建完整的声学纹理;然而,多轮去噪也带来了采样计算开销,最终效果受表示方式、条件编码及采样策略共同影响。
两条路线的差别不等于“谁更会作曲”
自回归方法的核心是按序采样,扩散方法的核心则是从噪声迭代去噪。前者生成路径可理解为“基于前文预测后文”,后者则每轮修正当前整体表示。两者均接收文本条件,且依赖音频表示与解码过程,因此不能仅凭模型名称断定其成品必然更连贯、音质更佳或更符合提示词。
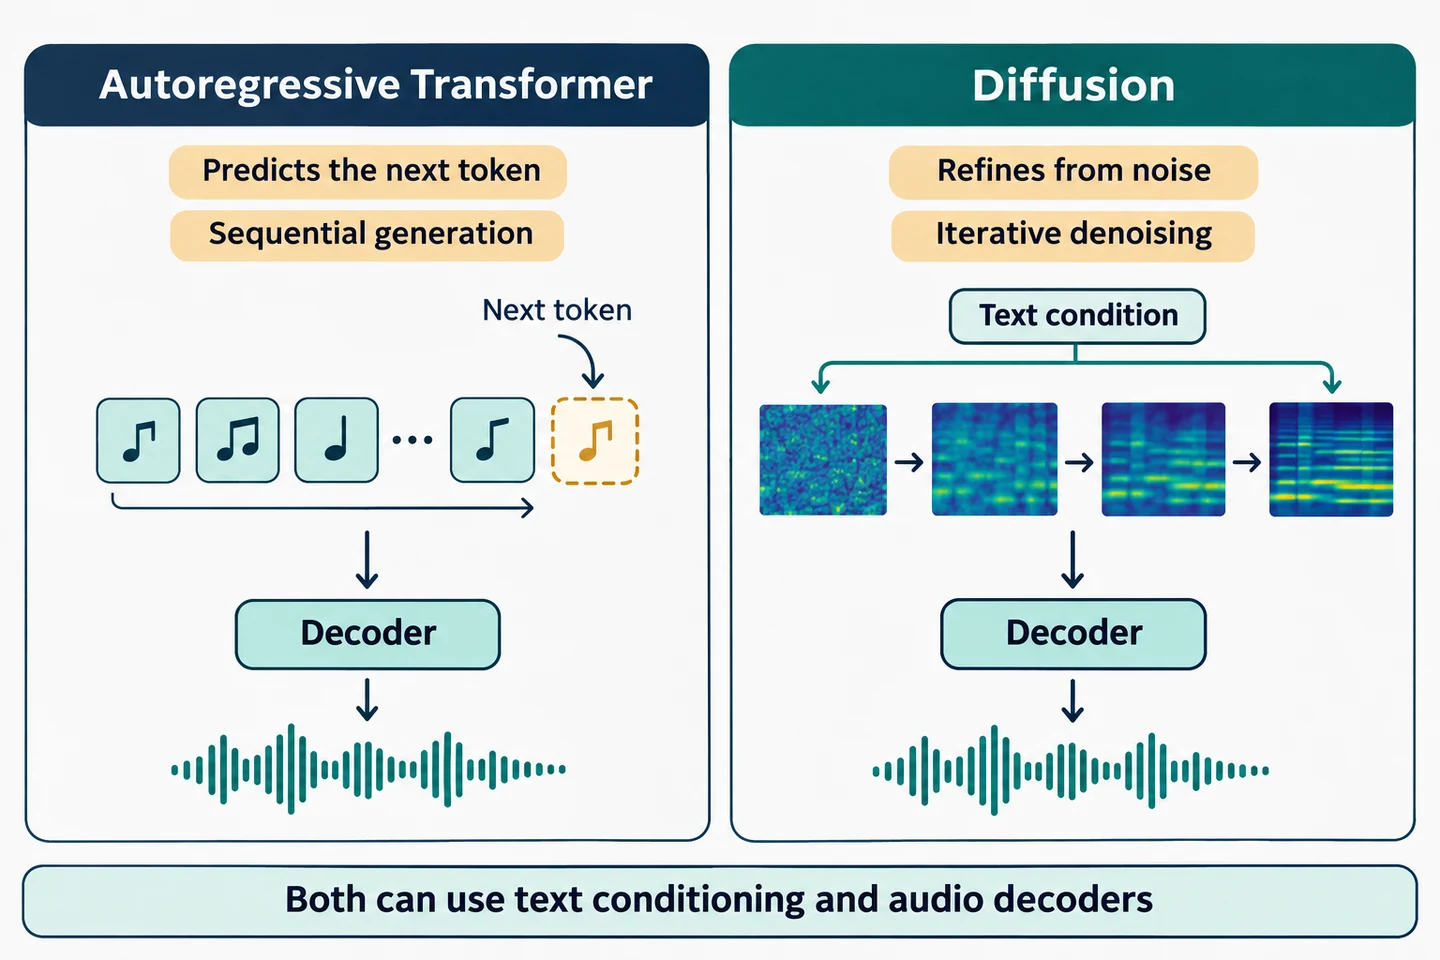
自回归预测与扩散去噪的生成方式对比
此外,论文中的代表系统仅展示特定技术方案,并非所有产品的内部架构说明书。实际服务可能组合文本编码器、音频 Tokenizer、Transformer、扩散模块或其他组件。若缺乏产品方公开的技术细节,不应仅凭听感臆断其采用的算法类型。
为什么提示词不总能精确控制结果
文本条件提供的是生成方向,而非逐音符的硬性指令。“慢速、温暖、弦乐主导”描述了风格与大致编制,但模型仍需将自然语言映射至训练习得的声学特征。诸如“副歌前停两拍,随后加入三声部和声”的要求涉及时间位置、结构与声部关系,其实现准确度取决于训练数据、条件表示及架构设计。
若模型支持旋律输入、节拍条件或分段编辑,这些额外条件可缩小自由生成的范围。然而,条件越具体并不意味着结果必然严格服从;评估时应分别审视节奏、音色、段落衔接及指定元素,避免仅用一句“像不像”进行概括。
长曲连贯性是多层次问题
音乐同时包含短时的音色与节奏细节,以及长时的主题变化、段落重复和高潮安排。即使音频 Token 序列能表达局部连续性,也不自动保证整曲结构合理。模型需在较长范围内保持主题、变化与段落关系;序列过长会增加建模难度,而分段生成则需解决片段间的衔接问题。
因此,短片段听感顺畅并不能直接证明模型已掌握完整歌曲结构。研究者虽尝试通过层级表示、长上下文建模或分段生成等思路处理长时结构,但不同方法在连贯度、可控性与计算成本之间仍存在权衡。
什么时候该用哪种解释框架
若关注音乐 Token 随时间的展开,可采用自回归 Transformer 的“逐步预测”框架理解;若关注潜在表示如何从随机状态演变为结构化形态,则适用扩散模型的“迭代去噪”框架。现实系统常将文本理解、音频压缩、生成和解码拆分为多个环节,不可将整个流程简化为单一算法标签。
评估 AI 音乐工具时,应重点关注其公开的输入条件类型、局部结果编辑能力、生成长度与段落是否符合需求,以及输出是否保留目标音色和节奏。技术路线解释了模型组织生成过程的方式,但不会单独决定作品的审美价值。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章