
深入详解 JavaScript String 对象的常用内置方法,涵盖检索判断、切片截取、文本替换、格式对齐与清洗拆分的机制原理、代码示例及核心避坑指南。

当前位置:首页 > JavaScript 基础 > 正文
JavaScript String对象常用内置方法详解
作者:半夏
时间:2026-11-22
浏览:190
文章目录
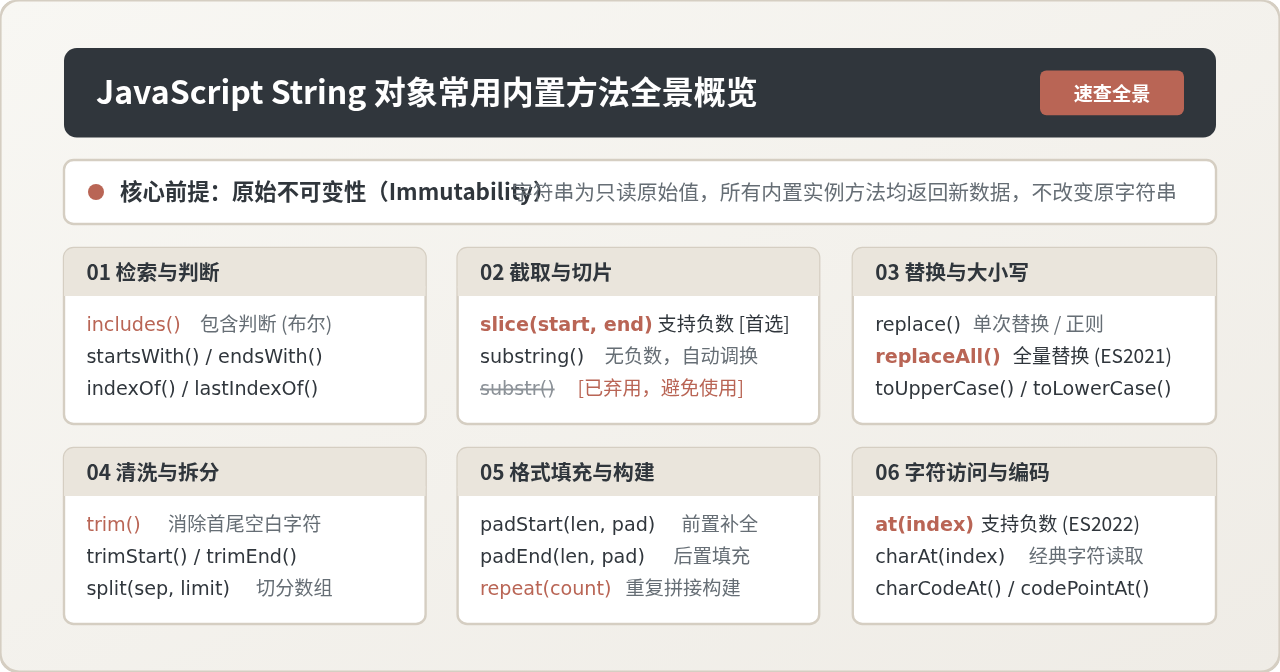
JavaScript 中的字符串(String)是不可变(immutable)的原始数据类型,所有对字符串调用的内置实例方法均不会修改原字符串,而是返回一个全新的字符串或相应数据。熟练掌握常用字符串方法不仅能减少冗余的正则与条件逻辑,还能有效规避因参数处理机制差异引发的隐式 Bug。本文将系统归纳 JavaScript 字符串在检索判断、文本截取、替换转换、清洗分割、对齐填充等核心场景下的常用内置方法,通过机制拆解、对比分析与完整代码示例,梳理其用法、边界条件与最佳选型依据。
一、字符串的核心特性与索引访问模型
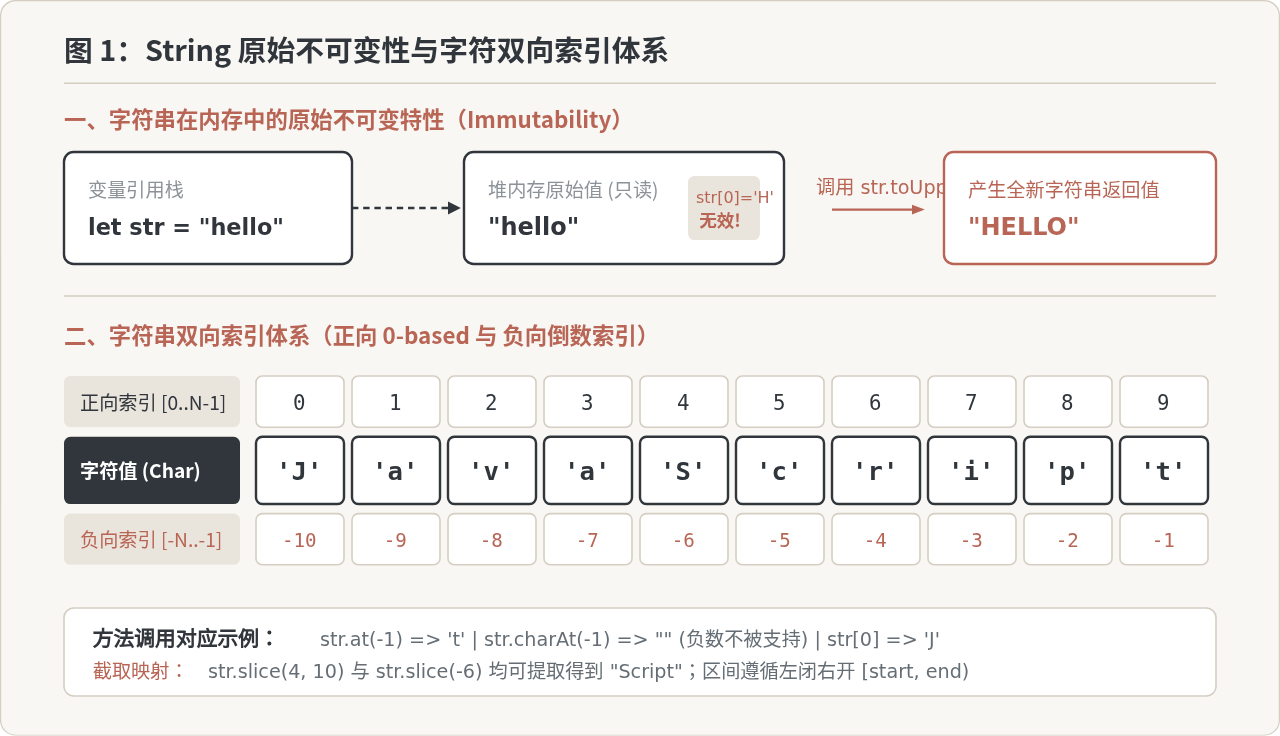
理解 JavaScript 字符串所有内置方法的前提,是明确字符串在内存中的原始不可变特性。在 JavaScript 中,一旦字符串原始值被创建,该内存区域的内容便无法被原位修改。任何试图修改特定字符的操作(例如 str[0] = 'H')在非严格模式下都会静默失败,在严格模式下则会直接抛出 TypeError。
let origin = "javascript";
origin[0] = "J"; // 无法原位更改
console.log(origin); // 示例输出: "javascript"

let upper = origin.toUpperCase();
console.log(origin); // 示例输出: "javascript"(原字符串保持不变)
console.log(upper);  // 示例输出: "JAVASCRIPT"(返回全新字符串)
在字符访问方面,JavaScript 提供了三种主要方式:下标访问符 str[i]、经典方法 charAt(i),以及 ECMAScript 2022(ES13)引入的 at(i)。它们的关键差异集中在对负数索引的处理上:
str[index]:只接受正向索引,索引越界或传入负数时返回undefined。str.charAt(index):只接受非负索引,越界或传入负数时均返回空字符串""。str.at(index):原生支持负数索引,例如-1表示最后一个字符,越界时返回undefined。相比旧式str[str.length - 1],代码更简洁优雅。
二、子串检索与位置判断方法
在日常业务开发中,判断字符串是否包含某些关键词、是否以特定协议开头,是最常见的需求。JavaScript 提供了语义直观的布尔判断方法与位置索引方法。
1. 包含性判断:includes()
includes(searchString, position) 用于检测当前字符串是否包含指定的子字符串,返回布尔值。可选参数 position 表示开始检索的索引位置(默认值为 0)。
const url = "https://api.example.com/v1/users";

console.log(url.includes("api"));       // 示例输出: true
console.log(url.includes("https", 5)); // 示例输出: false(从索引 5 开始查找)最佳实践:当仅需确认某个子串是否存在,而不需要知道其具体出现的索引位置时,必须优先使用 includes(),切忌使用过时的 indexOf() !== -1,后者的语义表达模糊且容易出现将 0 误判为假值的逻辑漏洞。
2. 前缀与后缀校验:startsWith() 与 endsWith()
startsWith(searchString, position) 与 endsWith(searchString, endPosition) 分别用于校验字符串是否以指定子串开始或结束,均返回布尔值。
startsWith("https://")常用于协议检测、路由前缀匹配。其第二个参数position表示从何处开始判定(默认0)。endsWith(".json")常用于文件扩展名校验。注意其第二个参数endPosition表示检索区间的结束点(默认长度为str.length),而非起始点。
const filename = "avatar_2026.png";

console.log(filename.startsWith("avatar")); // 示例输出: true
console.log(filename.endsWith(".png"));     // 示例输出: true
console.log(filename.endsWith("avatar", 6));// 示例输出: true(前 6 个字符截面是否以 avatar 结尾)
3. 位置检索:indexOf() 与 lastIndexOf()
当需要精确定位子串在原字符串中的起始偏移量时,使用 indexOf(searchString, position) 或从后往前检索的 lastIndexOf()。若找到则返回首个匹配字符的非负索引(从 0 开始),未找到则返回 -1。两者均为大小写敏感。
const text = "system_config_system";

console.log(text.indexOf("system"));     // 示例输出: 0
console.log(text.lastIndexOf("system")); // 示例输出: 14
console.log(text.indexOf("none"));       // 示例输出: -1
三、子串截取与切片:slice、substring 与 substr 深度对比
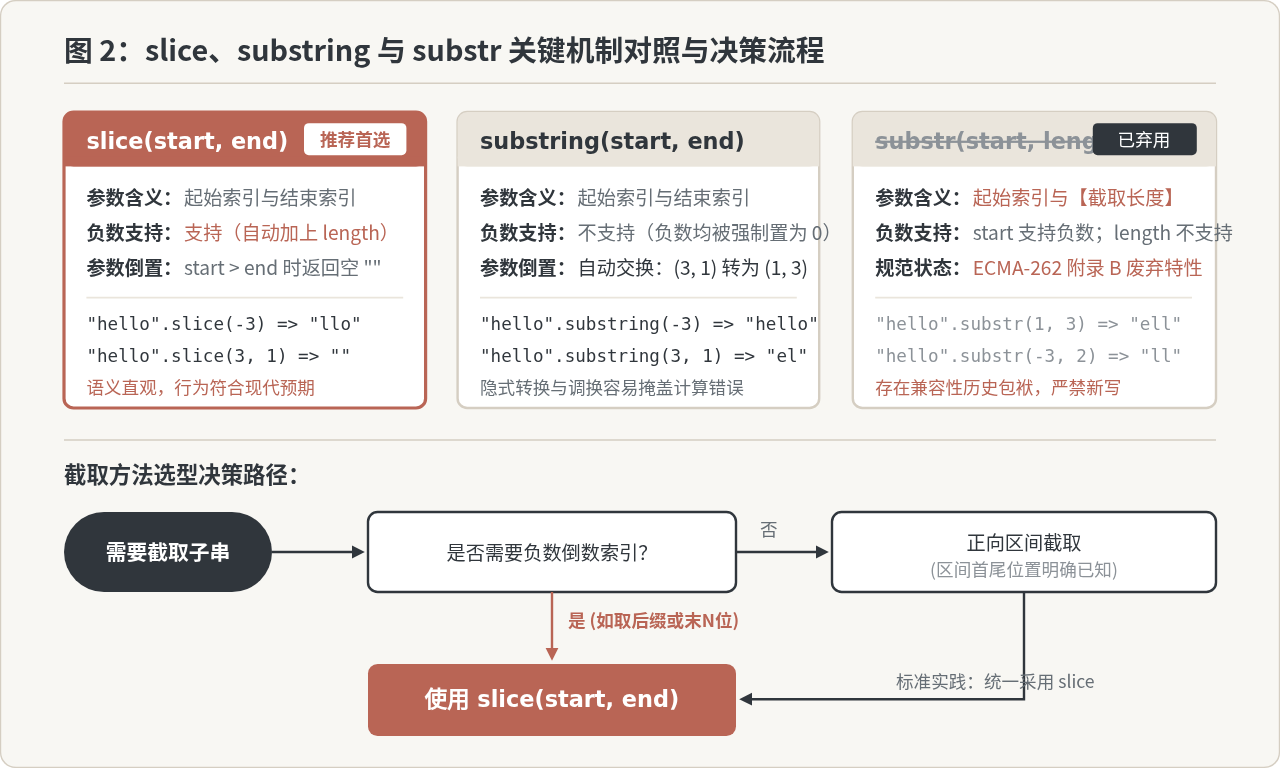
截取字符串是 JavaScript 中极易混淆的模块,原因在于历史上存在 slice()、substring() 以及已被废弃的 substr() 三个名称相近但机制大相径庭的方法。
1. 现代标杆:slice(start, end)
slice() 提取从 start 索引开始到 end 索引结束的子字符串,遵循数学上的“左闭右开”区间 [start, end),即包含 start 但不包含 end。省略 end 时直接截取到字符串末尾。
slice() 最强大的特性在于完整支持负数索引。当参数为负数时,其内部计算公式为 start + length,即从末尾倒数计算。如果 start > end,slice() 不会进行任何调换,直接返回空字符串 ""。
const str = "Hello, World!";

console.log(str.slice(7, 12));  // 示例输出: "World"
console.log(str.slice(-6, -1)); // 示例输出: "World"(倒数第 6 位至倒数第 1 位)
console.log(str.slice(-6));     // 示例输出: "World!"(倒数第 6 位至末尾)
console.log(str.slice(5, 2));   // 示例输出: ""(start > end 返回空)
2. 历史机制:substring(start, end)
substring() 同样接收起始和结束索引,但其行为存在两个特殊规则:
- 不支持负数:任何小于 0 的数值或 NaN 都会被强制当成
0处理。 - 自动参数调换:若
start > end,它会自动将较小的值作为起点,较大的值作为终点。例如substring(5, 2)等价于substring(2, 5)。
const sample = "JavaScript";

console.log(sample.substring(-3));    // 示例输出: "JavaScript"(-3 强制被视为 0)
console.log(sample.substring(4, 0));    // 示例输出: "Java"(自动调换为 0 到 4)
3. 已弃用方法:substr(start, length)
重要警告:
String.prototype.substr() 已在 ECMAScript 规范中被正式标记为废弃(Annex B 遗留特性)。它的第二个参数不是结束索引,而是截取长度。由于历史遗留实现各异且缺乏未来演进支持,现代项目中严禁新建使用。
| 方法名称 | 参数语义 | 负数参数处理 | start > end 行为 | 推荐指数 |
|---|---|---|---|---|
slice(start, end) |
[起始索引, 结束索引) | 支持负数(倒数换算) | 返回空字符串 "" |
★★★★★(强烈推荐首选) |
substring(start, end) |
[起始索引, 结束索引) | 负数强制转为 0 |
自动对调两参数位置 | ★★★☆☆(容易掩盖逻辑错误) |
substr(start, length) |
[起始索引, 截取长度] | start 支持负数,length 负数为 0 | 不适用(参数非同一维度) | ★☆☆☆☆(规范已废弃,避免使用) |
四、文本替换与清洗方法
在用户表单交互与接口数据清洗场景中,去除多余空白字符和替换敏感词是核心环节。
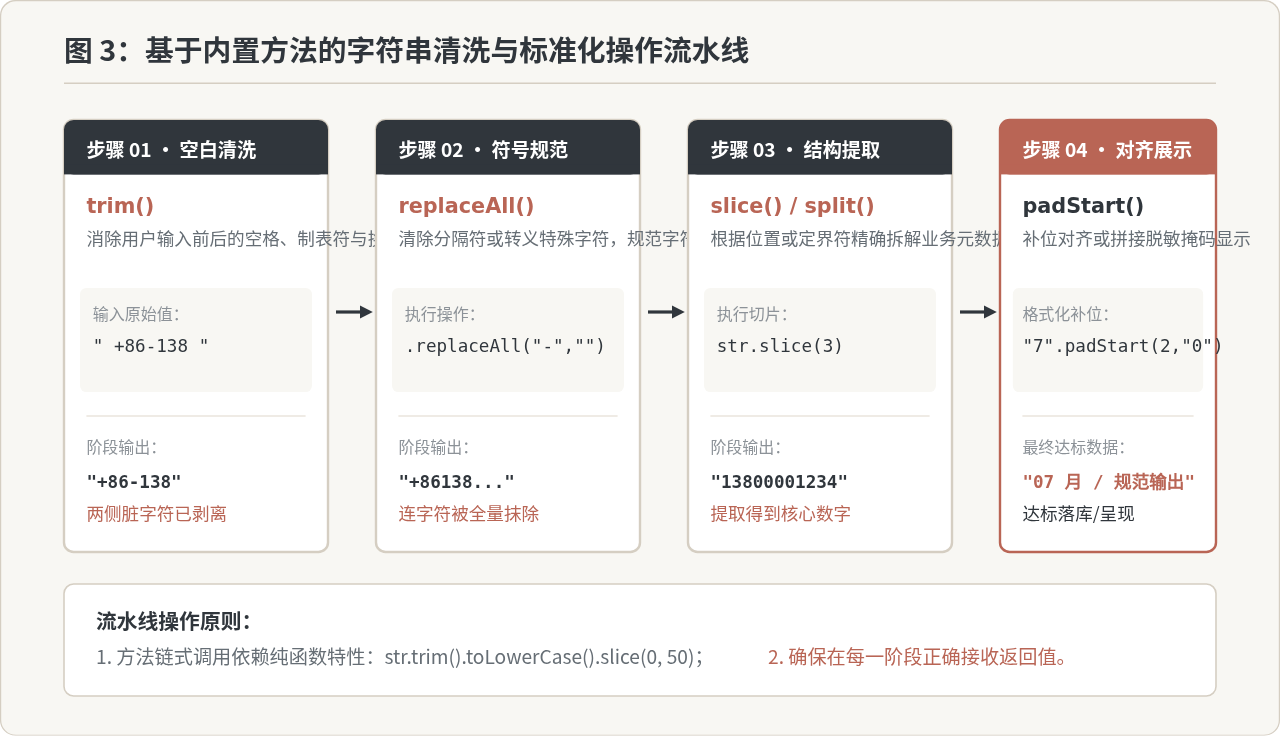
1. 空白字符修剪:trim()、trimStart() 与 trimEnd()
trim() 会清除字符串两端的所有空格、Tab 制表符( )以及换行符(
、 )。原字符串中的内部空格不会受到影响。如果仅需清理单侧,可选用 trimStart()(别名 trimLeft())或 trimEnd()(别名 trimRight())。
const rawInput = "   admin@corp.internal
	 ";
const cleanEmail = rawInput.trim();

console.log(cleanEmail); // 示例输出: "admin@corp.internal"
2. 内容替换:replace() vs replaceAll()
这是 JavaScript 初学者极易踩坑的地方。replace(pattern, replacement) 在传入普通字符串作为匹配模式时,仅会替换首次出现的匹配项。
const dateStr = "2026-11-16";

// 陷阱:仅替换了第一个连字符
console.log(dateStr.replace("-", "/"));
// 示例输出: "2026/11-16"

// 正确做法 1: 使用正则表达式并显式添加 /g 全局标志
console.log(dateStr.replace(/-/g, "/"));
// 示例输出: "2026/11/16"

// 正确做法 2: 使用 ES2021 引入的 replaceAll()
console.log(dateStr.replaceAll("-", "/"));
// 示例输出: "2026/11/16"
replaceAll() 正则限制:如果向
replaceAll() 传入正则表达式,该正则表达式必须携带全局标志 /g。如果未携带 /g(例如 str.replaceAll(/\d/, "X")),JavaScript 引擎将直接抛出 TypeError: String.prototype.replaceAll called with a non-global RegExp。
五、拆分、补全与重复构建方法
1. 字符串分割:split()
split(separator, limit) 接收一个分隔符(字符串或正则表达式),将原字符串分割为一个包含子字符串的数组。可选的 limit 限制返回数组的最大元素数量。
const tags = "javascript,web,frontend,node";
const tagList = tags.split(",", 2);

console.log(tagList); // 示例输出: ["javascript", "web"]
Unicode 避坑提醒:很多开发者习惯使用 str.split('') 来把字符串逐字拆分为单字符数组。当字符串中包含超出 BMP(基本多文种平面)的 UTF-16 代理对(如 Emoji "👋"、某些汉字生僻字)时,split('') 会将 4 字节字符拆碎成两个非法的乱码代理单元。推荐改用扩展运算符 [...str] 或 Array.from(str),它们原生基于 Code Point(码点)迭代,能够正确保留复杂字符。
const greeting = "Hi👋";

console.log(greeting.split("")); // 示例输出: ["H", "i", "\uD83D", "\uDC4B"](代理对断裂)
console.log([...greeting]);      // 示例输出: ["H", "i", "👋"](完整识别)
2. 定长补全:padStart() 与 padEnd()
ECMAScript 2017 引入的 padStart(targetLength, padString) 与 padEnd(targetLength, padString) 解决了长久以来格式化对齐需手写循环的痛点。如果当前字符串长度小于 targetLength,则在头部或尾部使用 padString(默认为空格)重复填充直至达到指定长度。
// 典型场景 1: 日期与时间补零
const month = "5";
console.log(month.padStart(2, "0")); // 示例输出: "05"

// 典型场景 2: 掩码卡号展示
const rawCard = "6222021234567890";
const lastFour = rawCard.slice(-4);
const masked = lastFour.padStart(rawCard.length, "*");
console.log(masked); // 示例输出: "************7890"
3. 重复构建:repeat()
repeat(count) 返回将原字符串重复拼接 count 次的新字符串。参数 count 必须为非负整数,传入负数或正无穷大会抛出 RangeError。
const divider = "-".repeat(20);
console.log(divider); // 示例输出: "--------------------"
六、常用内置方法速查与避坑决策
为了在实际编码中快速选择最合理的 API 并规避潜在隐患,下表梳理了高频场景下的对应法则与注意事项:
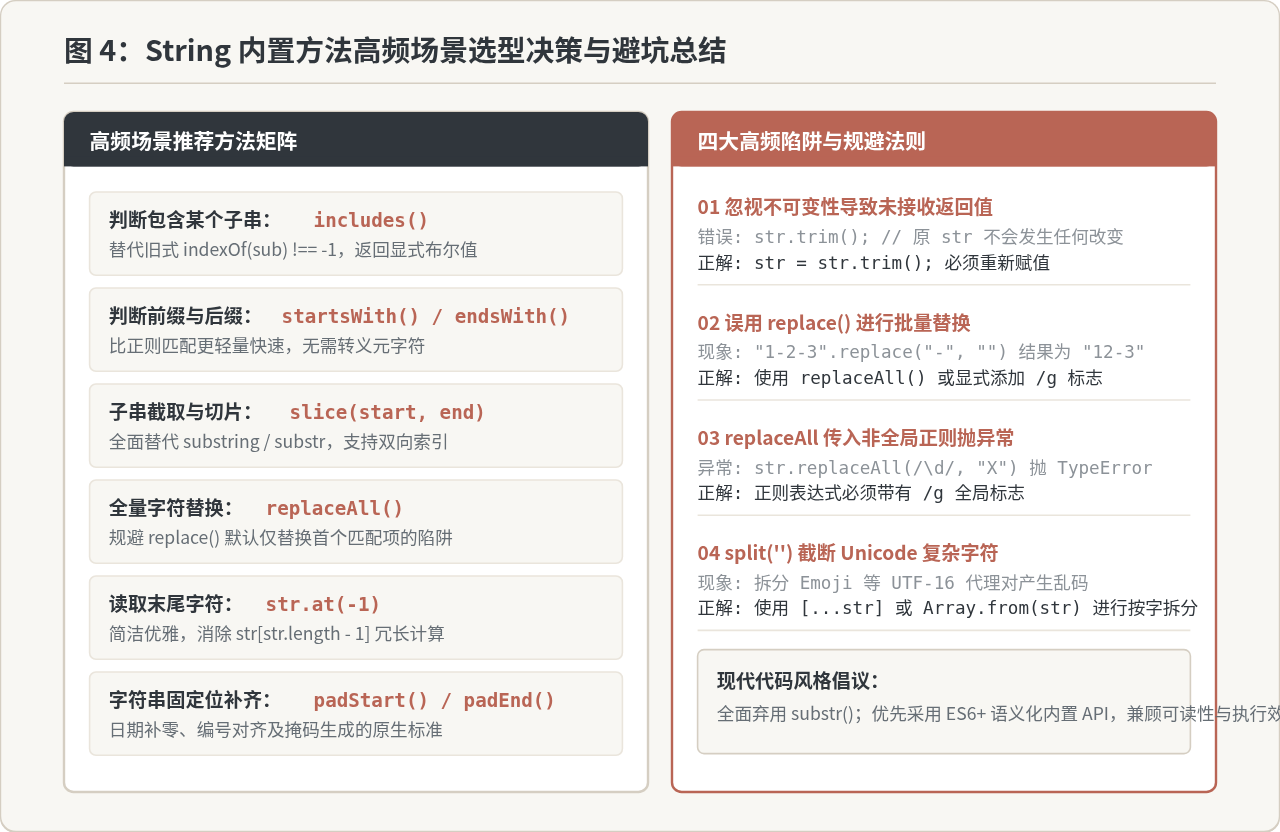
- 牢记不可变性:永远通过赋值接收方法返回值(
str = str.trim()),切勿在调用方法后直接读取原变量。 - 淘汰历史包袱:在新代码中完全移除
substr();截取统一优先采用slice()。 - 语义化优于正则:简单的包含或前后缀检测,优先使用
includes()、startsWith()、endsWith(),执行速度更快且无需对正则特殊符号进行转义。 - 全量替换谨慎选择:进行批量全局替换时,推荐直接使用
replaceAll();若配合正则使用,必须确保带有/g标志。 - Emoji 字符安全分割:处理含有表情符号或特殊语言字符时,使用
[...str]替代str.split('')。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章