
全面解析在JavaScript中将字符串拆分为单个字符数组的四种核心方案。深入对比str.split('')、展开运算符[...str]、Array.from()以及Intl.Segmenter在处理ASCII、生僻字代理对和复合Emoji表情时的差异与底层原理。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JavaScript怎么将字符串拆分为单个字符数组
作者:半夏
时间:2026-11-21
浏览:473
文章目录
JavaScript 教程
字符编码
ECMAScript 原生方案
适合读者:前端开发者 / Node.js 工程师
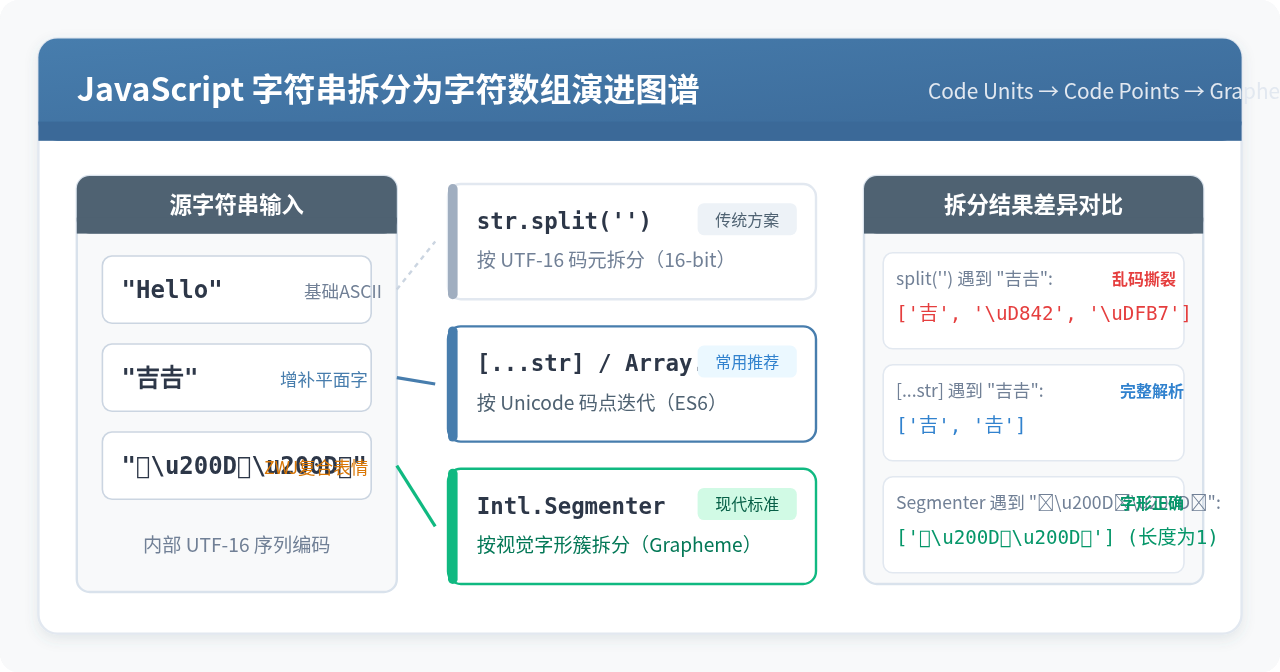
将字符串拆分为单个字符构成的数组,是 JavaScript 中处理文字倒序、逐字比对、字符筛选及动画特效的高频需求。常见手段包括
split('')、ES6 展开运算符 [...str]、Array.from(str) 以及现代标准 Intl.Segmenter。虽然表面上都能返回数组,但因为 JavaScript 内部统一采用 UTF-16 编码,若处理生僻字(代理对)或复杂的复合 Emoji 时,选用不当的方法会导致文字碎裂、乱码甚至不可预知的业务异常。
方法一:使用 String.prototype.split('')(传统基础方案)
在早期的 JavaScript 开发中,最直接、最广为人知的写法是调用字符串原生实例方法 split(''),传入空字符串作为分隔符。
// 基础示例:纯 ASCII 英文字符串
const message = "hello";
const chars = message.split('');
console.log(chars);
// 示例输出: ['h', 'e', 'l', 'l', 'o']
console.log(chars.length); // 示例输出: 5
对纯 ASCII 字符(如英文、数字、基本英标符号)或者位于基本多语言平面(BMP,码点范围在 U+0000 到 U+FFFF 内)的常用中文字符,split('') 能够正常工作:
const cnStr = "中国心";
const cnChars = cnStr.split('');
console.log(cnChars);
// 示例输出: ['中', '国', '心']
console.log(cnChars.length); // 示例输出: 3
重大缺陷警示:
split('') 是严格按照 16 位 UTF-16 码元(Code Unit) 切割的。任何超出基本平面的 Unicode 字符(例如生僻古籍汉字“𠮷”、常见 Emoji“😀”)在 UTF-16 中都需要用两个 16 位的“代理对”(Surrogate Pair)来表示。split('') 会粗暴地将高位代理与低位代理拆开,产生两个完全无法独立显示的乱码单元。
// 代理对拆分破损演示
const rareStr = "A𠮷B";
const brokenResult = rareStr.split('');

console.log(brokenResult);
// 示例输出: ['A', '\uD842', '\uDFB7', 'B']
// 其中的 '\uD842' 和 '\uDFB7' 是破碎的代理半区,单独打印为乱码或空白字符!
console.log(brokenResult.length); // 示例输出: 4 (原本只有 3 个字符!)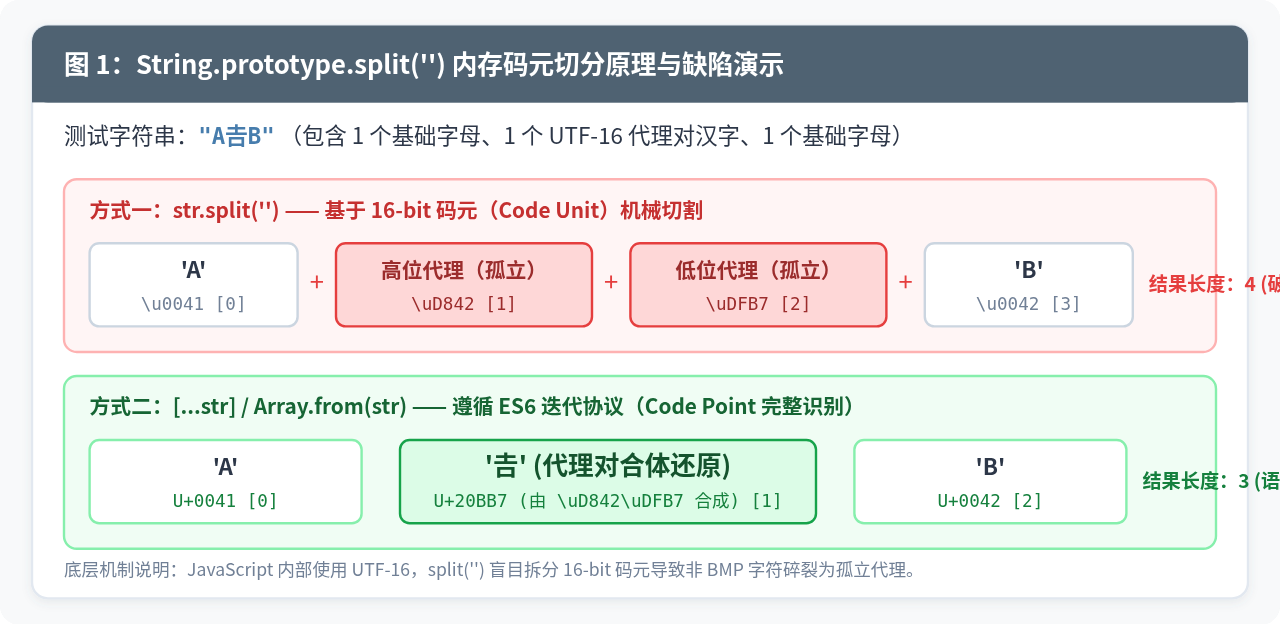
方法二:使用 ES6 展开运算符 [...str](通用推荐)
针对 split('') 破坏代理对的问题,ECMAScript 2015 (ES6) 引入了字符串迭代协议(String Iterator Protocol)。在 ES6 之后,最推荐的常规写法是使用展开运算符(Spread Operator)[...str]。
字符串在被展开时,底层会调用 String.prototype[Symbol.iterator],该迭代器以 Unicode 码点(Code Point) 为单位进行步进,能够自动识别两个 16 位的代理对并将其视为一个完整的字符元素。
// 使用展开运算符拆分
const text = "A𠮷B";
const safeChars = [...text];

console.log(safeChars);
// 示例输出: ['A', '𠮷', 'B']
console.log(safeChars.length); // 示例输出: 3 (完整保留生僻字,长度准确)

// 基础 Emoji 拆分
const emojiText = "Hi😊!";
const emojiList = [...emojiText];
console.log(emojiList);
// 示例输出: ['H', 'i', '😊', '!']
展开运算符语法非常简洁直观,在大多数现代 Web 前端以及 Node.js 开发中,如果涉及常规国际化文本或简单单码点 Emoji,[...str] 应当作为首选基础方案。
方法三:使用 Array.from(str)(拆分并伴随转换)
Array.from() 同样基于 ES6 字符串迭代协议,因此在处理 Unicode 代理对时的表现与 [...str] 完全一致。但 Array.from() 具备一个强大的额外优势:它允许传入第二个参数作为 mapFn 映射函数,在拆分字符的同时就地完成转换,避免先生成字符数组再调用 .map() 带来的二次内存分配开销。
// 基础用法:等价于 [...str]
const word = "你好𠮷世界";
const charArray = Array.from(word);
console.log(charArray);
// 示例输出: ['你', '好', '𠮷', '世', '界']

// 进阶用法:拆分的同时获取字符及其码点十六进制
const mapped = Array.from("A𠮷", char => ({
  char,
  codePoint: 'U+' + char.codePointAt(0).toString(16).toUpperCase()
}));

console.log(mapped);
// 示例输出:
// [
//   { char: 'A', codePoint: 'U+41' },
//   { char: '𠮷', codePoint: 'U+20BB7' }
// ]
Unicode 编码深水区:码元、码点与字形簇的本质差异
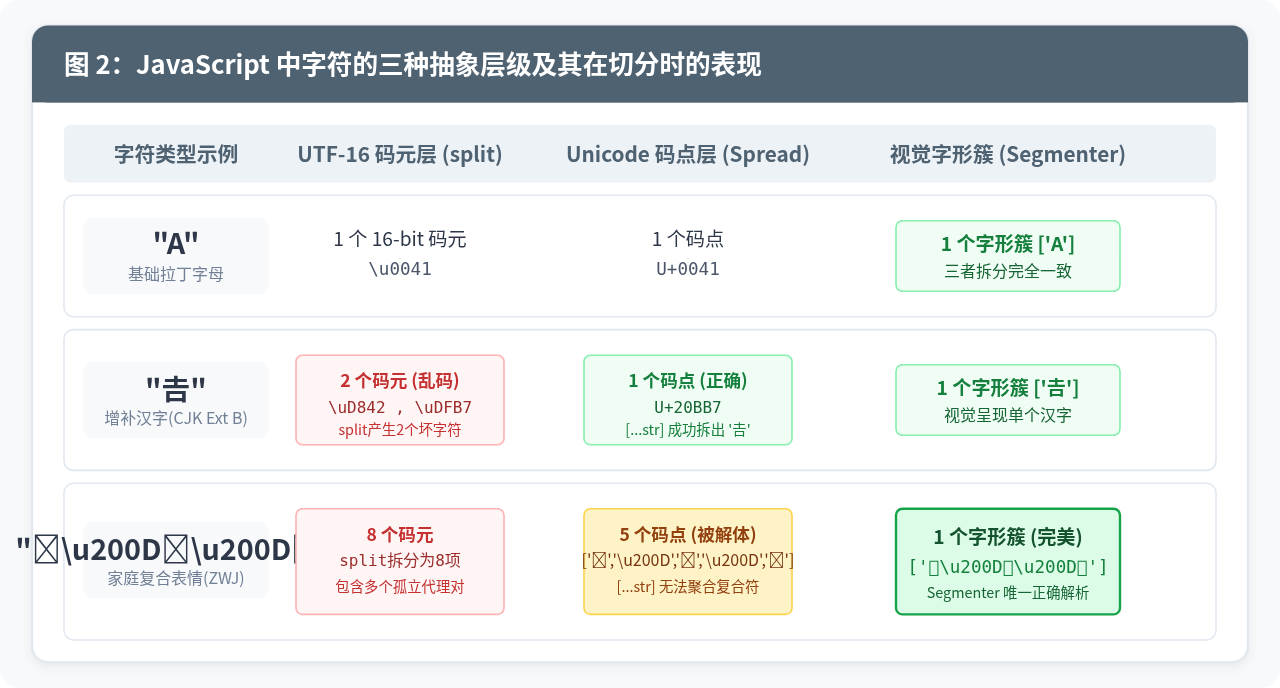
虽然 [...str] 和 Array.from() 能够完美处理生僻汉字与单码点符号,但是在现代即时通讯、富文本编辑及社交平台中,我们经常遇到复合 Emoji 与音调修饰符。这就引出了 JavaScript 字符表示的三个不同层次:
- UTF-16 码元(Code Unit):内存中的 16 位二进制块。
str.length和str.split('')就是依据此层级计数的。 - Unicode 码点(Code Point):Unicode 标准为世界上每一个字符分配的唯一序号(如
U+0041、U+20BB7)。[...str]和Array.from()遵循这一层级。 - 用户感知字形簇(Grapheme Cluster):人类视觉上感知到的“单个书写符号”。许多现代字符在视觉上是单字,但在 Unicode 中由多个独立码点复合而成。
例如,代表“一家三口”的表情 👨👩👧,是由男士 👨、零宽连字符(ZWJ,\u200D)、女士 👩、零宽连字符、女孩 👧 拼合而成的序列。如果用 [...str] 切分,就会将这个家庭表情拆散成 5 个零散的独立码点,导致渲染破裂!
方法四:使用 Intl.Segmenter(现代工业级字形簇拆分)
为了从根本上解决复合表情、国旗、肤色修饰符以及带有声调结合标记(Combining Diacritical Marks)字符的切分难题,ECMAScript 正式推出了国际化文本分词标准 API:Intl.Segmenter。
通过指定分词颗粒度为 granularity: 'grapheme',Intl.Segmenter 能够精准按照人类视觉感知的“字形簇”进行切割,是目前 JavaScript 生态中最为严谨、无损的拆分方式。
/**
* 将字符串安全拆分为人类视觉感知上的单个字符(字形簇)数组
* @param {string} str - 目标字符串
* @param {string} locale - 语言环境,默认 zh-CN
* @returns {string[]} 纯净的单个字符数组
*/
function splitToGraphemes(str, locale = 'zh-CN') {
if (typeof Intl !== 'undefined' && Intl.Segmenter) {
const segmenter = new Intl.Segmenter(locale, { granularity: 'grapheme' });
return Array.from(segmenter.segment(str), item => item.segment);
}
// 降级兜底方案(针对极老旧运行环境)
return [...str];
}
// 严苛场景测试:复合家庭表情 + 国旗 + 增补汉字
const complexStr = "🇨🇳中国𠮷👨👩👧";
const graphemes = splitToGraphemes(complexStr);
console.log(graphemes);
// 示例输出: ['🇨🇳', '中', '国', '𠮷', '👨👩👧']
console.log(graphemes.length); // 示例输出: 5 (绝对符合人类直觉!)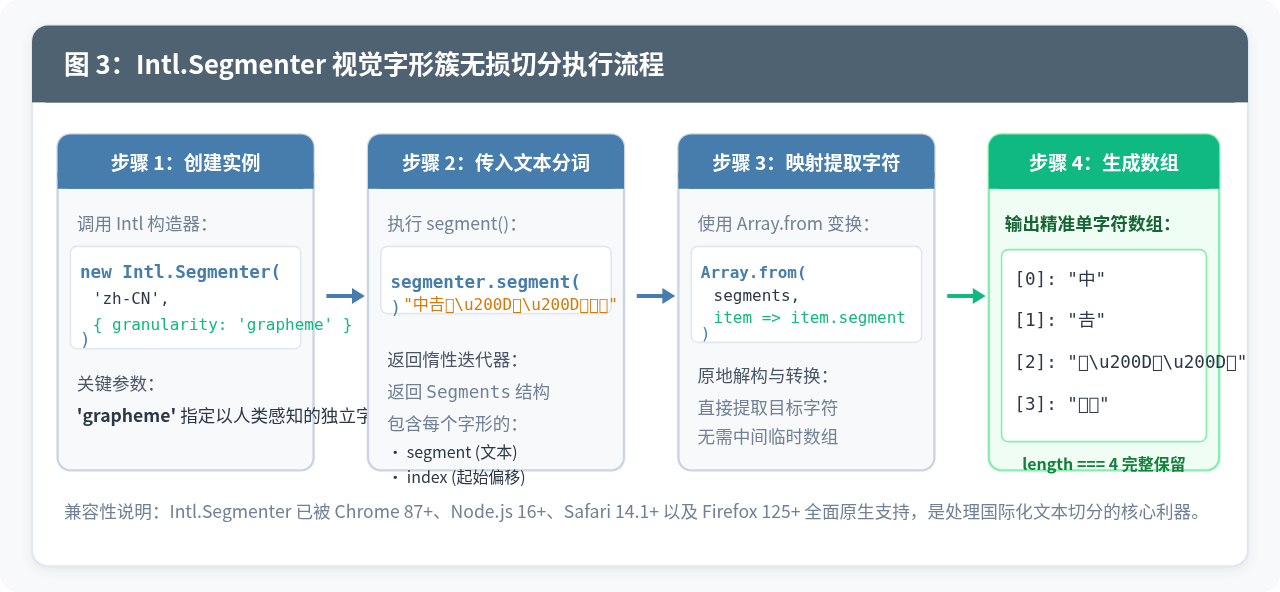
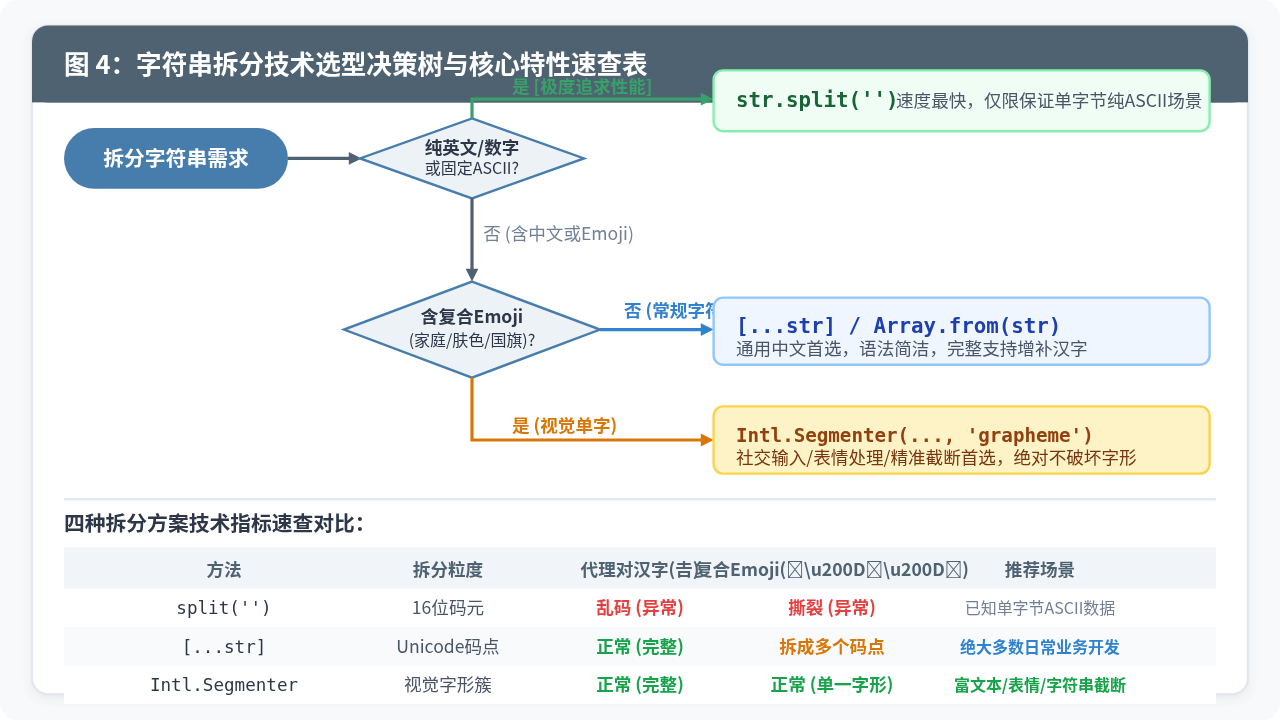
核心选型决策树与场景对比
在工程实践中,并不是所有场景都必须引入最复杂的 Intl.Segmenter。我们需要根据具体的输入数据源特征和性能诉求进行合理决策:
| 拆分方式 | 底层依据 | 增补生僻字 (如 𠮷) | 复合表情 (如 👨👩👧) | 执行性能 | 适用业务场景 |
|---|---|---|---|---|---|
str.split('') |
UTF-16 码元 | ❌ 碎裂乱码 | ❌ 撕裂破坏 | 极高(单字节最快) | 明确限定纯英文字符串、固定协议头部、哈希字串等 |
[...str] |
Unicode 码点 | ✅ 完好解析 | ⚠️ 拆散为多个码点 | 高 | 通用业务前台、常规多语言文本处理、绝大多数标准项目 |
Array.from(str) |
Unicode 码点 | ✅ 完好解析 | ⚠️ 拆散为多个码点 | 高 | 在拆分字符的同时需要对字符执行映射、转换或计数的场景 |
Intl.Segmenter |
视觉字形簇 | ✅ 完好解析 | ✅ 完美识别为单字 | 中(需构建分词实例) | 社交应用输入框字数限制、文本截断省略、Emoji 键盘开发 |
常见衍生场景与注意事项
1. 字符串安全反转(Reverse)
初学者常习惯写 str.split('').reverse().join('') 来颠倒字符串。如果字符串中包含 𠮷 或 👨👩👧,这种写法不仅会产生乱码,还会完全破坏 Emoji 的内部 ZWJ 连结规则。
// 错误写法
"𠮷".split('').reverse().join('');
// 得到无效的孤立低位+高位代理,显示为乱码 "\uDFB7\uD842"

// 推荐正确写法
function reverseString(str) {
  return splitToGraphemes(str).reverse().join('');
}

console.log(reverseString("你好𠮷世界!"));
// 示例输出: "!界世𠮷好你" (完美保留汉字字形)
2. 精准字数限制与截断
在开发限制 10 个字符的评论输入框时,直接使用 str.length > 10 会让输入了 👨👩👧(占 8 个字符长度)的用户感到困惑。应当通过 splitToGraphemes(str).length 来计算真实字数,并在截断时切片数组后再 join(''),防止截出半个表情导致显示问号方块。
function truncateText(str, maxChars = 10) {
const chars = splitToGraphemes(str);
if (chars.length <= maxChars) return str;
return chars.slice(0, maxChars).join('') + '...';
}
console.log(truncateText("欢迎来到👨👩👧幸福家庭快乐时光", 8));
// 示例输出: "欢迎来到👨👩👧幸福..." (表情没有被截断成乱码)实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章