
深入讲解 JavaScript 中数组按时间排序的核心写法,包括纯数字时间戳减法、Date 对象显式转换、字符串解析开销规避、不可变排序与 NaN 边界防御处理。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JavaScript数组按时间排序:Date对象与时间戳比较写法
作者:代码拾荒
时间:2026-11-22
浏览:135
文章目录
JavaScript 核心基础与进阶实践
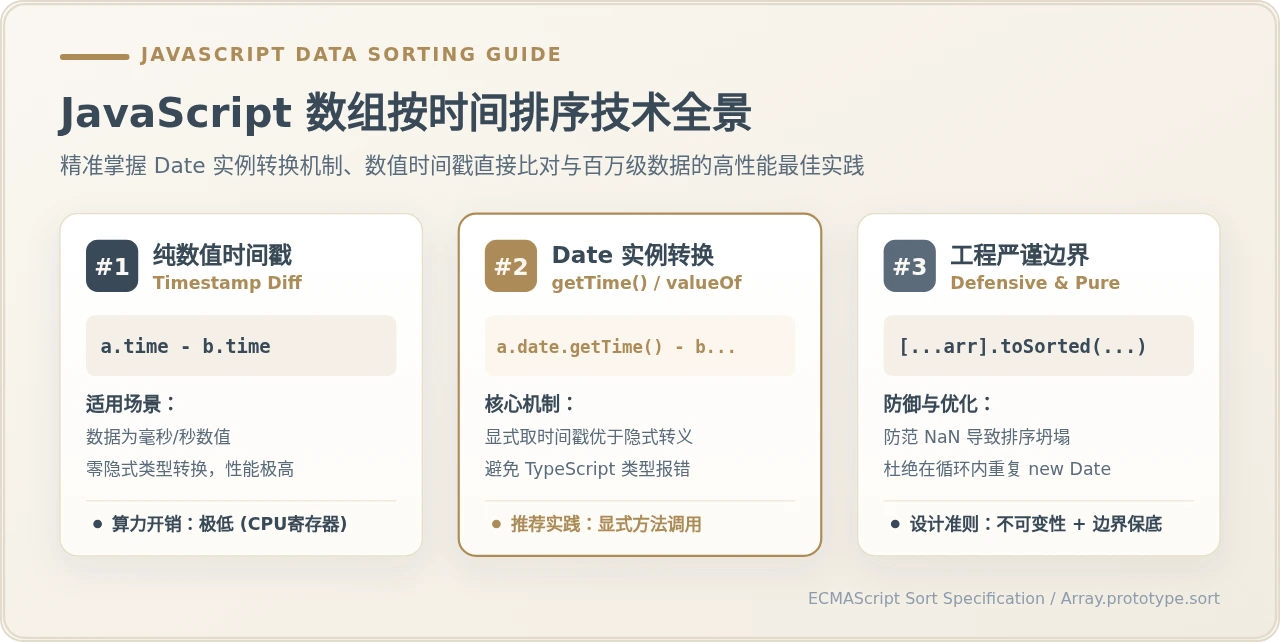
图 0:JavaScript 数组按时间排序全景指引与核心技术架构
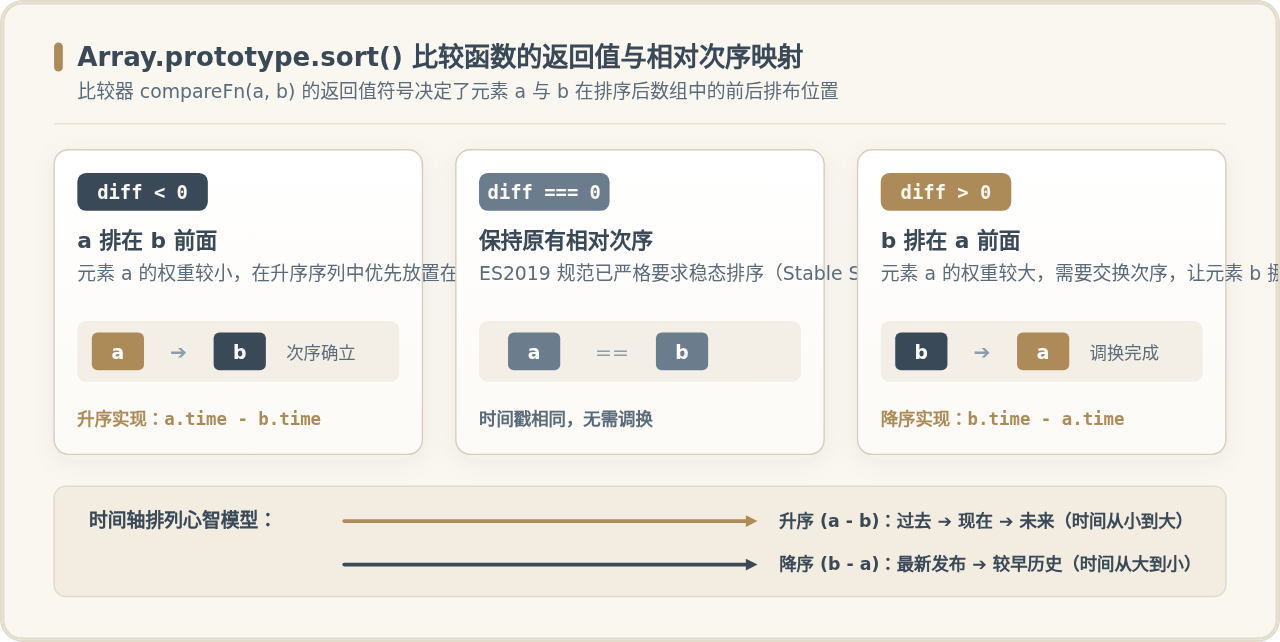
图 1:Array.prototype.sort() 比较函数的返回值与相对次序映射
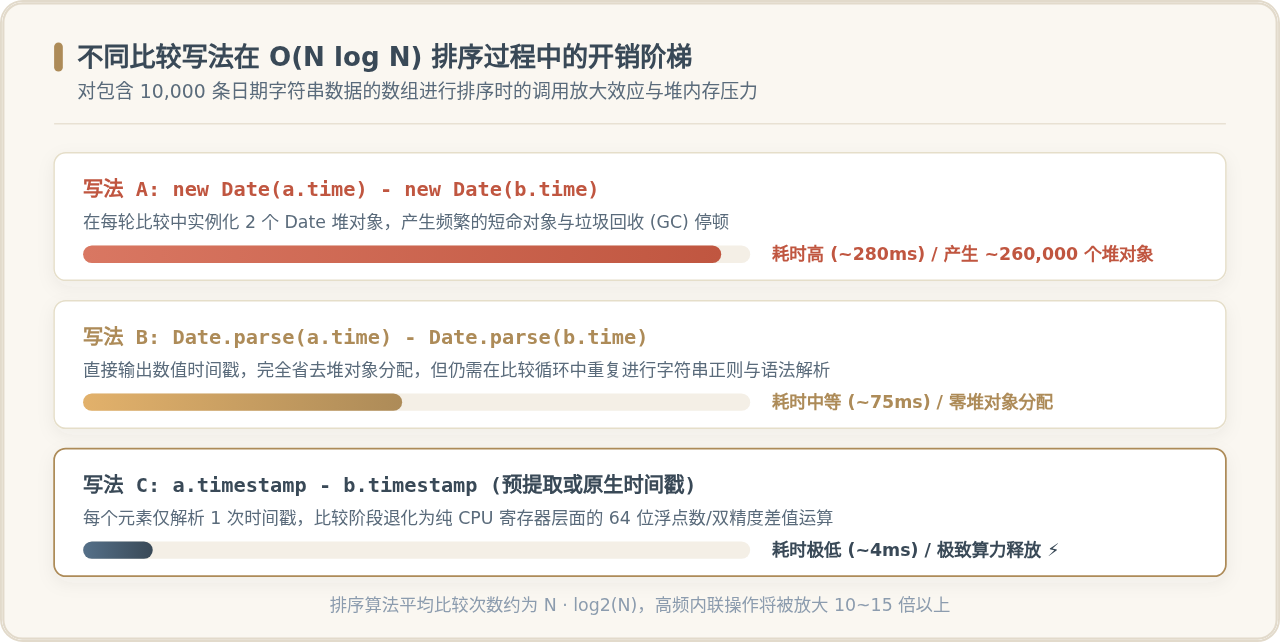
图 2:不同比较写法在排序循环中的性能与内存消耗阶梯
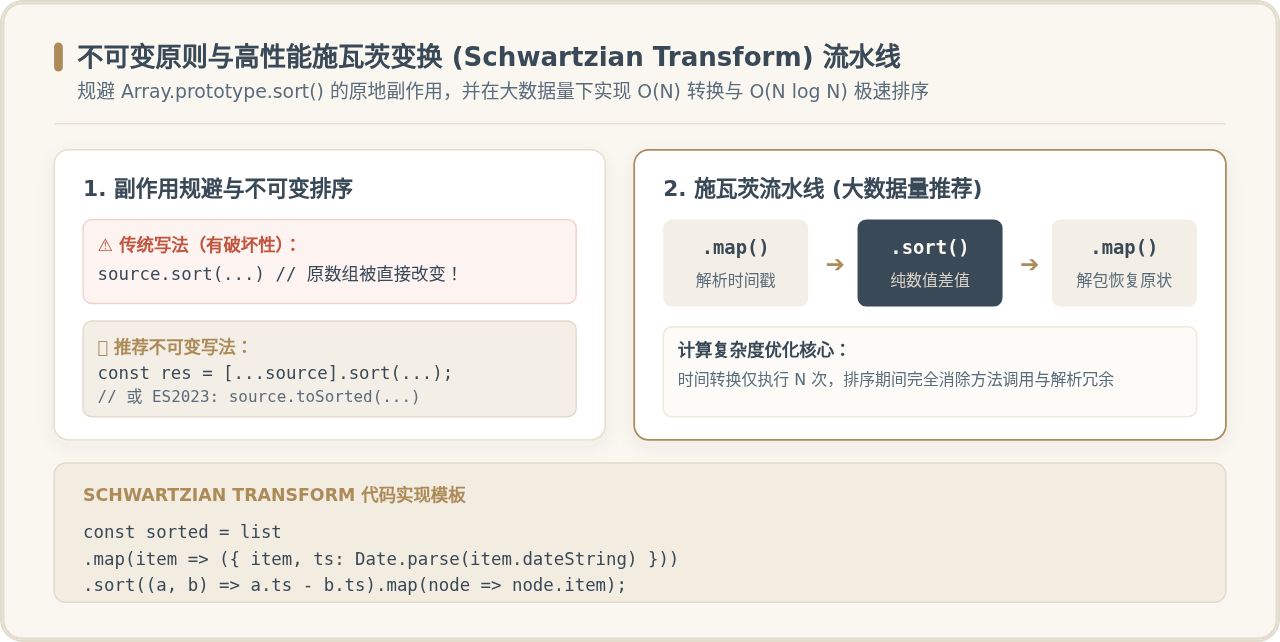
图 3:不可变排序数据流与施瓦茨流水线机制
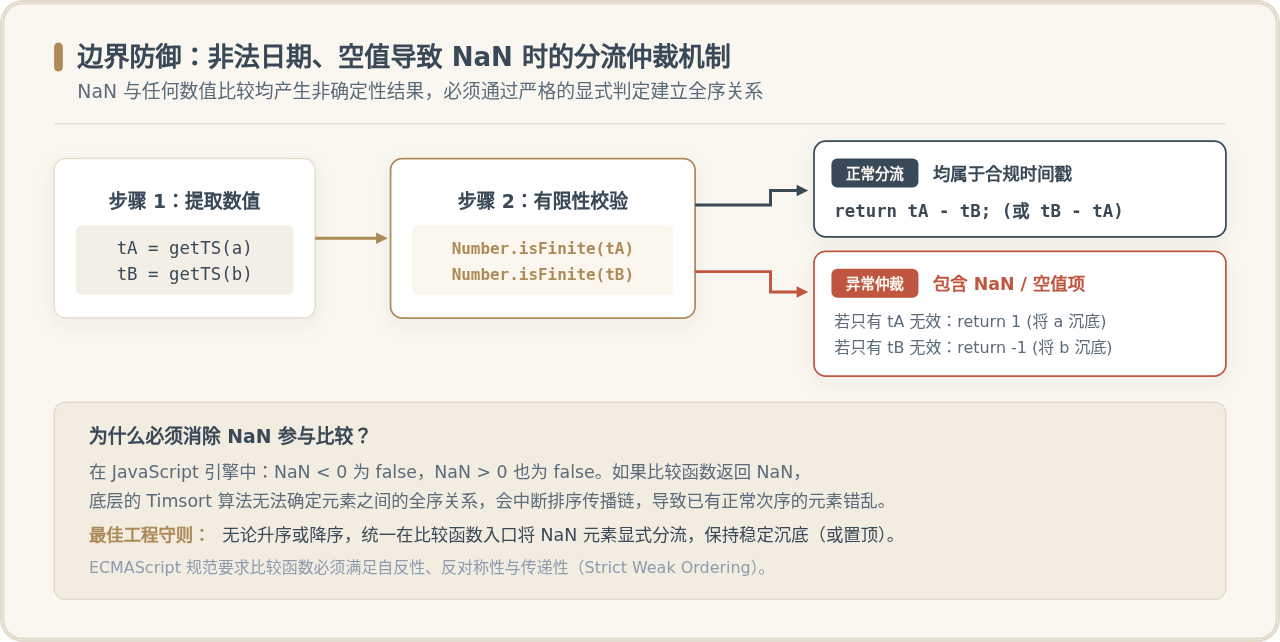
图 4:非法日期、空值导致 NaN 时的分流仲裁机制
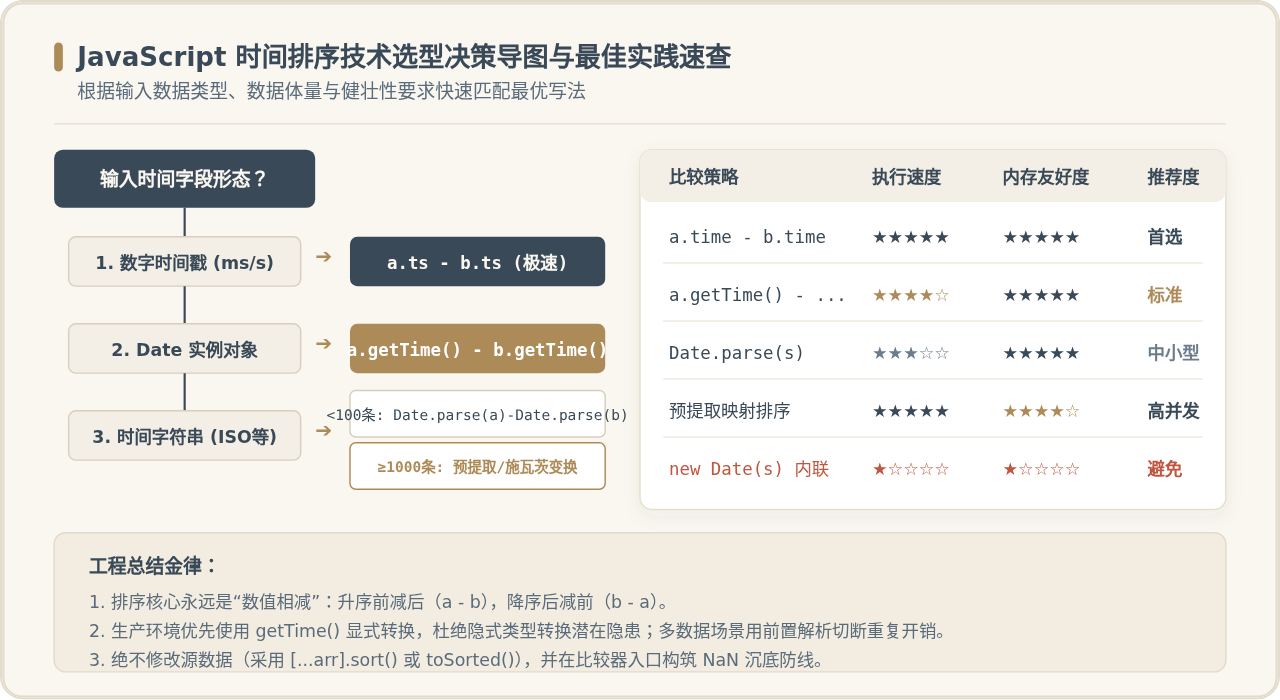
图 5:JavaScript 时间排序技术选型决策导图与全景速查
在 JavaScript 中对包含时间的数组进行排序,核心在于使用
Array.prototype.sort() 并传入自定义比较函数。如果数据已经是数字时间戳,可以直接使用数值相减;如果是 Date 实例,可通过 .getTime() 转换为毫秒数后再做差值;若数据是时间字符串,则应先解析或提取时间戳。本文具体介绍数字时间戳与 Date 对象在升序和降序场景下的标准写法,分析隐式类型转换与对象实例化的性能差异,并提供包含无效日期和空值时的边界防御方案。
一、JavaScript 数组时间排序的核心机制
JavaScript 数组自带的 sort() 方法在未传入参数时,默认会将数组内所有元素转换为字符串,并按照每个字符的 UTF-16 码元顺序进行升序排列。这种默认机制在处理时间数据时会导致致命错误。例如:
// 错误示例:默认 sort() 导致时间排序失常
const dates = ["2024-10-05", "2024-02-28", "2023-12-31"];
// 若存在单数字月份或不同格式(如 "2024/1/9" 与 "2024/01/15"),字符串比较将彻底失效
为了准确按照时间的自然先后次序排列,必须向 sort() 传入一个接收两个比较项的比较函数 compareFn(a, b)。该函数的底层判定规则非常明确:
- 返回值小于 0:表示
a应当排在b的前面; - 返回值大于 0:表示
b应当排在a的前面(即双方调换顺序); - 返回值等于 0:表示两者排序权重相同,在现代 JavaScript 引擎中将严格保持它们原有的相对物理次序(ES2019 已将
sort统一规定为稳定排序 Stable Sort)。
二、标准比较写法与完整代码示例
在实际项目开发中,数组元素包含的时间通常呈现为三种物理形态:纯数字时间戳、Date 对象实例以及日期时间字符串。针对不同的形态,存在与之对应的最佳比较写法。
1. 纯数字时间戳写法(性能最高)
时间戳是自 1970 年 1 月 1 日 00:00:00 UTC 起经过的毫秒数(或秒数)。由于它们已经是连续的 64 位浮点数,比较时可以直接执行减法运算,无需经过任何类型转换或方法调用。
// 原始数据示例:每条记录带有毫秒时间戳
const logList = [
  { id: 101, timestamp: 1716000000000, event: "系统启动" },
  { id: 102, timestamp: 1716000850000, event: "用户登录" },
  { id: 103, timestamp: 1715998200000, event: "任务调度" }
];

// 【升序排序】:从旧到新(时间戳小的排在前面,前减后)
const ascLogs = [...logList].sort((a, b) => a.timestamp - b.timestamp);

// 【降序排序】:从新到旧(最新时间排在前面,后减前)
const descLogs = [...logList].sort((a, b) => b.timestamp - a.timestamp);

// 示例输出结果验证:
// ascLogs[0].id === 103 (1715998200000 最早)
// descLogs[0].id === 102 (1716000850000 最新)
2. 原生 Date 对象写法(getTime 显式转换)
如果数组对象中的属性已经是 Date 类的实例,常见写法有两种:直接减法与显式 getTime()。
直接减法 a.date - b.date 在 JavaScript 中之所以能够运行,是因为减号运算符(-)会触发对象的隐式类型转换,底层引擎会自动调用 Date.prototype[Symbol.toPrimitive]('number')(进而调用 valueOf()),返回对应的毫秒数。然而,这种写法在严格的 TypeScript 环境下会抛出类型错误(The left-hand side of an arithmetic operation must be of type 'any', 'number', 'bigint' or an enum type),并且增加了运行时的隐式转换开销。
因此,工业级代码推荐使用显式的 getTime() 方法:
// 原始数据示例:每条记录包含标准的 Date 实例
const appointments = [
  { title: "项目评审", scheduledAt: new Date("2024-06-15T09:30:00Z") },
  { title: "需求讨论", scheduledAt: new Date("2024-06-15T14:00:00Z") },
  { title: "晨会沟通", scheduledAt: new Date("2024-06-15T08:00:00Z") }
];

// 【推荐写法】:显式调用 getTime(),语义严谨且兼容 TypeScript
// 升序排列:较早时间在前
const sortedAppointmentsAsc = [...appointments].sort(
  (a, b) => a.scheduledAt.getTime() - b.scheduledAt.getTime()
);

// 降序排列:较晚时间在前
const sortedAppointmentsDesc = [...appointments].sort(
  (a, b) => b.scheduledAt.getTime() - a.scheduledAt.getTime()
);
3. 日期字符串场景的比较写法与陷阱
后端接口或存储介质中最常见的往往是 ISO 8601 格式字符串(例如 "2024-05-20T16:00:00.000Z")。处理这种数据时,很多初学者会写出如下代码:
// ⚠️ 极其常见但存在性能缺陷的写法:
list.sort((a, b) => new Date(a.dateStr) - new Date(b.dateStr));
这种写法在功能上能够得到正确结果,但在排序算法进行期间,比较函数会被高频调用。排序算法的平均比较次数为 O(N log N),在 N = 10,000 时,比较函数将被执行约 130,000 次,这意味着引擎必须在瞬间分配超过 260,000 个临时 Date 对象,引发严重的内存垃圾堆积和主线程卡顿。
针对字符串时间,推荐采用两级递进方案:
- 轻量场景(数据量 < 200 条):使用
Date.parse()替代new Date()。Date.parse()直接返回数字时间戳,避免在堆内存中创建任何对象。 - 海量数据场景(数据量 ≥ 1,000 条):采用施瓦茨变换(Schwartzian Transform)进行单次线性预提取。
// 方案 1:小型数组内联 Date.parse()
const smallList = [
  { name: "Task 1", time: "2024-05-01 10:00:00" },
  { name: "Task 2", time: "2024-04-12 18:30:00" }
];
smallList.sort((a, b) => Date.parse(a.time) - Date.parse(b.time));

// 方案 2:大数据量推荐:施瓦茨变换(预处理缓存时间戳)
const largeList = [
  // 假设包含数千条数据的数组...
];

const sortedLargeList = largeList
  .map(item => ({ item, timestamp: Date.parse(item.time) })) // O(N) 预计算,仅解析一次
  .sort((a, b) => a.timestamp - b.timestamp)                   // O(N log N) 纯数值极速差值
.map(node => node.item); // O(N) 恢复数据引用三、不可变排序原则与副作用规避
JavaScript 语言中的 Array.prototype.sort() 是一个具有破坏性(In-place mutation)的原地操作方法。调用它不仅会返回排序后的数组,还会直接修改传入的原数组本身。
在 React、Vue、Redux 等现代前端框架中,直接修改状态对象会导致浅比较(Shallow Compare)失效,进而引发视图无法响应更新或难以排查的状态污染问题。
为了保持函数式编程中的数据不可变性(Immutability),通常采用以下两种规避方式:
- 展开运算符浅拷贝:
[...array].sort(...)。通过数组解构快速生成一个新数组实例,然后再对其排序。 - ES2023 原生不可变方法
toSorted():ECMAScript 2023 标准正式引入了toSorted()。该方法接收完全相同的比较函数,但在排序完成后直接返回一个全新的浅拷贝数组,原数组毫发无损。
const originalList = [
  { id: 1, time: 1716000000000 },
  { id: 2, time: 1715000000000 }
];

// 现代浏览器及 Node.js 20+ 原生支持 toSorted
const sortedList = originalList.toSorted((a, b) => a.time - b.time);

// 验证原数组未被修改:
console.log(originalList[0].id === 1); // true(原数组物理顺序保持完好)
console.log(sortedList[0].id === 2); // true(新数组已完成升序排列)四、边界场景与异常防御处理
在实际生产环境中,后端返回的时间字段可能存在脏数据,例如 null、undefined,或者无法解析的非法日期字符串(如 "Invalid Date"、"")。
当对非法字符串调用 Date.parse() 或 new Date().getTime() 时,将得到 NaN(Not a Number)。在 IEEE 754 浮点数标准下,NaN 具备非常特殊的性质:
console.log(NaN - 100);  // NaN
console.log(NaN < 0);    // false
console.log(NaN > 0);    // false
console.log(NaN === 0);  // false
如果排序比较函数返回了 NaN,V8 引擎内置的 Timsort 算法将无法判定两者的相对次序。这打破了数学上的“严格弱序关系”(Strict Weak Ordering),导致整个数组的排序链路发生紊乱,原本正常的数据项也会被随意错置。
生产环境防御准则
在比较函数入口必须进行有限性校验(Number.isFinite()),将非法数据、null 或 undefined 统一分流,显式指定其置底或置顶,确保比较函数在任何输入下都输出确定的数字(-1、0 或 1)。
下面是一个具备完整防御机制的生产级时间排序函数,支持将无效时间项稳定沉底:
/**
 * 健壮的数组时间排序通用工具函数
 * @param {Array} list 需要排序的对象数组
 * @param {Function} timeSelector 时间提取函数
 * @param {'asc' | 'desc'} order 排序方向,默认 'asc'
 * @param {boolean} invalidToBottom 是否将无效时间排到末尾,默认 true
 */
function safeSortByTime(list, timeSelector, order = 'asc', invalidToBottom = true) {
  // 提取时间戳并做容错归一化
  const extractTimestamp = (item) => {
    if (!item) return NaN;
    const raw = timeSelector(item);
    if (raw instanceof Date) return raw.getTime();
    if (typeof raw === 'number') return raw;
    if (typeof raw === 'string') return Date.parse(raw);
    return NaN;
  };

  return [...list].sort((a, b) => {
    const tA = extractTimestamp(a);
    const tB = extractTimestamp(b);

    const validA = Number.isFinite(tA);
    const validB = Number.isFinite(tB);

    // 情况 1:两者皆为无效时间
    if (!validA && !validB) return 0;

    // 情况 2:其中一项为无效时间,根据配置稳定分流
    if (!validA) return invalidToBottom ? 1 : -1;
    if (!validB) return invalidToBottom ? -1 : 1;

    // 情况 3:两者皆为有效时间戳,执行差值判定
    return order === 'asc' ? tA - tB : tB - tA;
  });
}

// 验证防御函数的执行表现:
const dirtyData = [
  { id: 1, time: "2024-05-18T10:00:00Z" },
  { id: 2, time: null },
  { id: 3, time: "invalid-date-string" },
  { id: 4, time: "2024-05-10T08:00:00Z" }
];

const cleaned = safeSortByTime(dirtyData, item => item.time, 'asc');
// 结果:id: 4 (5月10日) -> id: 1 (5月18日) -> id: 2 & 3 (无效值均被平稳放置于数组末尾)
五、时间排序技术选型与全景速查
针对不同业务场景,合理权衡开发便捷度与运行效率,选择最贴合实际的排序方案:
| 输入数据形态 | 推荐写法(升序示例) | 时间复杂度 | 内存分配开销 | 典型适用场景 |
|---|---|---|---|---|
| 数字时间戳 (Number) | [...arr].sort((a, b) => a.ts - b.ts) |
O(N log N) | 零额外分配 | 服务端返回时间戳的高频列表、图表时序点 |
| Date 实例 (Object) | [...arr].sort((a, b) => a.d.getTime() - b.d.getTime()) |
O(N log N) | 零额外分配 | 表单日期拾取器、日历组件实体数据 |
| 时间字符串 (小数据量 < 200) | [...arr].sort((a, b) => Date.parse(a.s) - Date.parse(b.s)) |
O(N log N) | 零额外分配 | 常规中后台管理系统分页表格(10~50 条) |
| 时间字符串 (大数据量 ≥ 1000) | arr.map(...).sort(...).map(...) (施瓦茨变换) |
O(N log N) | O(N) 临时对象 | 前端百万级静态日志分析、离线报表整理 |
| 含有空值/不可信输入 | safeSortByTime(arr, selector) (双向防御) |
O(N log N) | O(1) 局部变量 | 公开 API 对接、多源聚合数据消费端 |
综上所述,JavaScript 数组时间排序的核心始终是将时间实体转化为连续数字进行差值计算。通过把握“升序前减后、降序后减前”的代数规律,使用 getTime() 显式转换确保类型严谨,借助不可变方法规避原数组污染,并在入口做好 NaN 容错防御,即可在各类业务场景中编写出既高效又健壮的时间排序逻辑。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章