
深入解析JavaScript中Array.prototype.sort()默认行为导致反直觉排序的底层根源,剖析ECMAScript规范中的ToString转换与UTF-16码元比对机制,并提供localeCompare与Intl.Collator的高性能实践方案。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS字符串默认排序为何不符合直觉?解析Unicode排序陷阱
作者:小括号
时间:2026-11-21
浏览:91
文章目录
一、底层机制拆解:Array.prototype.sort() 究竟如何工作?
初学者在 JavaScript 中最常遇到的意外输出莫过于数字数组的排序异常。例如直觉上我们认为 2 小于 10,但运行以下简短代码时结果却令人困惑:
const numbers = [10, 2, 5];
numbers.sort();
console.log(numbers);
// 示例输出: [10, 2, 5]
产生这一现象的根源在于 ECMAScript 规范对 Array.prototype.sort(comparefn) 的定义。当没有向 sort() 传递 comparefn 参数时,引擎内部会采用默认的抽象比对算法,其核心规则包含三个关键步骤:
- 所有元素强制转为字符串:无论数组项原本是数字、布尔值、还是对象,只要不是
undefined,引擎均会在内部对其执行抽象操作ToString(element)。数字10被转为字符序列"10",数字2被转为字符序列"2"。 - 获取首个字符的 UTF-16 码元:对于转换后的字符串,引擎从索引 0 开始逐个检查字符的 16 位码元数值(即
String.prototype.charCodeAt()返回的值)。字符'1'的码元为49 (0x0031),而字符'2'的码元为50 (0x0032)。 - 数值比较终止判定:由于
49 < 50,引擎直接得出结论:"10"在字典序中小于"2"。比对过程在第一个字符处立即判定完毕,根本不会解析后续的'0',更不会考虑整体的数学大小。
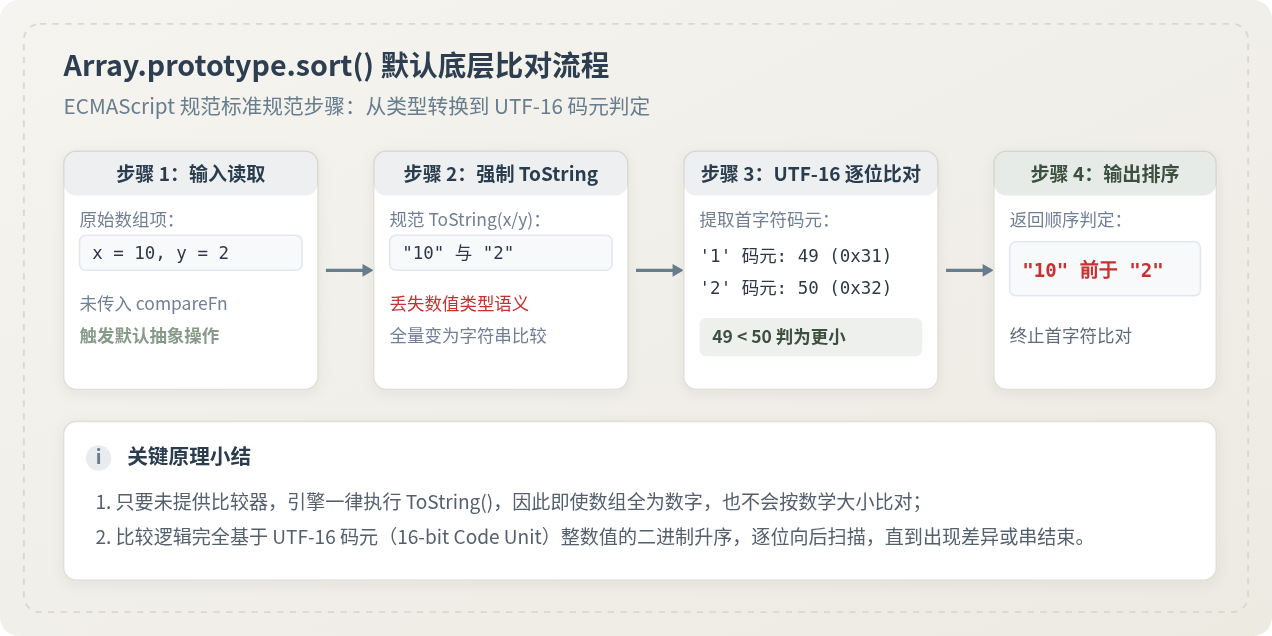
规范关键定义:UTF-16 码元序列字典序
ECMAScript 规范明确指明:无参排序是按 UTF-16 代码单元值(code unit values)的升序进行的。这意味着排序实质上是二进制编码位上的字典序比较,而非人类语言中的语义分析。
二、典型陷阱全景:三大反直觉场景与底层根源
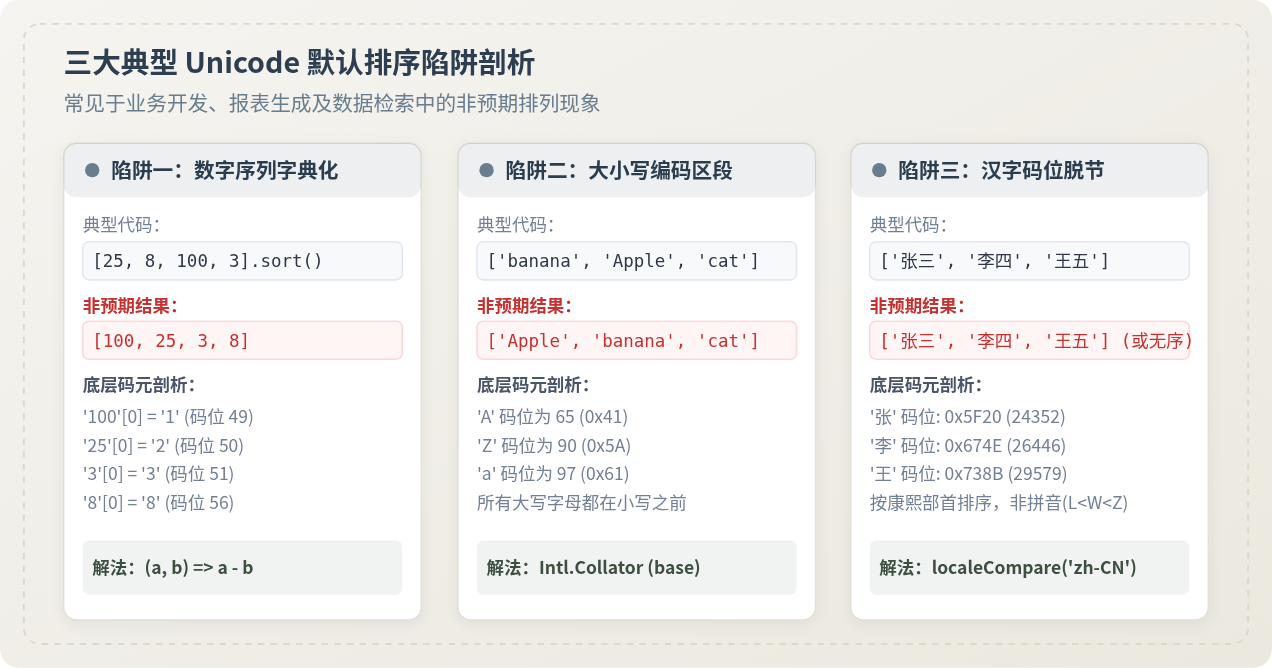
理解了 UTF-16 码元比对的本质后,我们来看开发中最容易踩坑的三大典型场景。
1. 纯数字序列的“字典化”倒置
在电商价格排序、编号列表或分页查询中,未传比较器的数字排序会导致严重的逻辑漏洞:
const scores = [25, 8, 100, 3, 72];
scores.sort();
console.log(scores);
// 示例输出: [100, 25, 3, 72, 8]
在这个结果中,100 被排在首位,紧接着是 25,而 8 却被排在末尾。原因正是首字符码位的顺序:'1' (49) < '2' (50) < '3' (51) < '7' (55) < '8' (56)。字符长度只在前面字符完全相同时才起决定作用(例如 "2" 与 "25" 比对时,"2" 是前缀,因而 "2" 小于 "25")。
2. ASCII 区段中的大小写倒置
在西方字母体系中,我们在字典里查词时通常认为 "apple" 应该紧随 "Apple" 之后,或者无论大小写都按同一字母表排列。但在 ASCII / Unicode 编码表中,大写拉丁字母与小写拉丁字母被分配在两个独立的连续区间:
- 大写字母
'A' ~ 'Z'码位区间为65 ~ 90 (0x41 ~ 0x5A) - 小写字母
'a' ~ 'z'码位区间为97 ~ 122 (0x61 ~ 0x7A)
const fruits = ['banana', 'Apple', 'cherry', 'Banana'];
fruits.sort();
console.log(fruits);
// 示例输出: ['Apple', 'Banana', 'banana', 'cherry']
由于所有大写字母的码元均严格小于所有小写字母,导致任意以大写字母开头的单词(即使是 'Zebra')都会排在小写 'apple' 之前。这彻底打破了词典排序的一致性。
3. 汉字与多语言:Unicode 码位脱离拼音习惯
中文开发者最常见的需求之一是让人员名单或组织架构按“拼音首字母”或“笔画”进行顺序展示。但在 JS 默认排序下,中文并不是按拼音排列的:
const names = ['张三', '李四', '王五', '赵六'];
names.sort();
console.log(names);
// 示例输出: ['张三', '李四', '王五', '赵六']
按照汉语拼音首字母排序,顺序应当是:李四 (L) < 王五 (W) < 张三 (Z) < 赵六 (Z)。但默认排序的结果却是张三排在最前。这是因为 Unicode 汉字编码(如 CJK 统一表意文字区块)在历史上主要是依据《康熙字典》的部首和笔画顺序,或者是按历史字表分配码位的:
- '张': 0x5F20 (十进制 24352)
- '李': 0x674E (十进制 26446)
- '王': 0x738B (十进制 29579)
- '赵': 0x8D75 (十进制 36213)
汉字在 Unicode 码表中并非拼音连续分布,因此直接使用 sort() 处理中文,其排列顺序对用户而言毫无规律可循。
补充注意:Emoji 与辅助平面代理对(Surrogate Pairs)
由于 JavaScript 早期设计限制,字符串内部采用 UTF-16 编码。普通字符处于基本多语言平面(BMP,码位不超过 0xFFFF),占用 1 个码元;而许多 Emoji 表情(如 😄 码位 U+1F604)位于辅助平面,在 UTF-16 中被拆分为两个代理码元(高位代理与低位代理,如 0xD83D 0xDE04)。在默认排序下,两个代理码元会被分别比对,当混合比较特殊字符与常规字符时可能引发更为隐蔽的乱序问题。
三、深度对比与权衡:默认码元比对 vs 语言学排序
在明确了为什么默认排序不符合直觉之后,我们需要在工程实践中对比两种处理方式的根本差异:二进制码元排序 与 语言学区域排序(Locale Collation)。
为什么 JavaScript 语言规范不直接将默认排序改成符合自然直觉的方式?这里涉及到底层性能、确定性与多语言歧义的权衡:
| 对比维度 | 默认 UTF-16 码元排序 (默认 behavior) | 语言学感知排序 (localeCompare / Intl.Collator) |
|---|---|---|
| 比较规则 | 纯粹二进制 16-bit 整数比对,无上下文 | 遵循 CLDR(通用区域数据仓库)语言学规则 |
| 区域敏感性 | 完全无关(在任何操作系统与地区结果恒定) | 依赖指定 Locale(如 'zh-CN', 'de-DE', 'en-US') |
| 自然数混合处理 | 无法识别数字,作为连续单字符比较 | 支持 numeric: true,将 "v2" 排在 "v10" 之前 |
| 单次比较耗时 | 几纳秒(CPU 寄存器级整数对比) | 微秒级(需要查阅语言规则表与重音折叠) |
为什么重要:性能与语义的关键抉择
语言学排序(Locale Collation)虽然完全契合人类的直觉,但它的计算成本远高于简单的码元比对。如果在排序包含数万条记录的大型数组时,不加思索地在比较函数中直接调用 a.localeCompare(b, 'zh-CN'),会导致极其严重的性能开销:
// ❌ 存在性能隐患的大数组排序写法
bigList.sort((a, b) => a.localeCompare(b, 'zh-CN'));
在快速排序或 Timsort 算法中,比较操作会执行 $O(N \log N)$ 次。每次调用带有选项参数的 localeCompare 时,JavaScript 引擎都需要重新解析区域字符串并构建临时的国际化比较规则上下文。这在数组较大时会导致帧率下降或页面无响应。
正确的工业级实践是使用 ECMAScript 国际化 API:提前实例化并复用 Intl.Collator 对象,单次创建即可实现高达 10 到 30 倍的吞吐量提升。
四、规范化解决方案与操作决策树
针对不同的数据形态与业务诉求,编写排序时应当遵循明确的技术决策路径,避免盲目使用单一方法。
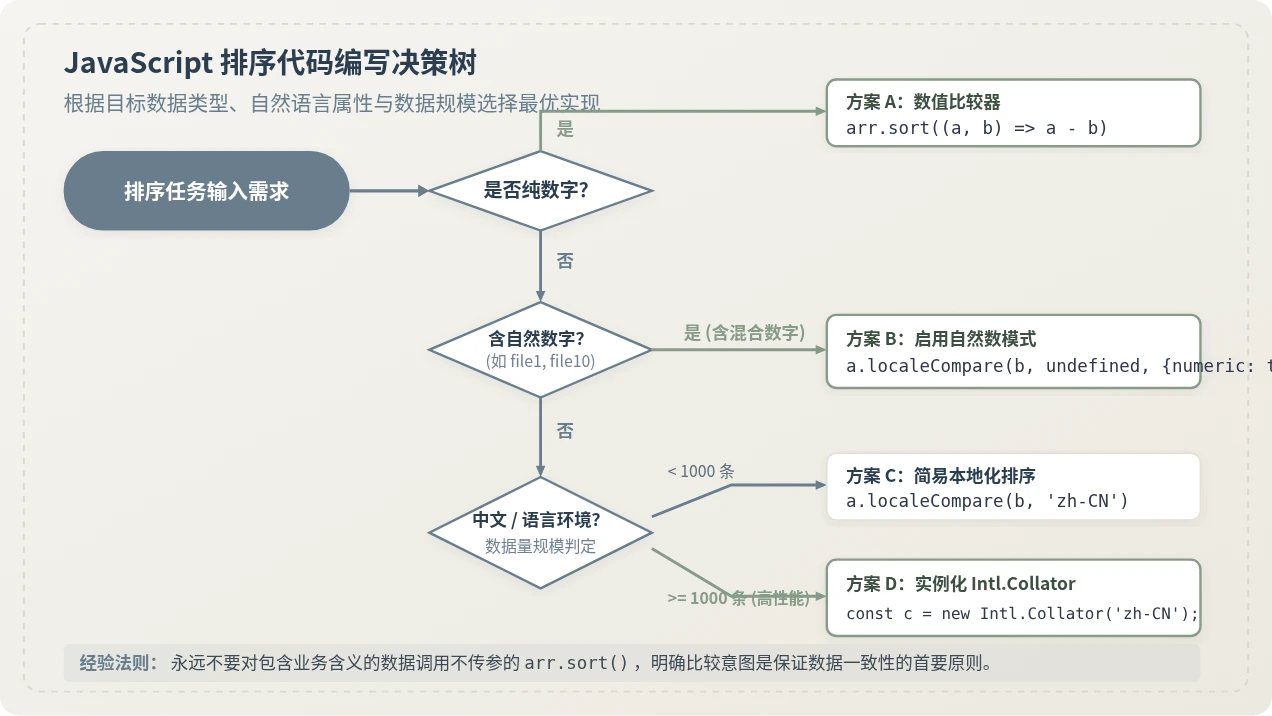
场景 1:纯数值数组排序
必须显式提供减法比较函数。对于升序排列,使用 (a, b) => a - b;对于降序排列,使用 (a, b) => b - a:
const list = [100, 25, 8, 3];
// 正确做法:数值比较器
list.sort((a, b) => a - b);
console.log(list);
// 示例输出: [3, 8, 25, 100]
场景 2:文件名与版本号等自然数混排
当字符串中嵌入了编号时(如 "file1.txt"、"file10.txt"、"file2.txt"),默认排序会将 "file10.txt" 挤在 "file2.txt" 前面。此时开启 numeric: true 选项:
const files = ['chapter1.docx', 'chapter10.docx', 'chapter2.docx'];

// 启用自然数值识别模式
files.sort((a, b) => a.localeCompare(b, undefined, { numeric: true }));
console.log(files);
// 示例输出: ['chapter1.docx', 'chapter2.docx', 'chapter10.docx']
场景 3:中文姓名或标题按拼音排序(高性能实例复用)
对于人员列表、城市列表等中文数据,明确指定 'zh-CN' 语言环境:
const cities = ['武汉', '北京', '广州', '上海', '成都'];

// 推荐实践:初始化 Intl.Collator 实例并复用
const zhCollator = new Intl.Collator('zh-CN', {
  sensitivity: 'accent',
  numeric: true
});

cities.sort(zhCollator.compare);
console.log(cities);
// 示例输出: ['北京', '成都', '广州', '上海', '武汉']
// 拼音首字母顺序: B(北京) < C(成都) < G(广州) < S(上海) < W(武汉)
场景 4:英文不区分大小写排序
在整理英文标签或字典时,可以通过设置 sensitivity: 'base' 忽略大小写差异:
const tags = ['banana', 'Apple', 'cat', 'Banana'];
const enCollator = new Intl.Collator('en', { sensitivity: 'base' });

tags.sort(enCollator.compare);
console.log(tags);
// 示例输出: ['Apple', 'banana', 'Banana', 'cat']
五、全维度选型总结与避坑清单
为了让不同场景下的技术选型更加清晰直观,下图系统梳理了四种主流排序方案的优劣边界:
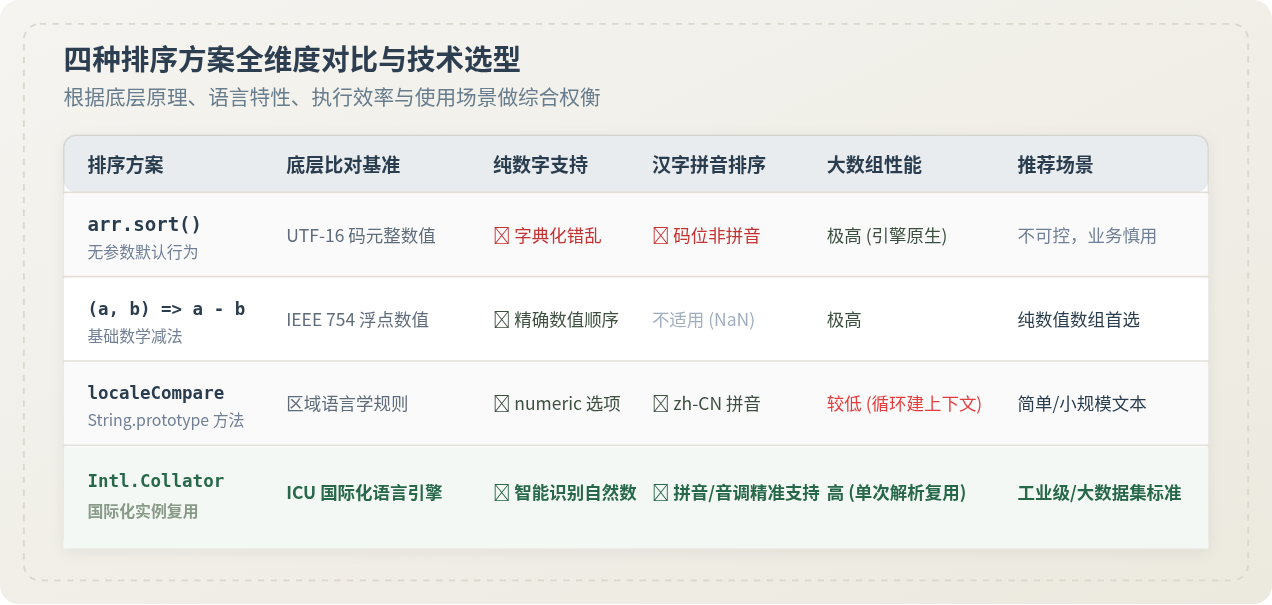
避坑核心原则速记:
- 原则一(严禁无参):在业务代码中,坚决避免书写无参的
arr.sort()。即使在开发调试阶段,也应始终写明比较器,防止隐性 Bug 流入生产环境。 - 原则二(原地修改):谨记
sort()方法会直接在原数组上进行原地(in-place)变更,并返回原数组引用。若要保留原始数据副本,应先使用[...arr].sort()或 ES2023 新增的arr.toSorted()。 - 原则三(规模换架构):对几条到几十条的简单界面展示,
a.localeCompare(b, 'zh-CN')足以满足需求;对于复杂报表、海量下拉框或高频计算逻辑,务必提取静态单例new Intl.Collator('zh-CN', { numeric: true })进行复用。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章