
深入解析在JavaScript中构建x86汇编器时处理伪指令的核心机制,涵盖两遍扫描架构、TypedArray小端序编码、ORG基址重设、ALIGN对齐计算以及数据发射与预留的本质差异。

当前位置:首页 > JavaScript 项目实战 > 正文
使用JavaScript构建x86汇编器时的伪指令处理技巧
作者:青柠
时间:2026-11-21
浏览:438
文章目录
使用 JavaScript 构建 x86 汇编器时,伪指令(Directives)并不对应 CPU 的硬件操作码,而是直接操控汇编器的内部运行状态,包括基准地址定位、符号常量绑定、对齐填充以及静态数据的二进制封装。处理伪指令的核心在于设计一套上下文驱动的调制机制,并在两遍扫描(Two-Pass)流程中将尺寸评估与字节发射精确解耦。本文将针对数据定义(DB/DW/DD)、空间预留(RESB)、常量绑定(EQU)与内存对齐(ORG/ALIGN)等核心伪指令,结合 TypedArray、DataView 及符号表状态机,详解其在 JavaScript 中的完整实现方法与避坑技巧。
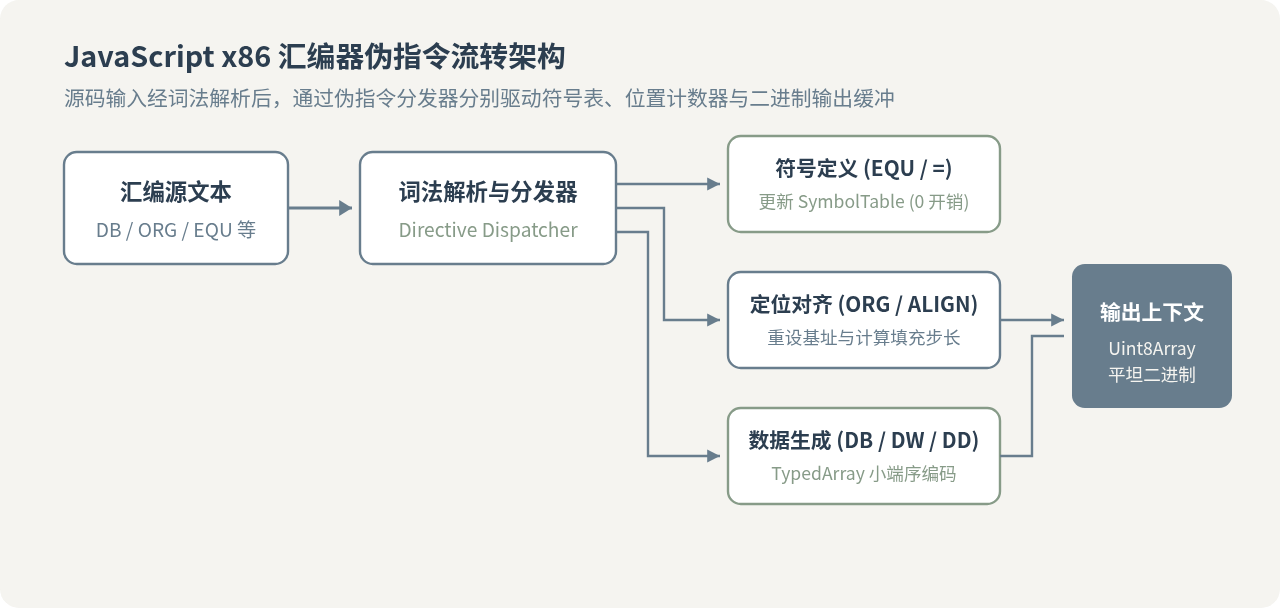
一、伪指令在汇编器架构中的定位与状态流转
真实机器指令(如 MOV EAX, EBX 或 JMP target)的作用是生成供 CPU 执行的机器码(Opcode),其字节长度和编码格式由 x86 指令集架构严格规范。与之相对,伪指令是写给汇编器本身的控制元指令。汇编器在解析代码行时,必须根据助记符(Mnemonic)将指令路由至不同的处理分支:
- 机器指令处理器:查阅操作码映射表,计算 ModR/M、SIB 字节及操作数立即数,发射指令机器码。
- 伪指令分发网关(Directive Dispatcher):不查询 CPU 操作码表,而是直接读写汇编上下文状态机(
AssemblerContext),根据具体伪指令修改位置计数器(Location Counter,通常用$表示)、注入符号表或向输出缓冲区追加静态字节序列。
在 JavaScript 单线程模型中,构建汇编器通常会将整段汇编源文本按行切分并进行词法提取。伪指令通常以专用助记符形式出现(如 ORG 0x7C00),或作为语句的核心动词(如 msg DB 'Hello', 0)。维持一个整洁的上下文字典是保障所有伪指令正确执行的前提。
二、核心机制对比:数据发射型伪指令 vs 空间预留型伪指令
在 x86 汇编中,定义数据与预留空间是两组最容易被初学者混淆的概念。理解它们在同一汇编环境下的行为差异,是设计输出缓冲区控制器的关键:
| 对比维度 | 数据发射型伪指令(如 DB / DW / DD) | 空间预留型伪指令(如 RESB / RESD) |
|---|---|---|
| Pass 1 行为 | 计算初始值序列的实际字节总长,推进位置指针 | 解析数量表达式,计算预留字节长,推进位置指针 |
| Pass 2 平坦镜像 | 将编码后的小端序二进制真实写入 Uint8Array | 必须写入等量的 0x00 字节,维持扇区/镜像绝对物理偏移 |
| Pass 2 ELF/PE 段 | 归入 .data 段,占用可执行文件物理磁盘存储 |
归入 .bss 段,仅修改段头部尺寸字段,不占磁盘体积 |
| 初始值要求 | 必须提供显式初始值(数值、字符串或数组) | 仅接收整数长度参数,不需要也不允许提供初始数据 |
关键差异的影响:如果用户正在构建的是用于 BIOS 引导扇区(如 512 字节 MBR)的平坦二进制(Flat Binary)汇编器,
RESB 64 必须在输出流中补足 64 个零字节。若错误地将其处理为“仅修改指针而不发射字节”,会导致其后紧随的引导签名(0xAA55)向前塌陷,最终生成的镜像不足 512 字节且无法通过 BIOS 引导检验。反之,若生成 ELF 目标文件时为 RESB 写入了物理零,则会使目标文件体积非必要膨胀。
三、两遍扫描(Two-Pass)中的伪指令处理步骤
为了解决向前引用(Forward Reference,即先使用后定义标签)的问题,工业级汇编器普遍采用两遍扫描结构。伪指令在这两遍扫描中承担着截然不同的工作:
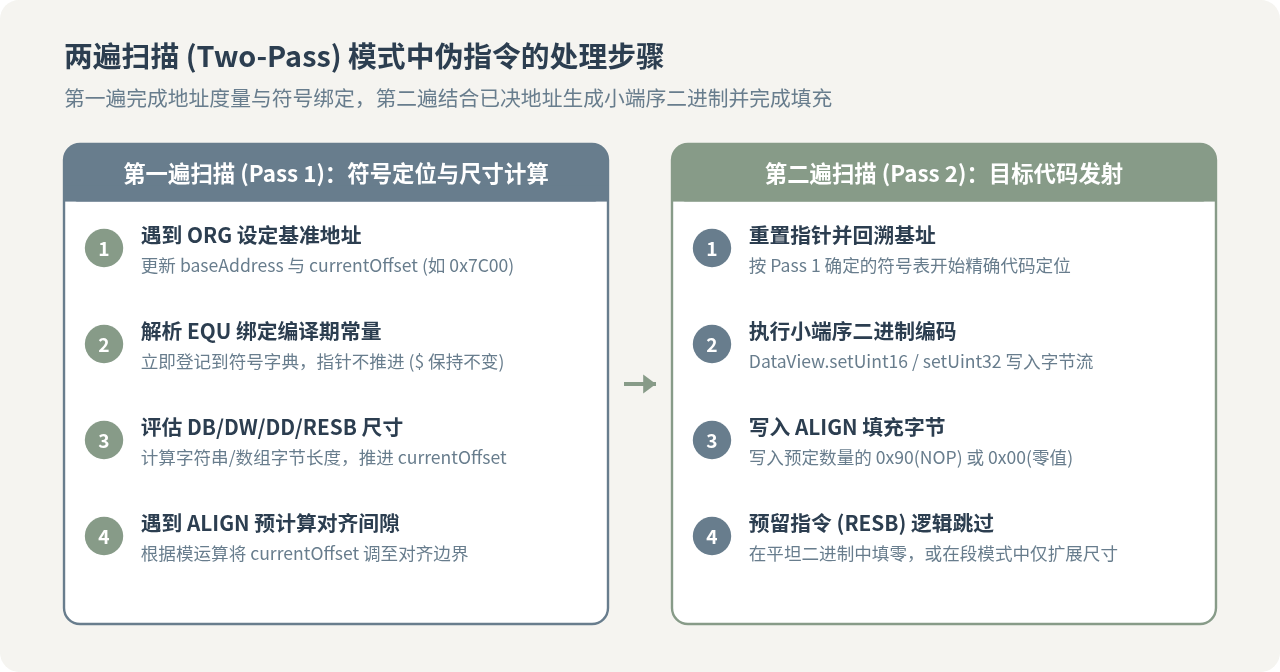
1. 第一遍扫描(Pass 1):计算尺寸与锚定符号
第一遍扫描的目标是建立完整的符号表(Symbol Table)。在这一阶段,汇编器不生成任何最终机器字节,但必须准确计算每条伪指令所占用的空间大小:
ORG origin:将上下文中的locationCounter与baseAddress同步重置为指定基址。例如遇到ORG 0x7C00,后续遇到的首个标签地址即为0x7C00。label EQU expr:计算表达式数值,并直接将(label, value)写入符号字典。因为EQU属于纯编译期别名,绝对不能累加位置指针。DB / DW / DD:扫描参数列表。遇到字符串时通过字符计数计算字节数(单字节编码每个字符占 1 字节),遇到数值则按 1、2、4 字节单位累加,随后推进locationCounter。ALIGN n:计算当前地址距离下一个n字节边界所需的对齐垫片字节数,提前计入locationCounter。
2. 第二遍扫描(Pass 2):代码回填与二进制发射
当第一遍扫描完成,所有标签的绝对内存地址均已固定。第二遍扫描重新从源码起始行执行:
- 此时所有出现在数据定义指令中的符号引用(例如
DW table_end - table_start)都可以通过符号表获得确切整数。 - 调用 JavaScript 底层的类型化数组(TypedArray)与数据视图(DataView),按 x86 小端序要求将数据写入连续内存缓冲区。
四、JavaScript 实现核心:数据打包与 Little-Endian 编码技巧
JavaScript 语言内部所有数字均为 IEEE 754 双精度 64 位浮点数,且原生位运算符(如 <<, |, &)默认将操作数强制转换为 32 位有符号补码整数。在处理 x86 多字节数值和溢出检测时,必须特别注意规避隐式类型转换缺陷。
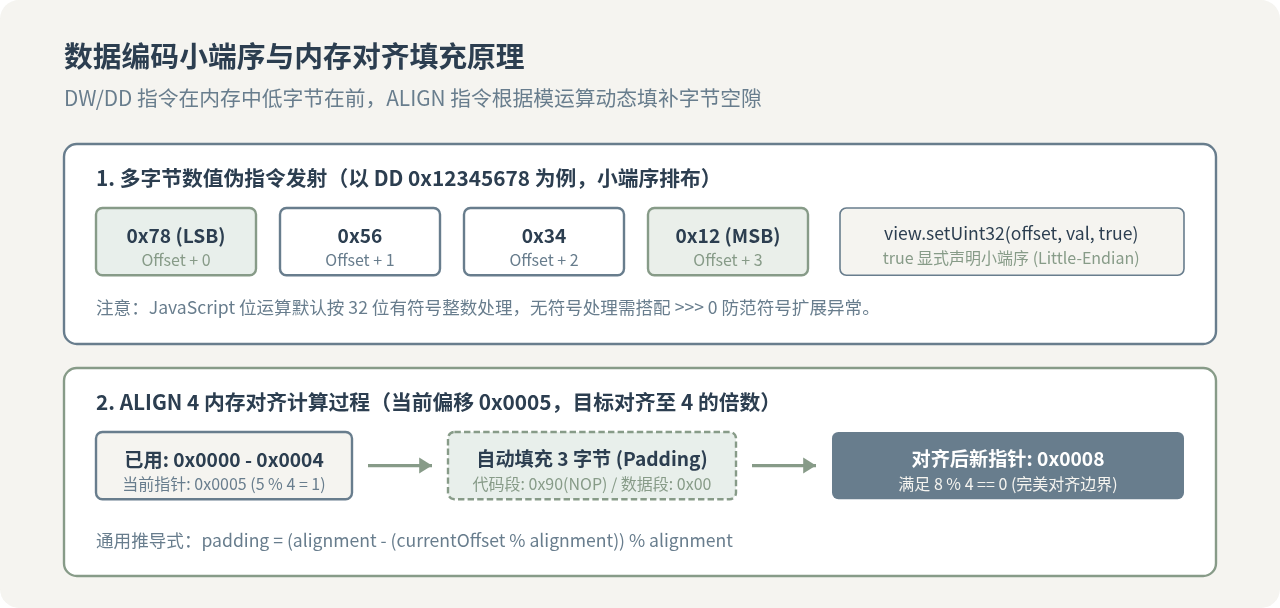
1. 上下文状态机与 DataView 写入实现
在浏览器或 Node.js 环境中,推荐预先分配一个可扩容的 ArrayBuffer,配合 DataView 实现精准字节序控制。以下为核心状态机及数据定义指令的完整 JavaScript 实现:
/**
 * x86 汇编器上下文状态机
 */
class AssemblerContext {
  constructor(initialCapacity = 65536) {
    this.buffer = new ArrayBuffer(initialCapacity);
    this.view = new DataView(this.buffer);
    this.bytes = new Uint8Array(this.buffer);
    this.locationCounter = 0; // 当前虚拟地址 ($)
    this.cursor = 0;          // 输出缓冲区物理写入偏移
    this.baseAddress = 0;     // ORG 基准地址
    this.symbolTable = new Map();
    this.textEncoder = new TextEncoder(); // 默认 UTF-8 / ASCII 转码
  }

  // 确保缓冲区容量充足
  ensureCapacity(extraBytes) {
    if (this.cursor + extraBytes > this.buffer.byteLength) {
      const newCapacity = Math.max(this.buffer.byteLength * 2, this.cursor + extraBytes);
      const newBuffer = new ArrayBuffer(newCapacity);
      new Uint8Array(newBuffer).set(this.bytes);
      this.buffer = newBuffer;
      this.view = new DataView(this.buffer);
      this.bytes = new Uint8Array(this.buffer);
    }
  }

  // 获取最终紧凑输出二进制
  getOutputBinary() {
    return this.bytes.slice(0, this.cursor);
  }
}
2. 多类型混合参数的 DB/DW/DD 处理
x86 汇编中,一条数据伪指令经常同时包含字符串、字符常量和数值(例如 DB "Version: ", 0x0A, 0x00)。处理器必须具备参数拆分与多态编码能力:
/**
 * 处理 DB (Byte - 8位) 伪指令
 */
function emitDB(context, operands, isPass2) {
  for (const op of operands) {
    if (typeof op === 'string') {
      // 处理以引号包围的字符串字面量
      const rawStr = op.replace(/^["']|["']$/g, '');
      const encoded = context.textEncoder.encode(rawStr);
      if (isPass2) {
        context.ensureCapacity(encoded.length);
        context.bytes.set(encoded, context.cursor);
        context.cursor += encoded.length;
      }
      context.locationCounter += encoded.length;
    } else if (typeof op === 'number') {
      // 8位整数,合法范围 -128 到 255
      const byteVal = op & 0xFF;
      if (isPass2) {
        context.ensureCapacity(1);
        context.view.setUint8(context.cursor, byteVal);
        context.cursor += 1;
      }
      context.locationCounter += 1;
    }
  }
}

/**
 * 处理 DW (Word - 16位) 伪指令,强制小端序 (Little-Endian)
 */
function emitDW(context, operands, isPass2) {
  for (const val of operands) {
    if (isPass2) {
      context.ensureCapacity(2);
      // DataView setUint16 第三个参数为 true 表示 Little-Endian
      context.view.setUint16(context.cursor, val & 0xFFFF, true);
      context.cursor += 2;
    }
    context.locationCounter += 2;
  }
}

/**
 * 处理 DD (DWord - 32位) 伪指令,强制小端序并处理无符号数值
 */
function emitDD(context, operands, isPass2) {
  for (const val of operands) {
    if (isPass2) {
      context.ensureCapacity(4);
      // val >>> 0 保证 32 位无符号整数表示正确
      context.view.setUint32(context.cursor, val >>> 0, true);
      context.cursor += 4;
    }
    context.locationCounter += 4;
  }
}
五、定位与对齐:ORG 与 ALIGN 的数学模型与段处理
1. ORG 指令处理
ORG <address>(Origin)用来指定后续代码或数据的加载起始基址。在平坦二进制输出中,ORG 并不代表在文件开头插入大量空白,而是将相对虚拟地址偏移进行重定位映射:
function handleORG(context, targetAddress) {
  context.baseAddress = targetAddress;
  context.locationCounter = targetAddress;
}
当随后定义标签 start: 时,context.symbolTable.set('start', context.locationCounter) 记录的便是 0x7C00,从而使所有引用 start 绝对地址的代码生成正确的内存指针。
2. ALIGN 对齐公式与填充码选择
为了提升 CPU 缓存行命中率或满足特定硬件规范(如内存描述符要求 4 字节或 16 字节对齐),汇编器需通过 ALIGN n 将位置计数器对其到 n 的整倍数。
对齐填充长度计算遵循通用模运算公式:
// 正确计算填充字节数:(n - (offset % n)) % n
function calculatePadding(currentOffset, alignment) {
  if ((alignment & (alignment - 1)) !== 0) {
    throw new Error(`ALIGN 基数必须为 2 的整数次幂,当前传入: ${alignment}`);
  }
  return (alignment - (currentOffset % alignment)) % alignment;
}
注意避免的数学陷阱:如果直接使用
alignment - (offset % alignment),当当前地址正好处于对齐边界时(如 offset = 8, alignment = 4),计算结果会是 4,从而导致汇编器非必要地多填充了 4 个字节!外层的 % alignment 能够确保在已对齐时补齐长度正确归零。
在填充字节的选择上,汇编器应具备上下文感知能力:
- 代码段(Code Section):填充
0x90,即 x86 的NOP(No Operation)单字节指令。若 CPU 指针因异常进入对齐区,执行NOP能平滑滑行到目标代码,避免因执行0x00 0x00(ADD [EAX], AL)导致非预期内存写入或段错误。 - 数据段(Data Section):填充
0x00,符合未初始化内存的标准约定。
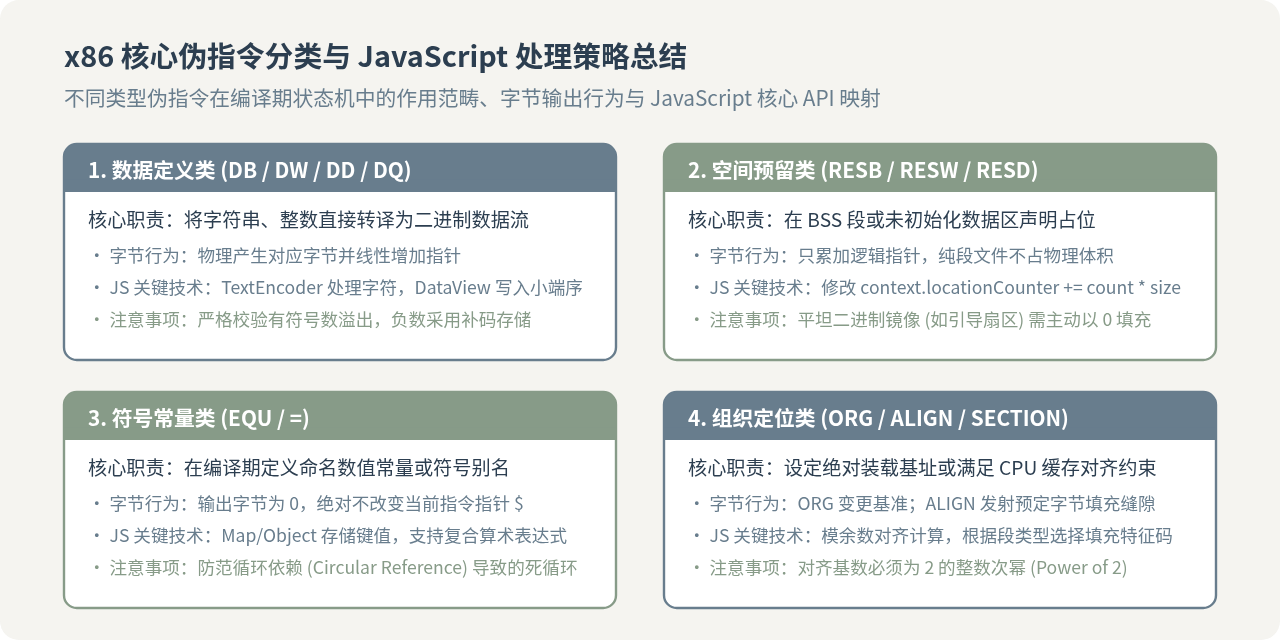
六、工程实践避坑指南
在完成基础实现后,实际解析复杂汇编程序时还需防范以下常见边界问题:
1. 字符串多字节与转义序列的字节长陷阱
使用 JavaScript 的 TextEncoder.encode() 处理字符串字面量时需格外小心。如果汇编源文件中包含中文或非 ASCII 字符,UTF-8 会将单个字符编码为 2 到 4 字节。但若汇编器旨在模拟纯 16 位 DOS 或 BIOS 环境(通常采用 CP437 或 ASCII 单字节字符集),直接调用 UTF-8 编码会导致字节计数超出预期。对于纯 ASCII 环境,建议建立单字节映射校验,对超出 0x7F 的字符显式抛出提示或按指定代码页转码。
2. 宏指令与重复定义 TIMES 的处理
在 NASM 语法中,常见的 times 510 - ($ - $$) db 0 实际上是结合了位置计数器 $ 与段起始 $$ 的复合伪指令。在 JavaScript 汇编器中,必须先对 510 - (context.locationCounter - context.baseAddress) 进行 AST 表达式求值,求出循环计数值,再复用 emitDB 逻辑完成批量填充。
3. EQU 表达式的拓扑依赖防范
EQU 语句允许引用其他符号,例如 BUF_LEN EQU DATA_END - DATA_START。在第一遍扫描时,若符号引用的定义出现在当前行之后,直接求值会导致 NaN 或报错。工程上的解法是将未决表达式以抽象语法树(AST)节点形式挂载在符号表中,在第一遍扫描末尾进行依赖拓扑排序解析;若检测到环形引用(Circular Dependency),则及时抛出编译错误。
通过清晰划分两遍扫描职责、严格把控 DataView 小端序参数、并在状态机中统一维护地址计数器与物理输出流,使用 JavaScript 能够高效、健壮地实现完整的 x86 汇编器伪指令解析引擎。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章