
深入解析JavaScript是否支持中文作为变量名,从ECMAScript语法规范、Unicode标识符分类(UAX #31)到底层词法分析器解析机制,辅以完整代码示例、易错边界排查及工程实践建议。

当前位置:首页 > JavaScript 基础 > 正文
JavaScript可以用中文做变量名吗?Unicode标识符支持解析
作者:青柠
时间:2026-11-21
浏览:201
文章目录
规范标准:ECMAScript 2015+ (ECMA-262)
Unicode 规范:UAX #31
技术领域:JavaScript 语法解析与工程实践
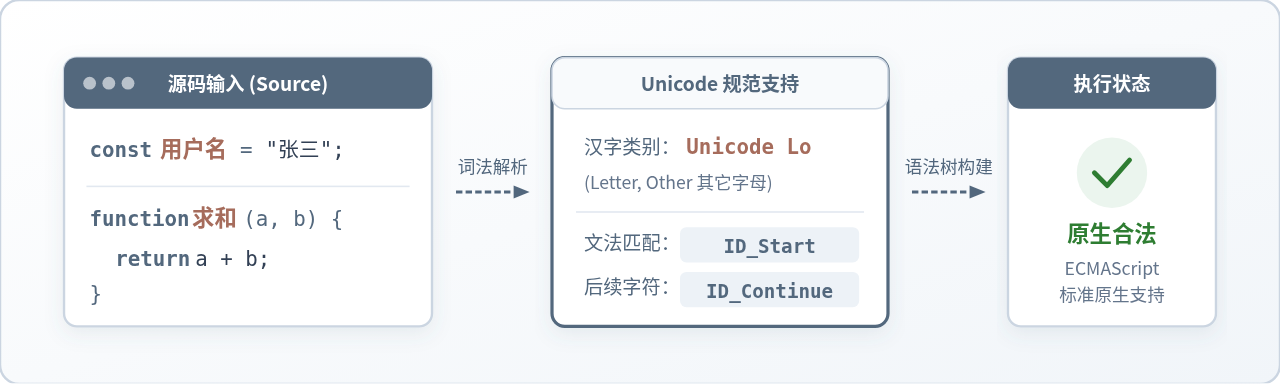
核心答案:完全可以。在现代 JavaScript(ECMAScript 规范)中,中文汉字属于合法的标识符字符(Identifier)。你可以直接使用中文命名变量、常量、函数、类名以及对象属性,JavaScript 引擎在词法分析阶段便能原生解析并构建语法树,无需任何插件或转译工具。
一、为什么 JavaScript 能识别中文变量名?
很多刚接触编程的开发者下意识地认为“代码只能用英文字母编写”,甚至担心中文变量名会导致浏览器报错。这种误解主要源自早期 C 语言、C++ 等经典编译器默认基于 ASCII 字符集构建词法规则的历史惯性。
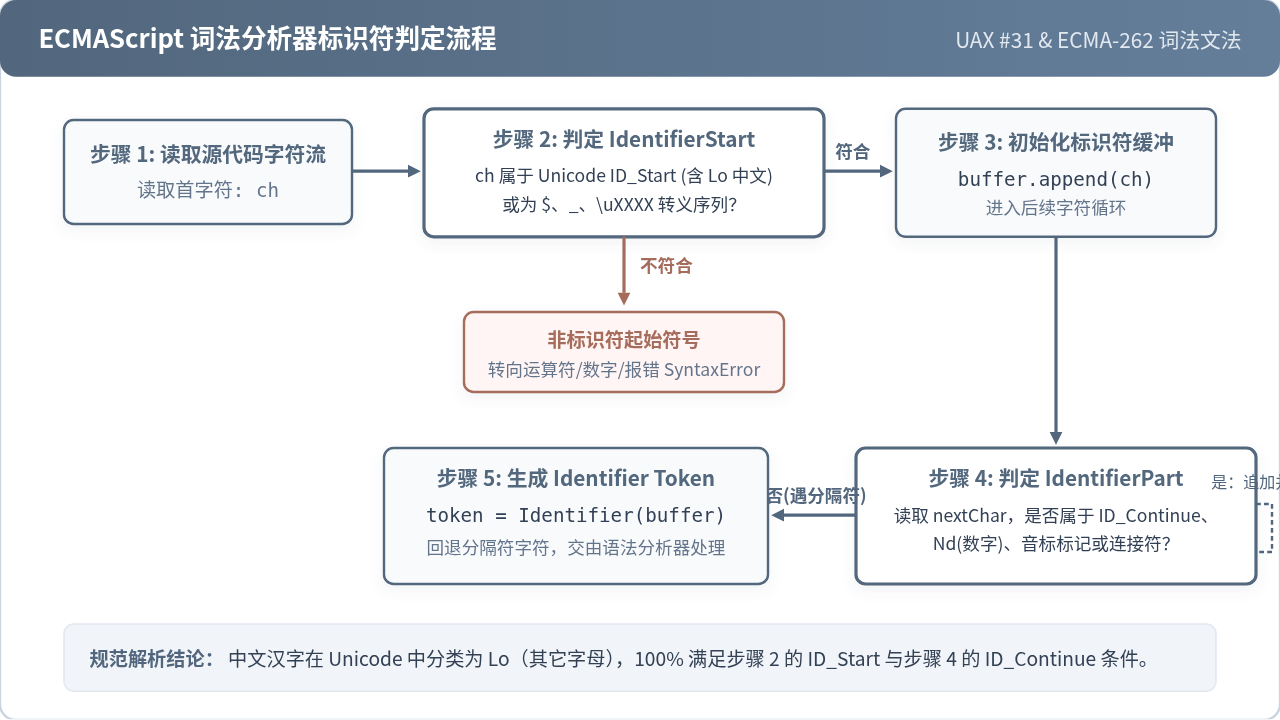
JavaScript 早在诞生初期就将 Unicode 纳入了语言底层设计。根据 ECMA-262(ECMAScript 语言规范)第 12 章“词法文法(Lexical Grammar)”中关于标识符名称(IdentifierName)的定义,JavaScript 的标识符命名规则直接遵循 Unicode 联盟发布的 Unicode 标准附录第 31 号(Unicode Standard Annex #31: Unicode Identifier and Pattern Syntax)。
在词法规则中,一个合法的 JavaScript 变量名由两个文法产生式决定:
IdentifierStart(标识符起始字符):决定变量名的第一个字符是否合法。合规范围包括所有 Unicode 字符分类中的ID_Start属性字符、ASCII 字母(a-z,A-Z)、美元符号($)、下划线(_)以及对应的 Unicode 转义序列(如\uXXXX)。IdentifierPart(标识符后续字符):决定首字符之后的其余字符是否合法。除了继承IdentifierStart的全部合法字符外,还扩展纳入了ID_Continue、十进制数字类(Nd)、音标与注音结合标记(Mn/Mc)、连接标点(Pc)以及零宽连字/非连字控制符(ZWJ/ZWNJ)。
在 Unicode 字符数据库(UCD)中,中文汉字被归类为 “Lo”(Letter, other,其它字母)。按照 Unicode 规范标准,所有的 Lo 类别字符均天然具有 ID_Start 和 ID_Continue 属性。因此,从语法引擎的角度来看,汉字“名”与英文字母“a”在词法规则上拥有完全等价的语法地位。
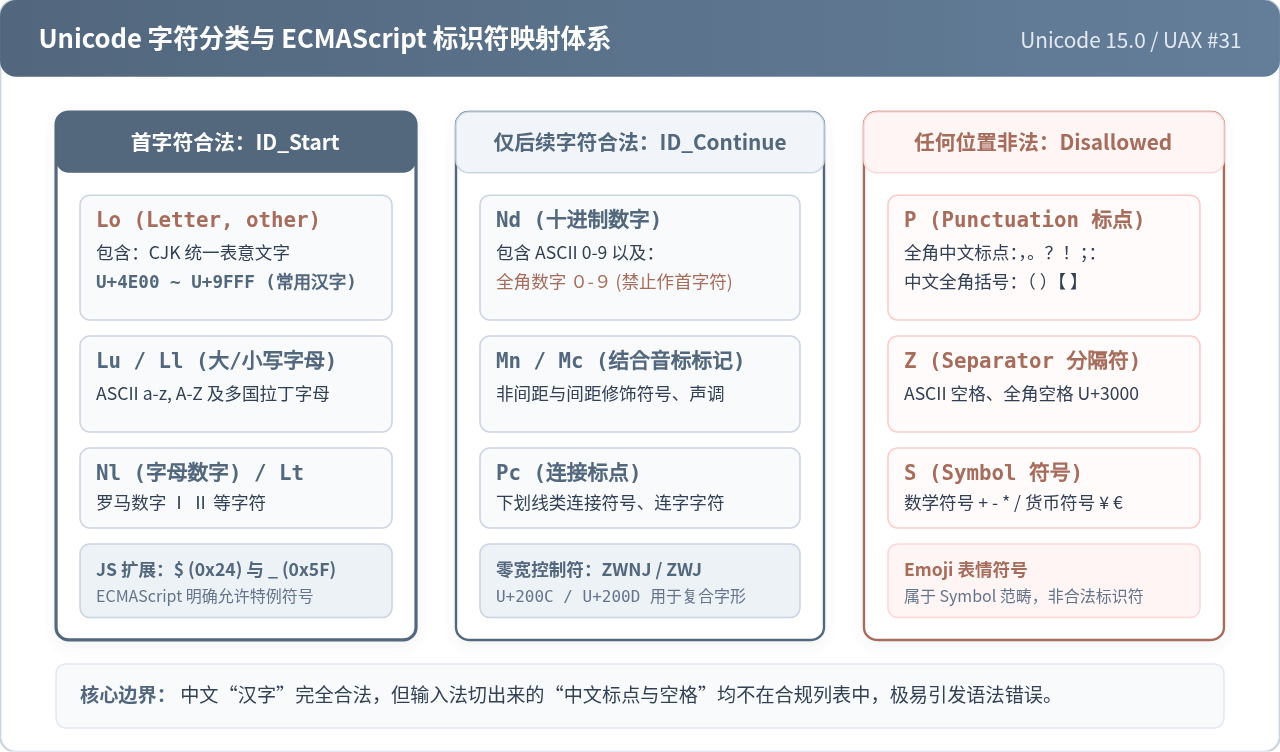
二、Unicode 字符分类与 ECMAScript 映射体系
为了精准把握中文在 JavaScript 中的合法边界,理解 Unicode 的大类划分至关重要。Unicode 将全球符号划分为字母(L)、标点(P)、数字(N)、分隔符(Z)和符号(S)等主要类别。JavaScript 引擎的词法分析器正是根据这些类别决定字符是否允许进入标识符。
| Unicode 分类标识 | 分类中文名称 | 典型字符示例 | 在 JS 标识符中的语法有效性 |
|---|---|---|---|
| Lo (Letter, other) | 其它字母(核心表意文字) | 汉字(“用”、“户”、“数”)、日文假名、韩文字母 | 完全合法:既可作起始字符,也可作后续字符 |
| Lu / Ll | 大写字母 / 小写字母 | A-Z, a-z, 希腊字母 α, β | 完全合法:标准的起始与后续字符 |
| Nd (Decimal number) | 十进制数字 | ASCII 数字 0-9、全角数字 0-9 | 部分合法:只可作为后续字符,不可作为首字符 |
| Po / Ps / Pe | 各类标点符号 | 中文句号(。)、逗号(,)、书名号(《》) | 非法:不能在标识符任意位置出现 |
| Zs (Space separator) | 空格与空白分隔符 | 半角空格(\u0020)、中文全角空格(\u3000) | 非法:会被识别为词法分词标记或语法空白 |
从上表可以清晰看出,中文“汉字”和中文“标点/空格”在 Unicode 体系中处于完全不同的类别。这是理解后续语法报错的关键所在。
三、中文标识符在 JavaScript 中的实际代码应用
在日常 JavaScript 开发中,所有支持标识符名称(IdentifierName)的语法结构均可以直接使用中文。以下提供涵盖变量声明、函数定义、面向对象类、对象字面量与解构赋值的完整示例:
// 1. 基础变量与常量声明
const 网站名称 = "前端技术知识库";
let 访问计数 = 1024;
let 已登录 = true;

// 2. 函数声明、形参与返回值
function 计算折扣价格(原价, 折扣率) {
  if (折扣率 <= 0 || 折扣率 > 1) {
    throw new Error("折扣率必须在 0 到 1 之间");
  }
  const 最终价格 = 原价 * 折扣率;
  return 最终价格;
}

// 3. 面向对象类(Class)定义与继承
class 电子商务订单 {
  constructor(订单编号, 金额) {
    this.订单编号 = 订单编号;
    this.金额 = 金额;
    this.状态 = "待支付";
  }

  标记为已支付() {
    this.状态 = "已支付";
    return `订单 ${this.订单编号} 状态更新为: ${this.状态}`;
  }
}

// 4. 对象字面量与解构赋值
const 用户信息 = {
  姓名: "王小明",
  角色: "系统管理员",
  权限等级: 9
};

const { 姓名, 角色 } = 用户信息;
console.log(姓名); // 示例输出: "王小明"

const 新订单 = new 电子商务订单("ORD-20261117-01", 299);
console.log(新订单.标记为已支付()); // 示例输出: "订单 ORD-20261117-01 状态更新为: 已支付"
以上代码在 Node.js、Chrome V8、Firefox SpiderMonkey、Safari JavaScriptCore 等所有现代运行时中均可直接执行,不会产生任何解析差异或性能损耗。
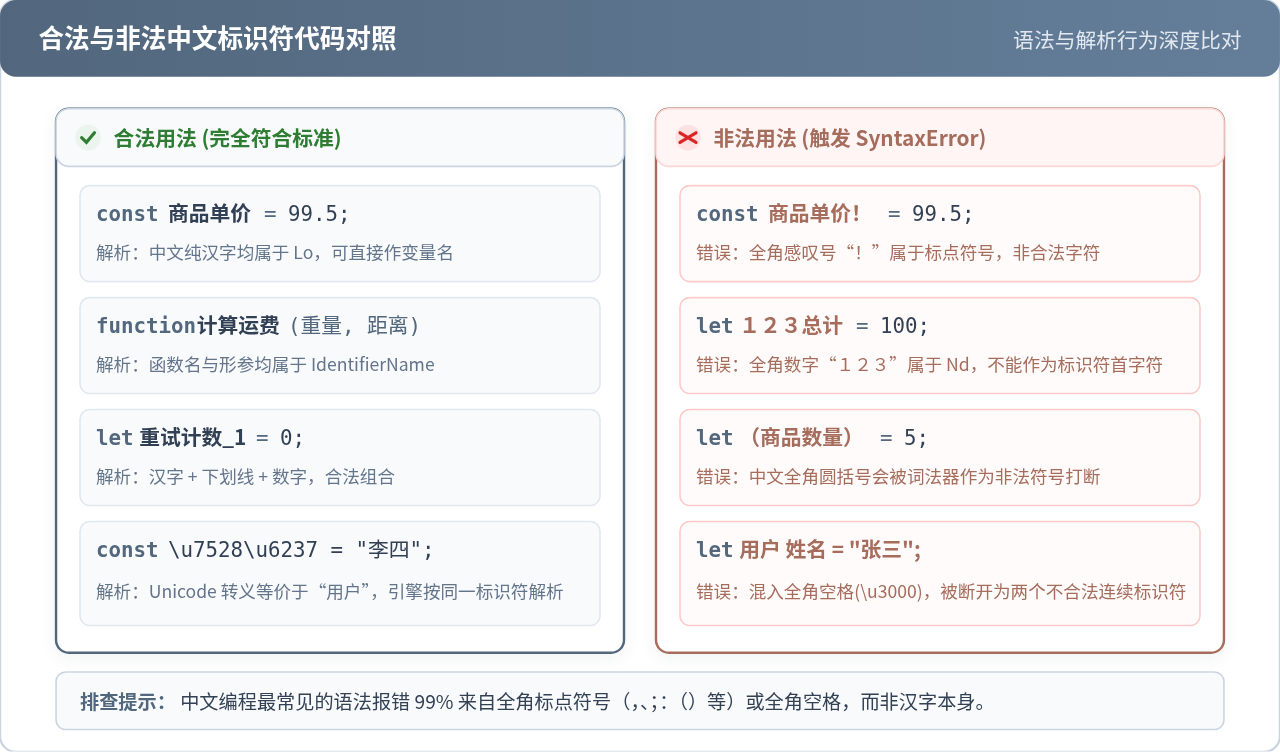
四、容易引发语法错误的四大陷阱与边界排查
既然中文在规范中完全合法,为什么部分开发者在尝试输入中文变量名时会遭遇 Uncaught SyntaxError: Invalid or unexpected token 报错?绝大多数情况下,问题并非出在“中文汉字”上,而是出在输入法伴随的附加字符上:
1. 全角中文标点符号误输入
这是触发语法报错最高频的原因。中文输入状态下,逗号 ,(U+FF0C)、冒号 :(U+FF1A)、分号 ;(U+FF1B)、圆括号 ()(U+FF08/U+FF09)均属于 Unicode 标点符号类(Punctuation)。例如:
// 错误示例:误输入中文全角逗号
let 名字,年龄; // SyntaxError: Unexpected token ','

// 正确示例:变量名保持中文,语法分隔符使用半角英文逗号
let 名字, 年龄;
2. 中文全角空格(U+3000)混入
在中文输入法处于全角排版模式时,敲击空格键会生成全角空格(Unicode 编码 \u3000,属于 Zs 分类)。虽然现代 ECMAScript 已经将 \u3000 识别为合法空白分隔符(White Space),但如果全角空格夹在变量名中间,引擎会将其切分为两个独立的标识符,从而报出语法错误:
// 错误示例:中间混入了全角空格
let 用户 地址 = "北京市"; // SyntaxError: Unexpected identifier '地址'

// 正确示例:保持连续或使用半角下划线连接
let 用户地址 = "北京市";
let 用户_地址 = "北京市";
3. 全角数字充当首字符
全角数字 0-9(U+FF10 ~ U+FF19)在 Unicode 中属于 Nd(Decimal Number)。根据前文提到的文法产生式,数字属于 IdentifierPart 而不是 IdentifierStart。因此,全角数字不能放在变量名的开头,只能放在后续位置:
// 错误示例:全角数字作起始字符
const 1号商品 = "苹果"; // SyntaxError: Invalid or unexpected token

// 正确示例:数字位于汉字之后
const 商品1号 = "苹果"; // 完全合法
4. 源码文件编码格式与 Unicode 转义等价性
JavaScript 源码必须以 UTF-8 字符编码格式保存。如果开发编辑器错误采用了 GB2312、GBK 或 ISO-8859-1 等传统单字节/双字节编码,中文字符在读取时可能被损坏为乱码字节序列,进而导致词法解析失败。
Unicode 转义序列验证:在 JavaScript 中,任何标识符都可以用十六进制转义表示。例如汉字“测试”的 Unicode 码点分别为
\u6d4b 和 \u8bd5。在控制台运行 let \u6d4b\u8bd5 = 100; console.log(测试);,你会发现它准确输出了 100。这进一步印证了引擎解析器是在 Unicode 码点层面同等对待标识符的。
五、工程实践中的权衡:何时该用?何时应避免?
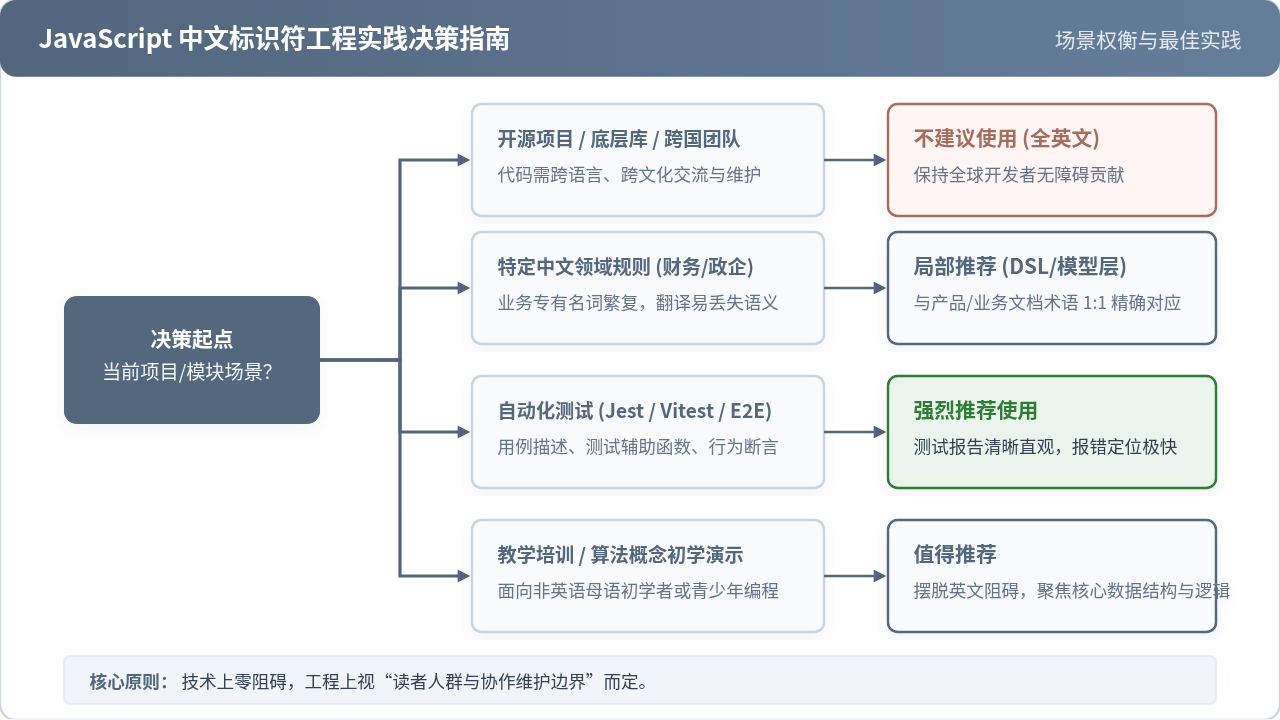
通过前面的解析,我们已经明确:在语法层面,中文做变量名毫无阻碍;但在工程协作层面,它是一把需要审慎评估的双刃剑。
1. 为什么主流开源项目依然遵循全英文规范?
- 国际化协作门槛:开源软件与全球协作团队成员来自不同母语背景。全英文标识符是软件工程通用的最低沟通成本约定,能够确保世界各地的开发者都能顺畅阅读代码和提交 Pull Request。
- 输入法频繁切换成本:在编写代码时,关键字(
const,if,return)和语法标点必须为半角英文字符。如果变量名使用中文,开发者必须频繁在中文输入法与英文状态之间切换,容易降低输入流畅度并增加敲错全角符号的概率。 - 历史遗留工具链兼容性:虽然现代前端打包工具(Webpack、Vite、Rollup、Esbuild)均已深度支持 UTF-8,但部分极老旧的 CI/CD 命令行容器、日志收集服务或终端若环境 LANG 未配置 UTF-8,在输出错误堆栈时可能遭遇乱码。
2. 中文标识符具有显著价值的实用场景
跳出“全盘否定”的思维定势,在以下特定业务与研发环节中,适度使用中文标识符往往能带来极高的实用价值:
- 单元测试与 E2E 行为描述(强烈推荐):在 Jest、Vitest、Playwright 等测试套件中,测试用例函数与夹具如果用长串蹩脚的英文命名,往往难以精准表达复杂的业务边界。直接使用中文描述能够让测试报告一目了然:
describe("用户积分结算引擎", () => { it("当用户为黄金会员且订单满300元时,应赠送双倍积分", () => { const 模拟用户 = 创建黄金会员用户(); const 计算结果 = 计算订单奖励(模拟用户, 350); expect(计算结果.赠送积分).toBe(700); }); }); - 复杂领域驱动设计(DDD)与本土专业规则模型:在财务核算、税收计算、中国特色行政审批或医保报销规则中,存在大量高度本土化的专业术语(如“进项税额转出”、“计税依据”、“专项附加扣除”)。强行将其翻译为非标准英文,不仅团队成员难以形成统一共识,还极易丢失业务语义。在领域模型层直接建立中文对象属性与业务方法,可以使代码与业务规范文档实现真正的 1:1 映射。
- 青少年编程与算法教学演示:在向刚接触编程的初学者讲解快速排序、二叉树遍历或递归原理时,去除英文词汇的心智负担,让变量名直接呈现为“左子树”、“右子树”、“基准值”,能让学员将 100% 的精力聚焦在算法逻辑的推导与数据结构的流动上。
总结
回到文章开头的核心问题:JavaScript 完全可以用中文做变量名。这项能力并非某种取巧的黑魔法,而是 ECMAScript 语言规范基于 Unicode 标准体系(UAX #31)赋予开发者的正统语言特性。
在日常开发中,无需对中文标识符抱有语法层面的顾虑。日常遇到的语法错误大多来自全角标点与空格,只需在编辑器中注意输入法状态即可彻底避免。在架构决策上,建议在通用公共库和跨国开源协作中保持全英文规范;而在自动化测试、复杂领域核心算法及内部教学演示中,合理运用中文命名,能够显著提升代码的可读性与业务表达力。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章