
详细讲解在Node.js环境下使用xml2js库解析XML数据的完整流程,涵盖依赖安装、异步Promise解析、核心配置调优、属性与数组处理以及异常排错方案。

当前位置:首页 > Node.js 基础 > 正文
Node.js中怎么使用xml2js库解析XML数据
作者:夜航船
时间:2026-11-20
浏览:488
文章目录
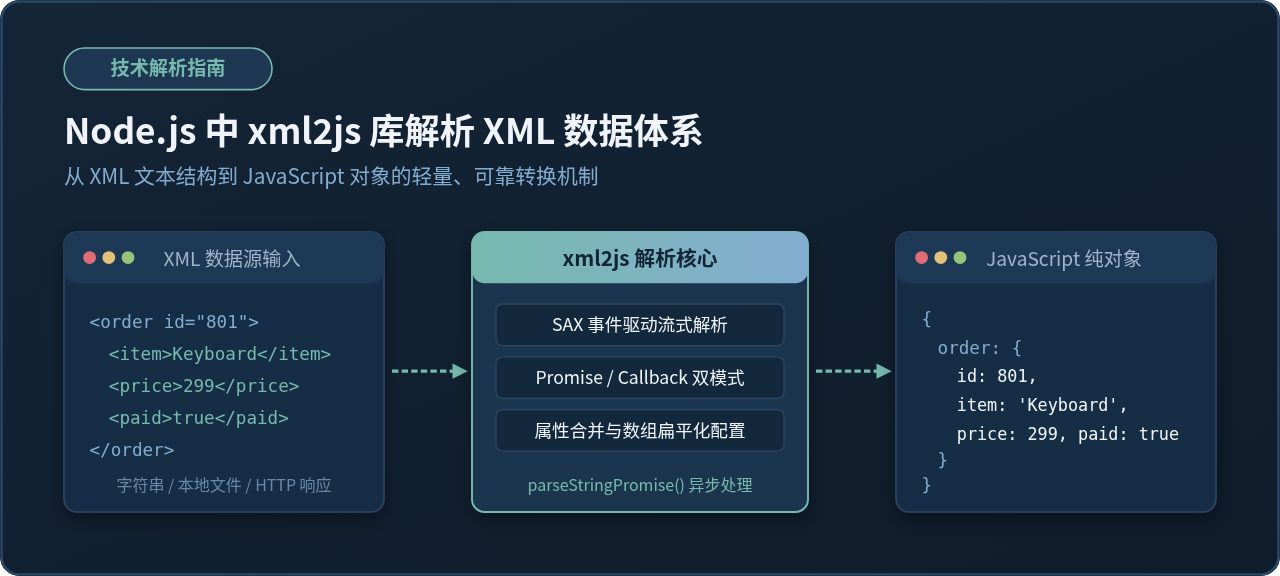
在开发与第三方接口对接的服务时,例如微信支付早期回调、企业级 SOAP WebService、电信运营商接口或 RSS/Atom 订阅源,XML 依然是高频出现的数据承载格式。Node.js 原生仅提供了对 JSON 的一等公民支持,并未在标准库中内置轻量好用的 XML 解析模块。xml2js 是 Node.js 生态中最成熟且广泛应用的 XML 转 JavaScript 对象工具库。它底层基于 SAX 流式事件驱动解析器,既能以极低的内存开销完成复杂嵌套 XML 的结构化转换,又同时提供了传统回调与现代 Promise 风格的双向接口。本文将从安装准备、异步核心用法、结构映射机制、参数调优到生产级异常处理,完整阐述其使用方法。
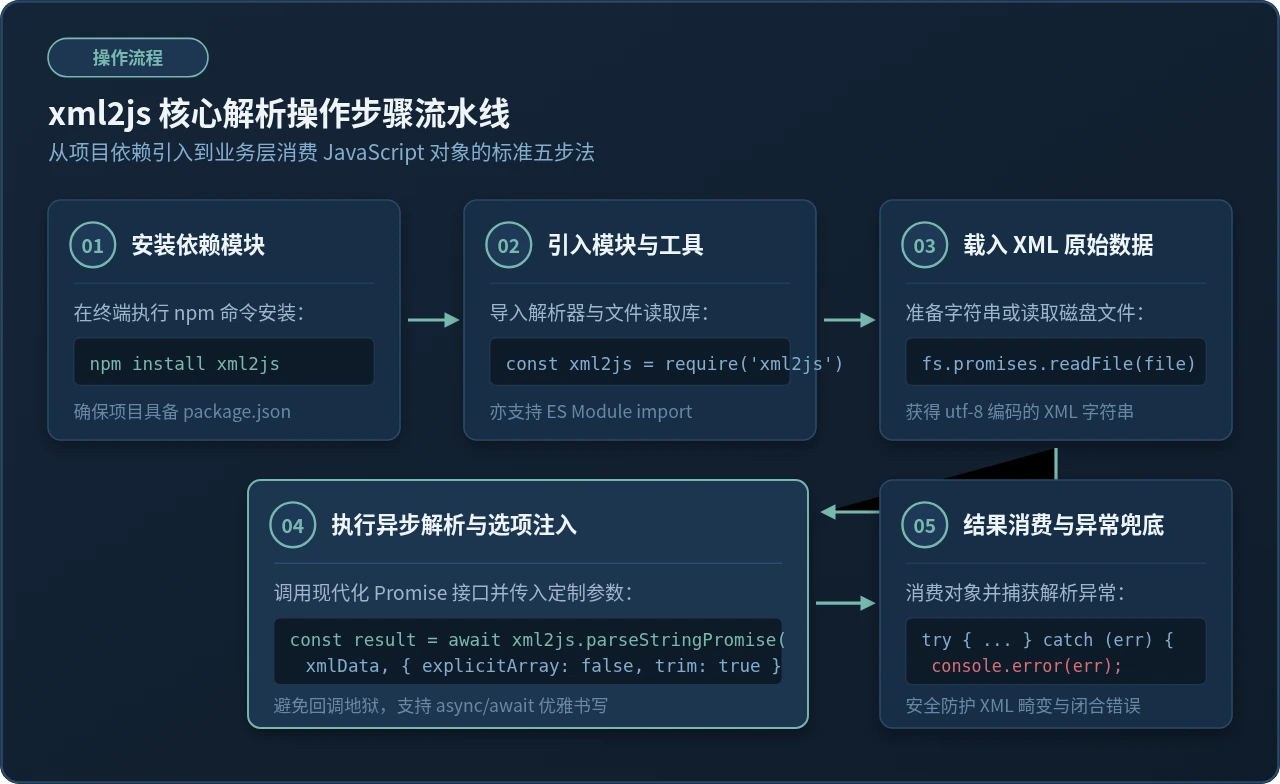
一、准备工作与安装配置
使用 xml2js 前,需确保本地已安装 Node.js(推荐 LTS 版本)。该库为纯 JavaScript 实现,依赖极少,无需配置 node-gyp 或本地 C++ 编译工具链,因此在不同操作系统中都能快速安装部署。
在项目的根目录下打开终端,执行以下 npm 命令将其写入依赖列表:
# 通过 npm 安装核心依赖
npm install xml2js

# 若使用 TypeScript 开发,可额外安装类型声明文件(可选)
npm install --save-dev @types/xml2js安装完成后,xml2js 暴露了多个核心接口:
xml2js.parseString(str, [options], callback):经典的事件回调解析函数。xml2js.parseStringPromise(str, [options]):返回标准 Promise 的现代解析方法,全面适配async/await。xml2js.Parser([options]):面向对象风格的解析器类,适合在需要复用相同配置解析多个文档的场景下实例化。
二、基础解析操作:从 XML 到 JavaScript 对象
在实际业务中,获取到的 XML 数据通常来自 HTTP 响应体字符串,或者由 fs 模块从磁盘中读取。最推荐的编写方式是使用基于 Promise 的 parseStringPromise 方法配合 async/await,代码结构直观且易于进行错误捕获。
2.1 解析 XML 字符串示例
假设我们接收到一段表示书籍信息的 XML 报文:
const xml2js = require('xml2js');

const xmlString = `<bookstore>
  <book id="bk01" category="tech">
    <title lang="zh">Node.js实战</title>
    <author>张三</author>
    <price>79.00</price>
  </book>
</bookstore>`;

async function parseXmlExample() {
  try {
    const result = await xml2js.parseStringPromise(xmlString);
    console.log(JSON.stringify(result, null, 2));
  } catch (err) {
    console.error('XML 解析失败:', err.message);
  }
}

parseXmlExample();
执行输出解析:
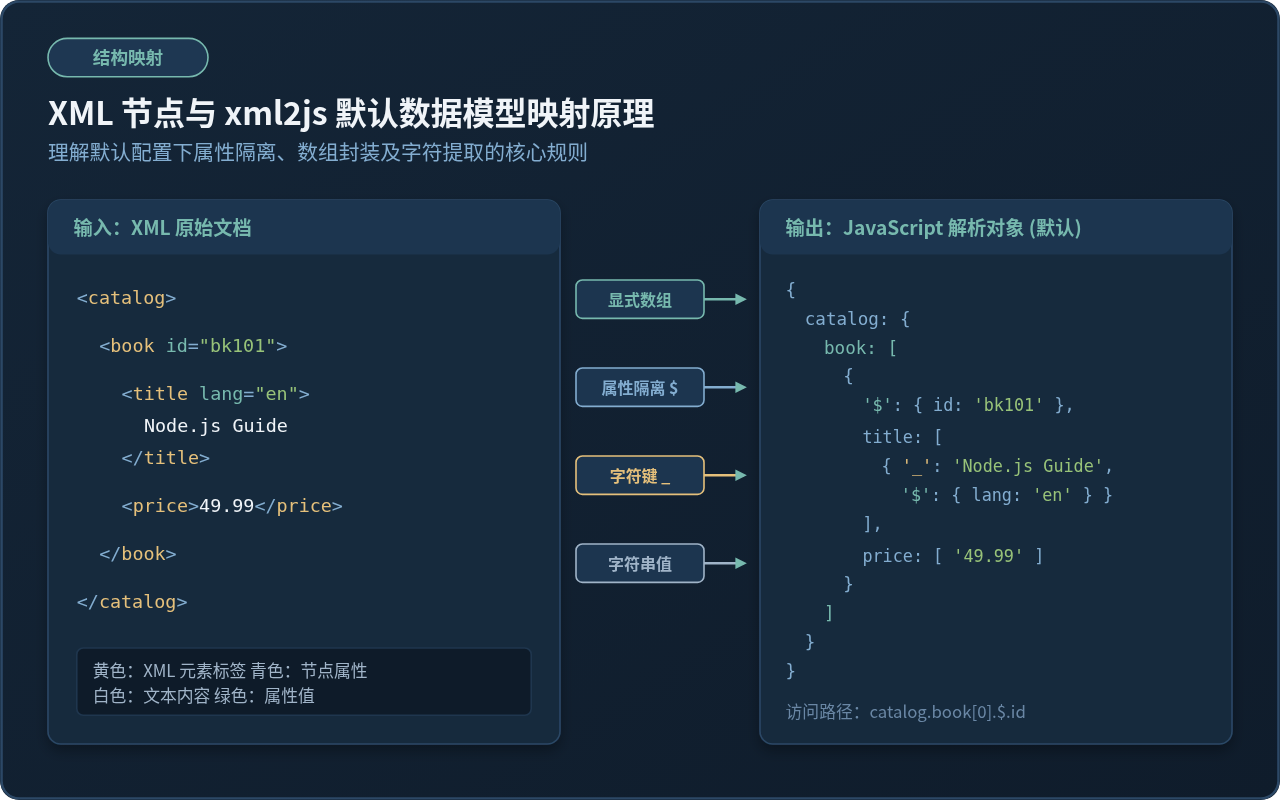
在默认无配置状态下,输出的 JavaScript 对象格式如下:
{
  "bookstore": {
    "book": [
      {
        "$": { "id": "bk01", "category": "tech" },
        "title": [
          {
            "_": "Node.js实战",
            "$": { "lang": "zh" }
          }
        ],
        "author": [ "张三" ],
        "price": [ "79.00" ]
      }
    ]
  }
}
2.2 读取并解析外部 XML 文件
当 XML 存储在磁盘中(例如配置文件 config.xml),可以结合 Node.js 原生的 fs/promises 模块直接异步读取文件内容后再交由 xml2js 解析:
const fs = require('fs/promises');
const path = require('path');
const xml2js = require('xml2js');

async function readAndParseFile(filePath) {
  try {
    // 明确指定 utf-8 编码,防止读入 Buffer 导致隐式类型问题
    const fileContent = await fs.readFile(filePath, 'utf-8');
    const data = await xml2js.parseStringPromise(fileContent);
    return data;
  } catch (err) {
    console.error(`读取或解析文件 ${filePath} 出错:`, err);
    throw err;
  }
}
三、进阶调优:定制解析规则与简化数据结构
从上一节的解析结果可以看出,xml2js 默认的映射规则具有以下两个显著特点:
- 所有子节点全量封装为数组:即使 XML 中某个标签只出现了一次(例如
<author>张三</author>),默认也会被转换为包含单项的数组["张三"]。这保证了在 Schema 未知时,动态增加多个同名标签不会导致数据结构从标量跳变为数组,但极大增加了读取路径的复杂性(每次都必须加[0]索引)。 - 属性独立存储在
$对象中:XML 标签上的属性(如category="tech")被单独收敛到名为$的内部键中;若文本节点自身带有属性,则文本内容会保存在_字段中。
为了使生成的 JavaScript 对象更加扁平、直观,贴近普通 JSON 对象的访问习惯,xml2js 提供了多种强大的配置项。
3.1 常用核心配置项解析
| 配置属性 | 默认值 | 作用说明 |
|---|---|---|
explicitArray |
true |
设为 false 时,如果子节点只有一个,直接解包为单一值或单对象,不再包装成长度为 1 的数组。 |
mergeAttrs |
false |
设为 true 时,会将属性直接合并到同级对象属性中,省去 .$ 层级。 |
ignoreAttrs |
false |
设为 true 时,解析过程中完全忽略 XML 节点上的属性,只保留标签及文本值。 |
trim |
false |
设为 true 时,自动修剪文本内容首尾的多余空白字符与换行。 |
explicitRoot |
true |
设为 false 时,剥离外层根节点包装,直接以根节点的子级作为返回对象顶层。 |
valueProcessors |
[] |
用于对文本内容做转换的函数数组,例如自动将数值字符串转为 Number、布尔转为 Boolean。 |
3.2 使用自定义 Parser 实例优化数据结构
在生产项目中,最常用的做法是创建带有调优参数的 Parser 实例,并配合 xml2js.processors 自动完成数据类型转换:
const xml2js = require('xml2js');

// 引入内置的数值与布尔转换处理器
const { parseNumbers, parseBooleans } = xml2js.processors;

const customParser = new xml2js.Parser({
  explicitArray: false, // 扁平化单元素数组
  mergeAttrs: true,     // 属性直接平铺到对象中
  trim: true,           // 去除换行与前后空格
  valueProcessors: [parseNumbers, parseBooleans] // 自动转 Number/Boolean
});

const xmlData = `<device id="D102" online="true">
  <name>Gateway</name>
  <port>8080</port>
</device>`;

async function parseCustomExample() {
  const result = await customParser.parseStringPromise(xmlData);
  console.log(result);
}

parseCustomExample();
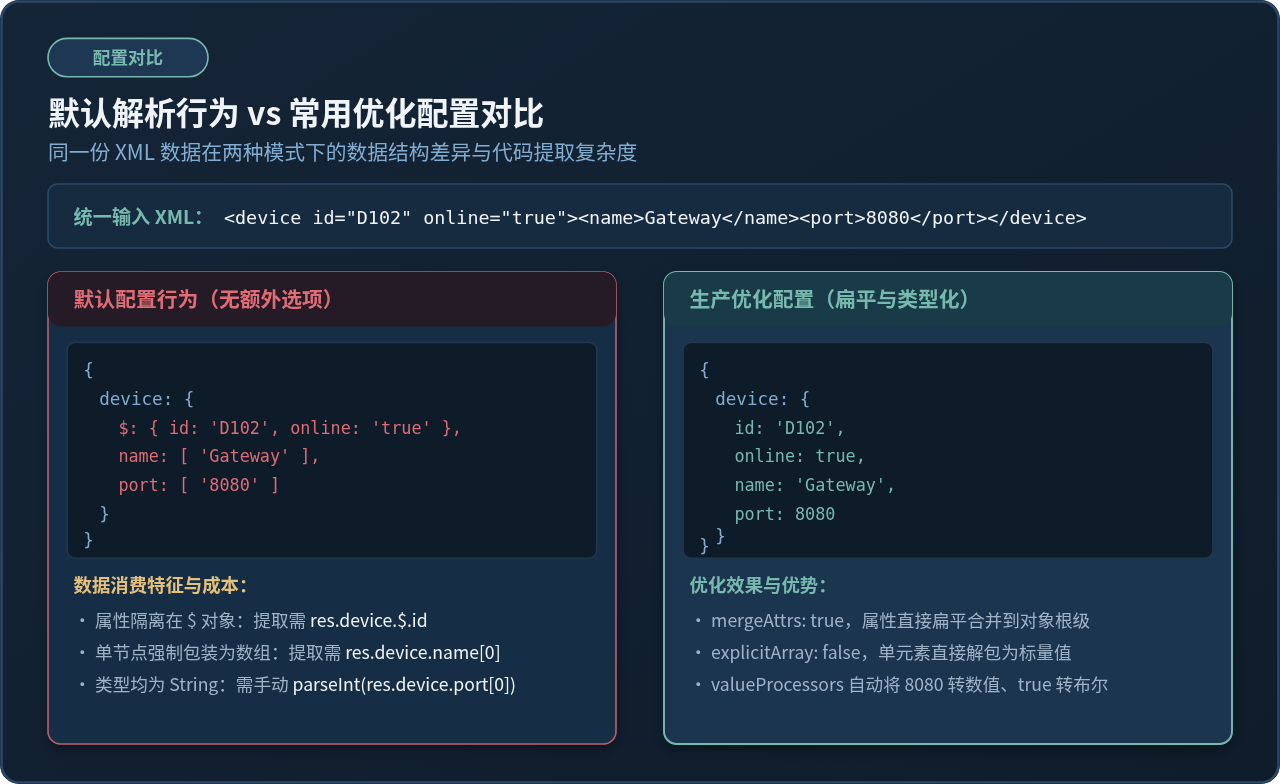
调优后的精简输出结果:
{
  "device": {
    "id": "D102",
    "online": true,      // 成功转为原生 Boolean
    "name": "Gateway",   // 自动脱去单元素数组外壳
    "port": 8080         // 成功转为原生 Number
  }
}
此时访问端口只需直接调用 result.device.port,不再需要编写繁琐且易错的 parseInt(result.device.port[0])。
四、异常处理与边缘场景排错
由于 XML 具有严格的语法标准,任何标签未正确闭合、特殊字符未转义或编码异常都会导致解析器抛出错误。在服务器运行时,必须对异常进行稳妥隔离,以防止单个脏数据导致整个进程崩溃。
4.1 非法 XML 语法错误拦截
当传入的 XML 片段损坏时,xml2js 会抛出 Non-whitespace before first tag 或 Unclosed root tag 等错误。在使用 parseStringPromise 时,应当始终使用 try...catch 包裹:
async function safeParseXml(rawXml) {
  if (!rawXml || typeof rawXml !== 'string') {
    throw new Error('无效的输入:XML 数据必须为非空字符串');
  }

  try {
    // 清除潜在的文件头 BOM 字符 ()
    const cleanXml = rawXml.replace(/^\uFEFF/, '').trim();
    return await xml2js.parseStringPromise(cleanXml, { explicitArray: false });
  } catch (err) {
    console.error('[XML_PARSE_ERROR] 语法解析异常:', err.message);
    return null; // 或按业务约定抛出自定义业务异常
  }
}
4.2 特殊字符与 CDATA 区块处理
XML 规定 &、<、>、"、' 为特殊预留实体。在包含 HTML 富文本或带有特殊符号的文本时,通常应将内容置于 <![CDATA[ ... ]]> 区块内。xml2js 原生支持 CDATA 节点的解析,会默认将 CDATA 内部的原始内容完整提取为字符串,不会触发特殊字符语法报错。
4.3 GBK / GB2312 等非 UTF-8 编码处理
部分老旧银行或政企接口返回的 XML 使用 GBK 或 GB2312 编码。xml2js 底层期待接收标准的 UTF-8 字符串输入。如果在读取二进制 Buffer 时直接将其转为普通字符串,中文字符会出现乱码甚至破坏 XML 标签。此时需要借助 iconv-lite 库先进行解码:
const iconv = require('iconv-lite');
const axios = require('axios');

async function fetchGbkXml(url) {
  // 必须以 arraybuffer 接收原始二进制流
  const response = await axios.get(url, { responseType: 'arraybuffer' });

  // 显式以 gbk 解码为 JS 原生字符串
  const xmlString = iconv.decode(response.data, 'gbk');

  // 交付 xml2js 解析
  return await xml2js.parseStringPromise(xmlString, { explicitArray: false });
}
五、实战总结与工作流体系
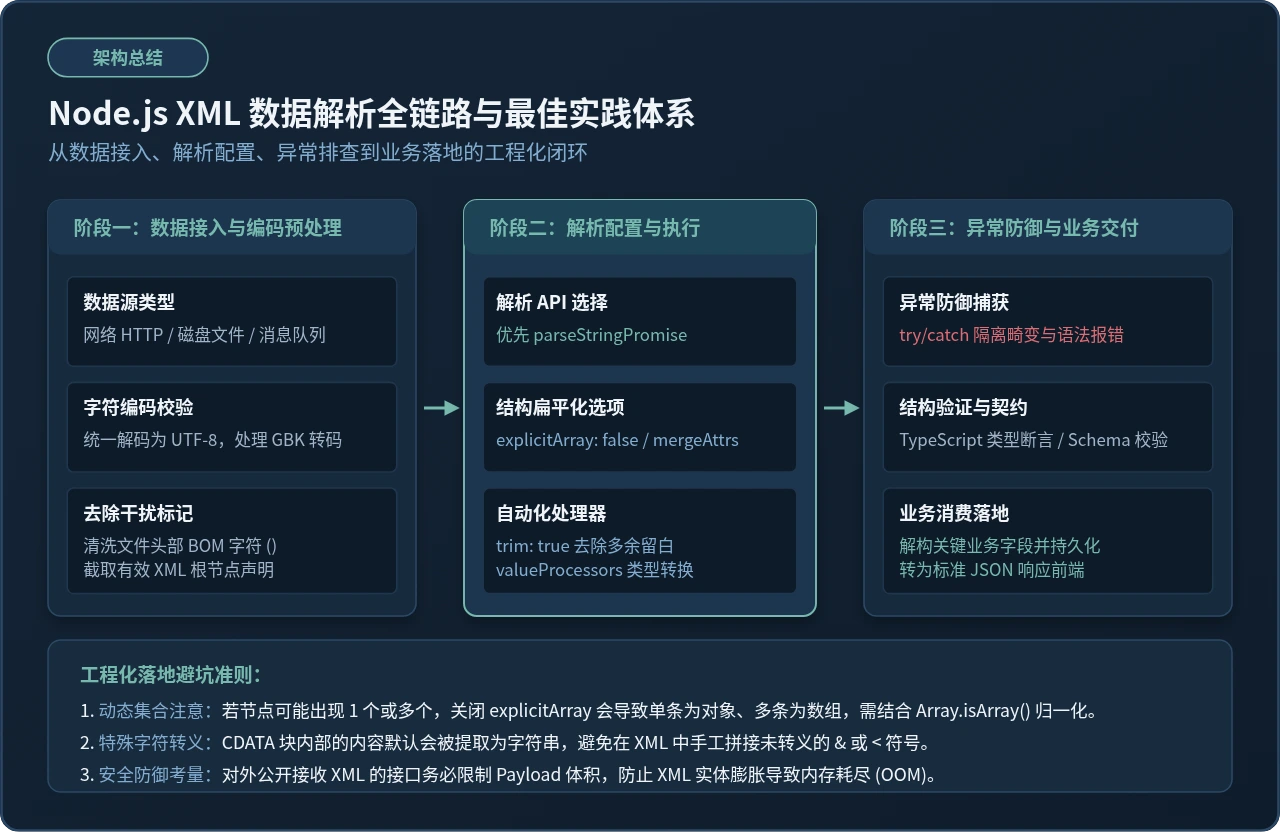
在 Node.js 中使用 xml2js 解析 XML 数据,核心在于明确数据输入契约并合理权衡数据结构扁平化选项:
- 对于接口文档明确、每个标签数量固定的场景,开启
explicitArray: false和mergeAttrs: true能极大降低后续访问属性时的心智负担与冗余代码。 - 对于可能包含动态数组(有时只有 1 项,有时有多项)的列表型数据,注意如果关闭了
explicitArray,单项时会被解析为对象,多项时会被解析为数组。在业务代码中应配合[].concat(data.items)或Array.isArray()进行统一兜底。 - 在公开暴露接收 XML 的服务端口上,应当在接入层对请求体限制大小(例如通过 Express 的
limit: '2mb'),防止遭遇畸形恶意超大 XML 造成的计算与内存资源耗尽攻击。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章