
深入解析JavaScript中数组简单倒序(reverse)与sort降序排列的核心区别,涵盖底层工作原理、代码示例、执行步骤、常见认知陷阱以及ES2023不可变操作最佳实践。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS数组简单倒序与sort降序排列有什么区别?
作者:异步漫步
时间:2026-11-20
浏览:561
文章目录
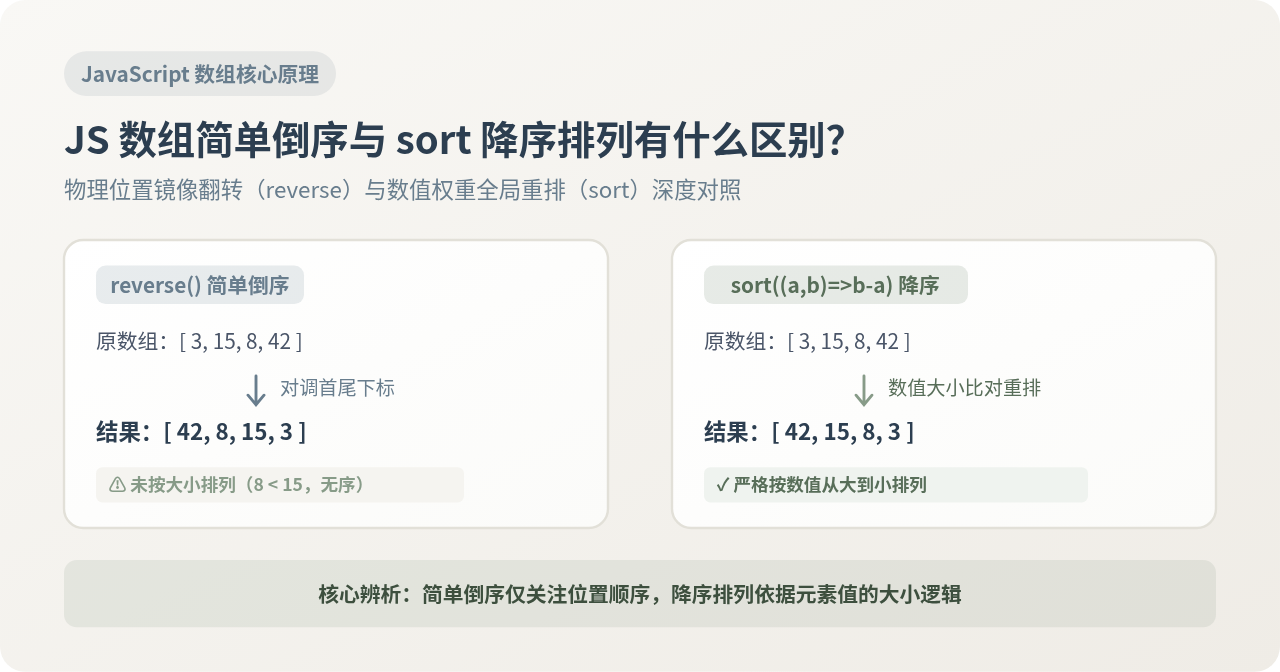
图 0:JavaScript 简单倒序与 sort 降序的核心行为对照缩略图
在 JavaScript 开发中,“简单倒序”与“sort 降序排列”是初学者最容易混淆的两种操作。简单倒序通过 Array.prototype.reverse() 实现,它的本质是按物理索引位置头尾翻转,完全不比对元素本身的实际大小;而降序排列通过 Array.prototype.sort((a, b) => b - a) 实现,它的本质是基于元素数值大小重新排布权重。只有在原数组本身已经严格按升序排列的前提下,简单倒序的结果才会碰巧呈现降序状态;对于任意乱序数组,调用倒序不仅无法排成从大到小,还会得到完全混乱的数据次序。
一、核心机制对比:物理翻转与数值比对
为了直观说明二者的本质差异,我们可以使用同一个无序数组 [5, 20, 15, 8] 分别执行这两种操作,观察它们在控制台中的具体行为:
// 准备初始无序数组
const arr1 = [5, 20, 15, 8];
const arr2 = [5, 20, 15, 8];

// 1. 执行简单倒序
arr1.reverse();
console.log('reverse 结果:', arr1);

// 2. 执行数值降序排列
arr2.sort((a, b) => b - a);
console.log('sort 降序结果:', arr2);
示例运行输出:
reverse 结果: [ 8, 15, 20, 5 ]
sort 降序结果: [ 20, 15, 8, 5 ]
分析上面的示例输出可以清楚看到:
reverse()只是把末尾索引 3 的8搬到第 0 位,把原第 2 位的15搬到第 1 位……整个过程没有经过任何大小比较,最终结果中8后面跟着比它更大的15,根本不是降序。sort((a, b) => b - a)计算了每对数值的差值,最终准确排出了20 > 15 > 8 > 5的严格递减序列。
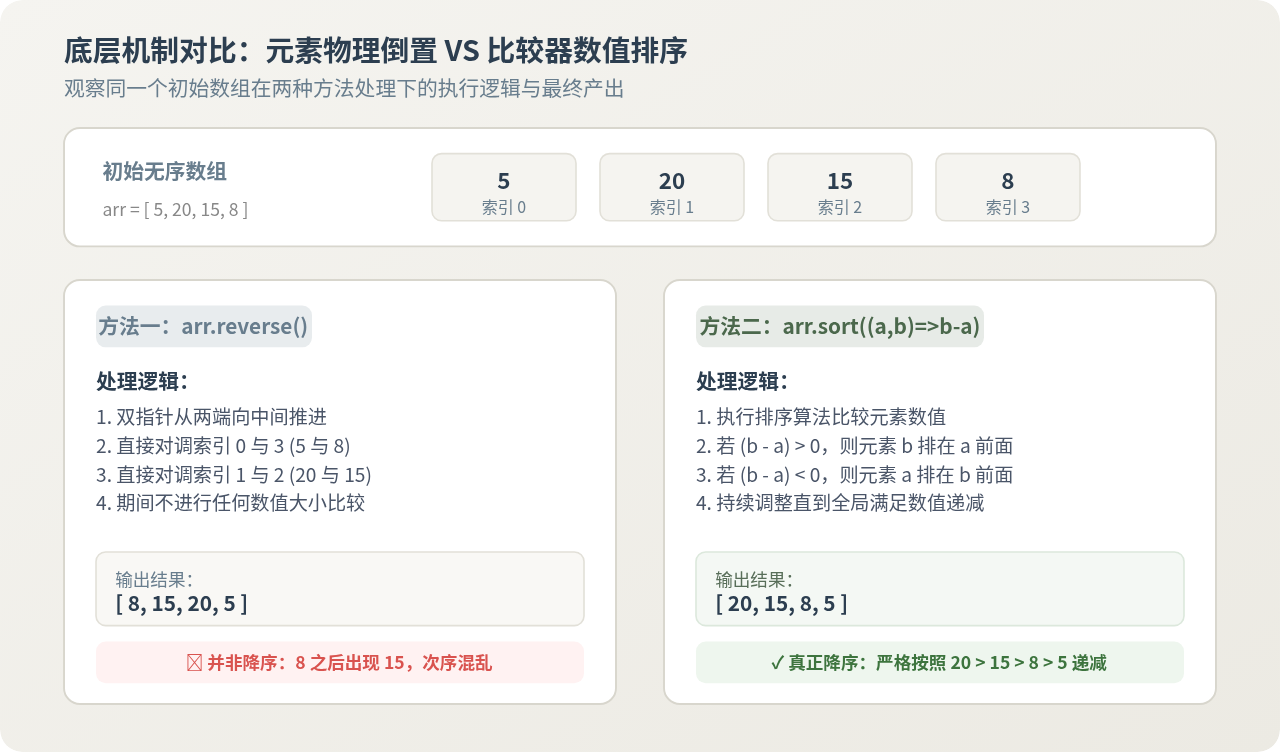
图 1:reverse 与 sort((a,b)=>b-a) 的底层运行机制与结果对比图
二、深入解析:reverse() 的运作原理与适用场景
reverse() 属于数组的原型方法。在 V8 等主流 JavaScript 引擎中,它的实现采用的是经典双指针算法:
- 一个指针指向数组头部索引
0,另一个指针指向数组尾部索引length - 1; - 两指针所在位置的元素直接通过中间变量交换;
- 左指针递增、右指针递减,直到两指针在数组中心相遇。
由于整个过程仅做镜像交换,它的时间复杂度为线性的 O(n),空间复杂度为 O(1),执行效率极高。但这种高效的前提是它完全忽略元素的值。因此,它的适用场景具有明确的边界:
- 时间轴与流式列表翻转:例如即时通讯软件中的聊天历史记录,接口返回按时间从旧到新排列,前端展示需要从最新消息向上铺展,此时直接翻转物理次序即可。
- 字符串与回文算法题:配合
str.split('').reverse().join('')快速逆转字符排列。 - 确定已升序数组的降序转换:如果上游接口或 SQL 已经做过严格的
ORDER BY score ASC,此时使用reverse()转为降序是安全的且性能优于重新执行快速排序。
三、深入解析:sort() 降序排列的运行机制与语法细节
sort() 是 JavaScript 提供的通用排序 API,现代引擎(如 Chrome V8、Node.js、SpiderMonkey)普遍采用 Timsort 算法(一种结合归并排序与插入排序的高性能混合算法),平均和最坏时间复杂度均为 O(n log n)。
特别注意默认调用陷阱:调用
arr.sort() 如果不提供参数,默认行为不是按数值大小排布,而是将所有元素转为字符串后按 UTF-16 代码单元值逐位比对。
// 陷阱示范:不传比较函数直接 sort
const numbers = [9, 80, 5];
numbers.sort();
console.log('默认 sort 结果:', numbers);
示例运行输出:
默认 sort 结果: [ 5, 80, 9 ]
在默认情况下,字符串 '80' 的首字符 '8' 的 UTF-16 编码小于 '9',导致 80 被排在 9 的前面。因此,实现可靠的数值降序,必须向 sort 显式传入比较函数:
// 正确写法:提供数值比较回调
arr.sort((a, b) => b - a);
比较函数规则十分明确:
- 当
b - a > 0(即b > a)时,函数返回正数,算法将b排在a之前; - 当
b - a < 0(即b < a)时,函数返回负数,算法将a排在b之前; - 当
b - a === 0时,相对次序保持不变(在稳定的 Timsort 下)。
四、操作规范与开发落地步骤
在日常业务开发中,选择倒序还是降序有一套清晰的判断依据。下图展示了从业务意图判断、参数编写到副作用防护的规范化操作链路:
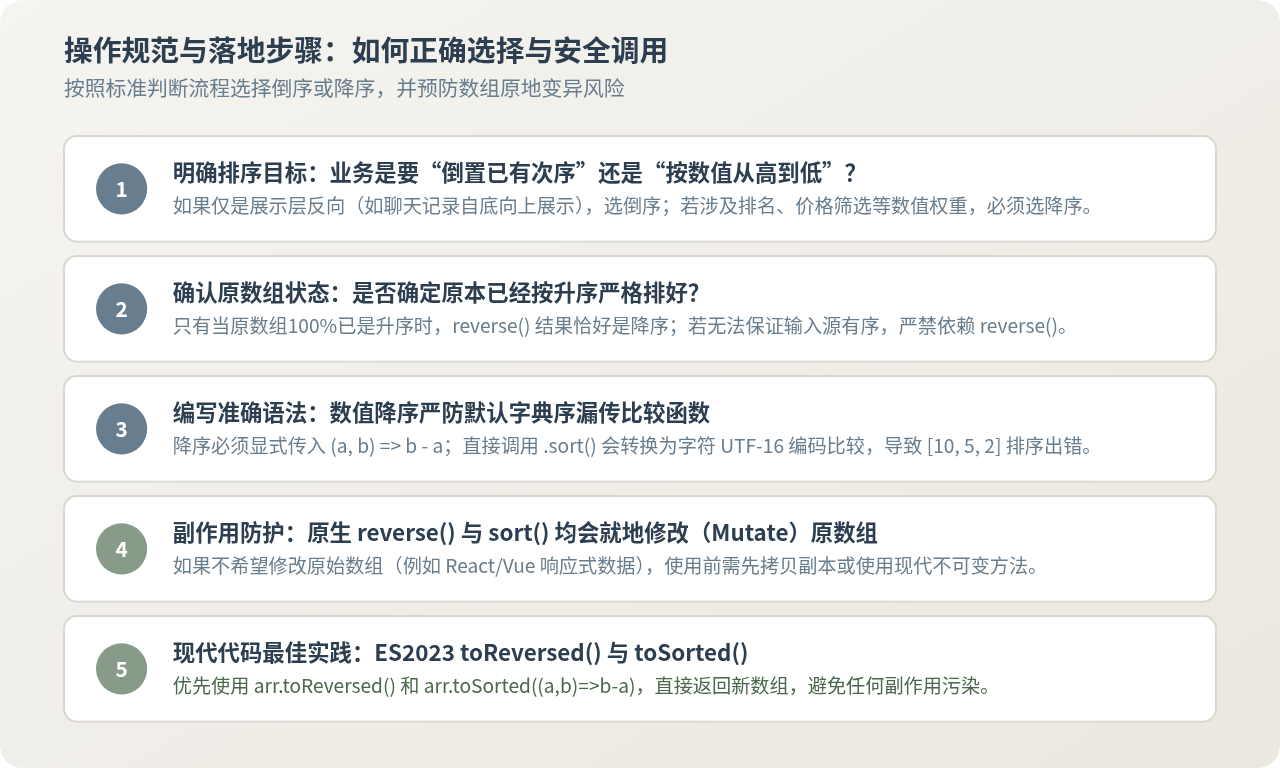
图 2:数组倒序与降序操作的标准开发与决策流程图
在具体编码时,应遵循以下操作规范:
- 前置状态审计:若目标是数值降序,且原始数据未经过排序保证,坚决不使用
reverse(); - 防御性编码:数值数组降序严格编写
(a, b) => b - a,对象数组降序编写(a, b) => b.price - a.price; - 避免副作用污染:牢记
reverse()与sort()均属于原地修改方法(Mutator)。
五、关键细节与常见三大陷阱剖析
在实际项目维护中,与这两种方法相关的 Bug 往往由于开发者对其运行细节理解不够全面。以下列出最常见的三种陷阱及排查方案:
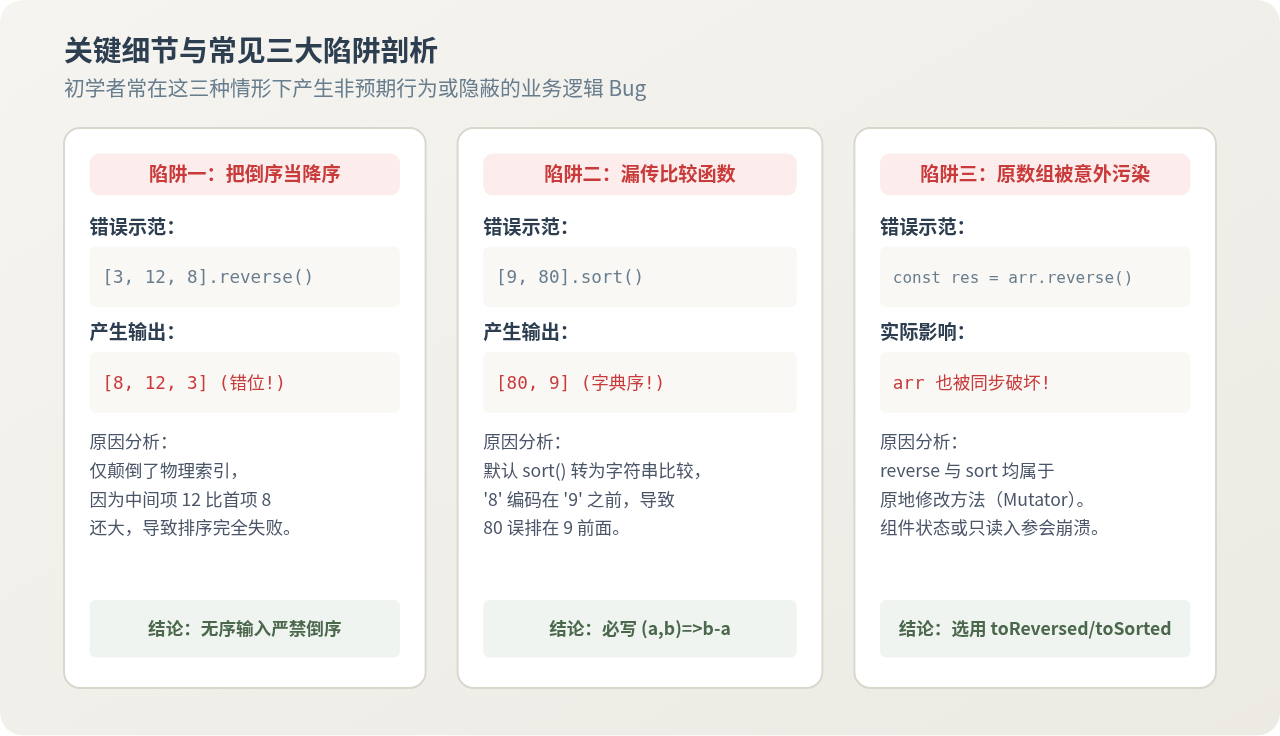
图 3:实际开发中最容易踩中的三大认知陷阱与对比示意图
陷阱一:误将“倒序”当成“降序”的快捷简写
在处理列表时,有些开发者潜意识认为 reverse() 能够将数值按从大到小排列。正如前文分析,一旦数组初始并非单调递增,倒序后的数据逻辑完全不可控。排查建议:凡是业务语义涉及“最高分”、“最新发布且有乱序插入”、“价格从高到低”,一律使用 sort((a, b) => b - a)。
陷阱二:对象数组排序错误使用两数相减处理浮点或大数溢出
在处理极端大数或特殊非数字值时,直接 b - a 可能因浮点数舍入精度出现偏差。在安全要求严苛的场景下,可以显式进行数值比较:
// 更加稳健的对象属性降序写法
products.sort((a, b) => {
  if (b.price > a.price) return 1;
  if (b.price < a.price) return -1;
  return 0;
});
陷阱三:原地破坏(Mutation)导致 Vue/React 响应式状态异常
很多开发者写出类似 const displayList = props.list.reverse(); 的代码,这会直接修改父组件传入的只读属性 props.list,打破单向数据流原则,引起难以追踪的渲染穿透问题。
解决方案:使用现代 ES2023(Node.js 20+ / 现代所有主流浏览器)原生支持的非破坏性方法:
// 1. ES2023 非变异倒序
const safeReversed = list.toReversed();

// 2. ES2023 非变异降序
const safeSorted = list.toSorted((a, b) => b - a);

// 3. 兼容旧环境的浅拷贝写法
const fallbackReversed = [...list].reverse();
const fallbackSorted = [...list].sort((a, b) => b - a);
六、总结与选型决策指南
为了方便在架构设计与日常代码编写中随时参考,下表对这两种操作的全部关键维度进行了横向对照:
| 特性维度 | 简单倒序 (reverse) | sort 降序排列 |
|---|---|---|
| 本质目的 | 颠倒元素当前的物理位置索引 | 根据元素数值的实际大小由高到低重排 |
| 前置数据要求 | 仅在原数组严格升序时才能得到降序 | 对输入原数组顺序无任何要求 |
| 核心参数 | 无参数 | 必须传入比较回调 (a, b) => b - a |
| 时间复杂度 | O(n) 线性双指针交换 | O(n log n) 比较型排序(Timsort) |
| 原地变异 | 就地修改原数组 | 就地修改原数组 |
| 现代非变异替代 | arr.toReversed() |
arr.toSorted((a, b) => b - a) |
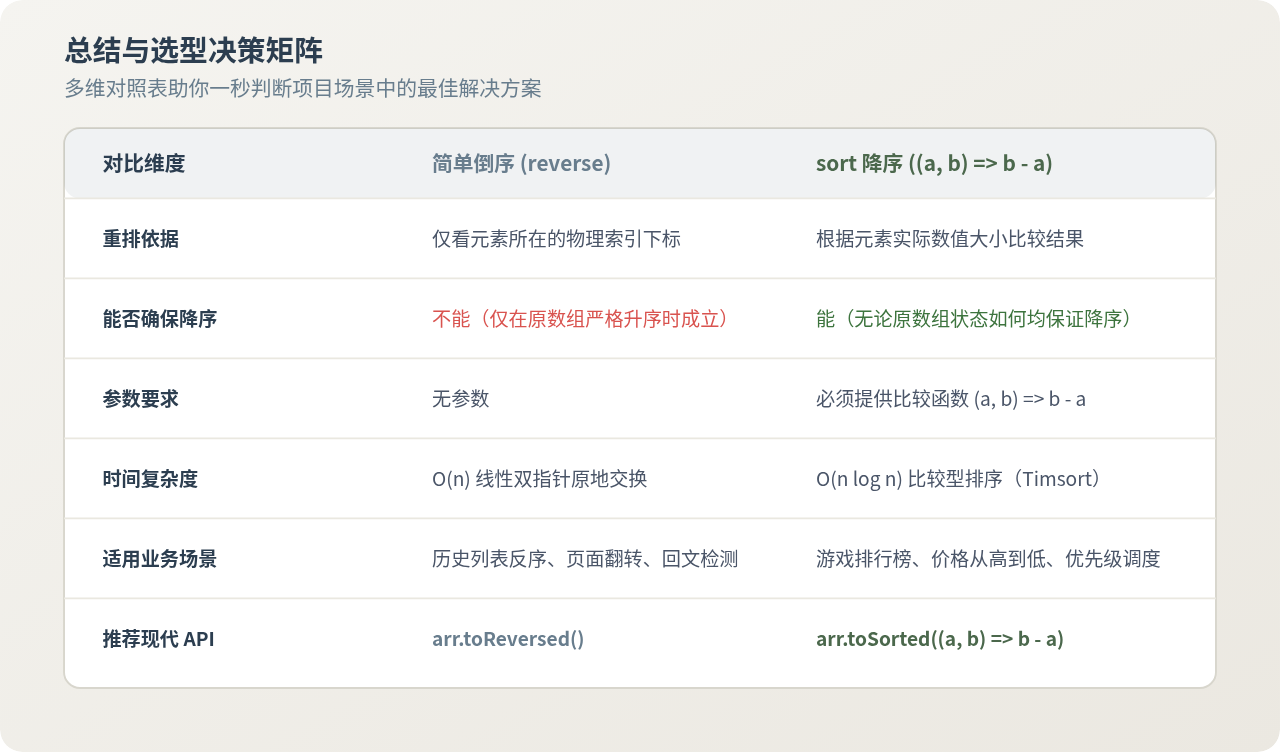
图 4:简单倒序与 sort 降序特性对比与决策总结矩阵
一句话选型法则:业务需要“反转当前展示”用
reverse(或 toReversed);业务需要“从大到小排权重”必须用 sort((a, b) => b - a)(或 toSorted)。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章